September 25, 2026
GPT-3 থেকে GPT-5: AI অনুবাদের মান আসলে কীভাবে পরিবর্তিত হয়েছে
GPT-3, GPT-4 এবং GPT-5-এর মধ্যে পাঁচ বছর এবং বেশ কয়েকটি আর্কিটেকচার প্রজন্মের ব্যবধান রয়েছে, কিন্তু অনুবাদের ক্ষেত্রে কাজের প্রশ্নটি "কোনটি সবচেয়ে বুদ্ধিমান" তা নয়। এটি আরও সুনির্দিষ্ট: ভাষার যেসব অংশ হুবহু শব্দ ধরে অনুবাদ করা যায় না—যেমন বাগধারা, দ্ব্যর্থবোধকতা এবং রেজিস্টার—সেগুলো পরিচালনার ক্ষেত্রে এই মডেলগুলোতে সুনির্দিষ্টভাবে কী পরিবর্তন এসেছে? এই উন্নতি নির্দিষ্ট কিছু ক্ষেত্রে, নির্দিষ্ট পয়েন্টে ঘটেছে, এবং এটি পুরোনো থেকে নতুনের দিকে একদম সরলরেখায় এগোয়নি।
অনুবাদের জন্য GPT-3 প্রকৃতপক্ষে কী সুবিধা দিয়েছিল
OpenAI 2020 সালে GPT-3 প্রকাশ করে, যা MachineTranslation.com-এর নিজস্ব টেস্টিং প্রোগ্রাম চালুর আগের ঘটনা, তাই এখানকার কোনো কিছুই কোনো প্রোপ্রাইটরি বেঞ্চমার্ক নয়। এটি সুনির্দিষ্টভাবে নথিবদ্ধ ইতিহাস, কোনো অভ্যন্তরীণ পরীক্ষার ফলাফল নয়। GPT-3 ছিল তার ধরণের প্রথম মডেল যা কোনো টাস্ক-নির্দিষ্ট প্রশিক্ষণ ছাড়াই একাধিক ভাষায় সাবলীল, মানুষের মতো স্বাভাবিক টেক্সট তৈরি করতে সক্ষম ছিল, যা এটিকে একটি সত্যিকারের মাইলফলক করে তুলেছিল। বিশেষ করে অনুবাদের ক্ষেত্রে, সেই একই সাবলীলতা একটি বাস্তব ঝুঁকি তৈরি করেছিল: GPT-3 টার্গেট ভাষায় আত্মবিশ্বাসের সাথে একটি সুগঠিত বাক্য তৈরি করতে পারত যা আসলে ভুল ছিল, এবং আউটপুটে এমন কোনো লক্ষণ থাকত না যা দেখে বোঝা যায় কোনো ভুল হয়েছে।
GPT-4 আসার পর কী পরিবর্তন হয়েছিল
GPT-4 চালু হয় March 2023-এ, এবং এই প্রজন্মের সময় থেকেই MachineTranslation.com-এর নিজস্ব মডেল টেস্টিং শুরু হয়। উন্নতিটি বাস্তব হলেও ছিল অসম। জাপানি ভাষায় দ্ব্যর্থবোধক ইংরেজি বাক্যাংশ "That's sick" পরীক্ষা করার সময়, পরীক্ষিত ছয়টি মডেলের মধ্যে কেবল GPT-4.1-nano লাইনটির ইচ্ছাকৃত দ্বৈত অর্থকে একটি মাত্র ব্যাখ্যায় সীমাবদ্ধ করে ফেলেছিল, যেখানে বাকি পাঁচটি মডেল মূল বাক্যাংশের উদ্দেশ্য অনুযায়ী দ্ব্যর্থবোধকতা বজায় রেখেছিল। বাগধারাগুলোর ক্ষেত্রে দুর্বলতা আরও স্পষ্ট ছিল: স্প্যানিশ বাগধারা "llevarse el gato al agua" একসাথে পাঁচটি GPT সংস্করণের মাধ্যমে অনুবাদ করতে গিয়ে তুলনামূলক ছোট GPT-4o-mini এবং GPT-4.1-nano উভয়ই একই আক্ষরিক, ভুল অনুবাদ তৈরি করেছিল, যা বাগধারাটির আসল অর্থ পুরোপুরি এড়িয়ে গেছে।
একই চিত্র অন্য ক্ষেত্রেও দেখা গেছে। আটটি GPT এবং Claude সাব-ভার্সনের মাধ্যমে জার্মান বাগধারা "ich verstehe nur Bahnhof" পরীক্ষা করার সময় বিশেষভাবে GPT-4o-mini এটি আক্ষরিক এবং ভুলভাবে অনুবাদ করেছিল, যেখানে একই পরীক্ষায় তুলনামূলক ছোট ও নতুন মডেল GPT-4.1-nano সঠিক অনুবাদ করেছিল। জেনারেশন এবং মডেলের আকারের মধ্যে কোনো ধারাবাহিক সামঞ্জস্য ছিল না—যা MachineTranslation.com-এর মডেল-ভার্সন টেস্টিং আরও বিশদভাবে তুলে ধরে।
অনুবাদের জন্য GPT-5 কী পরিবর্তন এনেছে
OpenAI GPT-5-কে একটি সমন্বিত সিস্টেম হিসেবে পরিচয় করিয়ে দেয় যা কাজের ধরণের ওপর নির্ভর করে একটি দ্রুতগতির ডিফল্ট মডেল এবং একটি গভীরতর রিজনিং মডেলের মধ্যে রাউট করে, যা GPT-4-এর একক-মডেল ডিজাইনের তুলনায় একটি কাঠামোগত পরিবর্তন। OpenAI-এর নিজস্ব GPT-5 System Card অনুসারে, মডেলটির সামগ্রিক ফ্যাকচুয়াল ভুলের হার GPT-4-এর তুলনায় প্রায় 45% এবং GPT-3-এর তুলনায় 80% কম, যা সার্বিক নির্ভরযোগ্যতার একটি বড় অগ্রগতি এবং অনুবাদের ক্ষেত্রেও বিশেষভাবে দৃশ্যমান। MachineTranslation.com-এর পরীক্ষায় সবচেয়ে স্পষ্ট উন্নতি সেখানে দেখা যায় যেখানে GPT-4-যুগের মডেলগুলো সবচেয়ে বেশি ভুগেছিল: যে স্প্যানিশ বাগধারাটি GPT-4o-mini এবং GPT-4.1-nano ভুল করেছিল, GPT-5.4-mini এবং GPT-5.4 উভয় মডেলই সেটির সঠিক ও ভাবানুগ অনুবাদ করেছে—প্রতিটি কিছুটা ভিন্নভাবে প্রকাশ করলেও উভয়ই বাগধারাটি সঠিকভাবে বুঝতে পেরেছে।
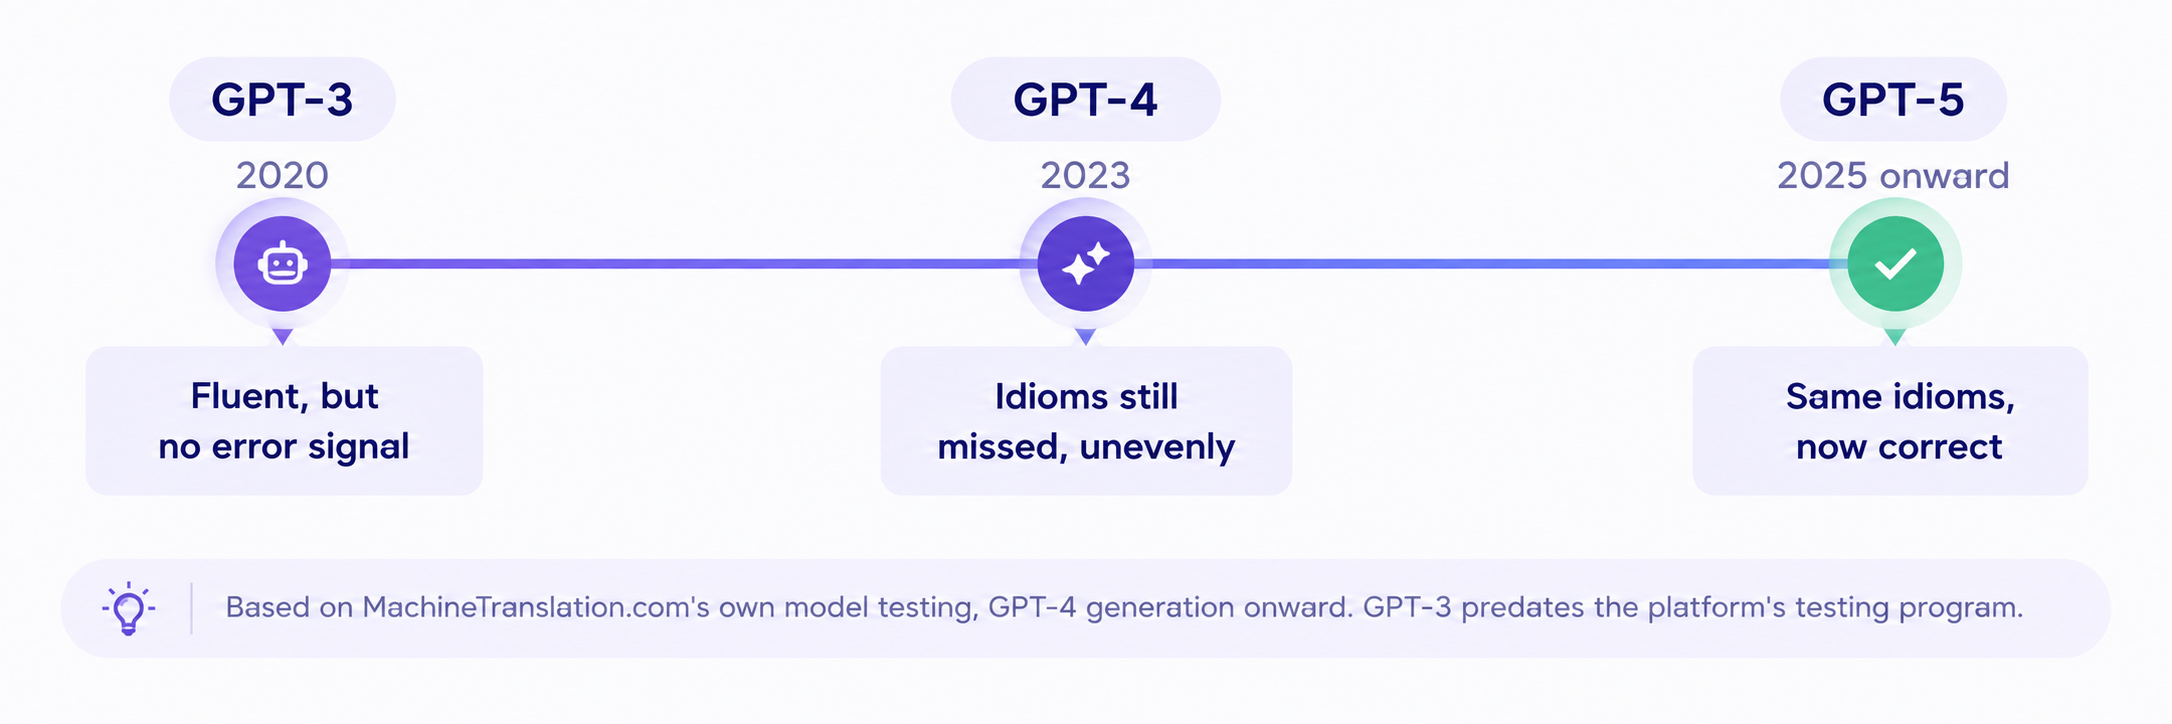
প্রজন্মগুলোর মধ্যকার এই ব্যবধান কোনো ধারাবাহিক অগ্রগতি ছিল না। এটি প্রায় সম্পূর্ণভাবেই সীমাবদ্ধ ছিল বাগধারামূলক এবং দ্ব্যর্থবোধক ভাষার ক্ষেত্রে। সোজাসাপটা টেক্সটের ক্ষেত্রে, GPT-4-যুগের এবং GPT-5-যুগের মডেলগুলোর স্কোর প্রায় একই রকম।
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| প্রকাশিত | 2020 | March 2023 | 2025, এখন GPT-5.4/5.5-এ |
| বর্তমানে উপলব্ধ | না, অবসরপ্রাপ্ত | শুধুমাত্র API, ChatGPT থেকে অবসরপ্রাপ্ত | হ্যাঁ, বর্তমান প্রজন্ম |
| বাগধারা পরিচালনা | MachineTranslation.com দ্বারা পরীক্ষিত নয় (প্রোগ্রামটির পূর্ববর্তী) | অসঙ্গতিপূর্ণ; বেশ কয়েকটি বাগধারা পুরোপুরি ধরতে পারেনি | GPT-4 যে বাগধারাগুলো ধরতে পারেনি, সেগুলো সঠিকভাবে সামলেছে |
| সাধারণ ব্যবসায়িক টেক্সট | MachineTranslation.com দ্বারা পরীক্ষিত নয় | শক্তিশালী, পরবর্তী মডেলগুলোর প্রায় অনুরূপ | শক্তিশালী, GPT-4-এর প্রায় অনুরূপ |
এই শেষ বিষয়টি গুরুত্বপূর্ণ: একটি সাধারণ ব্যবসায়িক বাক্যাংশ, "please confirm receipt of this document"-এর জার্মান অনুবাদের একটি পৃথক পরীক্ষায় পরীক্ষিত প্রতিটি মডেলেই প্রায় অভিন্ন ফলাফল এসেছে, যার মধ্যে GPT-4o-mini এবং GPT-5-প্রজন্মের মডেলগুলোও অন্তর্ভুক্ত ছিল। প্রজন্মের এই ব্যবধানটি মূলত আলঙ্কারিক এবং দ্ব্যর্থক ভাষার ক্ষেত্রেই দেখা যায়, এটি সার্বিক গুণগত মানের কোনো ঢালাও পার্থক্য নয়।
নতুন GPT প্রজন্ম মানেই কি সবসময় আরও ভালো অনুবাদ?
না। বিভিন্ন মডেল ফ্যামিলির মধ্যে একটি হিব্রু বাগধারা পরীক্ষা করার সময়, GPT-5.4-mini এবং GPT-5.4 একই বাক্যাংশের দুটি ভিন্ন ও আংশিক অর্থ প্রকাশ করেছে, যার কোনটিই পুরোপুরি সঠিক ছিল না; যেখানে তুলনামূলকভাবে একটি পুরোনো ও সম্পর্কহীন মডেল সঠিক উত্তরের অনেক কাছাকাছি পৌঁছাতে পেরেছে। একটি নতুন মডেল মানেই যে তা স্বয়ংক্রিয়ভাবে আরও নির্ভুল হবে তা নয়, এবং একটি নির্দিষ্ট বাক্যের জন্য একটি বড় বা সাম্প্রতিক মডেল স্বয়ংক্রিয়ভাবে নিরাপদ পছন্দ নাও হতে পারে।
অনুবাদের ক্ষেত্রে বর্তমানে GPT-5-এর অবস্থান
GPT-3 এবং GPT-4 উভয়কেই ChatGPT থেকে অবসর দেওয়া হয়েছে; GPT-4 শুধুমাত্র বিদ্যমান ইন্টিগ্রেশনের জন্য OpenAI-এর API-এর মাধ্যমে ব্যবহারযোগ্য রয়েছে। বর্তমান জেনারেশন, GPT-5.4 এবং GPT-5.5, বর্তমানে MachineTranslation.com-এ ব্যবহৃত হচ্ছে এবং এটি অন্যান্য প্রদানকারীর বর্তমান মডেলগুলোর বিপরীতে বেশ প্রতিযোগিতামূলক পারফর্ম করে, যদিও প্রতিটি ভাষা জোড়ায় সমভাবে শ্রেষ্ঠ নয়। বর্তমান GPT সাব-ভার্সনগুলো একে অপরের সাথে এবং Claude ও DeepSeek-এর মতো মডেলগুলোর সাথে কীভাবে তুলনীয় তা ঘনিষ্ঠভাবে দেখতে, MachineTranslation.com-এর হেড-টু-হেড সাব-ভার্সন টেস্টিং দেখুন, যা একটি জেনারেশনাল ওভারভিউয়ের চেয়েও আরও বিশদ বিশ্লেষণ প্রদান করে।
আপনি যদি বৃহৎ পরিসরে লোকালাইজ করেন তবে এর তাৎপর্য কী
একটি বৃহৎ লোকালাইজেশন প্রোগ্রামের জন্য যে ফলাফলটি সবচেয়ে বেশি গুরুত্বপূর্ণ তা হলো "GPT-5, GPT-3-কে হারায়" এটি নয়। বরং মডেলের ভার্সন—কেবল মডেল ফ্যামিলি নয়—নির্ধারণ করে যে একটি নির্দিষ্ট বাগধারা বা দ্ব্যর্থবোধক বাক্যাংশ সঠিকভাবে অনুবাদ হবে কিনা, এবং এটি কেবল এখানে দেখানো কয়েকটি ভাষার ক্ষেত্রেই নয়, প্রতিটি ভাষা জোড়ার ক্ষেত্রেই সত্য। এটি সবচেয়ে বেশি গুরুত্বপূর্ণ সেইসব কন্টেন্টের ক্ষেত্রে যা মূলত টোন এবং রূপক ভাষার ওপর নির্ভর করে, বিশেষ করে মার্কেটিং কপি এবং ইউজার-জেনারেটেড কন্টেন্ট, যেখানে আক্ষরিকভাবে অনূদিত একটিমাত্র বাগধারা কোনো পোস্ট বা বিজ্ঞাপনের সম্পূর্ণ অর্থ বদলে দিতে পারে। একটি প্রোগ্রাম যা কয়েক ডজন ভাষায় কন্টেন্ট রূপান্তর করছে, তা এর প্রতিটিতেই ঠিক এই ধরণের ভাষার সম্মুখীন হবে। MachineTranslation.com-এর সাব-ভার্সন টেস্টিং সিরিজ এবং পূর্ণাঙ্গ মডেল কম্প্যারিজন টেস্টিং এই বিষয়ে আরও বিশদভাবে তুলে ধরে। প্রতিটি অনুবাদে বর্তমান GPT মডেলগুলোর পাশাপাশি ২০টিরও বেশি অন্যান্য মডেল চালানোর এই প্ল্যাটফর্মটির পদ্ধতিটি বিশেষভাবে বিদ্যমান, কারণ কোনো একক মডেলের ভার্সন হিস্ট্রি নিজে থেকে যথেষ্ট নির্ভরযোগ্য গ্যারান্টি হতে পারে না।
সচরাচর জিজ্ঞাসিত প্রশ্নাবলী
1. অনুবাদের ক্ষেত্রে GPT-3, GPT-4 এবং GPT-5-এর মধ্যে আসল পার্থক্য কী?
GPT-3 সরাসরি টেক্সট মোটামুটি ভালোভাবেই পরিচালনা করেছিল, কিন্তু বাগধারা বা দ্ব্যর্থবোধক যেকোনো কিছু নিয়ে মারাত্মকভাবে হিমশিম খেয়েছিল। GPT-4 সেই ব্যবধানটি উল্লেখযোগ্যভাবে কমিয়ে এনেছিল কিন্তু তবুও দ্ব্যর্থতা বজায় রাখার পরিবর্তে কিছু সত্যিকার অর্থে অস্পষ্ট বাক্যাংশকে একটিমাত্র অর্থে রূপান্তর করেছিল। GPT-5-এর পরবর্তী সাব-ভার্সনগুলো এমন বাগধারাগুলো সঠিকভাবে অনুবাদ করেছে যা আগের GPT-4-যুগের মডেলগুলো আক্ষরিক এবং ভুলভাবে অনুবাদ করেছিল।
2. অনুবাদের ক্ষেত্রে GPT-5 কি সবসময় GPT-4-এর চেয়ে ভালো?
না। MachineTranslation.com-এর নিজস্ব পরীক্ষায় এমন ঘটনা দেখা গেছে যেখানে একটি ছোট, নতুন সাব-ভার্সন একটি বড়, পুরোনো সাব-ভার্সনের চেয়ে ভালো পারফর্ম করেছে; এবং জেনারেশনগুলোর মধ্যে গুণমানের ব্যবধানটি সার্বিক উন্নতির পরিবর্তে মূলত বাগধারা বা রূপক ভাষার ক্ষেত্রে বেশি নির্দিষ্ট।
3. OpenAI কি এখনও GPT-3 বা GPT-4 অফার করে?
না। উভয়কেই ChatGPT থেকে অবসর দেওয়া হয়েছে এবং নতুন GPT-5-জেনারেশনের মডেল দ্বারা প্রতিস্থাপিত করা হয়েছে। GPT-4 কেবলমাত্র বিদ্যমান ইন্টিগ্রেশনের জন্য OpenAI-এর API-এর মাধ্যমে অ্যাক্সেসযোগ্য রয়েছে, সাধারণ গ্রাহকদের ব্যবহারের সরাসরি বিকল্প হিসেবে নয়।
4. MachineTranslation.com কোন GPT ভার্সন ব্যবহার করে?
MachineTranslation.com শুধুমাত্র GPT-এর ওপর নির্ভর করার পরিবর্তে প্রতিটি অনুবাদে ২০টিরও বেশি অন্যান্য AI মডেলের পাশাপাশি বর্তমান GPT-5-জেনারেশনের মডেলগুলো (প্ল্যান টায়ারের ওপর ভিত্তি করে GPT-5.4 এবং GPT-5.5) পরিচালনা করে।
5. অনুবাদের ক্ষেত্রে অন্যান্য বর্তমান AI মডেলের তুলনায় GPT-5 কেমন?
GPT-5 প্রজন্মের মডেলগুলো প্রতিযোগিতামূলক পারফর্ম করে, তবে Claude, Gemini বা DeepSeek-এর মতো মডেলগুলোর চেয়ে সব ক্ষেত্রে সমভাবে উন্নত নয়। বিভিন্ন ভাষার জোড়া এবং কনটেন্টের ধরনের ওপর ভিত্তি করে ভিন্ন ভিন্ন মডেল এগিয়ে থাকে, আর এই কারণেই MachineTranslation.com কোনো একটিকে ডিফল্ট হিসেবে বেছে নেওয়ার পরিবর্তে সরাসরি একে অপরের সাথে সেগুলোর তুলনামূলক পরীক্ষা চালায়।