October 9, 2026
Qwen বনাম ChatGPT: কোন AI মডেলটি আরও ভালো অনুবাদ করে?
ChatGPT-এর বর্তমান প্রজন্ম এবং Qwen উভয়ই MachineTranslation.com প্রতিটি অনুবাদের জন্য যে মডেলের পুল পরিচালনা করে তার অংশ, প্ল্যাটফর্মটির সাথে তুলনা করা বাইরের কোনো প্রতিযোগী নয়। অভিন্ন সেগমেন্টে একই টেক্সট উভয়ের মাধ্যমে অনুবাদ করলে সামগ্রিকভাবে অধিকাংশ ল্যাঙ্গুয়েজ পেয়ারে ChatGPT জয়ী হয়। ফলাফলগুলোকে অনুবাদের দিক অনুযায়ী ভাগ করলে একটি নির্দিষ্ট ক্ষেত্রে ব্যবধানটি নাটকীয়ভাবে কমে আসে: ইংরেজিতে অনুবাদের ক্ষেত্রে, যেখানে দুটি মডেল প্রায় সমানে সমান।
অনূবাদের ক্ষেত্রে ChatGPT-এর চেয়ে ভালো কোনো AI আছে কি?
প্রতিদ্বন্দ্বী মডেলগুলোর উন্নতির সাথে সাথে ChatGPT-এর বিকল্পগুলির প্রতি সাধারণ আগ্রহ বৃদ্ধি পেয়েছে, যদিও ব্যবহারের ক্ষেত্র অনুযায়ী এর কারণগুলো অনেকটাই আলাদা এবং এর কোনো একক ব্যাখ্যা নেই। বিশেষ করে অনুবাদের ক্ষেত্রে, আরও কার্যকর প্রশ্ন হলো একটি নির্দিষ্ট ল্যাঙ্গুয়েজ পেয়ারে কোন মডেলটি আসলে আরও ভালো পারফর্ম করে—যা অনুভূতির বিষয় নয়, বরং একটি পরীক্ষাযোগ্য প্রশ্ন।
MachineTranslation.com-এর গত 28 দিনের ট্রাফিকের ভিত্তিতে, উভয় মডেলই 98টি ল্যাঙ্গুয়েজ পেয়ারে একই সোর্স টেক্সট অনুবাদ করেছে। এই পেয়ারগুলোর মধ্যে 77টিতে ChatGPT বেশি স্কোর করেছে; আর 21টিতে Qwen বেশি স্কোর করেছে। ম্যাচ করা আউটপুটের ওয়েটেড গড় বিশ্লেষণে 10-এর মধ্যে ChatGPT-এর স্কোর 9.10 এবং Qwen-এর স্কোর 8.98; গড়ে এটি একটি বাস্তব কিন্তু সামান্য ব্যবধান, যা অনুবাদের দিক বিবেচনায় আনলে অনেক বড় পার্থক্য লুকিয়ে রাখে।
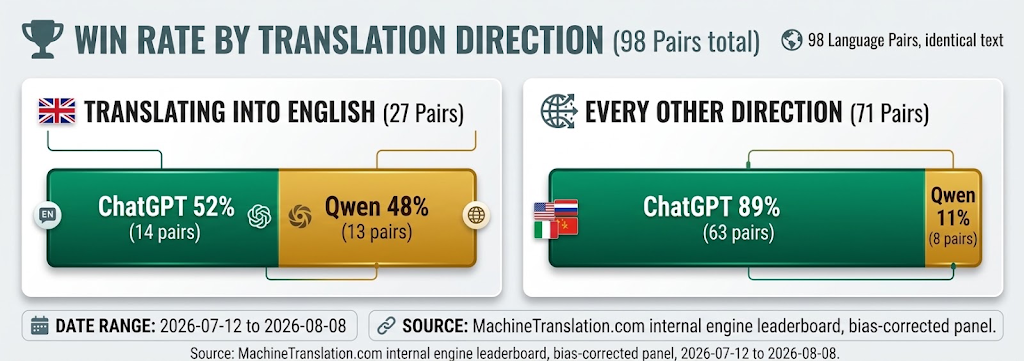
ইংরেজিতে অনুবাদের ক্ষেত্রে মডেল দুটি প্রায় সমানে সমান। অন্য প্রতিটি দিকের ক্ষেত্রে, পরীক্ষিত পেয়ারগুলোর সিংহভাগেই ChatGPT জয়ী হয়েছে।
| ChatGPT | Qwen | |
|---|---|---|
| মূল্যায়িত আউটপুটের শতাংশ | 54.76% | 42.6% |
| গড় স্কোর | 8.89 / 10 | 8.87 / 10 |
| স্কোরের সর্বনিম্ন 10% | 7.8 | 7.6 |
| জয়ের হার, ইংরেজিতে অনুবাদের ক্ষেত্রে | 52% | 48% |
| জয়ের হার, অন্যান্য সকল ক্ষেত্রে | 89% | 11% |
ইংরেজিতে অনুবাদের ক্ষেত্রে ব্যবধানটি প্রায় মুছে যায় কেন?
ডেটা দেখায় বিভাজনটি কোথায় ঘটে, কেন ঘটে তা নয়। যা স্পষ্ট তা হলো Qwen-এর প্রতিযোগিতামূলক সক্ষমতা সমানভাবে বিন্যস্ত নয়। টার্গেট ভাষা ইংরেজি এমন 27টি পেয়ারের মধ্যে Qwen 13টিতে জয়ী, যা মূলত টস করার মতো সমান সম্ভাবনাময়। অবশিষ্ট 71টি পেয়ারের মধ্যে—ইংরেজি থেকে অন্য ভাষায় এবং দুটি অ-ইংরেজি ভাষার মধ্যে উভয় ক্ষেত্রেই—ChatGPT 63টিতে জয়ী হয়, যা মোটটির 89%। কোনো টিম যদি ধরে নেয় যে ইংরেজিতে অনুবাদের ক্ষেত্রে Qwen-এর পারফরম্যান্স ইংরেজি থেকে অন্য ভাষায় বা অ-ইংরেজি ভাষার পেয়ারের অনুবাদের ক্ষেত্রেও একই থাকবে, তবে তারা ভুল দিক থেকে ভুল শিক্ষা গ্রহণ করবে।
Qwen কি একটি চীনা কোম্পানি, এবং অনুবাদের ক্ষেত্রে কি এটি কোনো প্রভাব ফেলে?
Qwen চীনে অবস্থিত Alibaba Cloud দ্বারা তৈরি। স্বতন্ত্রভাবে, এটি কোনো নির্দিষ্ট বাক্য মডেলটি কতটা ভালোভাবে অনুবাদ করে তা পরিবর্তন করে না; উপরের ডেটা একটি মডেল কোথায় তৈরি হয়েছে তা বিবেচনা না করেই প্রকৃত আউটপুট গুণমানকে প্রতিফলিত করে। এটি যেখানে প্রভাব ফেলতে পারে তা হলো ডেটা হ্যান্ডলিং: যেসব ব্যবসা নিয়ন্ত্রিত বা সংবেদনশীল কনটেন্ট (চুক্তিপত্র, চিকিৎসা সংক্রান্ত রেকর্ড, ব্যক্তিগত তথ্য) অনুবাদ করে, তাদের অনুবাদের গুণমান থেকে আলাদাভাবে, একটি AI সরবরাহকারী কোথায় সেই কনটেন্ট প্রসেস ও সংরক্ষণ করে সেই প্রশ্নটিকে একটি বাস্তব ডিউ-ডিলিজেন্স আইটেম হিসেবে বিবেচনা করা উচিত। এটি যেকোনো AI সরবরাহকারীর ক্ষেত্রেই প্রযোজ্য, কেবল Qwen-এর জন্য নয়, এবং এটি অন্যতম কারণ যে MachineTranslation.com প্রশ্নটি অমীমাংসিত না রেখে সরাসরি নিজস্ব ডেটা হ্যান্ডলিং ও নিরাপত্তা সংক্রান্ত নীতিমালা প্রকাশ করে।
আইনি এবং ব্যবসায়িক অনুবাদের জন্য কি কোনো একটি মডেল বেশি নির্ভরযোগ্য?
ধারাবাহিকভাবে নয়, এবং এই পার্থক্যের বিষয়টি সবসময় কোন মডেল বেশি স্কোর করছে তার ওপর নির্ভর করে না। আইনি লেখার ক্ষেত্রে যেকোনো একটি মডেলের ওপর ভরসা করার আগে MachineTranslation.com-এর বাস্তব চুক্তির ভাষার ওপর করা পরীক্ষায় জানা উচিত এমন দুটি পৃথক ক্ষেত্র পাওয়া গেছে। বাগধারামূলক ভাষার ক্ষেত্রে ফলাফল মাঝে মাঝে ভিন্ন হয়: একটি পৃথক সরাসরি পরীক্ষায় দেখা গেছে ChatGPT একটি জার্মান বাগধারা আক্ষরিক অর্থে এবং ভুলভাবে অনুবাদ করেছে, যেখানে Qwen সঠিক বাগধারামূলক অর্থটি খুঁজে পেয়েছে; যা মনে করিয়ে দেয় যে সামগ্রিক তথ্যে কোনো মডেলের সার্বিক এগিয়ে থাকা প্রতিটি বাক্যের ক্ষেত্রে সত্য নাও হতে পারে।
| টেস্ট কেস | ChatGPT | Qwen |
|---|---|---|
| জার্মান ভাষায় "At-will employment" | ব্যবহারযোগ্য, কার্যকরী বাক্যাংশ | একটি অপ্রাসঙ্গিক আইনি ধারণা ব্যবহার করেছে |
| স্প্যানিশ ভাষায় Limitation-of-liability ধারা | "que surjan de" | "derivados de" (আওতা পরিবর্তনকারী পার্থক্য) |
| "Ich verstehe nur Bahnhof" (জার্মান বাগধারা) | আক্ষরিক অনুবাদ করেছে, ভুল | সঠিক বাগধারামূলক অর্থ |
এই তিনটি ক্ষেত্রে কোনো মডেলই ধারাবাহিকভাবে জয়ী হয়নি: একটি একক মডেলের সামগ্রিক স্কোর কোনো নির্দিষ্ট পরিভাষা বা বাক্যাংশের ক্ষেত্রে তার আচরণ কেমন হবে তা আগে থেকে বলতে পারে না। এ কারণেই প্রথম খসড়াটি যে মডেলই তৈরি করুক না কেন, আইনি এবং চুক্তিভিত্তিক পাঠ্য মানুষের দ্বারা যাচাইকরণের পদক্ষেপ থেকে উপকৃত হয়।
ভাষার পরিধি সম্পর্কে কী বলা যায়?
ChatGPT বা Qwen কেউই এমন কোনো যাচাইকৃত, স্বতন্ত্রভাবে নিশ্চিত করা ভাষা জোড়ার তালিকা প্রকাশ করে না যেখানে অনুবাদের মান হ্রাস পায়। উভয়ই ব্যাপক বহুভাষিক প্রশিক্ষণপ্রাপ্ত সাধারণ উদ্দেশ্যের মডেল, যা একটি নির্দিষ্ট ভাষার সেটে পরিমাপকৃত অনুবাদ পারফরম্যান্সের দাবি থেকে আলাদা। কোনো মডেলের সাধারণ ভাষা সক্ষমতার ওপর অনুবাদের প্রকৃত মানের বিকল্প হিসেবে নির্ভর করার পরিবর্তে, MachineTranslation.com সরাসরি 330+-এর বেশি ভাষায় অনুবাদের মান পরীক্ষা করে এবং স্কোর প্রদান করে।
ব্যবসায়িক অনুবাদের জন্য ChatGPT বা Qwen-এ আপনার কী পেস্ট করা উচিত নয়?
ChatGPT বা Qwen কোনটিই ডেডিকেটেড অনুবাদ প্ল্যাটফর্ম হিসেবে তৈরি করা হয়নি, এবং একটি সাধারণ উদ্দেশ্যের চ্যাট ইন্টারফেসে সরাসরি সংবেদনশীল ব্যবসায়িক বিষয়বস্তু পেস্ট করার ক্ষেত্রে ডেটা ব্যবস্থাপনার একই ধরনের প্রশ্ন থেকে যায়, যা অন্য যেকোনো কনজিউমার AI টুলে পেস্ট করার ক্ষেত্রে প্রযোজ্য: ইনপুট কোথায় প্রক্রিয়া করা হচ্ছে, এটি সংরক্ষণ করা হচ্ছে কিনা এবং কার এতে অ্যাক্সেস রয়েছে। চুক্তিপত্র, মেডিকেল রেকর্ড, অভিবাসন সংক্রান্ত নথি এবং আর্থিক বিবরণী হলো ঠিক সেই ধরণের বিষয়বস্তু যেখানে অনুবাদের পরে নয়, অনুবাদের আগেই এই প্রশ্নের উত্তর খোঁজা জরুরি। এটি একটি বাস্তবসম্মত কারণ যে প্রকাশিত, যাচাইযোগ্য ডেটা ব্যবস্থাপনা প্রক্রিয়াসম্পন্ন একটি ডেডিকেটেড অনুবাদ প্ল্যাটফর্ম সাধারণ উদ্দেশ্যের চ্যাট ইন্টারফেসের চেয়ে সম্পূর্ণ ভিন্ন একটি প্রস্তাবনা, তা সেগুলোর পেছনে যে মডেলই কাজ করুক না কেন।
MachineTranslation.com প্রকৃতপক্ষে কীভাবে উভয় মডেল ব্যবহার করে
MachineTranslation.com প্রতিটি অনুবাদে ChatGPT, Qwen এবং 20টিরও বেশি অন্যান্য AI মডেল চালায়, তারপর সেই সংস্করণটি সামনে আনে যেটিতে এই মডেলগুলো সবচেয়ে বেশি সম্মত হয়। অনুবাদের দিকভেদে Qwen এবং ChatGPT-এর পারফরম্যান্স কতটা স্পষ্টভাবে ভিন্ন হয় তা বিবেচনা করলে, একটি মডেলকে স্থায়ী ডিফল্ট হিসেবে বেছে নেওয়ার অর্থ হবে ভাষা জোড়ার একটি অনুমেয় অংশে ভুল অনুমান করা। দিক-নির্ভর একই প্যাটার্ন MachineTranslation.com-এর Qwen বনাম DeepSeek তুলনাতেও দেখা যায়। বর্তমান মডেলগুলো একে অপরের বিরুদ্ধে কীভাবে পরীক্ষিত হয় তার পূর্ণাঙ্গ চিত্র পেতে, MachineTranslation.com-এর সম্পূর্ণ মডেল তুলনা পরীক্ষা দেখুন।
প্রায়শই জিজ্ঞাসিত প্রশ্নাবলী
1. অনুবাদের জন্য Qwen নাকি ChatGPT কোনটি বেশি ভালো?
অভিন্ন উৎস টেক্সটে পরীক্ষিত 98টি ভাষা জোড়ার মধ্যে, 77টিতে ChatGPT বেশি স্কোর করেছে। Qwen-এর সবচেয়ে শক্তিশালী দিক হলো ইংরেজিতে অনুবাদ করা, যেখানে দুটি মডেল প্রায় সমানে সমান। অন্য প্রতিটি দিকে, ChatGPT ভাষা জোড়ার সিংহভাগেই এগিয়ে থাকে, তাই অকপট উত্তরটি বিষয়বস্তু কোন দিক থেকে কোন দিকে যাচ্ছে তার ওপর অনেকটাই নির্ভর করে।
2. ChatGPT নাকি Qwen কোনটি বেশি ভাষা সমর্থন করে?
উভয়ই সাধারণ উদ্দেশ্যের AI মডেল, যেগুলোর নির্দিষ্ট ভাষার সীমাবদ্ধতার কোনো যাচাইকৃত এবং প্রকাশিত তালিকা নেই। কোনটিই স্বতন্ত্রভাবে নিশ্চিত করা ভাষা জোড়ার কভারেজ ডেটা প্রকাশ করে না, যা বহুভাষিক প্রশিক্ষণের সাধারণ দাবির ওপর নির্ভর না করে সরাসরি 330+-এর বেশি ভাষায় অনুবাদের মান পরীক্ষা এবং স্কোর করে এমন একটি প্ল্যাটফর্মের চেয়ে আলাদা।
3. আইনি ও ব্যবসায়িক অনুবাদের জন্য Qwen নাকি ChatGPT কোনটি বেশি ভালো?
সামগ্রিকভাবে কোনটিই নির্ভরযোগ্যভাবে বেশি ভালো নয়। একটি জার্মান কর্মসংস্থান আইনের শর্ত পরীক্ষা করার সময়, DeepSeek এবং ChatGPT ব্যবহারযোগ্য কার্যকরী বাক্যাংশ তৈরি করেছে, যেখানে Claude এবং Qwen উভয়ই একটি সম্পর্কহীন আইনি ধারণাকে টেনে এনেছে—যা প্রমাণ করে যে এই পার্থক্যটি সুনির্দিষ্ট পরিভাষা এবং প্রসঙ্গের ওপর নির্ভর করে, কোন মডেলটি সাধারণভাবে শক্তিশালী তার ওপর নয়।
4. MachineTranslation.com কি ChatGPT এবং Qwen-এর সাথে প্রতিযোগিতা করে?
না। MachineTranslation.com প্রতিটি অনুবাদে ChatGPT, Qwen এবং 20টিরও বেশি অন্যান্য AI মডেল চালায় এবং সেই সংস্করণটি সামনে আনে যেটিতে মডেলগুলো সবচেয়ে বেশি একমত হয়। এটি নিজস্ব কোনো পৃথক, প্রতিযোগী মডেল হিসেবে কাজ করার পরিবর্তে এই ধরনের মডেলগুলোকে পরীক্ষা করে এবং একত্রিত করে।
5. একটি বড় লোকালাইজেশন প্রকল্পের জন্য আমার কোন মডেলটি বেছে নেওয়া উচিত?
উভয় দিকে বহু ভাষায় কনটেন্ট অনুবাদের ক্ষেত্রে এদের কোনোটিই একা নিরাপদ ডিফল্ট নয়। এখানে নথিভুক্ত দিক-নির্দিষ্ট পার্থক্যের অর্থ হলো, যে মডেলটি ইংরেজিতে অনুবাদ করার ক্ষেত্রে ভালো পারফর্ম করে, তা একযোগে ডজন ডজন ভাষা জোড়ায় ইংরেজি থেকে অন্য ভাষায় অনুবাদের ক্ষেত্রে সম্পূর্ণ ভিন্ন ফলাফল দিতে পারে।
6. অনুবাদের জন্য কোন Qwen মডেলটি সেরা?
এটি এখনও উপলব্ধ নয়। অন্যান্য প্রোভাইডারের মতো না হয়ে, MachineTranslation.com-এর ট্র্যাকিং বর্তমানে Qwen-কে কোনো মডেল-ভার্সন ট্যাগ ছাড়াই একটি একক ইঞ্জিন হিসেবে রেকর্ড করে, তাই রিপোর্ট করার মতো সাব-ভার্সন ভিত্তিক মানের ডেটা নেই। এটি সমাধান হলে, Qwen3.8-Max এবং Qwen3.8-27B-এর মধ্যে একটি বাস্তব বিশ্লেষণ সম্ভব হবে; আপাতত, এটি কেবল একটি অপরিমাপিত বিবরণ নয়, বরং একটি প্রকৃত ঘাটতি।