October 2, 2026
Qwen বনাম Grok: কোন AI মডেলটি আরও ভালো অনুবাদ করে?
Qwen এবং Grok উভয়ই সাধারণ-উদ্দেশ্যের AI মডেল, অনুবাদ-নির্দিষ্ট কোনো টুল নয়, এবং উভয়ই সেই মডেল পুলের অংশ যা MachineTranslation.com প্রতিটি অনুবাদের জন্য চালায়। পরবর্তীতে যা বলা হয়েছে তা কীভাবে বুঝতে হবে তার জন্য এটি গুরুত্বপূর্ণ। এই ধরনের ডেটার সাথে আসা বাস্তব সতর্কতাগুলো মাথায় রেখে, এটি প্ল্যাটফর্মের নিজস্ব দুটি মডেল একে অপরের বিরুদ্ধে কীভাবে পারফর্ম করে তার একটি পর্যবেক্ষণ, কোনো বাইরের দুটি প্রতিযোগী এবং প্ল্যাটফর্মের নিজস্ব ব্যবস্থার মধ্যকার কোনো প্রতিযোগিতা নয়।
Qwen এবং Grok কী?
Qwen হলো Alibaba-এর large language models-এর পরিবার, যা বর্তমানে এর Qwen3.8 জেনারেশনে রয়েছে, এবং প্ল্যাটফর্মের চলমান সম্প্রসারণের অংশ হিসেবে এটিকে MachineTranslation.com-এর মডেল পুলে যুক্ত করা হয়েছে। Grok হলো xAI-এর মডেল লাইন, এই লেখা পর্যন্ত বর্তমানে Grok 4.7-এ রয়েছে, যা এই আর্টিকেলে প্রাথমিকভাবে তুলনা করা ভার্সনটির পর থেকে বেশ কয়েকটি রিলিজ পার করেছে এবং আলাদাভাবে প্ল্যাটফর্মে যুক্ত হয়েছে। কোনো মডেলই বিশেষভাবে অনুবাদের জন্য তৈরি করা হয়নি। উভয়ই সাধারণ-উদ্দেশ্যের সিস্টেম যা বৃহত্তর ভাষার সক্ষমতার অংশ হিসেবে ঘটনাক্রমে একাধিক ভাষা পরিচালনা করে, যা বিশেষভাবে অনুবাদের গুণমানের ওপর ভিত্তি করে তৈরি এবং পরীক্ষা করা কোনো প্ল্যাটফর্মের চেয়ে ভিন্ন একটি শুরুর পয়েন্ট।
MachineTranslation.com-এর নিজস্ব ডেটায় Qwen এবং Grok-এর তুলনা কেমন?
প্ল্যাটফর্ম ট্রাফিকের গত 28 দিনে, Grok গড়ে Qwen-এর চেয়ে বেশি স্কোর করেছে: 8.87-এর বিপরীতে 10-এর মধ্যে 9.26। Grok-এর সবচেয়ে খারাপ স্কোর করা 10% অনুবাদের গড়ও ছিল 9.2, যেখানে Qwen-এর সবচেয়ে খারাপ স্কোর করা 10% কমে 7.6-এ নেমে এসেছে, যা শুধুমাত্র গড়ের মাধ্যমে বোঝা যাওয়ার চেয়েও নিম্ন প্রান্তে থাকা একটি বড় ব্যবধান।
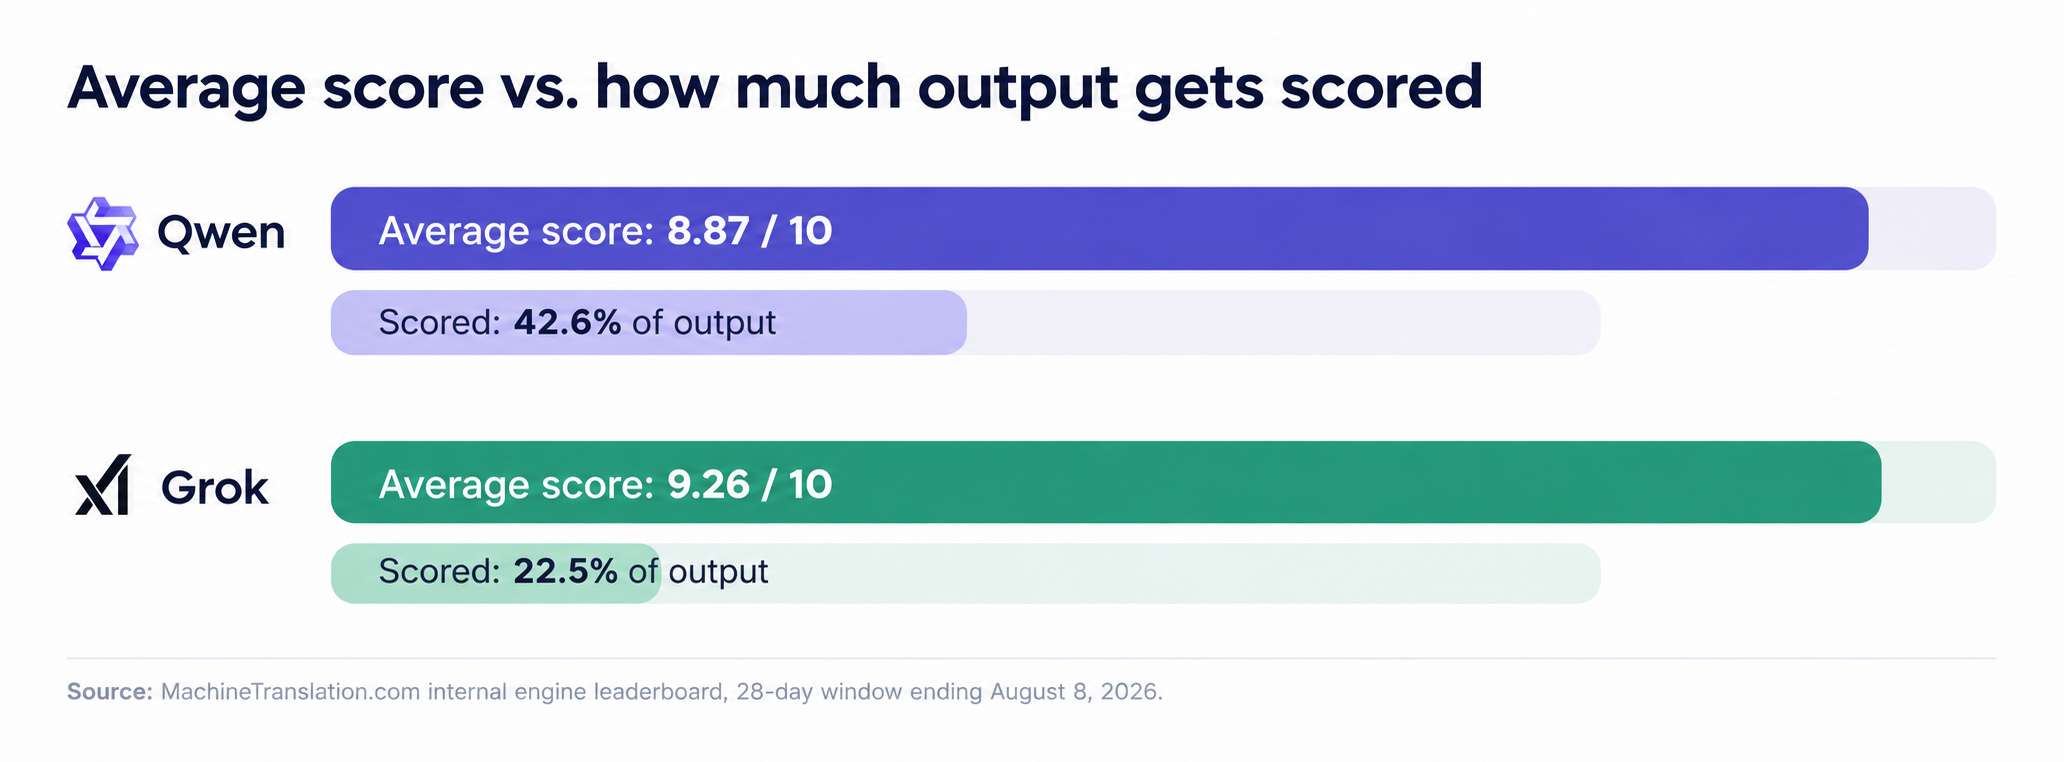
Grok-এর গড় স্কোর বেশি, তবে এটি এর আউটপুটের এক-চতুর্থাংশের কম স্কোরের ওপর ভিত্তি করে পাওয়া, যেখানে Qwen-এর ক্ষেত্রে তা প্রায় অর্ধেক। বার দুটি একই গল্পের ভিন্ন ভিন্ন অংশ তুলে ধরে।
| Qwen | Grok | |
|---|---|---|
| স্কোর করা আউটপুটের শতাংশ | 42.6% | 22.5% |
| গড় স্কোর | 8.87 / 10 | 9.26 / 10 |
| স্কোরের নিচের 10% | 7.6 | 9.2 |
সূত্র: MachineTranslation.com-এর অভ্যন্তরীণ ইঞ্জিন লিডারবোর্ড, August 8, 2026 তারিখে সমাপ্ত 28 দিনের উইন্ডো।
Grok-এর উচ্চতর স্কোর মানে কি এটি সেরা বিকল্প?
কেবল এর ভিত্তিতে নয়। প্ল্যাটফর্মে Qwen-এর তুলনায় Grok অনেক কম ব্যবহার করা হয় এবং এর অনুবাদের এক-চতুর্থাংশের চেয়েও কম স্কোর করা হয়, যেখানে Qwen-এর ক্ষেত্রে তা প্রায় অর্ধেক। একটি ছোট, কম প্রতিনিধিত্বমূলক নমুনা গড় স্কোরকে Qwen-এর সমপরিমাণ ভলিউমের তুলনায় ভালো বা খারাপ দেখাতে পারে। এই ডেটার উপর MachineTranslation.com-এর নিজস্ব রিপোর্টিং স্কোরিং কভারেজকে একটি প্রকৃত সীমাবদ্ধতা হিসেবে বিবেচনা করে, কোনো পাদটীকা হিসেবে নয়: যে ইঞ্জিনের ট্রাফিকের একটি সংকীর্ণ অংশের উপর স্কোর করা হয়েছে, সেটি এমন কোনো ইঞ্জিনের মতো পুঙ্খানুপুঙ্খভাবে পরীক্ষা করা হয়নি যার আউটপুটের প্রায় অর্ধেকের উপর স্কোর করা হয়েছে।
সঠিক বিশ্লেষণটি হলো Grok-এর সংখ্যাগুলো আশাব্যঞ্জক কিন্তু অপেক্ষাকৃত কম। Qwen-এর সংখ্যাগুলো গড়ে কম হলেও এটি অনেক বড় এবং অধিক প্রতিনিধিত্বমূলক ভিত্তির উপর প্রতিষ্ঠিত। কোনো তথ্যই অন্যটিকে বাতিল করে দেয় না।
ভাষা কভারেজ সম্পর্কে কী বলা যায়?
Qwen বা Grok কেউই এমন ভাষা জোড়াগুলোর কোনো যাচাইকৃত তালিকা প্রকাশ করে না যেখানে তাদের পারফরম্যান্স কমে যায়, এবং এটি নিশ্চিত করার জন্য কোনো স্বাধীন পরীক্ষাও নেই। আত্মবিশ্বাসের সাথে যা বলা যায় তা হলো, কোনো মডেলই নির্দিষ্ট ভাষার সেটে অনুবাদের মানের ওপর ভিত্তি করে তৈরি হয়নি যেভাবে একটি ডেডিকেটেড অনুবাদ প্ল্যাটফর্ম তৈরি হয়। MachineTranslation.com সরাসরি 270টিরও বেশি ভাষা পরীক্ষা এবং সাপোর্ট করে, যা একটি সাধারণ-উদ্দেশ্য মডেলের ব্যাপক অথচ অপরীক্ষিত বহুভাষিক সক্ষমতার দাবির চেয়ে সম্পূর্ণ ভিন্ন একটি দাবি।
MachineTranslation.com আসলে কীভাবে Qwen এবং Grok ব্যবহার করে
MachineTranslation.com প্রতিটি অনুবাদে Qwen, Grok এবং আরও 20টিরও বেশি AI মডেল চালায়, তারপর সেই সংস্করণটি সামনে নিয়ে আসে যেটির সাথে মডেলগুলো সবচেয়ে বেশি একমত হয়। গড়ে কম স্কোর করার জন্য কোনো মডেলকেই বাদ দেওয়া হয় না। একসাথে অনেকগুলি মডেল চালানোর মানে হলো সেই ক্ষেত্রগুলো ধরা যেখানে গড়ে কম স্কোর পাওয়া একটি মডেল এমন একটি নির্দিষ্ট বাক্য সঠিক অনুবাদ করে যা একটি বেশি স্কোর পাওয়া মডেল ভুল করে। Qwen-এর পারফরম্যান্স দিক (direction) এবং জোড়ার (pairing) ওপর ভিত্তি করেও বিভক্ত হয়, যা একটি একক মডেল বেছে নেওয়ার আগে জেনে রাখা ভালো, এই বিষয়টি MachineTranslation.com-এর Qwen বনাম DeepSeek তুলনায় আরও বিশদভাবে আলোচনা করা হয়েছে। মডেলগুলি কীভাবে সরাসরি একে অপরের বিপরীতে পরীক্ষা করা হয় তা আরও ঘনিষ্ঠভাবে দেখার জন্য, MachineTranslation.com-এর পূর্ণাঙ্গ মডেল তুলনামূলক পরীক্ষা দেখুন।
সচরাচর জিজ্ঞাসিত প্রশ্নাবলী
1. অনুবাদের জন্য Qwen নাকি Grok ভালো?
MachineTranslation.com-এর নিজস্ব 28-দিনের ইঞ্জিন ডেটাতে, Grok গড়ে Qwen-এর থেকে বেশি স্কোর করে, 10-এর মধ্যে 8.87-এর বিপরীতে 9.26। কিন্তু Grok-এর আউটপুটের একটি অনেক ছোট, কম প্রতিনিধিত্বমূলক অংশের উপর স্কোর করা হয়েছে, তাই এটি একটি ম্যাচড-সেগমেন্ট পরীক্ষার মতো নিখুঁত মুখোমুখি তুলনা নয়।
2. কেন Grok-এর গড় স্কোর বেশি কিন্তু স্কোর করা অনুবাদের সংখ্যা কম?
প্ল্যাটফর্মে Grok তুলনামূলকভাবে কম ব্যবহৃত হয় এবং এর আউটপুটের মাত্র 22.5% স্কোর পায়, যেখানে Qwen-এর ক্ষেত্রে তা 42.6%। একটি ছোট, কম প্রতিনিধিত্বমূলক নমুনা গড়কে বাড়িয়ে বা কমিয়ে দেখাতে পারে, যে কারণে এই তুলনাটিকে নির্দেশক হিসেবে ধরা উচিত, চূড়ান্ত নয়।
3. Qwen নাকি Grok বেশি ভাষা সাপোর্ট করে?
উভয়ই সাধারণ-উদ্দেশ্যমূলক AI মডেল, যেগুলোর ভাষা-নির্দিষ্ট সীমাবদ্ধতার কোনো প্রকাশিত, যাচাইকৃত তালিকা নেই। দুটির কোনোটিই বিশেষভাবে অনুবাদের জন্য তৈরি করা হয়নি, যা এমন একটি প্ল্যাটফর্মের চেয়ে আলাদা যা পরিমাপকৃত অনুবাদ পারফরম্যান্সের বিকল্প হিসেবে ব্যাপক বহুভাষিক প্রশিক্ষণের উপর নির্ভর না করে সরাসরি 270+ ভাষায় অনুবাদের মান পরীক্ষা এবং স্কোর করে।
4. MachineTranslation.com কি Qwen এবং Grok-এর সাথে প্রতিযোগিতা করে?
না। MachineTranslation.com প্রতিটি অনুবাদে Qwen, Grok এবং আরও 20 টিরও বেশি AI মডেল চালায় এবং সেই মডেলগুলো সবচেয়ে বেশি একমত হওয়া ভার্সনটি সামনে নিয়ে আসে। এটি নিজস্ব আলাদা মডেল হিসেবে এদের বিরুদ্ধে প্রতিযোগিতা করার পরিবর্তে এই ধরনের মডেলগুলোকে পরীক্ষা করে এবং একসাথে যুক্ত করে।
5. অনুবাদের জন্য MachineTranslation.com কোন AI মডেলটিকে সুপারিশ করে?
ডিফল্টভাবে কোনোটিই নয়। বিভিন্ন মডেল ভাষার জোড়া এবং কন্টেন্টের ধরন অনুযায়ী ভিন্ন পারফর্ম করে এবং কী অনুবাদ করা হচ্ছে তার উপর ভিত্তি করে এদের মধ্যেকার ব্যবধান যেকোনো দিকেই যেতে পারে। এই ভিন্নতার কারণেই প্ল্যাটফর্মটি স্থায়ী সুপারিশ হিসেবে কোনো একটিকে বেছে নেওয়ার পরিবর্তে প্রতিটি অনুবাদে একাধিক মডেল চালায়।