June 10, 2026
আমরা মূল্য প্রদানকারী ব্যবহারকারীদের আরও উন্নত এআই মডেল দিচ্ছি। এখানে কেন:
আমরা এই সপ্তাহে একটি সিদ্ধান্ত নিয়েছি যা আমি আপনাদের জানাতে চাই — এটি প্রকাশ করার পরে নয়, বরং এটি তৈরির সময়েই।
আমরা আমাদের বিভিন্ন স্তরের ব্যবহারকারীদের জন্য AI মডেল বরাদ্দ করার পদ্ধতিতে পরিবর্তন আনছি। MachineTranslation.com-এর পেইড ব্যবহারকারীরা শীঘ্রই শীর্ষস্থানীয় প্রদানকারী — OpenAI, Anthropic, Google, DeepSeek, এবং অন্যান্যদের থেকে আরও উন্নত AI মডেলগুলিতে অ্যাক্সেস পাবেন। ফ্রি ব্যবহারকারীরা সক্ষম, নির্ভরযোগ্য অনুবাদ পেতে থাকবেন — কিন্তু একই মডেলগুলি নয়। এই ফাঁকটি ইচ্ছাকৃত, এবং আমরা ঠিক কেন এই সিদ্ধান্তটি নিচ্ছি, আমি তা ব্যাখ্যা করতে চাই।
আমি এটিকে লাইভ হওয়া পর্যন্ত অপেক্ষা করে একটি পরিমার্জিত ঘোষণা হিসাবে পেশ করার চেয়ে বরং এখনই লিখতে চাই, যখন এর পেছনের যুক্তিগুলো টাটকা এবং সিদ্ধান্তটিও কিছুটা কাঁচা। সৎ সংস্করণটি আরও দরকারী।
সূচিপত্র
- কেন আমরা বেশ কিছুদিন ধরে এই বিষয়ে ভাবছি
- কী আমাদের মন পরিবর্তন করেছে: অভ্যন্তরীণ পরীক্ষা
- স্তরবিন্যাসের সৎ কারণ
- ব্যবহারকারীদের কাছে এটি কেমন দেখাবে
- আমরা এখনও যা বের করার চেষ্টা করছি
- সচরাচর জিজ্ঞাসিত প্রশ্নাবলী
কেন আমরা বেশ কিছুদিন ধরে এটি নিয়ে ভাবছি
MachineTranslation.com একবারে ২২টি এআই মডেল দিয়ে অনুবাদ করে এবং সেরা ফলাফলটি তুলে ধরতে একটি ঐক্যমত্য-ভিত্তিক পদ্ধতি ব্যবহার করে। আমরা যা করি তার মূল ভিত্তিই সবসময় এটা ছিল — কোনো একটি মডেলের উপর সবকিছু বাজি না ধরে, বরং একাধিকের মধ্যে তুলনা করা এবং আউটপুটগুলোকেই নিজেদের কথা বলতে দেওয়া।
এই পদ্ধতির একটি অস্বস্তিকর দিক হলো, এটি মডেলগুলোর মধ্যে গুণমানের পার্থক্যকে খুব স্পষ্ট করে তোলে। আমরা প্রতিদিন দেখি যে, সব মডেল সব লেখাকে সমানভাবে ভালোভাবে সামলাতে পারে না। এবং অনেক দিন ধরে, আমরা সেই পর্যবেক্ষণকে ব্যবহারকারীদের জন্য মডেল বরাদ্দ করার পদ্ধতিতে পরিবর্তন আনতে দিইনি।
সব মডেল সমান নয়, এবং এটি প্রমাণ করার জন্য আমাদের কাছে ডেটা আছে
কয়েক সপ্তাহ আগে, Rachelle (আমাদের AI প্রধান) আমাদের তৈরি করা একটি অভ্যন্তরীণ টুলের বিষয়ে বিস্তারিতভাবে বুঝিয়েছিলেন যা দিয়ে একযোগে একাধিক GPT মডেলের — যার মধ্যে GPT 4.1 nano, GPT 4.1 mini, GPT 5.4 mini, এবং অন্যান্য মডেল অন্তর্ভুক্ত — অনুবাদের গুণমান পরীক্ষা করা যায়। আপনি একই সোর্স টেক্সট ইনপুট করলে, প্রতিটি মডেলের আউটপুট পাশাপাশি দেখতে পাবেন।
এই টুলটি যা সঙ্গে সঙ্গে স্পষ্ট করে দেয়, তা হল: সহজ, ছোট, দৈনন্দিন টেক্সটের ক্ষেত্রে, আউটপুটগুলি প্রায় অভিন্ন। আপনি মিটিংটি বিকেল ৩টায়-এর মতো সহজ বাক্যের উপর ভিত্তি করে প্রিমিয়াম মডেলগুলির গুণমানের পক্ষে সত্যিই কোনো যুক্তি দিতে পারবেন না।
কিন্তু আসল ভাষাগত জটিলতার ক্ষেত্রে (বাগধারাযুক্ত বাক্যাংশ, নির্দিষ্ট ক্ষেত্রের পরিভাষা, দীর্ঘ নথি যেখানে হাজার হাজার শব্দ জুড়ে প্রসঙ্গ বজায় রাখতে হয়) মডেলগুলির মধ্যে ব্যবধান তৈরি হয়, এবং এটি এমনভাবে তৈরি হয় যা পেশাগতভাবে গুরুত্বপূর্ণ।
যেখানে নিম্ন-স্তরের মডেলগুলি নীরবে পিছিয়ে পড়ে
আমার মনে হয়, এটাই সেই অংশ যা নিয়ে অনুবাদ শিল্প যথেষ্ট সততার সাথে কথা বলে না। নিম্ন-স্তরের মডেলগুলি সাধারণত স্পষ্টভাবে ভুল অনুবাদ তৈরি করে না। তারা এমন অনুবাদ তৈরি করে যা আপাতদৃষ্টিতে ঠিক মনে হয়, কিন্তু তাতে এমন সূক্ষ্ম ভুল থাকে যা একজন বিষয়-বিশেষজ্ঞ (একজন আইনজীবী, একজন চিকিৎসা পেশাদার, একজন সিনিয়র লোকালাইজেশন ম্যানেজার) সঙ্গে সঙ্গে ধরে ফেলেন।
ভুল অর্থে উপস্থাপিত একটি শর্তমূলক বাক্যাংশ। একটি আইনি পরিভাষা, যা কোনো নির্দিষ্ট এখতিয়ারে একটি বিশেষ অর্থ বহন করে, তাকে তার দৈনন্দিন সমতুল্য শব্দে অনুবাদ করা হয়েছে। একটি দীর্ঘ নথির মাঝপথে ভাষারীতির বিচ্যুতি যা পুরো বিষয়টির পেশাদারি বিশ্বাসযোগ্যতাকে ক্ষুণ্ণ করে।
ব্যর্থতাটি নীরব। এবং পেশাদার অনুবাদে নীরব ব্যর্থতা ব্যয়বহুল হতে পারে।
যা আমাদের মন বদলে দিয়েছে: অভ্যন্তরীণ পরীক্ষা
আমরা অনুমানের উপর ভিত্তি করে এই সিদ্ধান্ত নিইনি। আমরা মডেলগুলিকে জটিল, বাগধারাযুক্ত উৎস টেক্সট (যে ধরণের কন্টেন্ট আমাদের পেশাদার ব্যবহারকারীদের আসলে অনুবাদ করার প্রয়োজন হয়) দিয়ে পরীক্ষা করেছি এবং আমরা ভাষাবিদদের দিয়ে আউটপুটগুলি মূল্যায়ন করিয়েছি।
ফলাফল স্পষ্ট ছিল। উন্নত মডেলগুলি সূক্ষ্মতা, ভাষারীতি এবং ক্ষেত্র-নির্দিষ্ট পরিভাষা ধারাবাহিকভাবে উন্নততরভাবে পরিচালনা করেছে। সস্তা মডেলগুলো সাধারণ ব্যবহারের জন্য যথেষ্টরও বেশি ছিল। দুটি ব্যবহারের ক্ষেত্রে সত্যিই ভিন্ন ভিন্ন সরঞ্জামের প্রয়োজন।
চারটি মডেল, একই বাক্য, খুব ভিন্ন ফলাফল
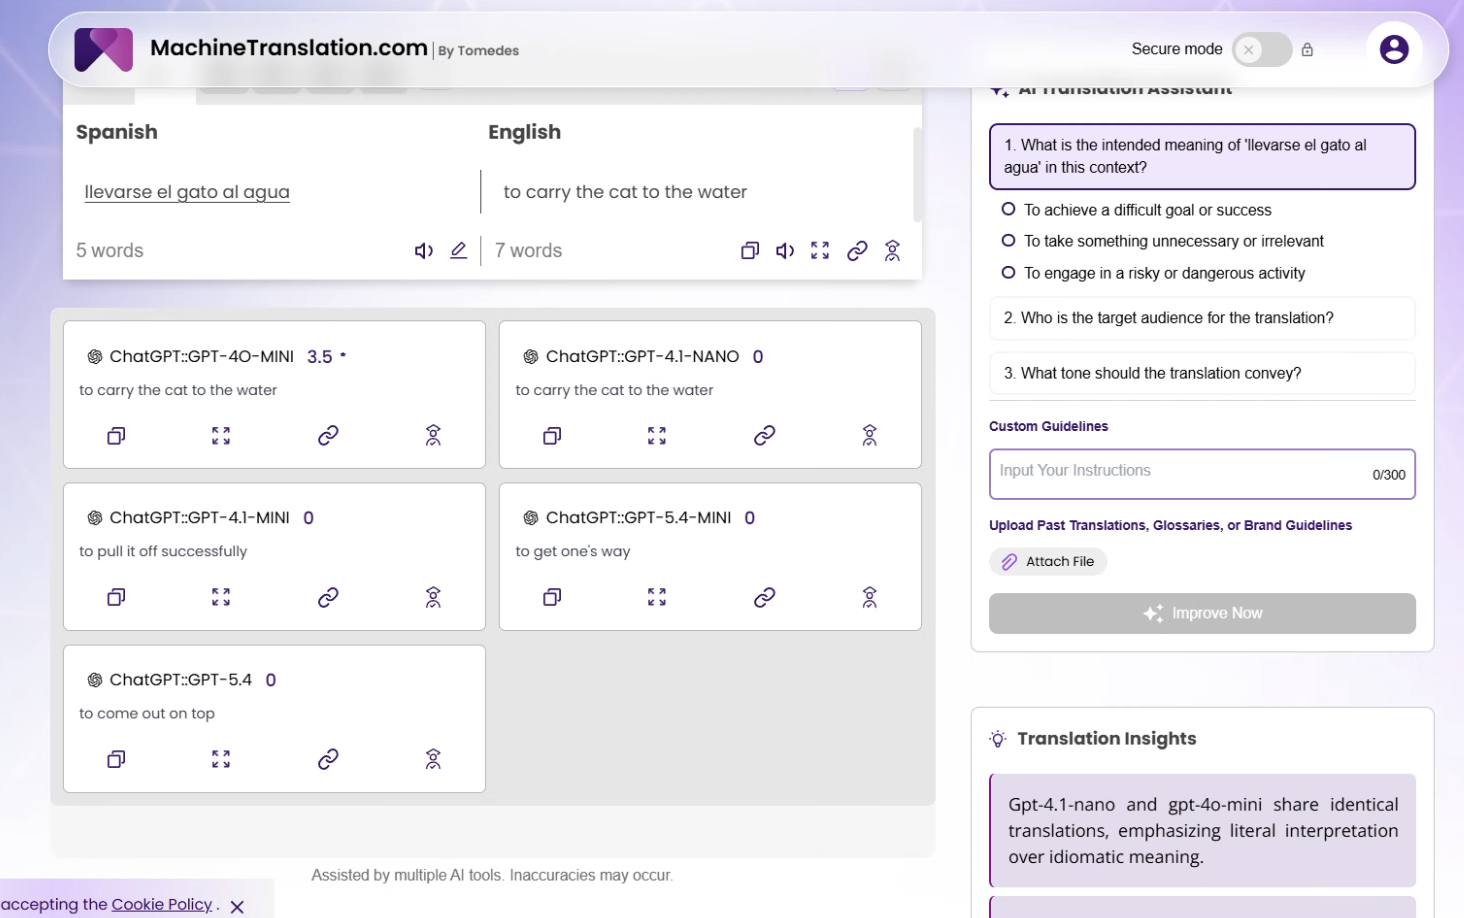
এর ফলে অভ্যন্তরীণভাবে যে কথোপকথন শুরু হয়েছিল, তা দাম নিয়ে ততটা ছিল না, যতটা ছিল সততা নিয়ে। আমরা যদি জানি যে মডেলগুলি পেশাদার-স্তরের কন্টেন্টে ভিন্নভাবে কাজ করে, এবং আমরা জানি যে আমাদের পেইড ব্যবহারকারীরা মূলত পেশাদার-স্তরের কন্টেন্টই অনুবাদ করেন, তাহলে একজন সাধারণ ইমেল অনুবাদকারী বিনামূল্যের ব্যবহারকারীর মতো তাদেরও একই মডেল দেওয়াটা উভয়ের প্রতিই অবিচার।{1][2}[3}স্তরবিন্যাসের আসল কারণ{4]{5][6}[7}ওফার{8] (আমাদের সিইও) আমাদের অভ্যন্তরীণ আলোচনায় পরিষ্কারভাবে বলেছেন:{1][6}[3}[12} নিম্ন-স্তরের মডেলগুলিতে জটিল বা বাগধারাযুক্ত টেক্সটের ক্ষেত্রে মানের আসল ঝুঁকি থাকে। কিন্তু বড় কথা হলো: ঐক্যমত্য ঠিক ততটাই ভালো, যতটা এর পেছনের মডেলগুলো। যখন অর্থপ্রদানকারী ব্যবহারকারীরা আরও উন্নত মডেল পান, তখন তারা শুধু উন্নততর ব্যক্তিগত আউটপুটই পাচ্ছেন না — তারা একটি শক্তিশালী ঐক্যমত্যও পাচ্ছেন। আরও ভালো মডেল, আরও ভালো ঐকমত্য, আরও নির্ভরযোগ্য অনুবাদ। পেশাদার-মানের অনুবাদের আসল মানে এটাই।
এই ধারণাটি আমার মনে গেঁথে গেছে। এটা শুধু খরচের যুক্তি নয়। এটি একটি স্পষ্টতার যুক্তি।
প্রিমিয়াম মডেল চালানোর প্রকৃত খরচ
বেশি সক্ষম এআই মডেলগুলি চালাতে প্রতি টোকেনে উল্লেখযোগ্যভাবে বেশি খরচ হয়। এটা MachineTranslation.com-এর কোনো নীতি নয়, সমস্ত প্রধান AI প্রদানকারী এভাবেই তাদের ফ্ল্যাগশিপ মডেলগুলির মূল্য নির্ধারণ করে। ওপেনএআই, অ্যানথ্রোপিক, গুগল, এবং ডিপসিক সকলেই তাদের সর্বশেষ, সবচেয়ে সক্ষম মডেলগুলি অর্থপ্রদানকারী গ্রাহকদের জন্য সংরক্ষিত রাখে কারণ সেই মডেলগুলি পরিচালনা করা উল্লেখযোগ্যভাবে বেশি ব্যয়বহুল। প্রতিটি বিনামূল্যে অনুবাদ, প্রতিটি সাধারণ প্রশ্ন, প্রতিটি এই সাইনবোর্ডে কী লেখা আছে জাতীয় অনুরোধের জন্য আমাদের সবচেয়ে উন্নত মডেলটি চালালে, আমাদের পরিকাঠামোগত খরচ উল্লেখযোগ্যভাবে বেড়ে যাবে।
আরও গুরুত্বপূর্ণ বিষয় হলো, এর অর্থ হবে, ১০,০০০-শব্দের প্রযুক্তিগত নথি অনুবাদকারী পেশাদারদের জন্য গুণমান বজায় রাখতে যে কম্পিউট বাজেট প্রয়োজন, তা দিয়ে কম-জটিল ব্যবহারের ক্ষেত্রগুলিতে ভর্তুকি দেওয়া। এটি একটি টেকসই বা যুক্তিযুক্ত বন্টন নয়।
কেন সব স্তরকে সমান বলে ভান করা কারও উপকারে আসে না
এই সিদ্ধান্তের একটি সংস্করণ আছে যা সম্পূর্ণরূপে মুনাফাভিত্তিক — বেশি চার্জ করুন, বেশি দিন, সহজ। আসলে সেটাই এর চালিকাশক্তি নয়।
এর চালিকাশক্তি হলো আমরা এমন একটি প্ল্যাটফর্ম তৈরি করেছি যা এআই মডেলগুলির মধ্যে গুণগত পার্থক্যকে সত্যিই তুলে ধরতে পারে। সেই পার্থক্যগুলো স্পষ্টভাবে দেখার জন্য আমাদের অভ্যন্তরীণ টুলিং আছে। আমাদের ব্যবহারকারী স্তরগুলি ডিজাইন করার সময় সেই দৃশ্যমানতাকে উপেক্ষা করা এক ধরনের অসততার সামিল হবে, এমন ভান করা যে ব্যবধানটির অস্তিত্ব নেই, যদিও আমাদের কাছে এর প্রমাণ আছে।
বিনামূল্যের ব্যবহারকারীরা কী পাচ্ছেন, তা তাদের জানার অধিকার আছে। অর্থপ্রদানকারী ব্যবহারকারীদের এটা জানার অধিকার আছে যে তারা অর্থপূর্ণভাবে ভিন্ন কিছু পাচ্ছেন। এবং পার্থক্যটি শুধু আরও উন্নত মডেলের অ্যাক্সেসই নয়, এটি সেই মডেলগুলি থেকে তৈরি একটি শক্তিশালী ঐকমত্যের অ্যাক্সেস। এটাই সেই নির্ভরযোগ্যতার সংকেত যা কোনো একক AI প্রদান করতে পারে না।
ব্যবহারকারীদের জন্য এটি কেমন হবে
আমরা এখনও বাস্তবায়নের বিবরণ নিয়ে কাজ করছি, তাই আমি নির্দিষ্ট বিষয়ে অতিরিক্ত প্রতিশ্রুতি না দেওয়ার ব্যাপারে সতর্ক থাকতে চাই। কিন্তু এই হল দিকনির্দেশনা।
যেখানে ফ্রি টিয়ার শক্তিশালী থাকবে
ফ্রি প্ল্যানের অনুবাদে সক্ষম AI মডেল ব্যবহার করা অব্যাহত থাকবে। দৈনন্দিন অনুবাদের বেশিরভাগ কাজের জন্য (ছোট বার্তা, সাধারণ পড়াশোনা, প্রাথমিক চিঠিপত্র), বিনামূল্যে ব্যবহারকারীরা সঠিক, নির্ভরযোগ্য আউটপুট পাবেন। এটা বদলাচ্ছে না।
ফ্রি টিয়ারটি রয়েছে কারণ আমরা বিশ্বাস করি যে ভাষা কোনো বাধা হওয়া উচিত নয়, এবং আমরা সেই অবস্থান থেকে সরে আসছি না।
যেখানে পেইড ব্যবহারকারীরা এগিয়ে থাকবেন
পার্থক্যটি সবচেয়ে বেশি দেখা যাবে:
| কন্টেন্টের ধরন | এখানে মডেলের গুণমান কেন গুরুত্বপূর্ণ |
|---|---|
| আইনি এবং আর্থিক নথি | শর্তাধীন ধারা, এখতিয়ার-নির্দিষ্ট পরিভাষা, রেজিস্টারের সামঞ্জস্য |
| প্রযুক্তিগত ডকুমেন্টেশন | ডোমেন-নির্দিষ্ট শব্দভান্ডার, দীর্ঘ ডকুমেন্টের মধ্যে সামঞ্জস্য |
| চিকিৎসা এবং ক্লিনিকাল টেক্সট | নির্ভুলতা, রেজিস্টার, অস্পষ্টতার প্রতি সংবেদনশীলতা |
| মার্কেটিং এবং ব্র্যান্ড কপি | প্রবাদ-প্রবচনের ব্যবহার, টোনের নির্ভুলতা, সাংস্কৃতিক অনুরণন |
| কম-রিসোর্স ভাষার জোড়া | কম প্রশিক্ষণ ডেটার অর্থ মডেলের গুণমানের বড় ব্যবধান |
| দীর্ঘ নথি (৫,০০০+ শব্দ) | প্রসঙ্গ ধরে রাখা, পুরো ডকুমেন্ট জুড়ে সামঞ্জস্য |
এই বিভাগগুলির যেকোনোটিতে কর্মরত পেশাদার ব্যবহারকারীদের জন্য, মডেল টিয়ারটি একটি বাস্তব পার্থক্য তৈরি করবে। ঠিক তাদের জন্যই আমাদের পেইড প্ল্যানগুলো তৈরি করা হয়েছে।
আর যেহেতু SMART-এর ঐক্যমত্য সেই আরও উন্নত মডেলগুলো থেকে তৈরি করা হয়েছে, তাই পেইড ব্যবহারকারীরা শুধু আরও ভালো ব্যক্তিগত আউটপুটই পাচ্ছেন না — তারা লেটেস্ট মডেলগুলোর একসাথে কাজ করার মাধ্যমে তৈরি আরও নির্ভরযোগ্য AI অনুবাদ পাচ্ছেন।
আমরা এখনও যা বের করার চেষ্টা করছি
আমি সত্যি বলতে চাই যে এই সবকিছুর সমাধান এখনও হয়নি।
আমরা এখনও সঠিক মডেল বরাদ্দ নির্ধারণ করছি — কোন মডেলগুলো কোন স্তরে থাকবে, এবং কীভাবে আমরা প্রোডাক্টের ভিতরে ব্যবহারকারীদের কাছে তা স্পষ্টভাবে জানাব। আমরা পেওয়ালের কার্যপ্রণালী নিয়ে কাজ করছি যাতে অভিজ্ঞতাটি নির্বিঘ্ন হয়, বিরক্তিকর নয়। এবং আমরা সাবধানে চিন্তা করছি যে কীভাবে ব্যবহারকারীদের কাছে মডেলের গুণমানের তথ্য এমনভাবে উপস্থাপন করা যায় যা শুধুমাত্র একটি বিপণন দাবি না হয়ে সত্যিই কার্যকর হবে।
এছাড়াও একটি বাস্তব প্রশ্ন রয়েছে যা নিয়ে আমরা ভাবছি: আমরা কীভাবে একজন বিনামূল্যের ব্যবহারকারীকে ঠিক সেই মুহূর্তে বুঝতে সাহায্য করতে পারি, যখন তারা এমন কোনো ব্যবহারের সম্মুখীন হয় যেখানে আপগ্রেড করলে তাদের আউটপুট অর্থপূর্ণভাবে উন্নত হবে? এটা যতটা প্রোডাক্টের চ্যালেঞ্জ, ততটাই ইউএক্স-এর চ্যালেঞ্জ, এবং আমাদের কাছে এখনও সম্পূর্ণ উত্তরটা নেই।
এটা লাইভ হলে কেমন সাড়া ফেলে, তা নিয়ে আমি লিখব। আপাতত, এটাই চিন্তাভাবনা।
আপনি যদি একজন পেইড ইউজার হন এবং মডেলের গুণমানের ক্ষেত্রে আপনার কাছে কোনটি সবচেয়ে গুরুত্বপূর্ণ সে বিষয়ে মতামত দিতে চান, তাহলে আমি সত্যিই আগ্রহী। MachineTranslation.com যোগাযোগ পৃষ্ঠার মাধ্যমে একটি বার্তা দিন।
সচরাচর জিজ্ঞাসিত প্রশ্নাবলী
1. কেন MachineTranslation.com মডেল বরাদ্দ করার পদ্ধতি পরিবর্তন করছে?
কারণ আমাদের অভ্যন্তরীণ পরীক্ষায় পেশাদার-স্তরের অনুবাদের কাজগুলিতে মডেল স্তরগুলির মধ্যে একটি অর্থপূর্ণ মানের ব্যবধান দেখা গেছে। আমরা একযোগে একাধিক AI মডেলের তুলনা করার জন্য একটি টুল তৈরি করেছি, এবং ডেটা থেকে বিষয়টি পরিষ্কার হয়ে গেছে: উন্নত মডেলগুলি জটিল, বাগধারাযুক্ত এবং ডোমেন-নির্দিষ্ট বিষয়বস্তু অনেক ভালোভাবে সামলাতে পারে। স্তর পরিবর্তনটি সেই বাস্তবতাকে সততার সাথে প্রতিফলিত করে। পেইড ব্যবহারকারীদের জন্য বৃহত্তর সুবিধা হলো এই যে, SMART কনসেনসাস আরও উন্নত মডেল থেকে তৈরি করা হয়, যার অর্থ নির্ভরযোগ্যতার সংকেতটি নিজেই আরও শক্তিশালী।
2. এটি চালু হলে কি ফ্রি প্ল্যানের অনুবাদ আরও খারাপ হয়ে যাবে?
না। ফ্রি প্ল্যানের ব্যবহারকারীরা দৈনন্দিন ব্যবহারের জন্য সক্ষম, নির্ভুল অনুবাদ পেতে থাকবেন। পরিবর্তনটি হল যে পেইড ব্যবহারকারীদের আরও উন্নত মডেলে আপগ্রেড করা হবে, এমনটা নয় যে বিনামূল্যে ব্যবহারকারীদের ডাউনগ্রেড করা হবে।
3. কোন ধরণের অনুবাদ প্রিমিয়াম AI মডেল থেকে সবচেয়ে বেশি উপকৃত হয়?
আইনি, আর্থিক, চিকিৎসা সংক্রান্ত, প্রযুক্তিগত এবং দীর্ঘ নথি — এবং কম প্রচলিত ভাষার জোড়ার যেকোনো কন্টেন্ট যেখানে প্রশিক্ষণের ডেটা কম থাকে। ছোট, সহজ, দৈনন্দিন টেক্সটের জন্য, মডেলের স্তরগুলির মধ্যে পার্থক্য ন্যূনতম। অর্থপ্রদানকারী ব্যবহারকারীদের জন্য বৃহত্তর সুবিধা হলো যে SMART consensus আরও উন্নত মডেল থেকে তৈরি করা হয়, যার অর্থ নির্ভরযোগ্যতার সংকেতটি নিজেই আরও শক্তিশালী।
4. এটা কখন লাইভ হবে?
আমরা এখন এটা তৈরি করছি। যখন এটি পাঠানো হবে, তখন আমি একটি আপডেট পোস্ট করব, যার মধ্যে থাকবে প্রোডাক্টে অভিজ্ঞতাটি কেমন দেখাচ্ছে এবং প্রাথমিক ডেটা কী দেখাচ্ছে।
5. MachineTranslation.com কীভাবে সিদ্ধান্ত নেয় যে একটি নির্দিষ্ট টেক্সটের জন্য কোন AI মডেলটি সেরা?
আমরা একযোগে একাধিক মডেল চালাই এবং আউটপুট মূল্যায়ন করার জন্য একটি ঐক্যমত্য-ভিত্তিক স্কোরিং পদ্ধতি ব্যবহার করি। আমাদের অভ্যন্তরীণ তুলনা টুলটি আমাদের একই উৎস টেক্সটের উপর মডেলের বিভিন্ন স্তরের গুণমান পরীক্ষা করতে দেয়, আর সেই তথ্যের ভিত্তিতেই এই স্তরবিন্যাসের সিদ্ধান্তটি নেওয়া হয়েছে। আপনি MachineTranslation.com.com ঐক্যমত্য সিস্টেম কীভাবে কাজ করে সে সম্পর্কে আরও জানতে পারেন।