September 9, 2026
Qwen vs DeepSeek: Hvilken AI-model oversætter bedst?
Kør de samme 12.000 oversættelsessegmenter igennem Qwen og DeepSeek, og DeepSeek vinder i størstedelen af sprogparrene. Det er ikke hele historien. Opdel resultaterne efter retning, og et specifikt mønster viser sig: Qwen lukker det meste af hullet og tager undertiden føringen, især når målsproget er engelsk. Ved oversættelse fra engelsk til andre sprog vinder DeepSeek næsten hver gang.
Den opdeling betyder mere end en enkelt samlet vinder, hvis du oversætter indhold på tværs af snesevis af sprog i stedet for kun ét sprogpar.
Hvad er Qwen og DeepSeek?
Qwen er Alibabas familie af store sprogmodeller. Den nuværende generation er Qwen3.8, udgivet i august 2026: Qwen3.8-Max er det lukkede flagskib, der kun er tilgængeligt via API, med 2,4 billioner parametre, mens Qwen3.8-27B er en mindre model med åbne vægte, der blev udgivet under Apache 2.0 få dage senere, henvendt til teams, der selv vil hoste.
DeepSeek er et kinesisk AI-laboratorium kendt for mixture-of-experts-modeller, der matcher førende ydeevne til en brøkdel af inferensomkostningerne. Dets nuværende generation, DeepSeek V4, blev lanceret i april 2026 i to varianter: V4 Pro (1,6 billioner parametre i alt, cirka 49 milliarder aktive pr. token) til kvalitetsfokuseret arbejde, og V4 Flash (284 milliarder i alt, cirka 13 milliarder aktive) til latensfølsomme arbejdsbelastninger. Begge leveres som MIT-licenserede åbne vægte.
Hvordan klarer Qwen og DeepSeek sig egentlig i forhold til hinanden inden for oversættelse, og ikke kun i benchmarks?
De fleste sammenligninger mellem Qwen og DeepSeek henviser til generelle benchmarks: kodning, matematik, ræsonnement. Ingen af disse måler oversættelseskvalitet direkte, og at køre hver model på forskellig kildetekst gør det umuligt at isolere eventuelle forskelle i nøjagtighed fra det, som selve teksten krævede.
MachineTranslation.coms egen oversættelsestrafik over de seneste 28 dage giver et klarere svar, fordi begge modeller oversatte den identiske kildetekst. På tværs af 98 sprogpar og mere end 12,000 matchede segmenter scorede DeepSeek højere i 83 par; Qwen scorede højere i 15. Hvis man indsnævrer det til de 27 par, hvor målsproget er engelsk, skrumper gabet markant: DeepSeek vinder 63% af dem (17 ud af 27), Qwen vinder 37% (10 ud af 27). På tværs af de resterende 71 par, hvor engelsk ikke er målsproget, vinder DeepSeek 92% (66 ud af 71).
Vinderrate efter oversættelsesretning (98 sprogpar, identisk tekst)
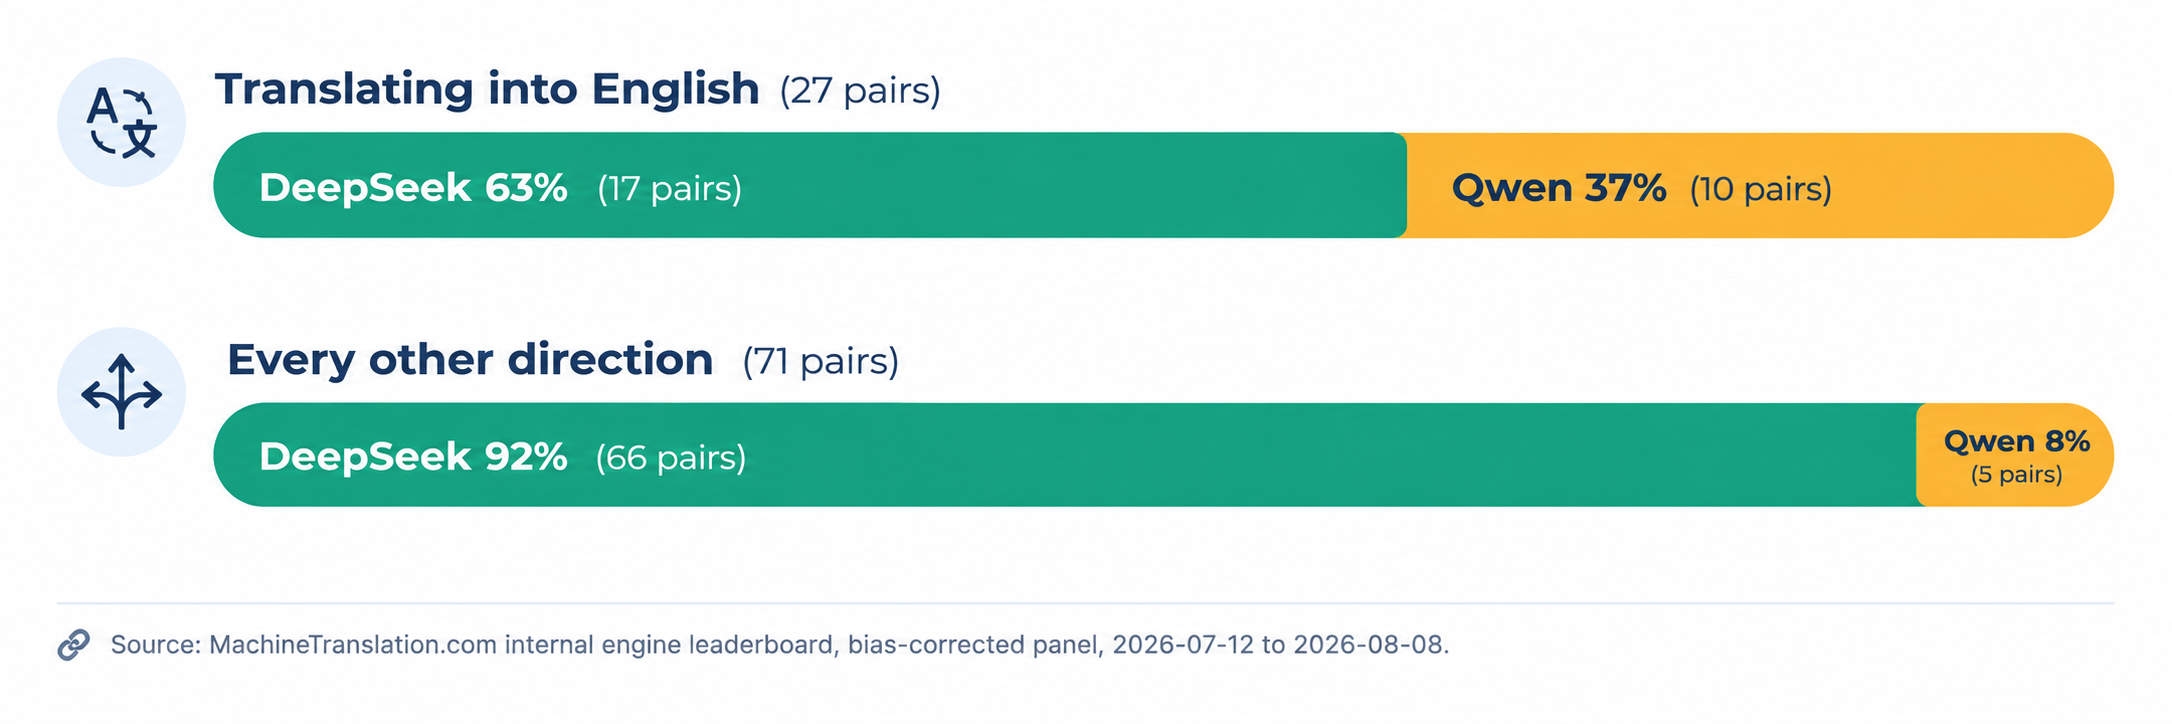
DeepSeek vinder det store flertal af sprogparrene samlet set. Qwens konkurrencevindue er snævert, men reelt: oversættelse til engelsk, hvor den tager mere end en tredjedel af parrene. Data: MachineTranslation.coms interne leaderboard, bias-korrigerede panel, July 12 to August 8, 2026.
Det vægtede gennemsnit på tværs af alle matchede segmenter placerer DeepSeek på 9.13 ud af 10 og Qwen på 8.98. Det er en reel forskel, men den er ikke jævnt fordelt, hvilket er det mest nyttige at vide, hvis dit indhold bevæger sig i mere end én retning. Dette er den samme head-to-head-metode, som MachineTranslation.com bruger på tværs af sin fulde modelsammenligningstest, ikke kun for dette ene par.
De samlede tal holder også i de enkelte testtilfælde. Ved test af den franske sætning "Elle est directrice adjointe du département commercial," nåede DeepSeek og Qwen frem til den samme engelske gengivelse, "deputy director of commercial department". Du kan tjekke det live-testresultat direkte. Ved test af "as soon as possible" oversat til spansk skilte DeepSeek sig ud fra konsensus blandt de fire modeller med "esté hecho" i stedet for "se haga", hvilket er et reelt afvigelsestilfælde , der afspejler en grammatisk skelnen mellem proces og resultat, ikke en fejl.
Hvorfor klarer Qwen sig specifikt bedre ved oversættelse til engelsk?
Dataene forklarer ikke hvorfor, kun hvor. Nogle af Qwens stærkeste par ind til engelsk er tamilsk, kinesisk, polsk, italiensk og hebraisk, som er kildesprog med store, veldokumenterede engelsksprogede træningskorpora, der generelt er tilgængelige for modeludviklere. Uden for den ene retning holder DeepSeeks fordel næsten overalt: både ud fra engelsk og mellem ikke-engelske sprogpar.
Hvad dette udelukker er at behandle nogen af modellerne som en universel standard. Et team, der oversætter produktbeskrivelser fra spansk til seks sprog og forventer den samme præstationsrangering, som de så ved at oversætte en kinesisk supporthenvendelse til engelsk, vil drage den forkerte lære af den forkerte retning, hvilket er den samme asymmetri, der viser sig i MachineTranslation.com's spansk-til-engelsk-modelopdeling, hvor de førende modeller ikke er de samme som dem, der fører i den omvendte retning.
Er Qwen og DeepSeek gratis og open-source?
Licenseringen fordeler sig forskelligt for hver. DeepSeek licenserer både V4 Pro og V4 Flash under MIT, som er en af de mest tilladende open-source-betingelser, der findes, så begge er gratis at hoste selv uden begrænsninger. Qwen er opdelt: Qwen3.8-27B leveres under Apache 2.0 og er gratis at hoste selv, men flagskibet Qwen3.8-Max forbliver lukket, udelukkende som API, og under Alibabas egen tilpassede licens.
I praksis betyder det, at der findes en fuldt open-weight, MIT-licenseret mulighed på DeepSeek-siden på begge kvalitetsniveauer. På Qwen-siden betyder det at vælge open-weight, at man må give afkald på flagskibsmodellen.
Hvad koster det at køre Qwen og DeepSeek i stor skala?
Efter DeepSeeks permanente prisnedsættelse i maj 2026 er de nuværende offentliggjorte API-takster $0.435 per million input tokens (cache miss) and $0.87 pr. million output-tokens for V4 Pro, mens V4 Flash er prissat lavere for sit latensoptimerede niveau.
For teams, der selv hoster en af modellerne i stedet for at bruge et hosted API, flyttes prisforholdet fuldstændigt over på GPU-infrastruktur og bliver en funktion af antallet af parametre og aktiv-parameter-effektivitet snarere end en takst pr. token.
Er en af modellerne sikker nok til juridisk, medicinsk eller reguleret indhold?
Ingen af modellerne offentliggør oversættelsesspecifikke sikkerhedscertificeringer, og generelle sikkerheds-benchmarks tester ikke for de fejltyper, der betyder noget i reguleret indhold: en fejloversat dosering, en ændret ansvarsklausul, et inkonsekvent juridisk begreb. MachineTranslation.com's egne test har fundet præcis denne type afvigelse mellem modeller på juridisk og medicinsk sprog, herunder tilfælde hvor modellerne brugte forskellige juridiske udtryk med forskelligt omfang , selvom begge scorede højt på generelle kvalitetsmålinger.
For kontrakter, immigrationsdokumenter eller klinisk indhold taler det for at parre begge modellers output med et menneskeligt verificeringstrin frem for at stole blindt på et enkelt AI-output, uanset hvilken model der har genereret det.
Hvad betyder det, hvis du lokaliserer til mange sprog på én gang?
En sammenligning baseret på ét sprogpar fortæller dig næsten ingenting om sprogpar nummer fyrre. Opdelingen i til-engelsk/fra-engelsk, der er dokumenteret her, holdt på tværs af en stikprøve på 98 par, netop fordi den blev testet i den skala: En enkelt engelsk-til-spansk test, hvilket er hvad de fleste Qwen mod DeepSeek-sammenligninger kører, ville have vist DeepSeek solidt i front og ikke sagt noget om, hvad der sker, når tamilsk, polsk eller hebraisk bliver en del af processen.
Det er det praktiske argument for ikke som standard at binde et stort lokaliseringsprogram til én enkelt models output. MachineTranslation.com kører både Qwen og DeepSeek, sammen med mere end 20 andre modeller, på hver oversættelse og fremhæver den version, som disse modeller er mest enige om, så en udrulning på 68 sprog ikke er afhængig af, hvilken model der tilfældigvis vandt det ene par, som nogen testede først. Du kan se præcis, hvilke modeller der var enige eller uenige om en given oversættelse, i den modelopdeling pr. oversættelse som platformen viser for hvert resultat.
Hver oversættelse bliver tjekket mod et bredere udvalg af modeller, end enten Qwen eller DeepSeek alene kan tilbyde, hvilket er det direkte svar på, hvad der sker, når dit indhold stopper med kun at bevæge sig i én retning.
Ofte stillede spørgsmål
1. Er Qwen eller DeepSeek bedst til oversættelse?
På tværs af 98 sprogpar testet på identisk kildetekst scorede DeepSeek højere i 83 af dem. Qwens sejre samler sig i én bestemt retning: oversættelse til engelsk, hvor den vinder omkring en tredjedel af tiden. I alle andre retninger vinder DeepSeek mere end 90% af tiden.
2. Er Qwen gratis at bruge?
Qwen3.8-27B er open-weight under Apache 2.0 og gratis at hoste selv. Flagskibet Qwen3.8-Max er lukket og kun tilgængeligt via Alibaba Clouds betalte API.
3. Er DeepSeek gratis at bruge?
Ja. Både DeepSeek V4 Pro og V4 Flash leveres med MIT-licenserede åbne vægte, så du kan hoste dem selv uden licensomkostninger. DeepSeek tilbyder også en betalt API til teams, der ikke ønsker selv at administrere deres infrastruktur.
4. Hvilken er hurtigst, Qwen eller DeepSeek?
DeepSeek V4 Flash er bygget specifikt til lav latenstid, med 13 milliarder aktive parametre pr. token mod V4 Pros 49 milliarder. Qwens tilsvarende lettere løsning, Qwen3.8-27B, er tæt snarere end mixture-of-experts, hvilket generelt gør den langsommere pr. token ved sammenlignelig kvalitet.
5. Kan jeg bruge Qwen og DeepSeek sammen til oversættelse?
Ja. MachineTranslation.com kører begge modeller, plus over 20 andre, på hver eneste oversættelse og fremhæver den version, de er mest enige om, så du ikke hænger fast i at vælge én model og håbe på, at den er det stærkeste valg til netop det sprogpar.
6. Hvad er forskellen på Qwen og DeepSeeks licensering?
DeepSeek licenserer begge V4-varianter under MIT, en af de mest tilladelige open-source-licenser, der findes. Qwen opdeler sit udvalg: mindre modeller som Qwen3.8-27B leveres under Apache 2.0, men flagskibet Qwen3.8-Max forbliver lukket under en tilpasset licens.