October 2, 2026
Qwen vs Grok: Hvilken AI-model oversætter bedst?
Qwen og Grok er begge generelle AI-modeller, ikke oversættelsesspecifikke værktøjer, og begge er en del af den pulje af modeller, som MachineTranslation.com kører ved hver oversættelse. Det har betydning for, hvordan det følgende skal læses. Dette er et kig på, hvordan to af platformens egne modeller klarer sig i forhold til hinanden, med de reelle forbehold der følger med den slags data, og ikke en konkurrence mellem to eksterne udfordrere og selve platformen. Hvad er Qwen og Grok? Qwen er Alibabas familie af store sprogmodeller, som i øjeblikket er i sin Qwen3.8-generation, og den blev tilføjet til MachineTranslation.coms modelpulje som en del af platformens løbende udvidelse. Grok er xAI's modellinje, i øjeblikket på Grok 4.7 i skrivende stund, som har gennemgået flere udgivelser siden den version, denne artikel oprindeligt sammenlignede, og som blev en del af platformen separat. Ingen af modellerne blev bygget specifikt til oversættelse. Begge er generelle systemer, der tilfældigvis håndterer mange sprog som en del af en bredere sproglig kapacitet, hvilket er et andet udgangspunkt end en platform, der er bygget og testet specifikt med henblik på oversættelseskvalitet. Hvordan klarer Qwen og Grok sig i forhold til hinanden på MachineTranslation.coms egne data? I løbet af de seneste 28 dages platformstrafik scorede Grok i gennemsnit højere end Qwen: 9.26 ud af 10 mod 8.87. Groks 10 % dårligst scorende oversættelser havde stadig et gennemsnit på 9.2, mens Qwens 10 % dårligst scorende faldt til 7.6, hvilket er en større kløft i bunden, end gennemsnittet alene antyder. Groks gennemsnitlige score er højere, men den baserer sig på en bedømmelse af mindre end en fjerdedel af dens output, mod næsten halvdelen for Qwen. De to søjler fortæller forskellige dele af den samme historie. Qwen Grok Procentdel af bedømt output 42.6% 22.5% Gennemsnitlig score
Hvad er Qwen og Grok?
Qwen er Alibabas familie af store sprogmodeller, aktuelt i sin Qwen3.8-generation, og blev tilføjet til MachineTranslation.coms modelpulje som en del af platformens løbende udvidelse. Grok er xAI's modellinje, der i skrivende stund aktuelt er på Grok 4.7, som har gennemgået flere udgivelser siden den version, denne artikel oprindeligt sammenlignede, og blev tilføjet til platformen separat. Ingen af modellerne blev bygget specifikt til oversættelse. Begge er systemer til generelle formål, der tilfældigvis håndterer mange sprog som en del af en bredere sproglig formåen, hvilket er et andet udgangspunkt end en platform, der er bygget og testet specifikt med fokus på oversættelseskvalitet.
Hvordan klarer Qwen og Grok sig i forhold til hinanden på MachineTranslation.com's egne data?
I løbet af de sidste 28 dages platformstrafik scorede Grok i gennemsnit højere end Qwen: 9.26 ud af 10 mod 8.87. Groks dårligst scorende 10% af oversættelserne lå stadig på et gennemsnit på 9.2, mens Qwens dårligst scorende 10% faldt til 7.6, hvilket er en større forskel i den lave ende, end gennemsnittet alene antyder.
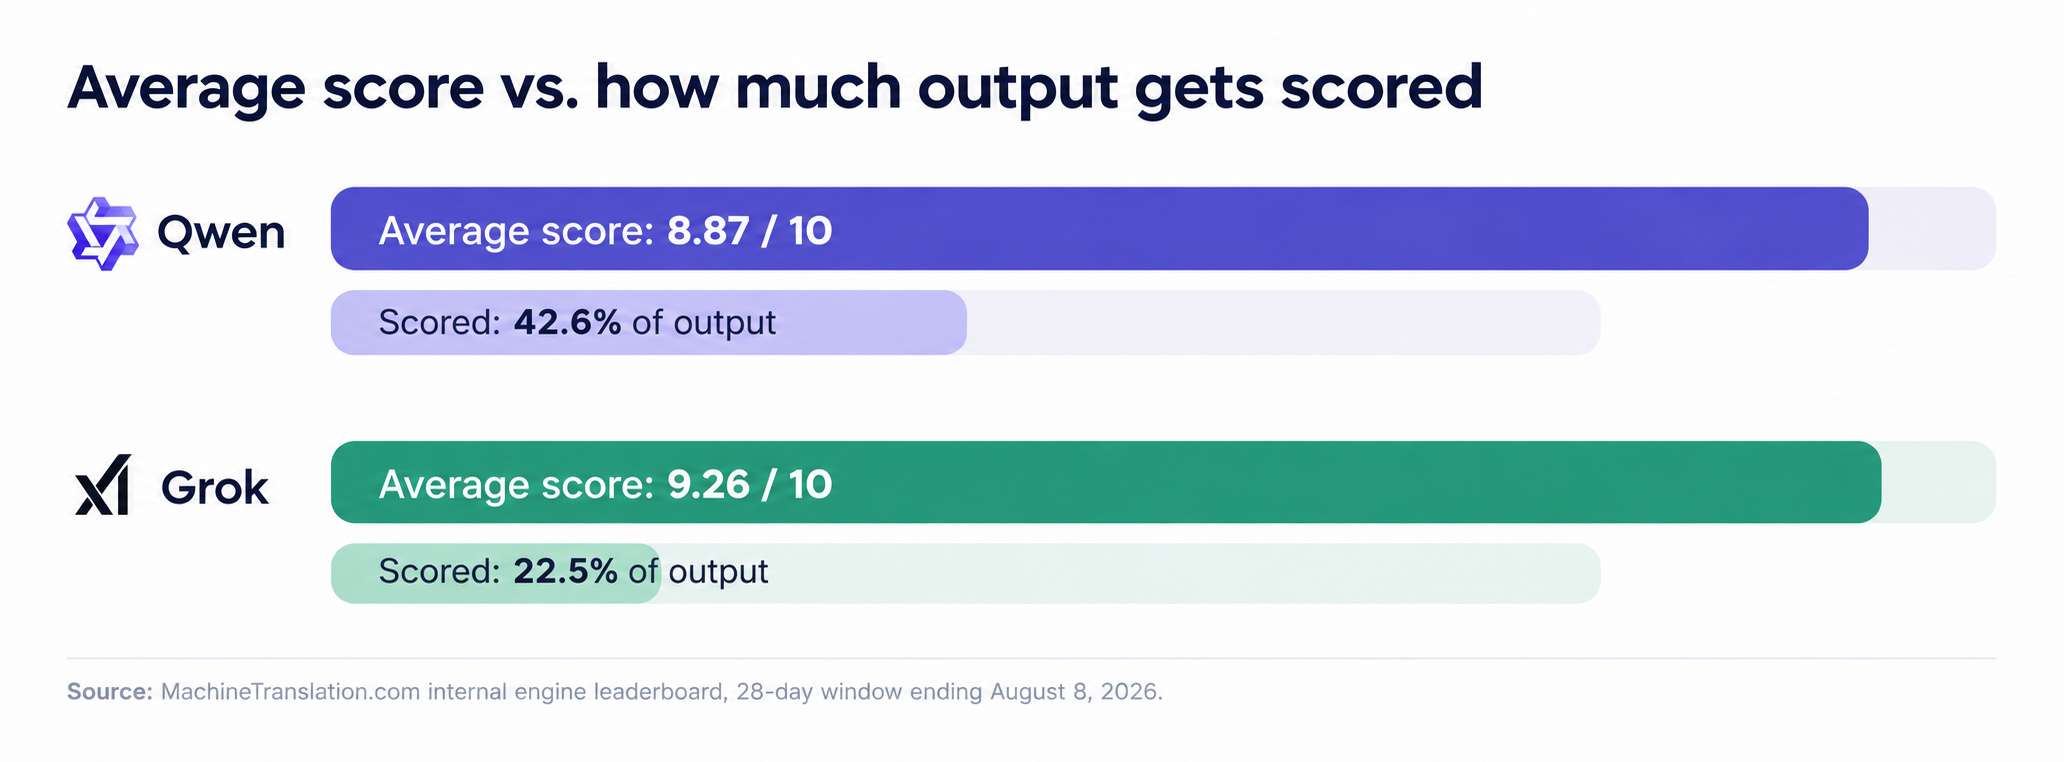
Groks gennemsnitsscore er højere, men den bygger på en bedømmelse af mindre end en fjerdedel af dens output, mod næsten halvdelen for Qwen. De to søjler fortæller forskellige dele af den samme historie.
| Qwen | Grok | |
|---|---|---|
| Procentdel af scoret output | 42.6% | 22.5% |
| Gennemsnitlig score | 8.87 / 10 | 9.26 / 10 |
| De laveste 10 % af scorerne | 7.6 | 9.2 |
Kilde: MachineTranslation.com's interne leaderboard for motorer, 28-dages periode, der slutter August 8, 2026.
Betyder Groks højere score, at det er det bedre valg?
Ikke i sig selv. Grok bruges langt sjældnere på platformen end Qwen, og mindre end en fjerdedel af dens oversættelser bliver overhovedet bedømt, mod næsten halvdelen af Qwens. En mindre, mindre repræsentativ stikprøve kan få et gennemsnit til at se bedre eller dårligere ud, end det ville ved samme volumen, som Qwen håndterer. MachineTranslation.com's egen rapportering af disse data behandler scoredækningen som en reel begrænsning, ikke en fodnote: en motor, der bedømmes på en snæver del af dens trafik, er ikke blevet testet lige så grundigt som en, der er bedømt på tværs af næsten halvdelen af sit output.
Den ærlige tolkning er, at Groks tal er lovende, men tyndere. Qwens er lavere i gennemsnit, men hviler på et meget større, mere repræsentativt grundlag. Ingen af disse kendsgerninger ophæver hinanden.
Hvad med sprogdækning?
Hverken Qwen eller Grok offentliggør en verificeret liste over sprogpar, hvor ydeevnen falder, og der findes ingen uafhængig test til at bekræfte en sådan. Hvad der med sikkerhed kan siges er, at ingen af modellerne blev bygget op omkring oversættelseskvalitet på tværs af et specifikt sprogsæt på samme måde, som en dedikeret oversættelsesplatform er. MachineTranslation.com tester og understøtter over 270 sprog direkte, hvilket er en anden slags påstand end en generel models brede, men utestede flersprogede kapacitet.
Hvordan MachineTranslation.com faktisk bruger Qwen og Grok
MachineTranslation.com kører Qwen, Grok og mere end 20 andre AI-modeller på hver oversættelse og fremhæver derefter den version, som disse modeller er mest enige om. Ingen af modellerne udelukkes for at score lavere i gennemsnit. At køre mange modeller på én gang betyder at fange de tilfælde, hvor en model, der scorer lavere i gennemsnit, alligevel får en specifik sætning rigtig, som en model, der scorer højere, misser. Qwens ydeevne opdeles også efter retning og parring på måder, der er værd at kende, før man vælger en enkelt model, hvilket dækkes mere dybdegående i MachineTranslation.com's Qwen vs DeepSeek-sammenligning. For et nærmere kig på, hvordan modeller testes direkte mod hinanden, se MachineTranslation.com's fulde test af modelsammenligninger.
Ofte stillede spørgsmål
1. Er Qwen eller Grok bedre til oversættelse?
På MachineTranslation.coms egne 28-dages motordata scorer Grok i gennemsnit højere end Qwen, 9.26 mod 8.87 ud af 10. Men Grok bliver bedømt på en meget mindre, mindre repræsentativ del af sit output, så dette er ikke en direkte sammenligning på den måde, som en test med matchende segmenter ville være det.
2. Hvorfor har Grok en højere gennemsnitsscore, men færre bedømte oversættelser?
Grok bruges sjældnere på platformen, og kun omkring 22.5% af dets output bliver bedømt, mod 42.6% for Qwen. En mindre, mindre repræsentativ stikprøve kan oppuste eller undervurdere et gennemsnit, hvilket er grunden til, at denne sammenligning bør læses som vejledende og ikke definitiv.
3. Understøtter Qwen eller Grok flere sprog?
Begge er generelle AI-modeller uden en offentliggjort, verificeret liste over sprogspecifikke begrænsninger. Ingen af dem er bygget specifikt til oversættelse, hvilket adskiller sig fra en platform, der direkte tester og bedømmer oversættelseskvalitet på tværs af 270+ sprog i stedet for at forlade sig på bred flersproget træning som erstatning for en målt oversættelsespræstation.
4. Konkurrerer MachineTranslation.com med Qwen og Grok?
Nej. MachineTranslation.com kører Qwen, Grok og mere end 20 andre AI-modeller på hver eneste oversættelse og præsenterer den version, som disse modeller er mest enige om. Den tester og kombinerer modeller som disse i stedet for at konkurrere mod dem som sin egen separate model.
5. Hvilken AI-model anbefaler MachineTranslation.com til oversættelse?
Ingen som standard. Forskellige modeller præsterer forskelligt afhængigt af sprogpar og indholdstype, og forskellen mellem dem kan gå i begge retninger afhængigt af, hvad der oversættes. Netop denne variation er grunden til, at platformen kører flere modeller på hver oversættelse frem for at vælge én som en fast anbefaling.