May 8, 2026
Grok vs. Claude για μετάφραση: τι δείχνουν τα benchmarks (2026)
Το Grok (xAI) και το Claude (Anthropic) είναι και τα δύο ικανά εργαλεία μετάφρασης AI, αλλά έχουν δομικά διαφορετικά δυνατά σημεία. Για τις περισσότερες γενικές μεταφραστικές εργασίες, δεν θα παρατηρήσετε ουσιαστική διαφορά μεταξύ τους. Για δύο συγκεκριμένα σενάρια (τη μετάφραση περιεχομένου σχετικά με πρόσφατα γεγονότα και τη μετάφραση επίσημων εγγράφων που απαιτούν ακρίβεια), η διαφορά είναι πραγματική και βασίζεται στον τρόπο με τον οποίο κατασκευάστηκε το κάθε μοντέλο.
Αυτό το άρθρο καλύπτει τι προσφέρει πραγματικά το κάθε μοντέλο για τη μετάφραση, πού τα κατατάσσουν τα ανεξάρτητα benchmarks και τι να χρησιμοποιήσετε όταν το αποτέλεσμα κανενός από τα δύο μοντέλα από μόνο του δεν είναι επαρκές.
Πώς συγκρίνονται το Grok και το Claude όσον αφορά την ποιότητα μετάφρασης;
Η σύντομη απάντηση: Το Claude ηγείται στα ανεξάρτητα επαγγελματικά benchmarks μετάφρασης. Το συγκεκριμένο πλεονέκτημα του Grok είναι η πρόσβαση σε γνώση σε πραγματικό χρόνο, όχι η συνολική ποιότητα μετάφρασης.
Στα εσωτερικά benchmarks του MachineTranslation.com, το Claude (επίπεδο 3.5 Sonnet) συγκεντρώνει βαθμολογία 93.8 στα 100 στην ποιότητα μετάφρασης — ακρίβεια, ορολογία και ύφος συνδυαστικά. Το Grok δεν εμφανίζεται στις 14 κορυφαίες λύσεις στην έκθεση State of Translation Automation 2025 της Intento, η οποία αξιολόγησε 46 MT engines και LLMs σε 11 γλωσσικά ζευγάρια. Το Claude Opus 4 και το Claude Sonnet 3.7 εμφανίζονται και τα δύο στο top 14. Πηγή: Εσωτερικά benchmarks του MachineTranslation.com· Intento State of Translation Automation 2025.
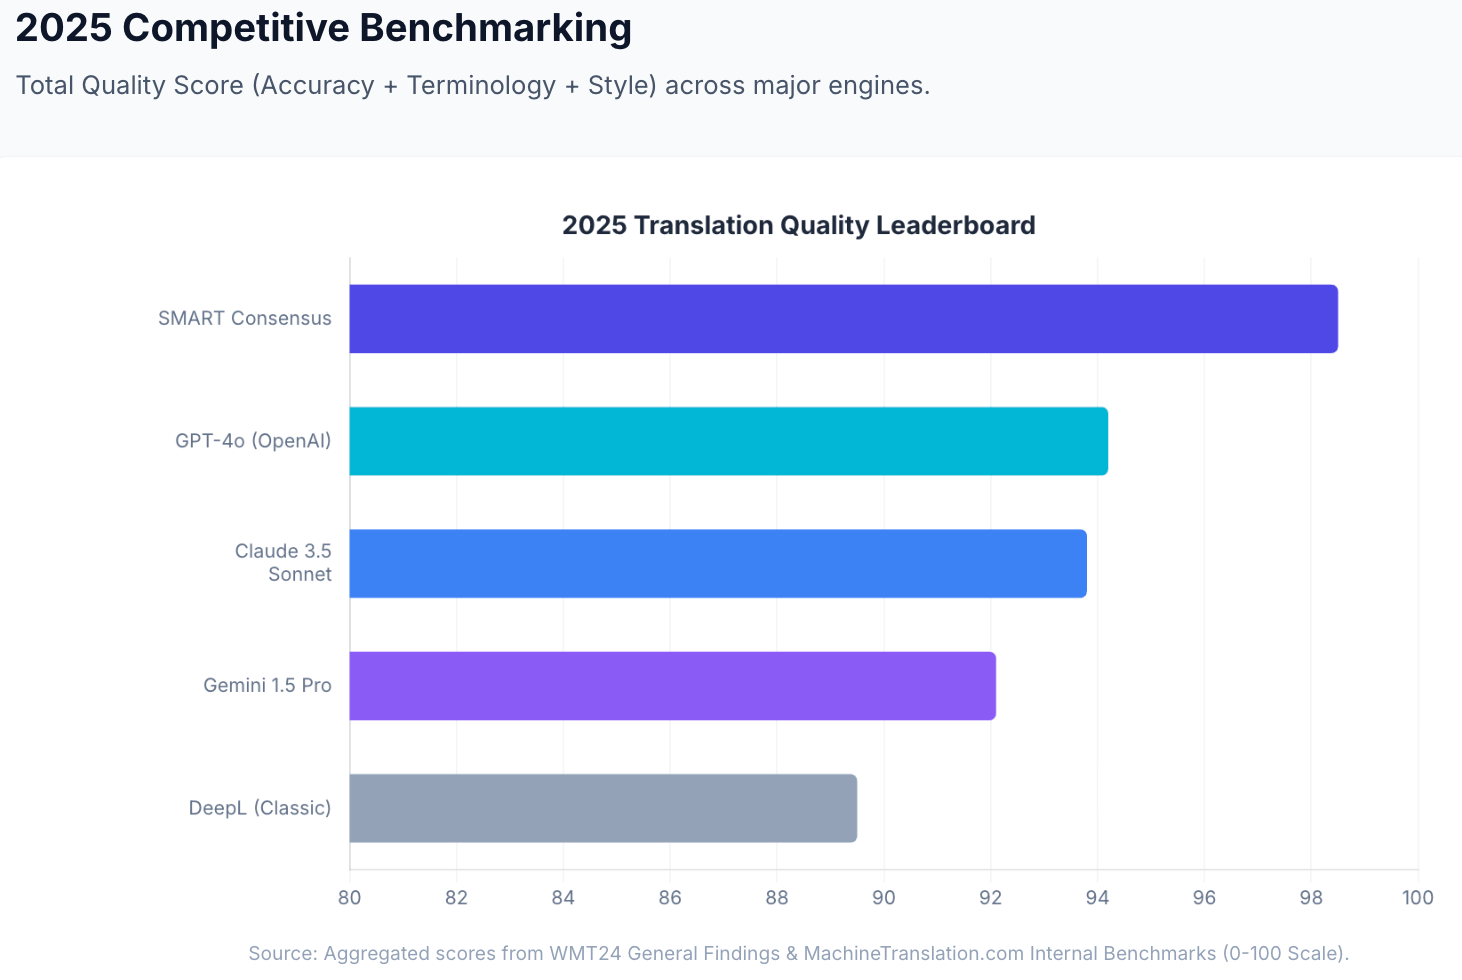
Στο WMT24 (τον κύριο ανεξάρτητο διαγωνισμό benchmark του μεταφραστικού κλάδου), το Claude 3.5 κατετάγη πρώτο σε 9 από τα 11 γλωσσικά ζεύγη, μπροστά από το GPT-4 και τις εξειδικευμένες νευρωνικές μηχανές MT. Στην τυφλή μελέτη της Lokalise για το 2025 από επαγγελματίες μεταφραστές, το 78% των μεταφράσεων του Claude 3.5 αξιολογήθηκε ως «καλό» — το υψηλότερο από οποιοδήποτε LLM που δοκιμάστηκε.
Το Grok δεν έχει αξιολογηθεί στο WMT24 ή στην ανεξάρτητη αξιολόγηση LQA της Intento σε συγκρίσιμο επίπεδο. Το Slator Pro Guide (2025) συμπεριλαμβάνει το Grok ως ένα από τα LLMs γενικής χρήσης που χρησιμοποιούνται για μετάφραση σε επαγγελματικά περιβάλλοντα, παράλληλα με το GPT και το Claude, αλλά δεν το κατατάσσει υψηλότερα από κανένα από τα δύο.
| Benchmark | Grok | Claude |
|---|---|---|
| MachineTranslation.com εσωτερική βαθμολογία ποιότητας | Δεν μετρήθηκε σε επίπεδο benchmark | 93.8/100 (επίπεδο 3.5 Sonnet) |
| Intento 2025 κορυφαίες 14 λύσεις | Δεν περιλαμβάνεται | Claude Opus 4, Sonnet 3.7 περιλαμβάνονται και τα δύο |
| WMT24 ζεύγη γλωσσών | Δεν αξιολογήθηκε | 1ο σε 9/11 ζεύγη γλωσσών |
| Lokalise 2025 τυφλή μελέτη | Δεν αξιολογήθηκε | 78% καλό (το υψηλότερο από οποιοδήποτε LLM) |
Πηγή: Εσωτερικά benchmarks του MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Πού έχει το Grok πραγματικό πλεονέκτημα;
Μετάφραση σε πραγματικό χρόνο και επικαιρότητας. Το καθοριστικό αρχιτεκτονικό χαρακτηριστικό του Grok είναι η ενσωμάτωσή του με τα δεδομένα της πλατφόρμας X (πρώην Twitter) και τη ζωντανή αναζήτηση στο διαδίκτυο. Σε αντίθεση με το Claude και τα περισσότερα άλλα LLMs, τα οποία εκπαιδεύονται σε στατικά σύνολα δεδομένων με σταθερά χρονικά όρια γνώσης, το Grok ενσωματώνει πληροφορίες σε πραγματικό χρόνο στα αποτελέσματά του. Για μεταφραστικές εργασίες που αφορούν πρόσφατα γεγονότα, νεοκυκλοφόρητα προϊόντα, αναδυόμενη πολιτική ορολογία, τρέχουσες ειδήσεις ή περιεχόμενο που αναφέρεται σε γεγονότα που συνέβησαν τις τελευταίες εβδομάδες, το Grok έχει πρόσβαση σε πλαίσιο πληροφοριών που το Claude δεν διαθέτει.
Αυτό είναι ιδιαίτερα σημαντικό για: τη μετάφραση ειδησεογραφικών άρθρων σχετικά με πρόσφατα γεγονότα, την τοπικοποίηση ανακοινώσεων προϊόντων για ταχέως μεταβαλλόμενες αγορές, τον χειρισμό νεοδημιουργηθείσας ορολογίας ή αργκό που είναι μεταγενέστερη των δεδομένων εκπαίδευσης άλλων μοντέλων, και για οποιοδήποτε περιεχόμενο όπου το νόημα εξαρτάται από τη γνώση του τι συνέβη πρόσφατα.
Αναδυόμενη και εξελισσόμενη ορολογία. Οι τεχνικοί τομείς, οι βιομηχανίες και τα πολιτισμικά πλαίσια παράγουν συνεχώς νέα ορολογία. Για μεταφραστικές εργασίες που περιλαμβάνουν πρόσφατα επινοημένους όρους, νέα ρυθμιστική γλώσσα ή νέα ονοματολογία προϊόντων, η ενημερωμένη εκπαίδευση και η αναζήτηση σε πραγματικό χρόνο του Grok τού δίνουν πρόσβαση σε μοτίβα χρήσης που παλαιότερα στιγμιότυπα δεδομένων εκπαίδευσης δεν αποτυπώνουν.
context window και συλλογιστική του Grok 4.1. Το Grok 4.1 (στα τέλη του 2025) διαθέτει context window 131K-token και βελτιωμένες δυνατότητες συλλογιστικής, καθιστώντας το ικανό σε πολύπλοκα, πολυεπίπεδα έγγραφα όπου οι σχέσεις μεταξύ των προτάσεων και η λογική συνοχή έχουν σημασία.
Πού έχει το Claude ένα πραγματικό πλεονέκτημα;
Ποιότητα μετάφρασης σε ανεξάρτητα benchmarks. Το πλεονέκτημα του Claude τεκμηριώνεται από ανεξάρτητη επαγγελματική αξιολόγηση και όχι από αυτοαναφερόμενους ισχυρισμούς. Το WMT24 κατέταξε το Claude 3.5 στην πρώτη θέση σε 9 από τα 11 γλωσσικά ζευγάρια έναντι ολόκληρου του ανταγωνισμού. Η τυφλή μελέτη του Lokalise για το 2025 διαπίστωσε ότι οι επαγγελματίες μεταφραστές προτίμησαν το αποτέλεσμα του Claude 3.5 σε ποσοστό καλό 78% — υψηλότερο από τα GPT-4, DeepL και Google Translate στην ίδια αξιολόγηση. Αυτές είναι τυφλές αξιολογήσεις: επαγγελματίες μεταφραστές αξιολόγησαν το αποτέλεσμα χωρίς να γνωρίζουν ποιο μοντέλο το παρήγαγε.
Συγκεκριμένα γλωσσικά ζεύγη ανά Intento 2025. Τα Claude Opus 4 και Sonnet 3.7 εμφανίζονται στην κατηγορία best για Αγγλικά προς Γερμανικά, Αγγλικά προς Ιαπωνικά, Αγγλικά προς Ιταλικά, Αγγλικά προς Κορεατικά, Αγγλικά προς Ολλανδικά, Αγγλικά προς Αραβικά και Αγγλικά προς Γαλλικά στην ανθρώπινη αξιολόγηση LQA της Intento. Για αυτά τα ζευγάρια, το Claude είναι η ισχυρότερη τεκμηριωμένη επιλογή μεταξύ των δύο.
Ακρίβεια ύφους και περιεχόμενο με λεπτές αποχρώσεις. Οι επαγγελματίες μεταφραστές στη μελέτη της Lokalise προτίμησαν το αποτέλεσμα του Claude στο υψηλότερο ποσοστό από οποιοδήποτε άλλο LLM — αντικατοπτρίζοντας την τεκμηριωμένη ικανότητα του Claude στη διατήρηση του ύφους, της συγγραφικής φωνής και του πλαισιακού νοήματος. Για τη λογοτεχνική μετάφραση, τα νομικά έγγραφα, την επίσημη επικοινωνία και τα κείμενα μάρκετινγκ, όπου ο τρόπος με τον οποίο λέγεται κάτι έχει εξίσου μεγάλη σημασία με το τι λέγεται, το Claude αποδίδει σταθερά καλά σε ανεξάρτητες αξιολογήσεις.
Συνοχή μακροσκελών εγγράφων. Το Claude 4.6 Sonnet υποστηρίζει ένα 200K-token context window, με το Claude Opus 4.6 να υποστηρίζει 1M tokens σε beta. Για μακροσκελή επίσημα έγγραφα (συμβόλαια, τεχνικά εγχειρίδια, εκθέσεις κλινικών δοκιμών), το Claude μπορεί να επεξεργαστεί ολόκληρο το έγγραφο σε ένα μόνο πέρασμα, διατηρώντας τη συνέπεια της ορολογίας καθ' όλη τη διάρκεια. Τα έγγραφα που επεξεργάζονται σε τμήματα παρουσιάζουν κατά 28% υψηλότερο ποσοστό ορολογικής ασυνέπειας σε σύγκριση με την επεξεργασία ολόκληρου του εγγράφου. Πηγή: Εσωτερικά δεδομένα του MachineTranslation.com.
Πώς συγκρίνονται όσον αφορά την υποστήριξη γλωσσών και την τιμολόγηση;
Υποστήριξη γλωσσών: Τόσο το Grok 4.1 όσο και το Claude 4.6 υποστηρίζουν μετάφραση στις περισσότερες κύριες γλώσσες του κόσμου. Το Claude έχει αξιολογηθεί ανεξάρτητα σε ευρωπαϊκά και ανατολικοασιατικά γλωσσικά ζευγάρια με ισχυρά αποτελέσματα. Η πολυγλωσσική υποστήριξη του Grok έχει βελτιωθεί στις διαδοχικές εκδόσεις. Για γλώσσες χαμηλών πόρων, και τα δύο μοντέλα παρουσιάζουν υποβάθμιση της ποιότητας — ο ανθρώπινος έλεγχος είναι κατάλληλος για περιεχόμενο σε γλωσσικά ζεύγη χαμηλών πόρων, ανεξάρτητα από το ποιο μοντέλο χρησιμοποιείται.
Τιμολόγηση:
| Πρόγραμμα | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Καταναλωτικό (μηνιαίο) | SuperGrok: $30/μήνα | Claude Pro: $20/μήνα |
| Είσοδος API (ανά M tokens) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Έξοδος API (ανά M tokens) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Δωρεάν επίπεδο | Ναι (με περιορισμό ρυθμού μέσω X/Grok.com) | Ναι (με περιορισμό ρυθμού μέσω claude.ai) |
Στο καταναλωτικό επίπεδο, το Claude Pro ($20/month) is cheaper than SuperGrok ($30/μήνα). Σε επίπεδο API, το Grok 4.1 έχει ένα μικρό πλεονέκτημα κόστους έναντι του Claude Sonnet 4.6 για ροές εργασίας μετάφρασης με μεγάλο όγκο εισόδου.
Ποιο είναι καλύτερο για συγκεκριμένους τύπους περιεχομένου;
| Τύπος περιεχομένου | Συνιστώμενο μοντέλο | Λόγος |
|---|---|---|
| Πρόσφατες ειδήσεις / τρέχοντα γεγονότα | Grok | Πρόσβαση σε δεδομένα σε πραγματικό χρόνο· τα μοντέλα στατικής εκπαίδευσης στερούνται τρέχοντος πλαισίου |
| Αναδυόμενη ορολογία / λανσαρίσματα νέων προϊόντων | Grok | Η ενσωμάτωση ζωντανής αναζήσθησης αποτυπώνει πρόσφατα μοτίβα χρήσης |
| Επίσημα νομικά έγγραφα | Claude | Ανεξάρτητη αξιολόγηση WMT24 και Lokalise 2025· ακρίβεια τόνου |
| Ιατρικό / κλινικό περιεχόμενο | Claude | Θέση σε ανεξάρτητα benchmark· διατήρηση του επιπέδου ύφους |
| Κείμενα μάρκετινγκ / δημιουργικό περιεχόμενο | Claude | Προτίμηση σε τυφλή μελέτη Lokalise 2025· τονικές αποχρώσεις |
| Τεχνική τεκμηρίωση (εκτενής) | Claude | Παράθυρο πλαισίου 200K-1M· συνέπεια ορολογίας σε όλο το μήκος |
| Μέσα κοινωνικής δικτύωσης / περιεχόμενο συνομιλίας | Οποιοδήποτε από τα δύο | Και τα δύο χειρίζονται καλά ζεύγη συνομιλίας υψηλών πόρων |
| Ενσωμάτωση προγραμματιστή / API | Οποιοδήποτε από τα δύο | Και τα δύο προσφέρουν πρόσβαση σε API· το Grok είναι ελαφρώς φθηνότερο στα token εισόδου |
Τι να χρησιμοποιήσετε όταν ένα μοντέλο δεν είναι αρκετό
Τόσο το Grok όσο και το Claude είναι εργαλεία ενός μόνο μοντέλου. Κάθε μεμονωμένο μοντέλο AI (ανεξάρτητα από το πόσο ικανό είναι) παράγει σφάλματα που δεν μπορεί να εντοπίσει στη δική του έξοδο. Μια ρέουσα και γεμάτη αυτοπεποίθηση μετάφραση είτε από το Grok είτε από το Claude μπορεί παρ' όλα αυτά να είναι σημασιολογικά λανθασμένη, και χωρίς διασταύρωση δεν υπάρχει τρόπος να το γνωρίζει κανείς.
Τόσο το Grok όσο και το Claude συγκαταλέγονται στα 22 μοντέλα στο σύστημα SMART του MachineTranslation.com. Το SMART τρέχει και τα 22 μοντέλα ταυτόχρονα (συμπεριλαμβανομένων των Grok και Claude) και επιστρέφει το αποτέλεσμα στο οποίο συμφωνεί η πλειοψηφία.
Τι σημαίνει αυτό για το ερώτημα Grok vs. Claude: Η ισχύς σε πραγματικό χρόνο του Grok και το βάθος πλαισίου του Claude συμβάλλουν και τα δύο στην ίδια συναίνεση. Όταν συμφωνούν, αυτή η συμφωνία αποτελεί ισχυρό σήμα ποιότητας.
Στα εσωτερικά benchmarks του MachineTranslation.com, τα μεμονωμένα μοντέλα κορυφαίας κατηγορίας συγκεντρώνουν βαθμολογία 93-94 στα 100 στην ποιότητα μετάφρασης. Η έξοδος συναίνεσης του SMART φτάνει το 98.5/100. Πηγή: Εσωτερικά benchmarks του MachineTranslation.com και WMT24 General Machine Translation Findings.
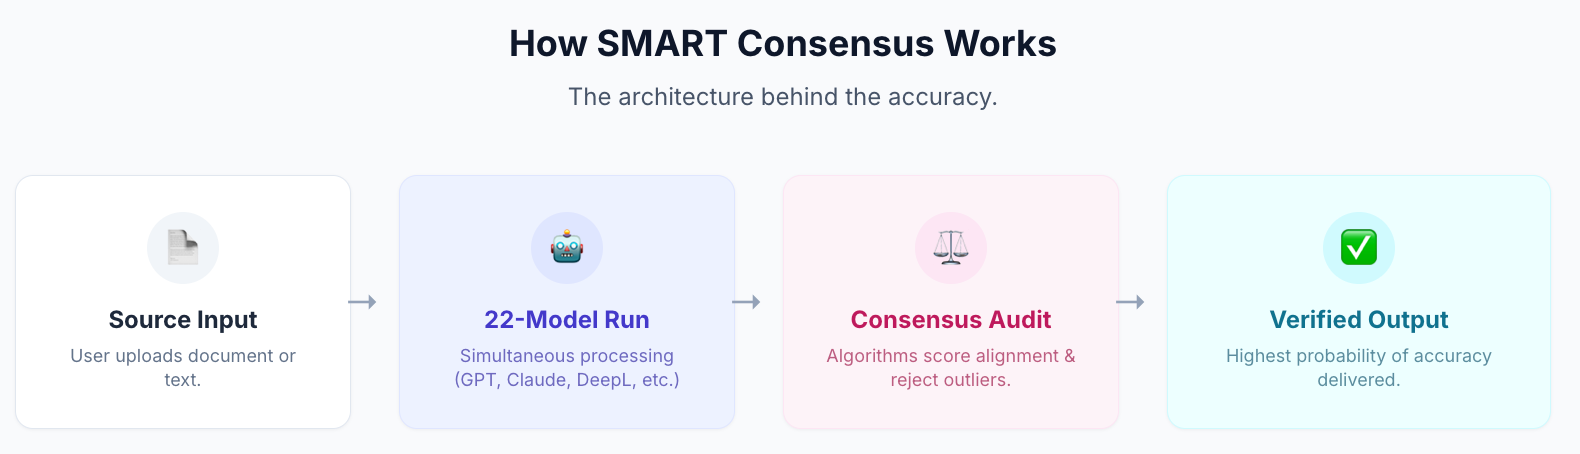
Οι χρήστες που μετέβησαν από μετάφραση μίας μόνο μηχανής στο SMART αφιέρωσαν 27% λιγότερο χρόνο για την επαλήθευση και τη διόρθωση των αποτελεσμάτων. Πηγή: Εσωτερικά δεδομένα του MachineTranslation.com.
Για περιεχόμενο κρίσιμης σημασίας (νομικά έγγραφα, κανονιστικές υποβολές, ιατρικές οδηγίες), η Ανθρώπινη Επαλήθευση κλιμακώνει τη συναίνεση SMART σε έναν πιστοποιημένο επαγγελματία αξιολογητή εντός της ίδιας πλατφόρμας. Χωρίς εξωτερικό φορέα. Εγγυημένη ακρίβεια 100%.
Μεταφράστε με Grok, Claude και 20 άλλα μοντέλα στο MachineTranslation.com — δωρεάν, δεν απαιτείται εγγραφή.
Συχνές ερωτήσεις
1. Είναι το Grok καλύτερο από το Claude για μετάφραση;
Για τις περισσότερες τυπικές μεταφραστικές εργασίες, το Claude προηγείται σε ανεξάρτητα benchmarks: πρώτο σε 9 από 11 γλωσσικά ζεύγη στο WMT24, αξιολόγηση good 78% στην τυφλή μελέτη του Lokalise για το 2025, και 93.8/100 στα εσωτερικά benchmarks ποιότητας του MachineTranslation.com. Το ιδιαίτερο πλεονέκτημα του Grok αφορά περιεχόμενο που απαιτεί γνώση της επικαιρότητας· η πρόσβασή του σε δεδομένα σε πραγματικό χρόνο τού δίνει ένα πλαίσιο που τα μοντέλα στατικής εκπαίδευσης, συμπεριλαμβανομένου του Claude, δεν διαθέτουν. Για πρόσφατες ειδήσεις, αναδυόμενη ορολογία και χρονικά ευαίσθητο περιεχόμενο, το Grok είναι η ισχυρότερη επιλογή.
2. Ποιο είναι το πλεονέκτημα του Grok έναντι του Claude για τη μετάφραση;
Το Grok ενσωματώνει δεδομένα σε πραγματικό χρόνο από το X (πρώην Twitter) και ζωντανή αναζήτηση στο διαδίκτυο. Σε αντίθεση με το Claude και τα περισσότερα άλλα LLMs που έχουν εκπαιδευτεί σε στατικά datasets, το Grok μπορεί να έχει πρόσβαση σε πληροφορίες σχετικά με πρόσφατα γεγονότα, νεοδημιουργηθείσα ορολογία και το τρέχον πλαίσιο κατά την παραγωγή μεταφράσεων. Αυτό το καθιστά ιδιαίτερα ισχυρότερο για τη μετάφραση ειδησεογραφικού περιεχομένου, πρόσφατα κυκλοφορημένων προϊόντων και οποιουδήποτε υλικού όπου το νόημα εξαρτάται από γεγονότα ή γλωσσικά μοτίβα των τελευταίων εβδομάδων.
3. Ποιο είναι το πλεονέκτημα του Claude έναντι του Grok για τη μετάφραση;
Το πλεονέκτημα του Claude τεκμηριώνεται μέσω ανεξάρτητης επαγγελματικής αξιολόγησης. Το Claude 3.5 κατετάγη πρώτο σε 9 από τα 11 γλωσσικά ζευγάρια στο WMT24, και οι επαγγελματίες μεταφραστές στην τυφλή μελέτη της Lokalise για το 2025 προτίμησαν το αποτέλεσμά του σε ποσοστό 78% ως «καλό» — το υψηλότερο από οποιοδήποτε LLM που δοκιμάστηκε. Το Claude εμφανίζεται επίσης στις κορυφαίες 14 λύσεις της Intento σε πολλαπλά γλωσσικά ζεύγη στην ανθρώπινη αξιολόγηση LQA, ενώ το Grok όχι. Για επίσημες, επαγγελματικές και υψηλού ρίσκου μεταφραστικές εργασίες, η ανεξάρτητη θέση του Claude στα benchmark είναι ο τεκμηριωμένος παράγοντας διαφοροποίησης.
4. Ποιο είναι καλύτερο για νομική μετάφραση, το Grok ή το Claude;
Το Claude είναι η ισχυρότερη επιλογή για νομική μετάφραση βάσει ανεξάρτητης αξιολόγησης. Το Claude 3.5 κατέλαβε την πρώτη θέση στα περισσότερα ευρωπαϊκά γλωσσικά ζεύγη υψηλών πόρων στο WMT24 και έλαβε τις υψηλότερες αξιολογήσεις προτίμησης σε τυφλή μελέτη από επαγγελματίες μεταφραστές. Για νομικό περιεχόμενο που απαιτεί πιστοποιημένη ακρίβεια, κανένα μοντέλο από μόνο του δεν είναι επαρκές — το Human Verification του MachineTranslation.com παρέχει 100% ακρίβεια από έναν πιστοποιημένο επαγγελματία αξιολογητή εντός της ίδιας πλατφόρμας, χωρίς να απαιτείται εξωτερικός πάροχος.
5. Είναι τόσο το Grok όσο και το Claude διαθέσιμα στο MachineTranslation.com;
Ναι. Και τα δύο συγκαταλέγονται στα 22 μοντέλα του συστήματος SMART του MachineTranslation.com. Κάθε SMART μετάφραση τρέχει τα Grok, Claude και 20 άλλα μοντέλα ταυτόχρονα, επιστρέφοντας το αποτέλεσμα στο οποίο συμφωνεί η πλειοψηφία. Αντί να επιλέξετε ανάμεσά τους, λαμβάνετε τη συναίνεση όλων των μοντέλων AI.
6. Πώς συγκρίνονται οι Grok και Claude όσον αφορά την τιμολόγηση;
Στο επίπεδο καταναλωτή, το Claude Pro κοστίζει $20/month versus SuperGrok at $30/μήνα. Σε επίπεδο API, το Grok 4.1 είναι ελαφρώς φθηνότερο στα tokens εισόδου ($2/M vs. $3/M για το Claude Sonnet 4.6) και εξόδου ($10/M vs. $15/M). Το δωρεάν πρόγραμμα του MachineTranslation.com περιλαμβάνει και τα δύο μοντέλα ως μέρος της συναίνεσης 22 μοντέλων του SMART, χωρίς να απαιτείται εγγραφή.
7. Ποιο μοντέλο AI είναι το καλύτερο για τη μετάφραση ειδησεογραφικών άρθρων;
Για τη μετάφραση ειδησεογραφικών άρθρων, το Grok έχει ένα δομικό πλεονέκτημα: η ενσωμάτωση δεδομένων σε πραγματικό χρόνο σημαίνει ότι διαθέτει το τρέχον πλαίσιο αναφοράς για τα γεγονότα που περιγράφονται, το οποίο ενδέχεται να λείπει από μοντέλα στατικής εκπαίδευσης. Για γενική μετάφραση ειδήσεων όπου η επικαιρότητα δεν είναι κρίσιμη, η benchmark απόδοση του Claude είναι ισχυρότερη. Για μετάφραση ειδήσεων μεγάλου όγκου, όπου τόσο η επικαιρότητα όσο και η ακρίβεια έχουν σημασία, το SMART του MachineTranslation.com εκτελεί και τα δύο μοντέλα και επιστρέφει το αποτέλεσμα της συναίνεσής τους.