October 2, 2026
Qwen vs Grok: Ποιο μοντέλο AI μεταφράζει καλύτερα;
Τα Qwen και Grok είναι και τα δύο μοντέλα τεχνητής νοημοσύνης γενικής χρήσης, όχι εξειδικευμένα εργαλεία μετάφρασης, και αποτελούν αμφότερα μέρος του συνόλου μοντέλων που εκτελεί το MachineTranslation.com σε κάθε μετάφραση. Αυτό έχει σημασία για τον τρόπο με τον οποίο πρέπει να ερμηνεύσετε τα παρακάτω. Πρόκειται για μια ματιά στο πώς αποδίδουν δύο από τα μοντέλα της ίδιας της πλατφόρμας το ένα απέναντι στο άλλο, με τις πραγματικές επιφυλάξεις που προκύπτουν από αυτού του είδους τα δεδομένα, και όχι για μια αναμέτρηση μεταξύ δύο εξωτερικών ανταγωνιστών και της ίδιας της πλατφόρμας.
Τι είναι τα Qwen και Grok;
Qwen είναι η οικογένεια μεγάλων γλωσσικών μοντέλων της Alibaba, που αυτή τη στιγμή βρίσκεται στη γενιά Qwen3.8, και προστέθηκε στο σύνολο μοντέλων του MachineTranslation.com στο πλαίσιο της συνεχιζόμενης επέκτασης της πλατφόρμας. Grok είναι η σειρά μοντέλων της xAI, που βρίσκεται στην έκδοση Grok 4.7 τη στιγμή που γράφονται αυτές οι γραμμές, έχοντας περάσει από πολλές εκδόσεις από την έκδοση που συνέκρινε αρχικά αυτό το άρθρο, και εντάχθηκε στην πλατφόρμα ξεχωριστά. Κανένα από τα δύο μοντέλα δεν δημιουργήθηκε ειδικά για μετάφραση. Και τα δύο είναι συστήματα γενικής χρήσης που τυχαίνει να χειρίζονται πολλές γλώσσες ως μέρος μιας ευρύτερης γλωσσικής ικανότητας, το οποίο αποτελεί διαφορετική αφετηρία από μια πλατφόρμα που έχει κατασκευαστεί και δοκιμαστεί ειδικά με γνώμονα την ποιότητα της μετάφρασης.
Πώς συγκρίνονται τα Qwen και Grok στα δεδομένα του ίδιου του MachineTranslation.com;
Τις τελευταίες 28 ημέρες επισκεψιμότητας της πλατφόρμας, το Grok σημείωσε υψηλότερη μέση βαθμολογία από το Qwen: 9.26 στα 10 έναντι 8.87. Το 10% των μεταφράσεων του Grok με τη χαμηλότερη βαθμολογία είχε μέσο όρο 9.2, ενώ το αντίστοιχο 10% του Qwen έπεσε στο 7.6, μια ευρύτερη διαφορά στο χαμηλότερο άκρο από αυτήν που υποδηλώνει ο μέσος όρος από μόνος του.
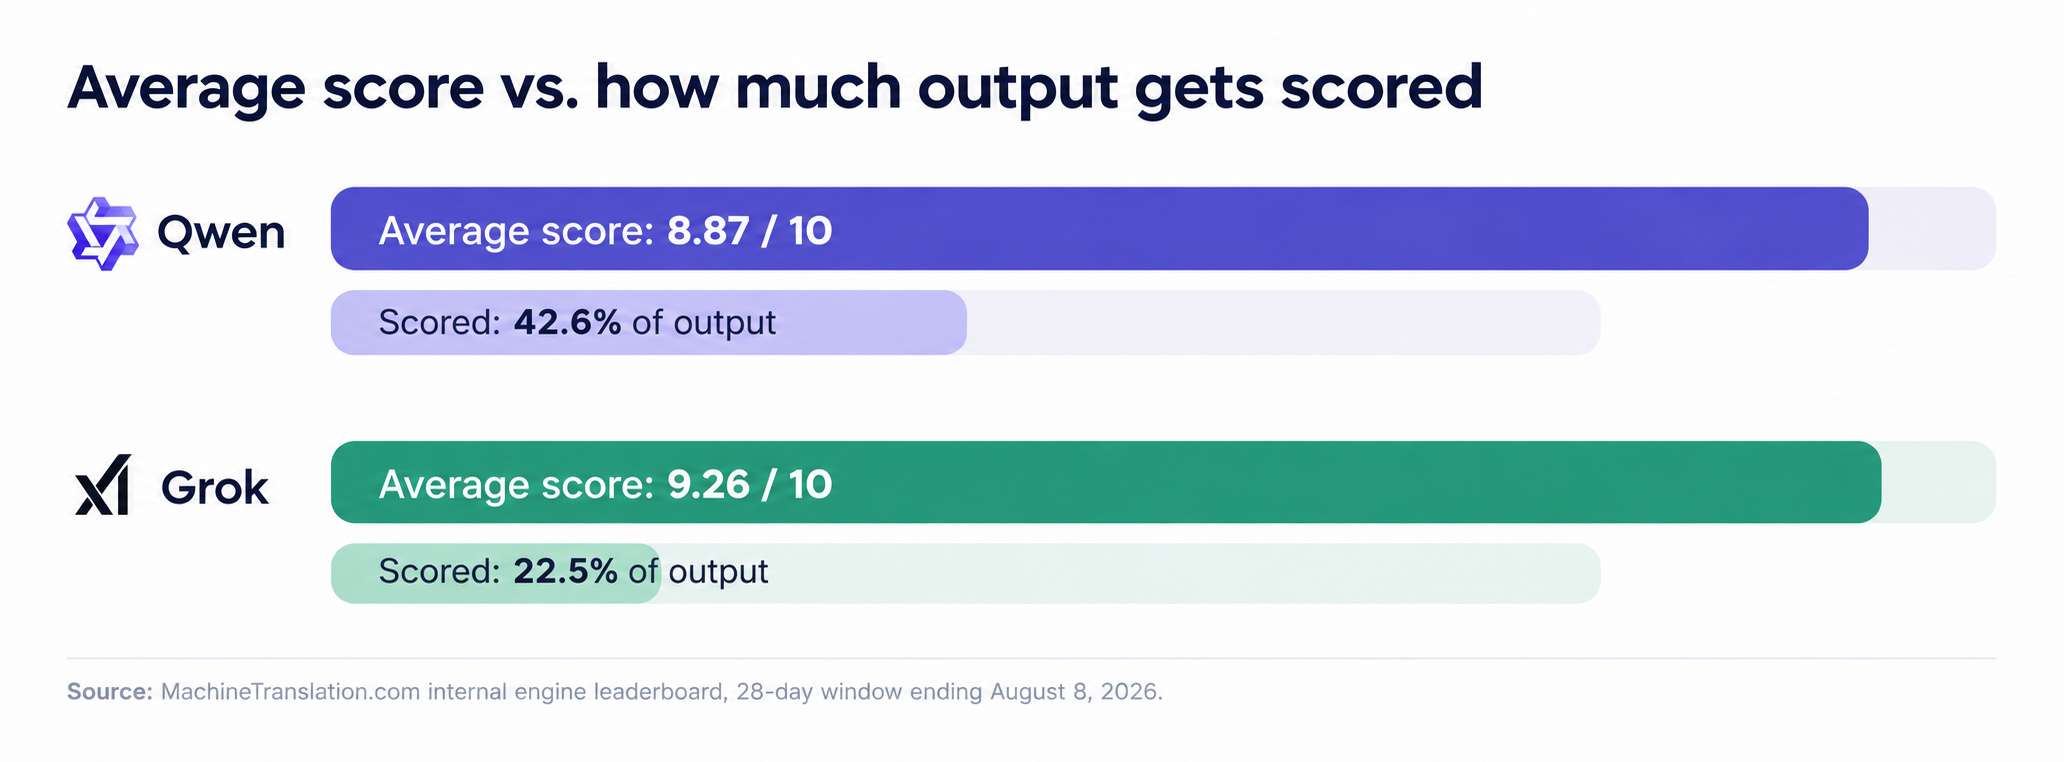
Η μέση βαθμολογία του Grok είναι υψηλότερη, αλλά βασίζεται στη βαθμολόγηση λιγότερου από το ένα τέταρτο των αποτελεσμάτων του, έναντι σχεδόν του μισού για το Qwen. Οι δύο ράβδοι αφηγούνται διαφορετικά μέρη της ίδιας ιστορίας.
| Qwen | Grok | |
|---|---|---|
| Ποσοστό αποτελεσμάτων που βαθμολογήθηκε | 42.6% | 22.5% |
| Μέση βαθμολογία | 8.87 / 10 | 9.26 / 10 |
| Το κατώτερο 10% των βαθμολογιών | 7.6 | 9.2 |
Πηγή: Εσωτερικός πίνακας κατάταξης μηχανών του MachineTranslation.com, παράθυρο 28 ημερών που λήγει στις August 8, 2026.
Η υψηλότερη βαθμολογία του Grok σημαίνει ότι είναι η καλύτερη επιλογή;
Όχι από μόνη της. Το Grok χρησιμοποιείται πολύ λιγότερο συχνά στην πλατφόρμα από το Qwen, και λιγότερο από το ένα τέταρτο των μεταφράσεών του βαθμολογείται συνολικά, έναντι σχεδόν των μισών του Qwen. Ένα μικρότερο, λιγότερο αντιπροσωπευτικό δείγμα μπορεί να κάνει έναν μέσο όρο να φαίνεται καλύτερος ή χειρότερος από ό,τι θα ήταν στον ίδιο όγκο που βλέπει το Qwen. Η αναφορά του ίδιου του MachineTranslation.com σε αυτά τα δεδομένα αντιμετωπίζει την κάλυψη βαθμολόγησης ως έναν πραγματικό περιορισμό, όχι ως υποσημείωση: μια μηχανή που βαθμολογείται σε ένα στενό τμήμα της κίνησής της δεν έχει ελεγχθεί τόσο διεξοδικά όσο μία που βαθμολογείται σε σχεδόν το ήμισυ της παραγωγής της.
Η ειλικρινής ανάγνωση είναι ότι οι αριθμοί του Grok είναι πολλά υποσχόμενοι αλλά πιο ισχνοί. Αυτοί του Qwen είναι χαμηλότεροι κατά μέσο όρο, αλλά βασίζονται σε μια πολύ μεγαλύτερη, πιο αντιπροσωπευτική βάση. Κανένα από τα δύο γεγονότα δεν αναιρεί το άλλο.
Τι γίνεται με τη γλωσσική κάλυψη;
Ούτε το Qwen ούτε το Grok δημοσιεύουν μια επαληθευμένη λίστα με ζεύγη γλωσσών όπου η απόδοση μειώνεται, και δεν υπάρχει καμία ανεξάρτητη δοκιμή για να επιβεβαιώσει κάτι τέτοιο. Αυτό που μπορεί να ειπωθεί με σιγουριά είναι ότι κανένα από τα δύο μοντέλα δεν δημιουργήθηκε με γνώμονα την ποιότητα μετάφρασης σε ένα συγκεκριμένο σύνολο γλωσσών με τον τρόπο που δημιουργείται μια εξειδικευμένη πλατφόρμα μετάφρασης. Το MachineTranslation.com ελέγχει και υποστηρίζει άμεσα πάνω από 270 γλώσσες, γεγονός που αποτελεί διαφορετικού είδους ισχυρισμό από την ευρεία αλλά μη δοκιμασμένη πολύγλωσση ικανότητα ενός μοντέλου γενικής χρήσης.
Πώς το MachineTranslation.com χρησιμοποιεί στην πραγματικότητα το Qwen και το Grok
Το MachineTranslation.com εκτελεί το Qwen, το Grok και περισσότερα από 20 άλλα μοντέλα AI σε κάθε μετάφραση, και στη συνέχεια αναδεικνύει την έκδοση με την οποία αυτά τα μοντέλα συμφωνούν περισσότερο. Κανένα από τα δύο μοντέλα δεν αποκλείεται επειδή έχει χαμηλότερη μέση βαθμολογία. Η ταυτόχρονη εκτέλεση πολλών μοντέλων σημαίνει τον εντοπισμό των περιπτώσεων όπου ένα μοντέλο με χαμηλότερη μέση βαθμολογία εξακολουθεί να αποδίδει σωστά μια συγκεκριμένη πρόταση την οποία ένα μοντέλο με υψηλότερη βαθμολογία κάνει λάθος. Η απόδοση του Qwen διαφοροποιείται επίσης ανά κατεύθυνση και ζεύγος με τρόπους που αξίζει να γνωρίζετε πριν επιλέξετε ένα μεμονωμένο μοντέλο, οι οποίοι καλύπτονται σε μεγαλύτερο βάθος στη σύγκριση Qwen vs DeepSeek του MachineTranslation.com. Για μια πιο προσεκτική ματιά στο πώς τα μοντέλα δοκιμάζονται απευθείας μεταξύ τους, δείτε τις πλήρεις δοκιμές σύγκρισης μοντέλων του MachineTranslation.com.
Συχνές ερωτήσεις
1. Είναι το Qwen ή το Grok καλύτερο για μετάφραση;
Στα δεδομένα μηχανών 28 ημερών του ίδιου του MachineTranslation.com, το Grok συγκεντρώνει υψηλότερη βαθμολογία κατά μέσο όρο από το Qwen, 9.26 έναντι 8.87 στα 10. Αλλά το Grok βαθμολογείται σε ένα πολύ μικρότερο, λιγότερο αντιπροσωπευτικό τμήμα της παραγωγής του, επομένως αυτή δεν είναι μια καθαρή απευθείας σύγκριση όπως θα ήταν μια δοκιμή αντιστοιχισμένων τμημάτων.
2. Γιατί το Grok έχει υψηλότερη μέση βαθμολογία αλλά λιγότερες βαθμολογημένες μεταφράσεις;
Το Grok χρησιμοποιείται λιγότερο συχνά στην πλατφόρμα και μόνο περίπου το 22.5% της παραγωγής του βαθμολογείται, έναντι 42.6% για το Qwen. Ένα μικρότερο, λιγότερο αντιπροσωπευτικό δείγμα μπορεί να διογκώσει ή να υποεκτιμήσει έναν μέσο όρο, γι' αυτό και αυτή η σύγκριση θα πρέπει να θεωρηθεί ενδεικτική, όχι οριστική.
3. Το Qwen ή το Grok υποστηρίζει περισσότερες γλώσσες;
Και τα δύο είναι μοντέλα AI γενικής χρήσης χωρίς δημοσιευμένη, επαληθευμένη λίστα περιορισμών για συγκεκριμένες γλώσσες. Κανένα από τα δύο δεν έχει κατασκευαστεί ειδικά για μετάφραση, κάτι που διαφέρει από μια πλατφόρμα που ελέγχει και βαθμολογεί απευθείας την ποιότητα μετάφρασης σε 270+ γλώσσες, αντί να βασίζεται στην ευρεία πολύγλωσση εκπαίδευση ως υποκατάστατο της μετρημένης απόδοσης μετάφρασης.
4. Ανταγωνίζεται το MachineTranslation.com τα Qwen και Grok;
Όχι. Το MachineTranslation.com εκτελεί τα Qwen, Grok και περισσότερα από 20 άλλα μοντέλα AI σε κάθε μετάφραση και αναδεικνύει την έκδοση στην οποία αυτά τα μοντέλα συμφωνούν περισσότερο. Δοκιμάζει και συνδυάζει τέτοια μοντέλα αντί να τα ανταγωνίζεται ως ένα ξεχωριστό, δικό του μοντέλο.
5. Ποιο μοντέλο AI συνιστά το MachineTranslation.com για μετάφραση;
Κανένα από προεπιλογή. Διαφορετικά μοντέλα αποδίδουν διαφορετικά ανά ζεύγος γλωσσών και τύπο περιεχομένου, και η διαφορά μεταξύ τους μπορεί να γείρει προς τη μία ή την άλλη πλευρά, ανάλογα με το τι μεταφράζεται. Αυτή η διακύμανση είναι ακριβώς ο λόγος για τον οποίο η πλατφόρμα εκτελεί πολλαπλά μοντέλα σε κάθε μετάφραση, αντί να επιλέγει ένα ως μόνιμη σύσταση.