September 9, 2026
Qwen vs DeepSeek: Aling AI model ang mas mahusay magsalin?
Ipatakbo ang parehong 12,000 segment ng pagsasalin sa Qwen at DeepSeek, at ang DeepSeek ang nanalo sa karamihan ng mga pares ng wika. Hindi iyan ang buong kuwento. Hatiin ang mga resulta ayon sa direksyon, at isang partikular na pattern ang lalabas: Halos mapunan ng Qwen ang agwat, at kung minsan ay nangunguna pa ito, lalo na kapag Ingles ang target na wika. Sa pagsasalin mula sa Ingles patungo sa anumang iba pang wika, halos palaging nananalo ang DeepSeek.
Mas mahalaga ang pagkakahating iyan kaysa sa pagkakaroon ng iisang pangkalahatang nagwagi kung nagsasalin ka ng nilalaman sa dose-dosenang wika sa halip na sa isang pares ng wika lamang.
Ano ang Qwen at DeepSeek?
Ang Qwen ay ang pamilya ng large language models ng Alibaba. Ang kasalukuyang henerasyon ay Qwen3.8, na inilabas noong Agosto 2026: Ang Qwen3.8-Max ay ang closed, API-only na flagship na may 2.4 trilyong parameter, habang ang Qwen3.8-27B ay isang mas maliit na open-weight model na inilabas sa ilalim ng Apache 2.0 pagkalipas ng ilang araw, na para sa mga team na gustong mag-self-host.
Ang DeepSeek ay isang Chinese AI lab na kilala sa mga mixture-of-experts model na pumapantay sa frontier performance sa maliit na bahagi lamang ng inference cost. Ang kasalukuyang henerasyon nito, ang DeepSeek V4, ay inilunsad noong Abril 2026 sa dalawang variant: Ang V4 Pro (1.6 trilyong kabuuang parameter, humigit-kumulang 49 bilyong aktibo bawat token) para sa gawaing nakatutok sa kalidad, at ang V4 Flash (284 bilyong kabuuan, humigit-kumulang 13 bilyong aktibo) para sa mga workload na sensitibo sa latency. Pareho itong inilabas bilang MIT-licensed open weights.
Paano nga ba nagkukumpara ang Qwen at DeepSeek sa pagsasalin, at hindi lang sa mga benchmark?
Karamihan sa mga paghahambing ng Qwen vs DeepSeek ay bumabanggit ng mga general-purpose benchmark: coding, math, reasoning. Walang alinman sa mga iyon ang direktang sumusukat sa kalidad ng pagsasalin, at ang pagpapatakbo sa bawat modelo gamit ang magkaibang source text ay nagiging sanhi upang maging imposible na ihiwalay ang anumang agwat sa kawastuhan mula sa kung ano ang hinihingi ng mismong teksto.
Ang sariling trapiko sa pagsasalin ng MachineTranslation.com sa nakalipas na 28 araw ay nagbibigay ng mas malinaw na sagot, dahil parehong isinalin ng dalawang modelo ang magkaparehong source text. Sa kabuuang 98 na pares ng wika at higit sa 12,000 magkatugmang segment, mas mataas ang nakuhang marka ng DeepSeek sa 83 pares; mas mataas naman ang nakuhang marka ng Qwen sa 15. Kung lilimitahan ito sa 27 pares kung saan Ingles ang target na wika, kapansin-pansing liliit ang agwat: Nanalo ang DeepSeek sa 63% ng mga ito (17 sa 27), nanalo ang Qwen sa 37% (10 sa 27). Sa natitirang 71 pares, kung saan hindi Ingles ang target, nanalo ang DeepSeek sa 92% (66 sa 71).
Win rate ayon sa direksyon ng pagsasalin (98 na pares ng wika, magkaparehong teksto)
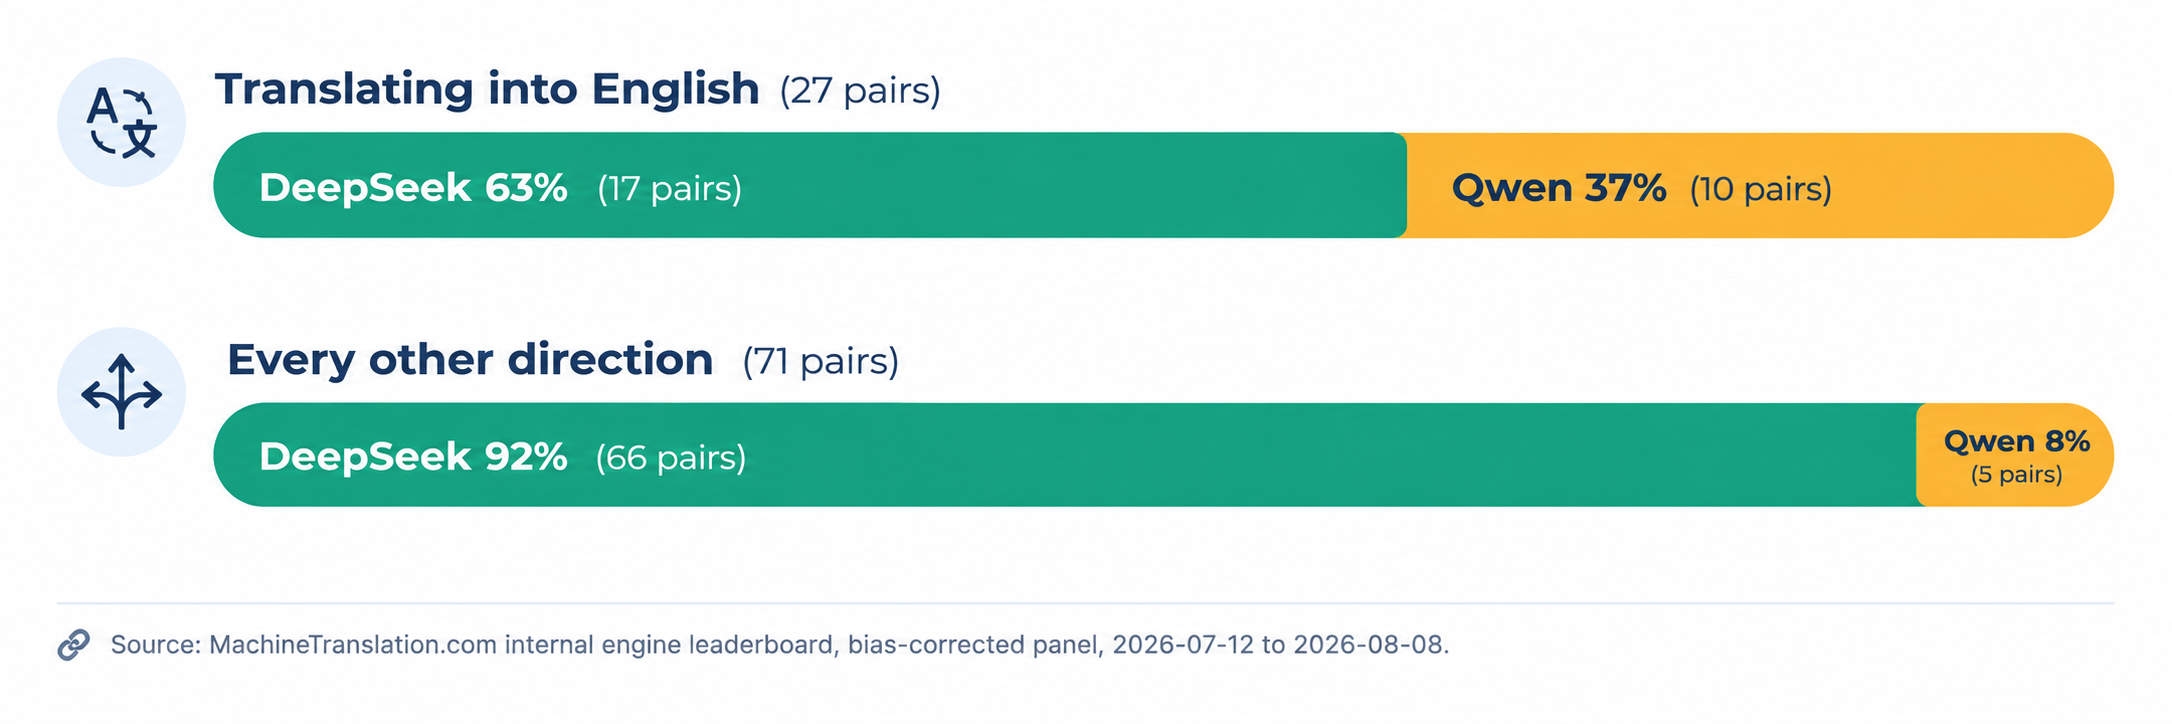
Nanalo ang DeepSeek sa malaking karamihan ng mga pares ng wika sa pangkalahatan. Makitid ngunit totoo ang pagkakataon ng Qwen na makipagkompetensya: ang pagsasalin patungong Ingles, kung saan nakukuha nito ang higit sa isang katlo ng mga pares. Datos: Internal engine leaderboard ng MachineTranslation.com, bias-corrected panel, Hulyo 12 hanggang Agosto 8, 2026.
Ang weighted average sa bawat magkatugmang segment ay naglalagay sa DeepSeek sa 9.13 mula sa 10 at sa Qwen sa 8.98. Ito ay isang totoong agwat, ngunit hindi ito pantay na naipapamahagi, na mas kapaki-pakinabang malaman kung ang iyong nilalaman ay isinasalin sa higit sa isang direksyon. Ito ang parehong head-to-head approach na ginagamit ng MachineTranslation.com sa buong pagsubok sa paghahambing ng modelo nito, hindi lamang para sa isang pares na ito.
Ang mga pinagsama-samang numero ay tugma rin sa mga indibidwal na test case. Sa pagsubok sa pariralang Pranses na "Elle est directrice adjointe du département commercial," nagkasundo ang DeepSeek at Qwen sa parehong salin sa Ingles, "deputy director of commercial department". Maaari mong direktang tingnan ang live na resulta ng pagsubok na iyon. Sa pagsubok sa "as soon as possible" na isinalin sa Espanyol, humiwalay ang DeepSeek sa konsensus ng apat na modelo gamit ang "esté hecho" sa halip na "se haga" na isang totoong kaso ng pagkakaiba na nagpapakita ng pagkakaiba sa gramatika sa pagitan ng proseso at resulta, hindi isang pagkakamali.
Bakit partikular na mas mahusay ang pagsasalin ng Qwen patungong Ingles?
Hindi ipinapaliwanag ng datos kung bakit, kundi kung saan lamang. Ang ilan sa pinakamalakas na pares patungong Ingles ng Qwen ay Tamil, Chinese, Polish, Italian, at Hebrew na mga source language na may malalaki at mahusay na nadokumentong English-language training corpora na pangkalahatang magagamit ng mga tagabuo ng modelo. Sa labas ng isang direksyong iyon, ang bentahe ng DeepSeek ay nananatili sa halos lahat ng dako: mula sa English, at maging sa pagitan ng mga pares ng wikang hindi English.
Dahil dito, hindi maaaring ituring ang alinmang modelo bilang isang pangkalahatang default. Ang isang koponan na nagsasalin ng mga listahan ng produkto mula sa Spanish patungo sa anim na wika at umaasa sa parehong ranggo ng pagganap na nakita nila sa pagsasalin ng Chinese support ticket patungo sa English ay maglalapat ng maling aral mula sa maling direksyon—na siyang kaparehong kawalan ng simetrya na makikita sa Spanish-to-English model breakdown ng MachineTranslation.com, kung saan ang mga nangungunang modelo ay hindi ang parehong mga nangunguna sa pabaligtad na direksyon.
Libre at open-source ba ang Qwen at DeepSeek?
Magkaiba ang paghahati ng lisensya para sa bawat isa. Nililisensyahan ng DeepSeek kapwa ang V4 Pro at V4 Flash sa ilalim ng MIT, isa sa mga pinakamaluwag na tuntunin ng open-source na magagamit, kaya parehong libre na i-self-host ang mga ito nang walang limitasyon. Hati ang Qwen: Ang Qwen3.8-27B ay inilabas sa ilalim ng Apache 2.0 at libreng i-self-host, ngunit ang flagship na Qwen3.8-Max ay nananatiling closed, API-only, at sa ilalim ng sariling pasadyang lisensya ng Alibaba.
Sa praktikal na aspeto, nangangahulugan iyan na mayroong ganap na open-weight, MIT-licensed na opsyon sa panig ng DeepSeek sa parehong antas ng kalidad. Sa panig ng Qwen, ang pagpili ng open-weight ay nangungunhan ng pagsuko sa flagship na modelo.
Magkano ang magiging gastos sa pagpapatakbo ng Qwen at DeepSeek sa malawakang antas?
Kasunod ng permanenteng bawas-presyo ng DeepSeek noong May 2026, ang kasalukuyang nai-publish na mga rate ng API nito ay $0.435 per million input tokens (cache miss) and $0.87 bawat milyong output token para sa V4 Pro, habang mas mababa naman ang presyo ng V4 Flash para sa latency-optimized tier nito.
Para sa mga koponan na nagpapasya na i-self-host ang alinmang modelo sa halip na gumamit ng hosted API, ang paghahambing ng gastos ay ganap na nalilipat sa GPU infrastructure at nagiging batay sa parameter count at active-parameter efficiency sa halip na per-token rate.
Ligtas sapat ba ang alinmang modelo para sa legal, medikal, o kontroladong nilalaman?
Alinman sa dalawang modelo ay walang inilalathalang mga sertipikasyon sa kaligtasan na partikular sa pagsasalin, at ang mga pangkalahatang benchmark sa kaligtasan ay hindi sumusubok para sa mga failure mode na mahalaga sa kontroladong nilalaman: tulad ng maling salin ng dosis, nabagong sugnay ng pananagutan, o hindi pare-parehong terminong legal. Sa sariling pagsusuri ng MachineTranslation.com, natuklasan ang mismong ganitong uri ng pagkakaiba sa pagitan ng mga modelo sa wikang legal at medikal, kabilang ang mga kaso kung saan gumamit ang mga modelo ng magkakaibang terminong legal na may magkakaibang saklaw sa kabila ng parehong pagkakaroon ng mataas na marka sa mga pangkalahatang sukatan ng kalidad.
Para sa mga kontrata, dokumento sa imigrasyon, o klinikal na nilalaman, iyon ang dahilan para ipares ang output ng alinmang modelo sa isang hakbang ng pag-verify ng tao sa halip na pagkatiwalaan ang isang AI output nang basta-basta, anuman ang modelong gumawa nito.
Ano ang kahulugan nito kung naglo-localize ka sa maraming wika nang sabay-sabay?
Ang paghahambing batay sa isang pares ng wika ay halos walang sinasabi sa iyo tungkol sa pares bilang apatnapu. Ang paghahating into-English/out-of-English na idokumento rito ay napatunayan sa isang sample ng 98 pares dahil partikular itong sinubukan sa ganoong kalaki na scale: ang isang solong pagsusuring English-to-Spanish, na siyang karaniwang pinatatakbo sa karamihan ng mga paghahambing ng Qwen vs DeepSeek, ay magpapakita na ang DeepSeek ay komportableng nangunguna at walang masasabi tungkol sa kung ano ang mangyayari kapag ang Tamil, Polish, o Hebrew ay kasama na sa pipeline.
Iyan ang praktikal na argumento para sa hindi pag-lock ng isang malaking programa sa lokalisasyon sa output ng isang modelo bilang default. Pinatatakbo ng MachineTranslation.com kapwa ang Qwen at DeepSeek, kasama ang higit sa 20 iba pang mga modelo, sa bawat pagsasalin at ipinapakita ang bersyon na pinakapinagkasunduan ng mga modelong iyon, kaya ang isang 68-wikang paglulunsad ay hindi nakadepende sa kung aling modelo ang nagkataong nanalo sa isang pares na unang sinubukan ng iba. Makikita mo nang eksakto kung aling mga modelo ang sumang-ayon o nagkaiba sa anumang ibinigay na pagsasalin sa per-translation model breakdown na ipinapakita ng platform para sa bawat resulta.
Ang bawat pagsasalin ay sinusuri laban sa mas malawak na hanay ng mga modelo kaysa sa kayang ialok ng alinman sa Qwen o DeepSeek nang mag-isa, na siyang direktang sagot sa kung ano ang mangyayari kapag ang iyong nilalaman ay hindi na lamang sa isang direksyon gumagalaw.
Mga madalas itanong
1. Mas mahusay ba ang Qwen o DeepSeek para sa pagsasalin?
Sa 98 na pares ng wika na sinubukan sa magkaparehong source text, mas mataas ang nakuha ng DeepSeek sa 83 sa mga ito. Ang mga panalo ng Qwen ay nakapangkat sa isang tiyak na direksyon: ang pagsasalin patungo sa English, kung saan nananalo ito nang humigit-kumulang sa ikatlong bahagi ng pagkakataon. Sa bawat iba pang direksyon, nananalo ang DeepSeek nang higit sa 90% ng pagkakataon.
2. Libre ba gamitin ang Qwen?
Ang Qwen3.8-27B ay open-weight sa ilalim ng Apache 2.0 at libreng i-self-host. Ang flagship na Qwen3.8-Max ay closed at magagamit lamang sa pamamagitan ng may-bayad na API ng Alibaba Cloud.
3. Libre bang gamitin ang DeepSeek?
Oo. Parehong may kasamang MIT-licensed open weights ang DeepSeek V4 Pro at V4 Flash, kaya maaari mong i-self-host ang alinman sa dalawa nang walang gastos sa lisensya. Nag-aalok din ang DeepSeek ng paid API para sa mga team na ayaw mamahala ng sarili nilang infrastructure.
4. Alin ang mas mabilis, Qwen o DeepSeek?
Ang DeepSeek V4 Flash ay sadyang binuo para sa mababang latency, na may 13 bilyong active parameters bawat token kumpara sa 49 bilyon ng V4 Pro. Ang katumbas na mas magaang opsiyon ng Qwen, ang Qwen3.8-27B, ay dense sa halip na mixture-of-experts, na sa pangkalahatan ay nagpapabagal dito bawat token sa maihahambing na kalidad.
5. Maaari ko bang gamitin ang Qwen at DeepSeek nang magkasama para sa pagsasalin?
Oo. Pinapatakbo ng MachineTranslation.com ang parehong modelo, kasama ang mahigit 20 iba pa, sa bawat pagsasalin at itinatampok ang bersyon kung saan pinakanagkakasundo ang mga ito, kaya hindi ka maiipit sa pagpili ng iisang modelo at sa pag-asang ito ang mas mahusay na pagpipilian para sa partikular na pares ng wikang iyon.
6. Ano ang pagkakaiba sa paglilisensya ng Qwen at DeepSeek?
Inililisensya ng DeepSeek ang parehong variant ng V4 sa ilalim ng MIT, isa sa mga pinakamapagpahintulot na open-source na lisensyang magagamit. Hinahati ng Qwen ang lineup nito: ang mas maliliit na modelo tulad ng Qwen3.8-27B ay ipinapamahagi sa ilalim ng Apache 2.0, ngunit ang flagship na Qwen3.8-Max ay nananatiling sarado sa ilalim ng isang custom na lisensya.