May 8, 2026
अनुवाद के लिए Grok बनाम Claude: बेंचमार्क क्या दर्शाते हैं (2026)
Grok (xAI) और Claude (Anthropic) दोनों ही सक्षम AI अनुवाद टूल हैं, लेकिन उनकी ताकतें संरचनात्मक रूप से भिन्न हैं। अधिकांश सामान्य अनुवाद कार्यों के लिए, आपको उनके बीच कोई महत्वपूर्ण अंतर दिखाई नहीं देगा। दो विशिष्ट परिदृश्यों के लिए (हाल की घटनाओं के बारे में सामग्री का अनुवाद करना, और सटीकता की आवश्यकता वाले औपचारिक दस्तावेजों का अनुवाद करना), अंतर वास्तविक है और इस बात पर आधारित है कि प्रत्येक मॉडल को कैसे बनाया गया था।
यह लेख इस बात को कवर करता है कि प्रत्येक मॉडल वास्तव में अनुवाद के लिए क्या प्रदान करता है, स्वतंत्र बेंचमार्क उन्हें कहाँ रखते हैं, और जब किसी भी मॉडल का आउटपुट अपने आप में पर्याप्त न हो तो क्या उपयोग किया जाए।
अनुवाद की गुणवत्ता पर Grok और Claude की तुलना कैसे होती है?
संक्षिप्त उत्तर: Claude स्वतंत्र पेशेवर अनुवाद बेंचमार्क में सबसे आगे है। Grok का विशिष्ट लाभ वास्तविक समय में ज्ञान तक पहुंच है, न कि समग्र अनुवाद गुणवत्ता।
MachineTranslation.com के आंतरिक बेंचमार्क में, Claude (3.5 Sonnet tier) अनुवाद गुणवत्ता — सटीकता, शब्दावली और शैली को मिलाकर — पर 100 में से 93.8 स्कोर करता है। Grok, Intento's State of Translation Automation 2025 के top 14 solutions में दिखाई नहीं देता है, जिसने 11 language pairs में 46 MT engines और LLMs का मूल्यांकन किया। Claude Opus 4 और Claude Sonnet 3.7 दोनों शीर्ष 14 में दिखाई देते हैं। स्रोत: MachineTranslation.com के आंतरिक बेंचमार्क; Intento State of Translation Automation 2025.
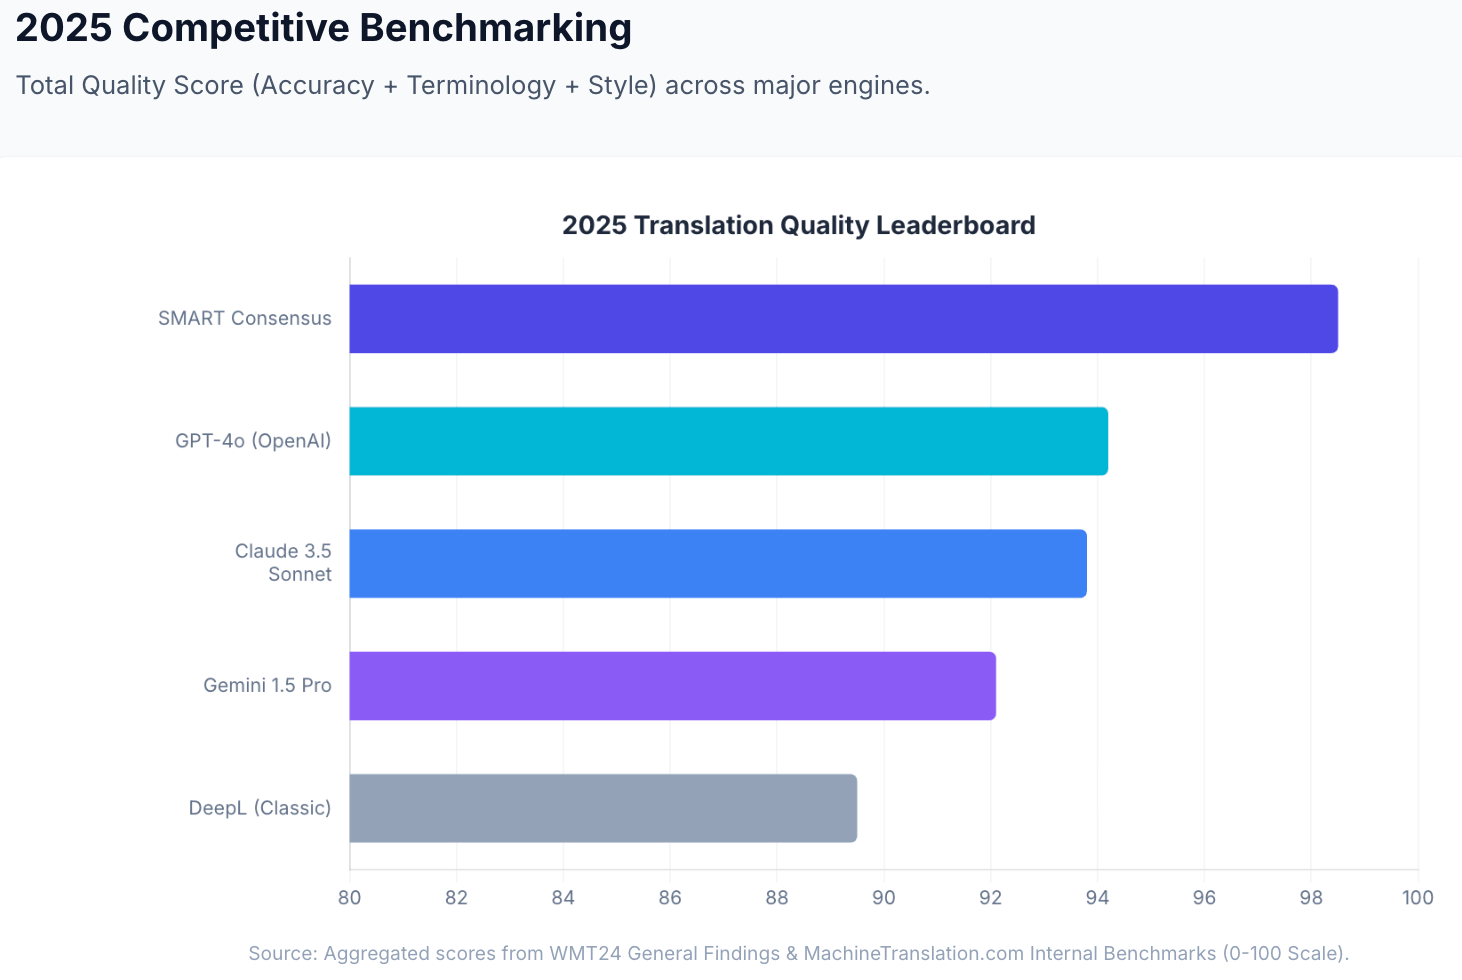
WMT24 (अनुवाद उद्योग की प्राथमिक स्वतंत्र बेंचमार्क प्रतियोगिता) में, Claude 3.5 11 में से 9 भाषा युग्मों में GPT-4 और समर्पित न्यूरल MT इंजनों से आगे पहले स्थान पर रहा। Lokalise के 2025 के पेशेवर अनुवादकों द्वारा किए गए ब्लाइंड स्टडी में, Claude 3.5 के 78% अनुवादों को good दर्जा दिया गया था — जो परीक्षण किए गए किसी भी LLM में सबसे अधिक है।
Grok का WMT24 या Intento के स्वतंत्र LQA मूल्यांकन में तुलनीय स्तर पर मूल्यांकन नहीं किया गया है। The Slator Pro Guide (2025) Grok को GPT और Claude के साथ व्यावसायिक परिवेशों में अनुवाद के लिए उपयोग किए जाने वाले सामान्य-उद्देश्य वाले LLMs में से एक के रूप में सूचीबद्ध करता है, लेकिन इसे दोनों में से किसी से ऊपर रैंक नहीं करता है।
| Benchmark | Grok | Claude |
|---|---|---|
| MachineTranslation.com आंतरिक गुणवत्ता स्कोर | बेंचमार्क स्तर पर मापा नहीं गया | 93.8/100 (3.5 Sonnet tier) |
| Intento 2025 शीर्ष 14 समाधान | सूचीबद्ध नहीं है | Claude Opus 4, Sonnet 3.7 दोनों सूचीबद्ध हैं |
| WMT24 भाषा युग्म | मूल्यांकन नहीं किया गया | 9/11 भाषा युग्मों में 1st |
| Lokalise 2025 blind study | मूल्यांकन नहीं किया गया | 78% अच्छा (किसी भी LLM में सबसे अधिक) |
स्रोत: MachineTranslation.com आंतरिक बेंचमार्क; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Grok को कहाँ वास्तविक बढ़त हासिल है?
रियल-टाइम और समसामयिक घटनाओं का अनुवाद। Grok की मुख्य संरचनात्मक विशेषता X (पूर्व में Twitter) प्लेटफॉर्म डेटा और लाइव इंटरनेट सर्च के साथ इसका एकीकरण है। Claude और अधिकांश अन्य LLMs के विपरीत, जो fixed knowledge cutoffs वाले static datasets पर प्रशिक्षित होते हैं, Grok अपने outputs में real-time information को शामिल करता है। हालिया घटनाओं, नए जारी किए गए उत्पादों, उभरती हुई राजनीतिक शब्दावली, वर्तमान समाचारों, या पिछले कुछ हफ्तों के भीतर हुई घटनाओं का संदर्भ देने वाली सामग्री से जुड़े अनुवाद कार्यों के लिए, Grok के पास उस संदर्भ तक पहुंच है जो Claude के पास नहीं है।
यह विशेष रूप से इनके लिए महत्वपूर्ण है: हालिया घटनाओं के बारे में समाचार लेखों का अनुवाद करने, तेजी से बदलते बाजारों के लिए उत्पाद घोषणाओं को स्थानीयकृत करने, नए गढ़े गए शब्दों या स्लैंग (slang) को संभालने जो अन्य मॉडलों के प्रशिक्षण डेटा के बाद के हैं, और ऐसी किसी भी सामग्री के लिए जहां अर्थ इस बात पर निर्भर करता है कि हाल ही में क्या हुआ है।
उभरती और विकसित होती शब्दावली। तकनीकी क्षेत्र, उद्योग और सांस्कृतिक संदर्भ निरंतर नई शब्दावली उत्पन्न करते हैं। हाल ही में गढ़े गए शब्दों, नई नियामक भाषा, या नए product nomenclature से जुड़े अनुवाद कार्यों के लिए, Grok की अपडेटेड ट्रेनिंग और रियल-टाइम सर्च इसे ऐसे उपयोग पैटर्न तक पहुंच प्रदान करते हैं जो पुराने ट्रेनिंग डेटा स्नैपशॉट कैप्चर नहीं कर पाते हैं।
Grok 4.1 कॉन्टेक्स्ट विंडो और रीजनिंग। Grok 4.1 (2025 के उत्तरार्ध के अनुसार) में 131K-token context window और बेहतर तार्किक क्षमताएं हैं, जो इसे जटिल, बहु-स्तरीय दस्तावेजों पर सक्षम बनाती हैं जहां क्लॉज संबंध और तार्किक सुसंगतता मायने रखती है।
Claude को कहाँ वास्तविक बढ़त हासिल है?
स्वतंत्र बेंचमार्क पर अनुवाद की गुणवत्ता। Claude की बढ़त स्व-घोषित दावों के बजाय स्वतंत्र पेशेवर मूल्यांकन द्वारा प्रमाणित है। WMT24 ने पूरे प्रतिस्पर्धी क्षेत्र के मुकाबले 11 में से 9 language pairs में Claude 3.5 को पहले स्थान पर रखा। Lokalise के 2025 के ब्लाइंड स्टडी में पाया गया कि पेशेवर अनुवादकों ने Claude 3.5 के आउटपुट को 78% good दर पर पसंद किया — जो उसी मूल्यांकन में GPT-4, DeepL और Google Translate से अधिक था। ये ब्लाइंड मूल्यांकन हैं: पेशेवर अनुवादकों ने यह जाने बिना आउटपुट का मूल्यांकन किया कि इसे किस मॉडल ने तैयार किया था।
Intento 2025 के अनुसार विशिष्ट भाषा युग्म। Intento के human LQA evaluation में, Claude Opus 4 और Sonnet 3.7 English to German, English to Japanese, English to Italian, English to Korean, English to Dutch, English to Arabic, और English to French के लिए best श्रेणी में आते हैं। इन जोड़ियों के लिए, Claude दोनों में से अधिक मजबूत दस्तावेजीकृत विकल्प है।
टोन की सटीकता और सूक्ष्म सामग्री। Lokalise के अध्ययन में पेशेवर अनुवादकों ने किसी भी LLM की तुलना में Claude के आउटपुट को सबसे अधिक प्राथमिकता दी — जो रजिस्टर, लेखक की आवाज़ और संदर्भगत अर्थ को बनाए रखने में Claude की प्रमाणित क्षमता को दर्शाता है। साहित्यिक अनुवाद, कानूनी दस्तावेज़ों, औपचारिक संचार और मार्केटिंग कॉपी के लिए, जहाँ कोई बात कैसे कही गई है यह उतना ही महत्वपूर्ण होता है जितना कि क्या कहा गया है, Claude स्वतंत्र मूल्यांकनों में लगातार अच्छा प्रदर्शन करता है।
लंबे दस्तावेज़ों की सुसंगतता। Claude 4.6 Sonnet 200K-token context window का समर्थन करता है, जबकि Claude Opus 4.6 beta में 1M tokens का समर्थन करता है। लंबे औपचारिक दस्तावेजों (contracts, technical manuals, clinical trial reports) के लिए, Claude पूरे दस्तावेज को एक single pass में प्रोसेस कर सकता है, जिससे पूरे दस्तावेज में terminology consistency बनी रहती है। टुकड़ों में संसाधित किए गए दस्तावेज़, पूरे-दस्तावेज़ प्रसंस्करण की तुलना में शब्दावली असंगति की 28% अधिक दर दर्शाते हैं। स्रोत: MachineTranslation.com आंतरिक डेटा।
भाषा समर्थन और मूल्य निर्धारण के मामले में उनकी तुलना कैसी है?
भाषा समर्थन: Grok 4.1 और Claude 4.6 दोनों दुनिया की अधिकांश प्रमुख भाषाओं में अनुवाद का समर्थन करते हैं। Claude का यूरोपीय और पूर्वी एशियाई भाषा युग्मों में स्वतंत्र रूप से मूल्यांकन किया गया है, जिसके मजबूत परिणाम मिले हैं। Grok का बहुभाषी समर्थन क्रमिक संस्करणों के साथ बेहतर हुआ है। कम संसाधन वाली भाषाओं के लिए, दोनों मॉडलों की गुणवत्ता में गिरावट आती है — चाहे किसी भी मॉडल का उपयोग किया जाए, कम संसाधन वाले भाषा युग्मों की सामग्री के लिए मानवीय समीक्षा उपयुक्त है।
मूल्य निर्धारण:
| योजना | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| उपभोक्ता (मासिक) | SuperGrok: $30/month | Claude Pro: $20/month |
| API इनपुट (प्रति M टोकन) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API आउटपुट (प्रति M टोकन) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| निःशुल्क टियर | हाँ (X/Grok.com के माध्यम से दर-सीमित) | हाँ (claude.ai के माध्यम से दर-सीमित) |
उपभोक्ता टियर पर, Claude Pro ($20/month) is cheaper than SuperGrok ($30/month)। API स्तर पर, इनपुट-भारी अनुवाद वर्कफ़्लो के लिए Grok 4.1 को Claude Sonnet 4.6 पर थोड़ा लागत लाभ प्राप्त है।
विशिष्ट प्रकार की सामग्री के लिए कौन सा बेहतर है?
| सामग्री प्रकार | अनुशंसित मॉडल | कारण |
|---|---|---|
| हालिया समाचार / समसामयिक घटनाएं | Grok | रीयल-टाइम डेटा एक्सेस; स्टैटिक रूप से प्रशिक्षित मॉडलों में वर्तमान संदर्भ की कमी होती है |
| उभरती शब्दावली / नए उत्पाद लॉन्च | Grok | लाइव सर्च इंटीग्रेशन हाल के उपयोग के पैटर्न को कैप्चर करता है |
| औपचारिक कानूनी दस्तावेज़ | Claude | WMT24 और Lokalise 2025 स्वतंत्र मूल्यांकन; टोन की सटीकता |
| चिकित्सा / नैदानिक सामग्री | Claude | स्वतंत्र बेंचमार्क स्थिति; रजिस्टर का संरक्षण |
| मार्केटिंग कॉपी / रचनात्मक सामग्री | Claude | Lokalise 2025 ब्लाइंड स्टडी प्राथमिकता; टोन की सूक्ष्मताएं |
| तकनीकी दस्तावेज़ीकरण (लंबा) | Claude | 200K-1M कॉन्टेक्स्ट विंडो; पूरी लंबाई में शब्दावली की निरंतरता |
| सोशल मीडिया / संवादात्मक सामग्री | दोनों में से कोई भी | दोनों ही हाई-रिसोर्स संवादात्मक जोड़ियों को अच्छी तरह से संभालते हैं |
| डेवलपर / API एकीकरण | दोनों में से कोई भी | दोनों API एक्सेस प्रदान करते हैं; Grok इनपुट टोकन पर थोड़ा सस्ता है |
जब एक model पर्याप्त न हो तो क्या उपयोग करें
Grok और Claude दोनों single-model tools हैं। प्रत्येक व्यक्तिगत AI मॉडल (चाहे वह कितना भी सक्षम क्यों न हो) ऐसी त्रुटियां उत्पन्न करता है जिनका पता वह अपने स्वयं के आउटपुट में नहीं लगा सकता। Grok या Claude में से किसी का भी एक धाराप्रवाह और आत्मविश्वासपूर्ण अनुवाद फिर भी अर्थगत रूप से गलत हो सकता है, और बिना क्रॉस-चेक के यह जानने का कोई तरीका नहीं है।
Grok और Claude दोनों MachineTranslation.com के SMART सिस्टम के 22 मॉडलों में शामिल हैं। SMART सभी 22 मॉडलों को एक साथ चलाता है (जिसमें Grok और Claude शामिल हैं) और वह आउटपुट देता है जिस पर बहुमत सहमत होता है।
Grok बनाम Claude के सवाल के लिए इसका क्या मतलब है: Grok की real-time ताकत और Claude की contextual depth दोनों एक ही आम सहमति में योगदान करते हैं। जब वे सहमत होते हैं, तो वह सहमति गुणवत्ता का एक मजबूत संकेत होती है।
MachineTranslation.com के आंतरिक बेंचमार्क में, व्यक्तिगत शीर्ष-स्तरीय मॉडल अनुवाद गुणवत्ता पर 100 में से 93-94 स्कोर करते हैं। SMART का consensus output 98.5/100 तक पहुंच गया है। स्रोत: MachineTranslation.com के आंतरिक बेंचमार्क और WMT24 General Machine Translation Findings।
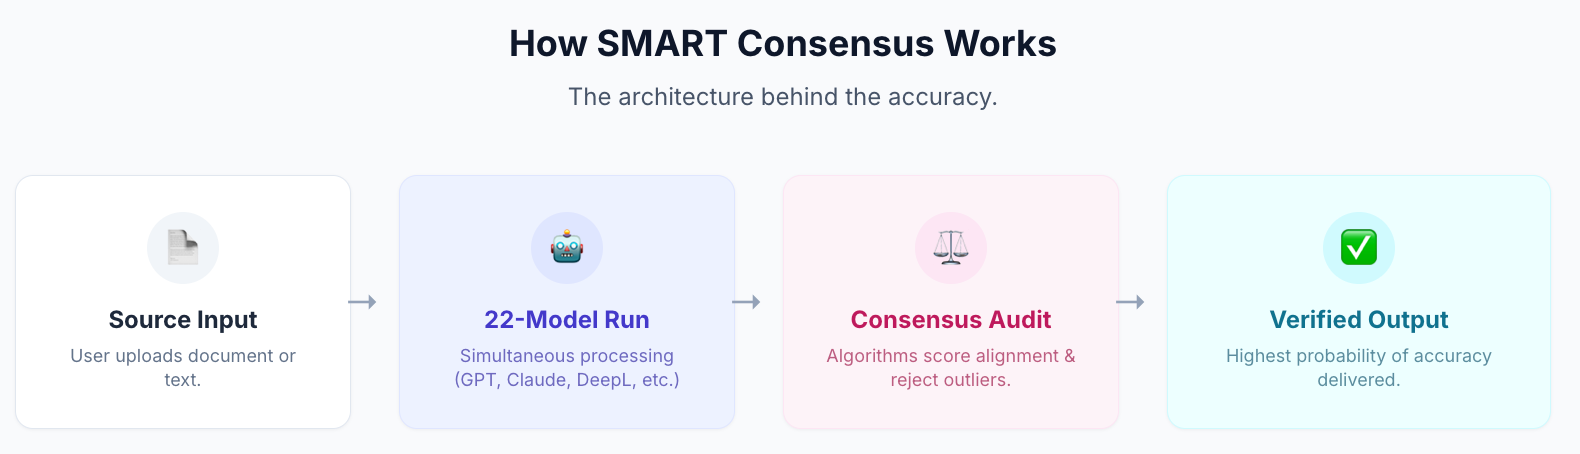
जिन उपयोगकर्ताओं ने single-engine translation से SMART पर स्विच किया, उन्होंने आउटपुट को सत्यापित करने और सुधारने में 27% कम समय बिताया। स्रोत: MachineTranslation.com का आंतरिक डेटा।
उच्च-जोखिम वाली सामग्री (कानूनी दस्तावेज, नियामक फाइलिंग, चिकित्सा निर्देश) के लिए, Human Verification उसी प्लेटफॉर्म के भीतर SMART consensus को एक प्रमाणित पेशेवर समीक्षक के पास अग्रेषित करता है। कोई बाहरी एजेंसी नहीं। 100% सटीकता की गारंटी।
Grok, Claude, और 20 अन्य मॉडलों के साथ MachineTranslation.com पर अनुवाद करें — मुफ्त, किसी साइन-अप की आवश्यकता नहीं।
अक्सर पूछे जाने वाले प्रश्न
1. क्या अनुवाद के लिए Grok, Claude से बेहतर है?
अधिकांश मानक अनुवाद कार्यों के लिए, Claude स्वतंत्र बेंचमार्क पर आगे है: WMT24 में 11 में से 9 भाषा जोड़ों में प्रथम, Lokalise के 2025 के ब्लाइंड अध्ययन में 78% अच्छी रेटिंग, और MachineTranslation.com के आंतरिक गुणवत्ता बेंचमार्क में 93.8/100। Grok का विशिष्ट लाभ उस content के लिए है जिसमें current-events के ज्ञान की आवश्यकता होती है, इसकी real-time data access इसे वह context प्रदान करती है जो Claude सहित static-trained models के पास नहीं होता। हालिया समाचारों, उभरती शब्दावली और समय-संवेदनशील सामग्री के लिए, Grok एक बेहतर विकल्प है।
2. अनुवाद के लिए Claude की तुलना में Grok का क्या लाभ है?
Grok, X (formerly Twitter) से real-time data और live internet search को एकीकृत करता है। Claude और static datasets पर प्रशिक्षित अधिकांश अन्य LLMs के विपरीत, Grok अनुवाद जेनरेट करते समय हाल की घटनाओं, नवनिर्मित शब्दावली और वर्तमान context के बारे में जानकारी एक्सेस कर सकता है। यह इसे विशेष रूप से समाचार सामग्री, हाल ही में जारी किए गए उत्पादों, और ऐसी किसी भी सामग्री का अनुवाद करने के लिए अधिक मजबूत बनाता है, जहां अर्थ पिछले कुछ हफ्तों की घटनाओं या भाषा के पैटर्न पर निर्भर करता है।
3. अनुवाद के लिए Grok की तुलना में Claude का क्या लाभ है?
Claude का लाभ स्वतंत्र पेशेवर मूल्यांकन के माध्यम से प्रलेखित है। Claude 3.5 WMT24 में 11 में से 9 language pairs में पहले स्थान पर रहा, और Lokalise के 2025 blind study में पेशेवर अनुवादकों ने इसके output को 78% good दर पर पसंद किया — जो परीक्षण किए गए किसी भी LLM में सबसे अधिक है। Claude भी मानव LQA मूल्यांकन में कई भाषा युग्मों में Intento के शीर्ष 14 समाधानों में दिखाई देता है, जबकि Grok नहीं। औपचारिक, पेशेवर और उच्च-जोखिम वाले अनुवाद कार्यों के लिए, Claude की स्वतंत्र बेंचमार्क स्थिति दस्तावेजीकृत विभेदक है।
4. कानूनी अनुवाद के लिए कौन सा बेहतर है, Grok या Claude?
स्वतंत्र मूल्यांकन के आधार पर कानूनी अनुवाद के लिए Claude अधिक मजबूत विकल्प है। Claude 3.5 ने WMT24 में अधिकांश high-resource European language pairs में पहला स्थान प्राप्त किया और पेशेवर अनुवादकों से उच्चतम blind-study preference ratings प्राप्त कीं। प्रमाणित सटीकता की आवश्यकता वाले कानूनी कंटेंट के लिए, कोई भी मॉडल अकेले पर्याप्त नहीं है — MachineTranslation.com का Human Verification उसी प्लेटफॉर्म के भीतर एक प्रमाणित पेशेवर समीक्षक से 100% सटीकता प्रदान करता है, किसी बाहरी विक्रेता की आवश्यकता नहीं है।
5. क्या Grok और Claude दोनों MachineTranslation.com पर उपलब्ध हैं?
हाँ। दोनों MachineTranslation.com के SMART system के 22 मॉडलों में शामिल हैं। प्रत्येक SMART अनुवाद Grok, Claude और 20 अन्य मॉडलों को एक साथ चलाता है, और वह आउटपुट प्रदान करता है जिस पर बहुमत सहमत होता है। उनके बीच चयन करने के बजाय, आपको सभी AI मॉडलों की आम सहमति प्राप्त होती है।
6. कीमत के मामले में Grok और Claude की तुलना कैसे होती है?
उपभोक्ता स्तर पर, Claude Pro की कीमत $20/month versus SuperGrok at $30/महीना है। API स्तर पर, Grok 4.1 इनपुट टोकन ($2/M vs. $3/M Claude Sonnet 4.6 के लिए) और आउटपुट ($10/M vs. $15/M) पर थोड़ा सस्ता है। MachineTranslation.com के फ्री प्लान में SMART के 22-मॉडल सर्वसम्मति के हिस्से के रूप में दोनों मॉडल शामिल हैं, किसी साइन-अप की आवश्यकता नहीं है।
7. समाचार लेखों का अनुवाद करने के लिए कौन सा AI model सबसे अच्छा है?
समाचार लेखों का अनुवाद करने के लिए, Grok के पास एक संरचनात्मक लाभ है: इसके real-time data integration का अर्थ है कि इसके पास वर्णित की जा रही घटनाओं का वर्तमान संदर्भ होता है, जिसकी कमी static-trained models में हो सकती है। सामान्य समाचार अनुवाद के लिए जहाँ हालिया होना महत्वपूर्ण नहीं है, Claude का benchmark प्रदर्शन अधिक मजबूत है। भारी मात्रा में समाचार अनुवाद के लिए जहाँ नवीनता और सटीकता दोनों मायने रखते हैं, MachineTranslation.com का SMART दोनों मॉडलों को चलाता है और उनका सर्वसम्मत आउटपुट देता है।