October 9, 2026
Qwen vs ChatGPT: कौन सा AI मॉडल बेहतर अनुवाद करता है?
ChatGPT की वर्तमान पीढ़ी और Qwen दोनों उन मॉडलों के समूह का हिस्सा हैं जिन्हें MachineTranslation.com प्रत्येक अनुवाद के लिए चलाता है, न कि दो बाहरी दावेदार जिनका मूल्यांकन खुद इस प्लेटफॉर्म के विरुद्ध किया जा रहा है। समान सेगमेंट पर दोनों के माध्यम से एक ही टेक्स्ट चलाएं, और समग्र रूप से भाषा युग्मों के एक बड़े हिस्से में ChatGPT जीतता है। परिणामों को अनुवाद की दिशा के आधार पर विभाजित करें, और तस्वीर एक विशिष्ट स्थान पर काफी सिमट जाती है: अंग्रेजी में अनुवाद, जहाँ दोनों लगभग बराबरी पर हैं।
क्या अनुवाद के लिए ChatGPT से बेहतर कोई AI है?
प्रतिस्पर्धी मॉडलों में सुधार के साथ ChatGPT के विकल्पों में आम रुचि बढ़ी है, हालांकि इसके कारण उपयोग के आधार पर काफी भिन्न होते हैं और इसका कोई एक कारण नहीं है। विशेष रूप से अनुवाद के लिए, अधिक उपयोगी प्रश्न यह है कि किसी दिए गए भाषा युग्म पर वास्तव में कौन सा मॉडल बेहतर प्रदर्शन करता है, जो कि धारणा का विषय होने के बजाय एक परीक्षण योग्य प्रश्न है।
MachineTranslation.com के पिछले 28 दिनों के ट्रैफ़िक के दौरान, दोनों मॉडलों ने 98 भाषा युग्मों में समान सोर्स टेक्स्ट का अनुवाद किया। ChatGPT ने इनमें से 77 युग्मों में उच्च स्कोर प्राप्त किया; Qwen ने 21 में उच्च स्कोर प्राप्त किया। मैच्ड आउटपुट पर वेटेड ऐवरेज ChatGPT को 10 में से 9.10 और Qwen को 8.98 पर रखता है, जो औसतन एक वास्तविक लेकिन मामूली अंतर है, जो अनुवाद की दिशा को शामिल करने पर दिखने वाले कहीं अधिक बड़े अंतर को छिपा देता है।
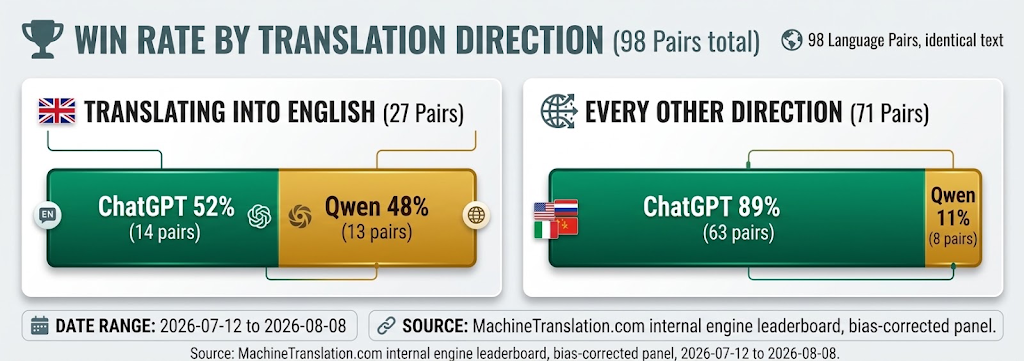
अंग्रेजी में अनुवाद के मामले में, दोनों मॉडल लगभग बराबरी पर हैं। अन्य सभी दिशाओं में, ChatGPT परीक्षण किए गए अधिकांश युग्मों में जीत हासिल करता है।
| ChatGPT | Qwen | |
|---|---|---|
| स्कोर किए गए आउटपुट का प्रतिशत | 54.76% | 42.6% |
| औसत स्कोर | 8.89 / 10 | 8.87 / 10 |
| सबसे निचले 10% स्कोर | 7.8 | 7.6 |
| विन रेट, अंग्रेजी में | 52% | 48% |
| विन रेट, अन्य सभी दिशाओं में | 89% | 11% |
अंग्रेजी में अनुवाद करते समय यह अंतर लगभग समाप्त क्यों हो जाता है?
डेटा यह दिखाता है कि यह अंतर कहाँ आता है, न कि क्यों। जो बात स्पष्ट है वह यह है कि Qwen की प्रतिस्पर्धात्मकता समान रूप से फैली नहीं है। उन 27 भाषा-जोड़ों में से जहाँ लक्षित भाषा अंग्रेजी है, Qwen 13 में जीत हासिल करता है, जो मूल रूप से एक सिक्के के उछाल जैसा है। शेष 71 जोड़ों में से—चाहे अंग्रेजी से बाहर अनुवाद करना हो या दो गैर-अंग्रेजी भाषाओं के बीच—ChatGPT 63, यानी उनमें से 89% में जीतता है। कोई भी टीम जो यह मान लेती है कि अंग्रेजी में अनुवाद करने में Qwen का प्रदर्शन आउटबाउंड या गैर-अंग्रेजी जोड़ों के अनुवाद में भी जारी रहेगा, वह गलत दिशा से गलत निष्कर्ष निकाल रही होगी।
क्या Qwen एक चीनी कंपनी है, और क्या अनुवाद के लिए इससे कोई फर्क पड़ता है?
Qwen को Alibaba Cloud द्वारा विकसित किया गया है, जो चीन में स्थित है। अपने आप में, यह इस बात को नहीं बदलता कि मॉडल किसी दिए गए वाक्य का कितनी अच्छी तरह अनुवाद करता है; ऊपर दिया गया डेटा मॉडल के निर्माण स्थल की परवाह किए बिना वास्तविक आउटपुट गुणवत्ता को दर्शाता है। जहाँ यह बात मायने रख सकती है वह है डेटा हैंडलिंग: विनियमित या संवेदनशील सामग्री (अनुबंध, मेडिकल रिकॉर्ड, व्यक्तिगत जानकारी) का अनुवाद करने वाले व्यवसायों को इस सवाल को कि कोई AI प्रदाता उस सामग्री को कहाँ प्रोसेस और स्टोर करता है, अनुवाद की गुणवत्ता से अलग एक वास्तविक ड्यू-डिलिजेंस विषय के रूप में देखना चाहिए। यह किसी भी AI प्रदाता पर लागू होता है, न कि केवल Qwen पर, और यही कारण है कि MachineTranslation.com इस सवाल को अनुत्तरित छोड़ने के बजाय अपनी डेटा हैंडलिंग और सुरक्षा प्रक्रियाओं को सीधे प्रकाशित करता है।
क्या कानूनी और व्यावसायिक अनुवाद के लिए दोनों में से कोई एक मॉडल अधिक विश्वसनीय है?
लगातार रूप से नहीं, और यह अंतर हमेशा इस बात पर निर्भर नहीं करता कि कौन सा मॉडल अधिक अंक प्राप्त करता है। वास्तविक अनुबंध की भाषा पर MachineTranslation.com के परीक्षण में दो ऐसे अलग-अलग मामले सामने आए, जिन्हें कानूनी पाठ के लिए किसी भी मॉडल पर भरोसा करने से पहले जानना जरूरी है। मुहावरेदार भाषा कभी-कभी इसके विपरीत जाती है: एक अलग आमने-सामने के परीक्षण में पाया गया कि ChatGPT ने एक जर्मन मुहावरे का शाब्दिक और गलत अनुवाद किया, जबकि Qwen ने सही मुहावरेदार अर्थ निकाला; यह इस बात की याद दिलाता है कि समग्र डेटा में किसी भी मॉडल की कुल बढ़त हर एक वाक्य के स्तर पर सही साबित नहीं होती है।
| टेस्ट केस | ChatGPT | Qwen |
|---|---|---|
| जर्मन में "At-will employment" | उपयोग योग्य, व्यावहारिक वाक्यांश | एक असंबद्ध कानूनी अवधारणा का उपयोग किया |
| स्पैनिश में Limitation-of-liability क्लॉज | "que surjan de" | "derivados de" (दायरे को बदलने वाला अंतर) |
| "Ich verstehe nur Bahnhof" (जर्मन मुहावरा) | शाब्दिक अनुवाद किया, गलत | सही मुहावरेदार अर्थ |
इन तीनों मामलों में कोई भी मॉडल लगातार बेहतर प्रदर्शन नहीं करता: किसी एक मॉडल का समग्र स्कोर किसी विशिष्ट शब्द या वाक्यांश पर उसके व्यवहार का सटीक अनुमान नहीं लगाता है। यही कारण है कि कानूनी और अनुबंध संबंधी पाठ में मानवीय सत्यापन (human verification) का कदम फायदेमंद साबित होता है, भले ही पहला ड्राफ्ट किसी भी मॉडल द्वारा तैयार किया गया हो।
भाषा कवरेज के बारे में क्या?
न तो ChatGPT और न ही Qwen भाषा युग्मों की ऐसी कोई सत्यापित, स्वतंत्र रूप से पुष्ट सूची प्रकाशित करते हैं जहाँ अनुवाद की गुणवत्ता कम हो जाती है। दोनों ही व्यापक बहुभाषी प्रशिक्षण वाले सामान्य-उद्देश्यीय मॉडल हैं, जो किसी विशिष्ट भाषा सेट में मापे गए अनुवाद प्रदर्शन से भिन्न दावा है। MachineTranslation.com किसी मॉडल की सामान्य भाषा क्षमता पर इस बात के विकल्प के रूप में भरोसा करने के बजाय कि वह वास्तव में कितना अच्छा अनुवाद करता है, सीधे 330+ भाषाओं में अनुवाद गुणवत्ता का परीक्षण और स्कोर करता है।
व्यावसायिक अनुवाद के लिए आपको ChatGPT या Qwen में क्या पेस्ट नहीं करना चाहिए?
न तो ChatGPT और न ही Qwen को एक समर्पित अनुवाद प्लेटफॉर्म के रूप में बनाया गया था, और संवेदनशील व्यावसायिक सामग्री को सीधे एक सामान्य-उद्देश्यीय चैट इंटरफ़ेस में पेस्ट करने से डेटा हैंडलिंग से जुड़े वही सवाल खड़े होते हैं जो इसे किसी अन्य उपभोक्ता AI टूल में पेस्ट करने पर होते हैं: इनपुट कहाँ प्रोसेस होता है, क्या इसे सुरक्षित रखा जाता है, और इसे कौन एक्सेस कर सकता है। अनुबंध, मेडिकल रिकॉर्ड, अप्रवासन दस्तावेज़ और वित्तीय विवरण बिल्कुल ऐसी ही सामग्री हैं जहाँ अनुवाद करने से पहले इस सवाल का जवाब जानना ज़रूरी है, बाद में नहीं। यही एक वास्तविक कारण है कि प्रकाशित, सत्यापन योग्य डेटा हैंडलिंग प्रक्रियाओं वाला एक समर्पित अनुवाद प्लेटफॉर्म सामान्य-उद्देश्यीय चैट इंटरफ़ेस से बिल्कुल अलग होता है, चाहे दोनों में से किसी के भी पीछे कोई भी मॉडल काम कर रहा हो।
MachineTranslation.com वास्तव में दोनों मॉडलों का उपयोग कैसे करता है
MachineTranslation.com प्रत्येक अनुवाद पर ChatGPT, Qwen और 20 से अधिक अन्य AI मॉडलों को चलाता है, और फिर उस संस्करण को सामने लाता है जिस पर वे मॉडल सबसे अधिक सहमत होते हैं। अनुवाद की दिशा के आधार पर Qwen और ChatGPT का प्रदर्शन जिस तरह तेज़ी से बदलता है, उसे देखते हुए किसी एक मॉडल को स्थायी डिफ़ॉल्ट के रूप में चुनने का मतलब भाषा युग्मों के एक निश्चित हिस्से पर गलत अनुमान लगाना होगा। यही दिशा-निर्भर पैटर्न MachineTranslation.com की Qwen बनाम DeepSeek तुलना में भी दिखाई देता है। वर्तमान मॉडलों का एक-दूसरे के विरुद्ध परीक्षण कैसे किया जाता है, इसकी पूरी तस्वीर के लिए MachineTranslation.com का पूर्ण मॉडल तुलना परीक्षण देखें।
अक्सर पूछे जाने वाले प्रश्न
1. क्या अनुवाद के लिए Qwen बेहतर है या ChatGPT?
समान स्रोत पाठ पर परीक्षण किए गए 98 भाषा युग्मों में से, ChatGPT ने उनमें से 77 में उच्च स्कोर प्राप्त किया। Qwen का सबसे मजबूत प्रदर्शन अंग्रेजी में अनुवाद करते समय रहा, जहाँ दोनों लगभग बराबरी पर हैं। हर दूसरी दिशा में, ChatGPT अधिकांश युग्मों में जीत हासिल करता है, इसलिए सटीक उत्तर इस बात पर काफी हद तक निर्भर करता है कि सामग्री का अनुवाद किस दिशा में हो रहा है।
2. क्या ChatGPT या Qwen अधिक भाषाओं का समर्थन करता है?
दोनों ही भाषा-विशिष्ट सीमाओं की सत्यापित, प्रकाशित सूची के बिना सामान्य-उद्देश्यीय AI मॉडल हैं। दोनों में से कोई भी स्वतंत्र रूप से पुष्ट भाषा-युग्म कवरेज डेटा प्रकाशित नहीं करता है, जो ऐसे प्लेटफॉर्म से भिन्न है जो बहुभाषी प्रशिक्षण के बारे में सामान्य दावों पर भरोसा करने के बजाय सीधे 330+ भाषाओं में अनुवाद गुणवत्ता का परीक्षण और स्कोर करता है।
3. क्या कानूनी और व्यावसायिक अनुवाद के लिए Qwen बेहतर है या ChatGPT?
दोनों में से कोई भी समग्र रूप से विश्वसनीय तौर पर बेहतर नहीं है। एक जर्मन रोज़गार कानून शब्द का परीक्षण करते समय, DeepSeek और ChatGPT ने उपयोगी कार्यात्मक वाक्यांश प्रस्तुत किए, जबकि Claude और Qwen दोनों ने एक असंबंधित कानूनी अवधारणा का उल्लेख किया। इससे पता चलता है कि यह अंतर शब्द और संदर्भ पर निर्भर करता है, न कि इस बात पर कि कौन सा मॉडल आमतौर पर अधिक मजबूत है।
4. क्या MachineTranslation.com, ChatGPT और Qwen के साथ प्रतिस्पर्धा करता है?
नहीं। MachineTranslation.com हर अनुवाद पर ChatGPT, Qwen और 20 से अधिक अन्य AI मॉडलों को चलाता है और उस संस्करण को सामने लाता है जिस पर वे मॉडल सबसे अधिक सहमत होते हैं। यह स्वयं एक अलग, प्रतिस्पर्धी मॉडल के रूप में कार्य करने के बजाय इस प्रकार के मॉडलों का परीक्षण और संयोजन करता है।
5. एक बड़े लोकलाइज़ेशन प्रोजेक्ट के लिए मुझे कौन सा मॉडल चुनना चाहिए?
जब कंटेंट दोनों दिशाओं में कई भाषाओं में जाता है, तो इनमें से कोई भी अकेला सुरक्षित डिफ़ॉल्ट नहीं है। यहाँ दर्ज किया गया दिशा-विशिष्ट अंतर यह दर्शाता है कि जो मॉडल अंग्रेजी में अनुवाद करते समय अच्छा प्रदर्शन करता है, वह दर्जनों भाषा जोड़ियों में एक साथ अंग्रेजी से अनुवाद करते समय बहुत अलग प्रदर्शन कर सकता है।
6. अनुवाद के लिए कौन सा Qwen मॉडल सबसे अच्छा है?
यह अभी उपलब्ध नहीं है। अन्य प्रोवाइडर्स के विपरीत, MachineTranslation.com की ट्रैकिंग वर्तमान में Qwen को बिना किसी मॉडल-वर्जन टैग के एक सिंगल इंजन के रूप में रिकॉर्ड करती है, इसलिए रिपोर्ट करने के लिए सब-वर्जन के आधार पर गुणवत्ता डेटा मौजूद नहीं है। एक बार जब यह ठीक हो जाएगा, तो Qwen3.8-Max और Qwen3.8-27B के बीच वास्तविक विश्लेषण संभव होगा; फिलहाल, यह सिर्फ एक अनमापा विवरण नहीं, बल्कि एक वास्तविक अंतर है।