November 13, 2026
अनुवाद के लिए Qwen बनाम Gemini और दिशा क्यों मायने रखती है
आपके पास दो मॉडल और भाषा युग्मों की एक सूची है, और आपको यह तय करना है कि प्रोजेक्ट के लिए किस मॉडल पर भरोसा किया जाए। अधिकांश Qwen बनाम Gemini तुलनाएं केवल एक समग्र स्कोर देती हैं। मेरा मानना है कि एक अकेला स्कोर उस मुख्य बात को छिपा देता है जो परिणाम तय करती है, और वह है अनुवाद की दिशा।
मैं इस बात पर काम करता हूं कि हम MachineTranslation.com पर चलने वाले मॉडलों का परीक्षण कैसे करते हैं, इसलिए मैं समान टेक्स्ट पर स्कोर किए गए 98 भाषा युग्मों पर Qwen और Gemini की तुलना कर सकता हूं। Gemini ने इनमें से 68 युग्मों में और Qwen ने 29 में अधिक स्कोर किया, तथा 10 में से औसत अंतर 0.08 अंक है। केवल कुल संख्या ही आपको यह नहीं बताती कि उर्दू से अंग्रेजी या अंग्रेजी से Haitian Creole के लिए कौन सा मॉडल चुना जाए।
यह लेख दिखाता है कि दोनों मॉडल कहां एक-दूसरे के करीब हैं और कहां प्रत्येक आगे है। यह यह भी बताता है कि मैं आपको अभी क्या नहीं बता सकता। मेरा डेटा 8 अगस्त, 2026 को समाप्त होता है, इससे पहले कि Google ने अक्टूबर में Gemini 4 की घोषणा की थी, इसलिए यह दोनों मॉडलों के पुराने संस्करणों का वर्णन करता है।
मुख्य बातें
- समान टेक्स्ट पर स्कोर किए गए 98 भाषा युग्मों में (12 जुलाई से 8 अगस्त, 2026 तक), Gemini ने 68 युग्मों में, Qwen ने 29 में अधिक स्कोर किया, और एक युग्म टाई रहा।
- औसत अंतर बहुत कम है, Qwen के 8.98 के मुकाबले Gemini के लिए 9.06, और 98 में से 60 युग्म 0.1 अंकों के दायरे में हैं।
- अंग्रेजी में अनुवाद करते समय, Qwen 27 में से 7 युग्मों में और Gemini 3 में 0.1 से अधिक अंकों से आगे है; अन्य 17 युग्म 0.1 अंकों के दायरे में हैं।
- अंग्रेजी से अनुवाद करते समय, Gemini 29 में से 13 युग्मों में 0.1 से अधिक अंकों से आगे है और Qwen किसी में भी नहीं।
- यह डेटा Google द्वारा अक्टूबर 2026 में Gemini 4 की घोषणा करने से पहले समाप्त होता है, इसलिए यह पहले के Gemini संस्करणों का वर्णन करता है और इसे वर्तमान मानने से पहले एक नए परीक्षण की आवश्यकता है।
क्या अनुवाद के लिए Qwen बेहतर है या Gemini?
यह दिशा पर निर्भर करता है, क्योंकि जब लक्षित भाषा अंग्रेजी होती है तो दोनों मॉडल करीब होते हैं और अधिकांश अन्य युग्मों में Gemini अधिक स्कोर करता है। सभी 98 युग्मों में, Gemini ने 68 में अधिक स्कोर किया। 12 जुलाई से 8 अगस्त, 2026 तक MachineTranslation.com के स्कोरों में, Gemini का औसत 10 में से 9.06 और Qwen का 8.98 था, जो कि 0.08 अंकों का औसत अंतर है।
यह पैनल केवल उन सेगमेंट्स की गणना करता है जहां ChatGPT, Claude, DeepSeek, Gemini, और Qwen सभी को वास्तविक स्कोर मिला, जिससे हर मॉडल का मूल्यांकन एक समान स्रोत टेक्स्ट पर किया जाता है। प्रत्येक भाषा युग्म में कम से कम 30 सेगमेंट्स हैं। मैं इस पैनल का उपयोग इसलिए करता हूं क्योंकि यह एक आम त्रुटि को दूर करता है, जो कि अलग-अलग टेक्स्ट पर मॉडलों की तुलना करना है।
संख्या के आधार पर, Gemini 68 युग्मों (69%) में आगे है, Qwen 29 (30%) में, और एक युग्म टाई रहा है। केवल संख्या इस अंतर को बढ़ा-चढ़ाकर दिखाती है, क्योंकि 98 में से 60 युग्म 0.1 अंकों के दायरे में हैं। अगले खंड परिणामों को दिशा और अंतर के अनुसार विभाजित करते हैं।
अनुवाद की कौन सी दिशाएं किस मॉडल के अनुकूल हैं?
Gemini तब आगे रहता है जब अंग्रेजी स्रोत भाषा होती है या जब दोनों में से कोई भी भाषा अंग्रेजी नहीं होती है, और जब अंग्रेजी लक्षित भाषा होती है तो Qwen इसके बराबर या आगे होता है। अंग्रेजी से अनुवाद में, Gemini 29 में से 13 युग्मों में 0.1 से अधिक अंकों से आगे है और Qwen किसी में भी नहीं। अंग्रेजी में अनुवाद में, Qwen 27 में से 7 युग्मों में उस अंतर से आगे है और Gemini 3 में।
| दिशा | जोड़े | Gemini 0.1 से अधिक से आगे | 0.1 अंक के भीतर | Qwen 0.1 से अधिक से आगे | औसत अंतर |
|---|---|---|---|---|---|
| अंग्रेजी में | 27 | 3 | 17 | 7 | Qwen +0.04 |
| अंग्रेजी से | 29 | 13 | 16 | 0 | Gemini +0.16 |
| दोनों में से कोई भी अंग्रेजी नहीं | 42 | 14 | 27 | 1 | Gemini +0.13 |
अंग्रेजी में, 27 में से 17 जोड़ियां 0.1 अंकों के भीतर हैं, Qwen 7 में आगे है, और Gemini 3 में आगे है। अंग्रेजी से, 29 में से 16 जोड़ियां 0.1 अंकों के भीतर हैं, Gemini 13 में आगे है, और Qwen किसी में भी आगे नहीं है। जहां दोनों में से कोई भी भाषा अंग्रेजी नहीं है, 42 में से 27 जोड़ियां 0.1 अंकों के भीतर हैं, Gemini 14 में आगे है, और Qwen 1 में आगे है।
अंग्रेजी में 27 में से 24 जोड़ियों में Qwen, Gemini से 0.1 अंकों के भीतर है या उससे आगे है। दिशा के आधार पर औसत देखें, तो अंग्रेजी में Qwen लगभग 0.04 अंक आगे है, जबकि अंग्रेजी से अन्य भाषाओं में Gemini लगभग 0.16 अंक आगे है और दो गैर-अंग्रेजी भाषाओं के बीच 0.13 अंक आगे है।
मुझे नहीं पता कि यह अंतर क्यों दिखता है, और यह डेटा मुझे यह नहीं बता सकता। एक स्पष्टीकरण जिसका मैं सबसे पहले परीक्षण करूंगा, वह प्रत्येक मॉडल के पीछे प्रशिक्षण टेक्स्ट का मिश्रण है, लेकिन मैंने वह परीक्षण नहीं किया है। ChatGPT के मुकाबले Qwen का रुझान भी कुछ ऐसा ही दिखता है। उसी पैनल पर, हमारे Qwen बनाम ChatGPT की तुलना में अंग्रेजी में दोनों लगभग बराबर रहे, जबकि अन्य 89% जोड़ियों में ChatGPT आगे रहा।
किन भाषा जोड़ियों में सबसे बड़ा अंतर दिखता है?
सबसे बड़े अंतर Gemini के पक्ष में हैं। यह रूसी से कज़ाख, अंग्रेजी से हाईटियन क्रिओल, अंग्रेजी से तागालोग, स्पेनिश से ग्रीक, और अरबी से फारसी में 0.51 से 0.95 अंकों से आगे है। Qwen की सबसे बड़ी बढ़त अपेक्षाकृत कम है, जो 0.15 और 0.26 अंकों के बीच है, और इसकी शीर्ष पांच में से चार जोड़ियां अंग्रेजी में अनुवाद की हैं।
| भाषा जोड़ी | Gemini स्कोर | Qwen स्कोर | अंतर |
|---|---|---|---|
| रूसी से कज़ाख | 9.27 | 8.32 | Gemini +0.95 |
| अंग्रेज़ी से हाईटियन क्रिओल | 9.19 | 8.27 | Gemini +0.92 |
| अंग्रेज़ी से तागालोग | 9.14 | 8.43 | Gemini +0.70 |
| स्पैनिश से ग्रीक | 8.90 | 8.33 | Gemini +0.57 |
| अरबी से फारसी | 8.84 | 8.34 | Gemini +0.51 |
| उर्दू से अंग्रेज़ी | 8.56 | 8.81 | Qwen +0.26 |
| चीनी से अंग्रेज़ी | 9.00 | 9.19 | Qwen +0.19 |
| स्वीडिश से अंग्रेज़ी | 8.29 | 8.46 | Qwen +0.16 |
| चीनी से इंडोनेशियाई | 9.03 | 9.19 | Qwen +0.16 |
| बर्मी से अंग्रेज़ी | 8.94 | 9.09 | Qwen +0.15 |
मैं इन्हें अंतिम रैंकिंग नहीं मानूँगा। दो सबसे बड़े अंतर, रूसी से कज़ाख और अंग्रेज़ी से हाईटियन क्रिओल, मीडियन जोड़ी की तुलना में छोटे नमूनों पर आधारित हैं। अंग्रेज़ी से तागालोग, स्पैनिश से ग्रीक और अरबी से फ़ारसी बड़े नमूनों पर आधारित हैं, इसलिए मैं उन तीनों पर अधिक भरोसा करूँगा। उन पर निर्भर होने से पहले मैं कम नमूने वाले दोनों अंतरों का पुनः परीक्षण करूँगा।
0.1 पॉइंट के अंतर का क्या मतलब है?
मेरे विचार में, 0.1 पॉइंट से कम का अंतर किसी विजेता को तय करने के लिए बहुत छोटा है। 98 पेयर्स में से, 60 इसी अंतर के दायरे में आते हैं, और प्रत्येक पेयर को सीमित संख्या में सेगमेंट्स पर स्कोर किया गया है। 0.1 की सीमा मेरी अपनी वर्किंग थ्रेशोल्ड है, और मैंने इन पेयर्स पर कोई सिग्निफिकेंस टेस्ट नहीं किया है।
एक स्कोर से कुछ अंतर छूट भी जाते हैं। हमारे कॉमन फ्रेज़ टेस्ट्स में, हमने 22 AI मॉडल्स के माध्यम से अरबी में "sorry" का परीक्षण किया। Gemini और Qwen दोनों ने कैज़ुअल آسف को चुना। ChatGPT और कंबाइंड रिज़ल्ट ने फॉर्मल عذرًا को चुना। प्रत्येक मॉडल का स्कोर 9.5 रहा, इसलिए दोनों शब्द रजिस्टर में भिन्न हैं और स्कोर में कोई बदलाव नहीं आया।
यही कारण है कि मैं मार्जिन और रजिस्टर के उदाहरणों को एक साथ देखता हूँ। स्पष्ट रजिस्टर अंतर वाले छोटे गैप के लिए मानवीय निर्णय की ज़रूरत होती है। छोटे सैंपल पर बड़े गैप के लिए फिर से टेस्ट करने की आवश्यकता होती है।
क्या Qwen और Gemini अलग अलग प्रकार की गलतियां करते हैं?
हाँ, क्योंकि हमारे 2026 World Cup कोट टेस्ट में दोनों मॉडलों ने कम से कम एक ऐसा विकल्प चुना जो अन्य मॉडलों ने नहीं चुना था, और स्कोर्स में मुश्किल से कोई बदलाव आया। Gemini ने Mbappé के एक वाक्यांश का अनुवाद "with each game" के रूप में किया और Wirtz के एक कोट का शब्दशः अनुवाद किया, जबकि Qwen ने Scaloni के एक कोट की अलग व्याख्या प्रस्तुत की। इन मामलों के स्कोर्स 9.2 से 9.5 के बीच रहे।
इसका विवरण हमारे World Cup कोट टेस्ट से आता है। आगे की ओर देखने से संबंधित Mbappé के कोट पर, अन्य मॉडलों ने "match" बनाए रखा जबकि Gemini ने "with each game" लिखा, जो रजिस्टर में एक छोटी सी चूक थी और इसका स्कोर 9.4 रहा। Wirtz के एक कोट पर, Gemini ने एक वाक्यांश का शब्दशः अनुवाद किया जिससे उसका अर्थ बदल गया, इसका स्कोर भी 9.4 रहा। Scaloni के कोट पर, अधिकांश मॉडल एक ही व्याख्या पर सहमत हुए जबकि Qwen ने "that is what matters" लिखा और 9.4 का स्कोर प्राप्त किया। Mbappé के रणनीतिक कोट पर, Claude और DeepSeek ने ब्रिटिश फ़ुटबॉल इंग्लिश को चुना जबकि Gemini, Qwen और अन्य ने अमेरिकन इंग्लिश को चुना, और Qwen ने 9.2 का स्कोर प्राप्त किया, जो बाकियों से कम था।
मैं इन्हें छोटी आदतें मानता हूँ। Gemini के उदाहरण रजिस्टर और शाब्दिक वाक्यांशों से संबंधित हैं। Qwen के उदाहरण इस बारे में हैं कि किसी पंक्ति की कौन सी व्याख्या चुनी जाए। चार उदाहरण किसी पैटर्न को स्थापित करने के लिए बहुत कम हैं, लेकिन वे दिखाते हैं कि एक अकेला स्कोर किस प्रकार के अंतर को छिपा देता है।
अनुवाद के लिए कौन सा Qwen मॉडल सबसे अच्छा है?
मैं अपने डेटा से यह नहीं कह सकता, क्योंकि MachineTranslation.com के स्कोर्स बिना किसी वर्ज़न टैग के Qwen को एक ही मॉडल के रूप में मानते हैं। Alibaba का Qwen3.8 फैमिली अगस्त 2026 में Hugging Face पर पहुंचा, इसलिए अब इसके कई वर्ज़न मौजूद हैं, और इस लेख के स्कोर्स उन्हें अलग नहीं करते हैं।
मैं इसे वर्ज़न के अनुसार अलग करना चाहूँगा, लेकिन अभी ऐसा नहीं कर सकता। प्लेटफ़ॉर्म स्तरीय संख्या उस समयावधि में चलाए गए एक से अधिक Qwen वर्ज़न का औसत हो सकती है। यदि आप किसी प्रोजेक्ट के लिए Qwen वर्ज़न के बीच चयन कर रहे हैं, तो मैं अपने खुद के टेक्स्ट के सैंपल पर उनकी तुलना करने की सलाह दूँगा।
अनुवाद के लिए Gemini के कुछ विकल्प क्या हैं?
ChatGPT, Claude, DeepSeek, Qwen, Grok और Mistral AI सभी MachineTranslation.com पर चलते हैं, और सही विकल्प पेयर पर निर्भर करता है। हमारे 12 जुलाई से 8 अगस्त, 2026 के स्कोर्स में, अंग्रेज़ी में अनुवाद वाले 27 पेयर्स में से 24 में Qwen या तो Gemini से 0.1 पॉइंट के भीतर है या उससे आगे है। हमारे Mistral AI फ्रेंच स्कोर्स दिखाते हैं कि इसका फ्रेंच से अंग्रेज़ी का औसत Gemini से 0.40 पॉइंट ऊपर है।
यदि आपका विकल्प ChatGPT है, तो जवाब पेयर के अनुसार भी बदलता है। हमारे प्रकाशित स्पैनिश से अंग्रेज़ी ब्रेकडाउन में, Gemini ने 31% सेगमेंट्स जीते और ChatGPT ने 21%। फ्रेंच पर, कोई भी मॉडल दोनों दिशाओं में नहीं जीतता। चूँकि पसंद पेयर के साथ बदलती है, MachineTranslation.com किसी एक विकल्प को नहीं चुनता। यह उन्हें एक साथ चलाता है।
मेरा सुझाव है कि युग्म और दिशा से शुरुआत करें, और फिर देखें कि कौन सा विकल्प उपयुक्त बैठता है।
MachineTranslation.com यह कैसे दिखाता है कि Qwen और Gemini कहाँ असहमत हैं?
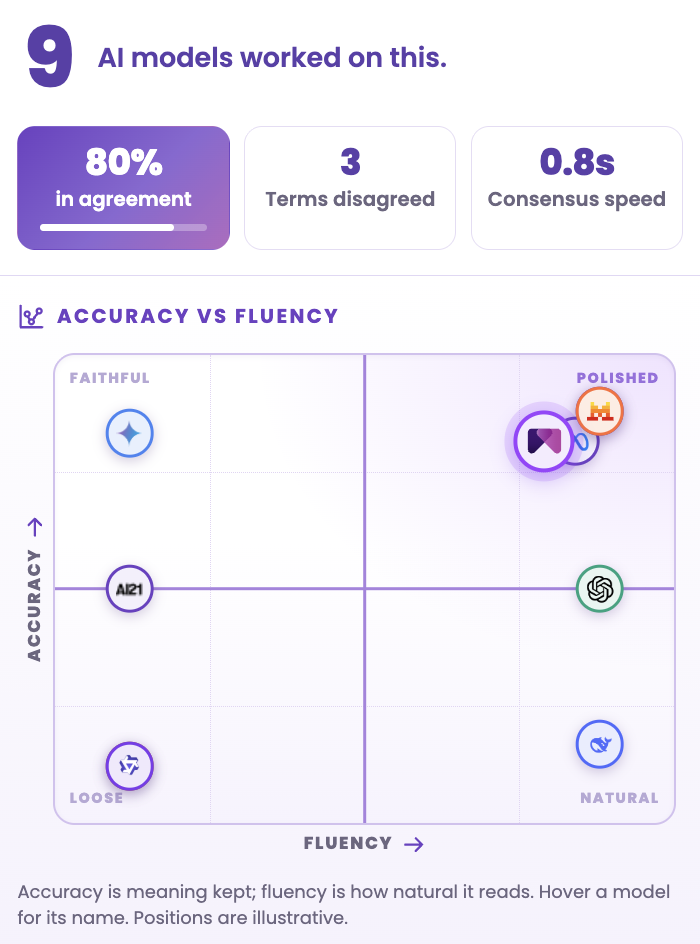
MachineTranslation.com प्रत्येक अनुवाद पर दोनों मॉडलों को चलाता है और दिखाता है कि मॉडल कहाँ सहमत हैं और कहाँ अलग होते हैं। सहमति पैनल यह रिपोर्ट करता है कि टेक्स्ट पर कितने AI मॉडलों ने काम किया, सहमति का हिस्सा कितना था, कितने शब्दों पर विवाद था, और सहमति कितनी तेज़ी से बनी।
ये परिणाम कितने हाल के हैं?
ये परिणाम 12 जुलाई से 8 अगस्त, 2026 तक के हैं, इसलिए ये उस समय चल रहे Gemini और Qwen संस्करणों का विवरण देते हैं। Google ने घोषणा की Gemini 4 अक्टूबर 2026 में। Alibaba का Qwen3.8 परिवार अगस्त 2026 में आया। मेरी सिफारिश है कि किसी नए प्रोजेक्ट के लिए इन नंबरों पर भरोसा करने से पहले पैनल को दोबारा चलाएँ।
मुझे उम्मीद है कि नॉइज़ के लिए कुछ गुंजाइश रखते हुए समान टेक्स्ट की तुलना करने की विधि प्रभावी बनी रहेगी। मुझे उम्मीद है कि अंतर का आकार बदलेगा। मैं ऐसे किसी भी युग्म को, जहाँ नए रन में अग्रणी मॉडल बदल जाता है, इस बात का संकेत मानूँगा कि पहले का अंतर नॉइज़ के दायरे में था।
मैं किसी प्रोजेक्ट के लिए Qwen और Gemini के बीच चुनाव कैसे करूँगा?
मेरी राय युग्म और दिशा के आधार पर चुनने की है और पूरे प्रोजेक्ट के लिए केवल एक बार चयन करने से बचने की है। व्यवहार में इसका अर्थ है 0.1 अंक से कम के अंतर को टाई मानना और युग्मों के बीच अग्रणी मॉडल के बदलने की उम्मीद करना। यह वह क्रम है जिसका मैं पालन करूँगा।
- प्रोजेक्ट में प्रत्येक भाषा युग्म को सूचीबद्ध करें और उसकी दिशा चिह्नित करें।
- इस लेख में प्रत्येक pair के अंतर की जाँच करें। 0.1 points से कम के अंतर को टाई मानें।
- जहाँ अंतर अधिक हो, वहाँ अग्रणी मॉडल से शुरुआत करें और अपने स्वयं के टेक्स्ट के एक नमूने का परीक्षण करें।
- यदि आपकी सामग्री दोनों दिशाओं में जाती है, तो pairs के बीच अग्रणी मॉडल बदलने की उम्मीद रखें।
- जब भी कोई मॉडल नया संस्करण जारी करे, तो दोबारा जाँच करें।
MachineTranslation.com पर हर अनुवाद में ये दोनों मॉडल 20 अन्य मॉडलों के साथ चलते हैं। वह संस्करण प्रस्तुत किया जाता है जिस पर उनमें से अधिकांश सहमत होते हैं, इसलिए पूरे प्रोजेक्ट के लिए केवल एक बार ही चयन करने की आवश्यकता नहीं होती है। मॉडलों के परिणामों का पूरा सेट हमारे मॉडल तुलना परीक्षण में उपलब्ध है।
अक्सर पूछे जाने वाले प्रश्न
1. अनुवाद के लिए Qwen या Gemini में से कौन सा बेहतर है?
यह दिशा पर निर्भर करता है, क्योंकि अंग्रेजी में अनुवाद के 27 pairs में से 24 में Qwen, Gemini से 0.1 points के दायरे में है या उससे आगे है। MachineTranslation.com के 12 जुलाई से 8 अगस्त, 2026 के स्कोर्स में Gemini ने 98 में से 68 pairs में अधिक स्कोर किया। 10 में से औसत अंतर 0.08 points का है, इसलिए मैं pair के अनुसार चयन करने का सुझाव दूंगा।
2. अनुवाद के लिए कौन सा Qwen मॉडल सबसे अच्छा है?
मैं हमारे डेटा के आधार पर यह नहीं कह सकता, क्योंकि MachineTranslation.com के स्कोर्स Qwen को बिना किसी संस्करण टैग के एक ही मॉडल मानते हैं। Alibaba का Qwen3.8 परिवार अगस्त 2026 में Hugging Face पर आया, इसलिए अब इसके कई संस्करण मौजूद हैं। जब तक स्कोर्स उन्हें अलग नहीं करते, तब तक किसी प्रोजेक्ट के लिए किसी एक को चुनने से पहले मैं अपने स्वयं के टेक्स्ट के नमूने पर संस्करणों की तुलना करने का सुझाव दूंगा।
3. अनुवाद के लिए Gemini के कुछ विकल्प क्या हैं?
ChatGPT, Claude, DeepSeek, Qwen, Grok और Mistral AI सभी MachineTranslation.com पर चलते हैं। हमारे 12 जुलाई से 8 अगस्त, 2026 के स्कोर्स में, अंग्रेजी में अनुवाद के 27 pairs में से 24 में Qwen, Gemini के 0.1 points के दायरे में या उससे आगे है। Mistral AI का फ्रेंच से अंग्रेजी का औसत Gemini से 0.40 points अधिक रहा। सही विकल्प pair पर निर्भर करता है।
4. क्या अनुवाद के लिए Gemini, ChatGPT से बेहतर है?
यह लैंग्वेज pair पर निर्भर करता है, क्योंकि कोई भी अकेला AI मॉडल हर जगह नहीं जीतता। हमारे प्रकाशित स्पैनिश से अंग्रेजी के विश्लेषण में, Gemini ने 31% सेगमेंट्स जीते और ChatGPT ने 21%। फ्रेंच पर, कोई भी मॉडल दोनों दिशाओं में नहीं जीतता है। उनके बीच चयन करने से पहले मैं आपकी आवश्यकता वाले pair और दिशा की जाँच करने का सुझाव दूंगा।
5. क्या Gemini अनुवाद के लिए सटीक है?
हाँ, क्योंकि MachineTranslation.com के July 12 to August 8, 2026 के स्कोर्स में Gemini का औसत 98 भाषा जोड़ों में 10 में से 9.06 था। सटीकता फिर भी जोड़े के आधार पर भिन्न होती है। इसकी बढ़त अंग्रेजी से अनुवाद में सबसे अधिक है, और अंग्रेजी में 27 में से 7 जोड़ों पर Qwen इससे 0.1 अंक से अधिक आगे है।