October 2, 2026
Qwen बनाम Grok: कौन सा AI मॉडल बेहतर अनुवाद करता है?
Qwen और Grok दोनों ही सामान्य-उद्देश्य वाले AI मॉडल हैं, न कि विशेष रूप से अनुवाद करने वाले टूल, और दोनों ही उन मॉडलों के पूल का हिस्सा हैं जिन्हें MachineTranslation.com हर अनुवाद पर चलाता है। आगे जो बताया गया है, उसे समझने के लिए यह जानना महत्वपूर्ण है। यह इस बात पर एक नज़र है कि प्लेटफ़ॉर्म के दो अपने मॉडल एक-दूसरे के मुक़ाबले कैसा प्रदर्शन करते हैं, जिसमें इस तरह के डेटा के साथ आने वाली वास्तविक सीमाएं भी शामिल हैं, न कि यह दो बाहरी चुनौती देने वालों और स्वयं प्लेटफ़ॉर्म के बीच की कोई प्रतियोगिता है।
Qwen और Grok क्या हैं?
Qwen Alibaba के लार्ज लैंग्वेज मॉडल्स का परिवार है, जो वर्तमान में अपनी Qwen3.8 पीढ़ी पर है, और इसे प्लेटफ़ॉर्म के चल रहे विस्तार के हिस्से के रूप में MachineTranslation.com के मॉडल पूल में जोड़ा गया था। Grok xAI की मॉडल लाइन है, जो इस लेख के लिखे जाने तक Grok 4.7 पर है, और इस लेख में मूल रूप से जिस संस्करण की तुलना की गई थी, उसके बाद से कई रिलीज़ से गुज़र चुकी है, और अलग से प्लेटफ़ॉर्म में शामिल हुई है। दोनों में से कोई भी मॉडल विशेष रूप से अनुवाद के लिए नहीं बनाया गया था। दोनों ही सामान्य-उद्देश्य वाले सिस्टम हैं जो व्यापक भाषा क्षमता के हिस्से के रूप में कई भाषाओं को संभालते हैं, जो कि विशेष रूप से अनुवाद गुणवत्ता के इर्द-गिर्द बनाए और परखे गए प्लेटफ़ॉर्म की तुलना में एक अलग शुरुआती बिंदु है।
MachineTranslation.com के अपने डेटा पर Qwen और Grok एक-दूसरे की तुलना में कैसे हैं?
प्लेटफ़ॉर्म ट्रैफ़िक के पिछले 28 दिनों में, Grok ने औसतन Qwen से अधिक स्कोर किया: 8.87 के मुकाबले 10 में से 9.26। Grok के सबसे खराब स्कोर वाले 10% अनुवादों का औसत भी 9.2 रहा, जबकि Qwen के सबसे खराब स्कोर वाले 10% का औसत गिरकर 7.6 हो गया, जो निचले स्तर पर एक ऐसा बड़ा अंतर है जिसे केवल औसत से नहीं समझा जा सकता।
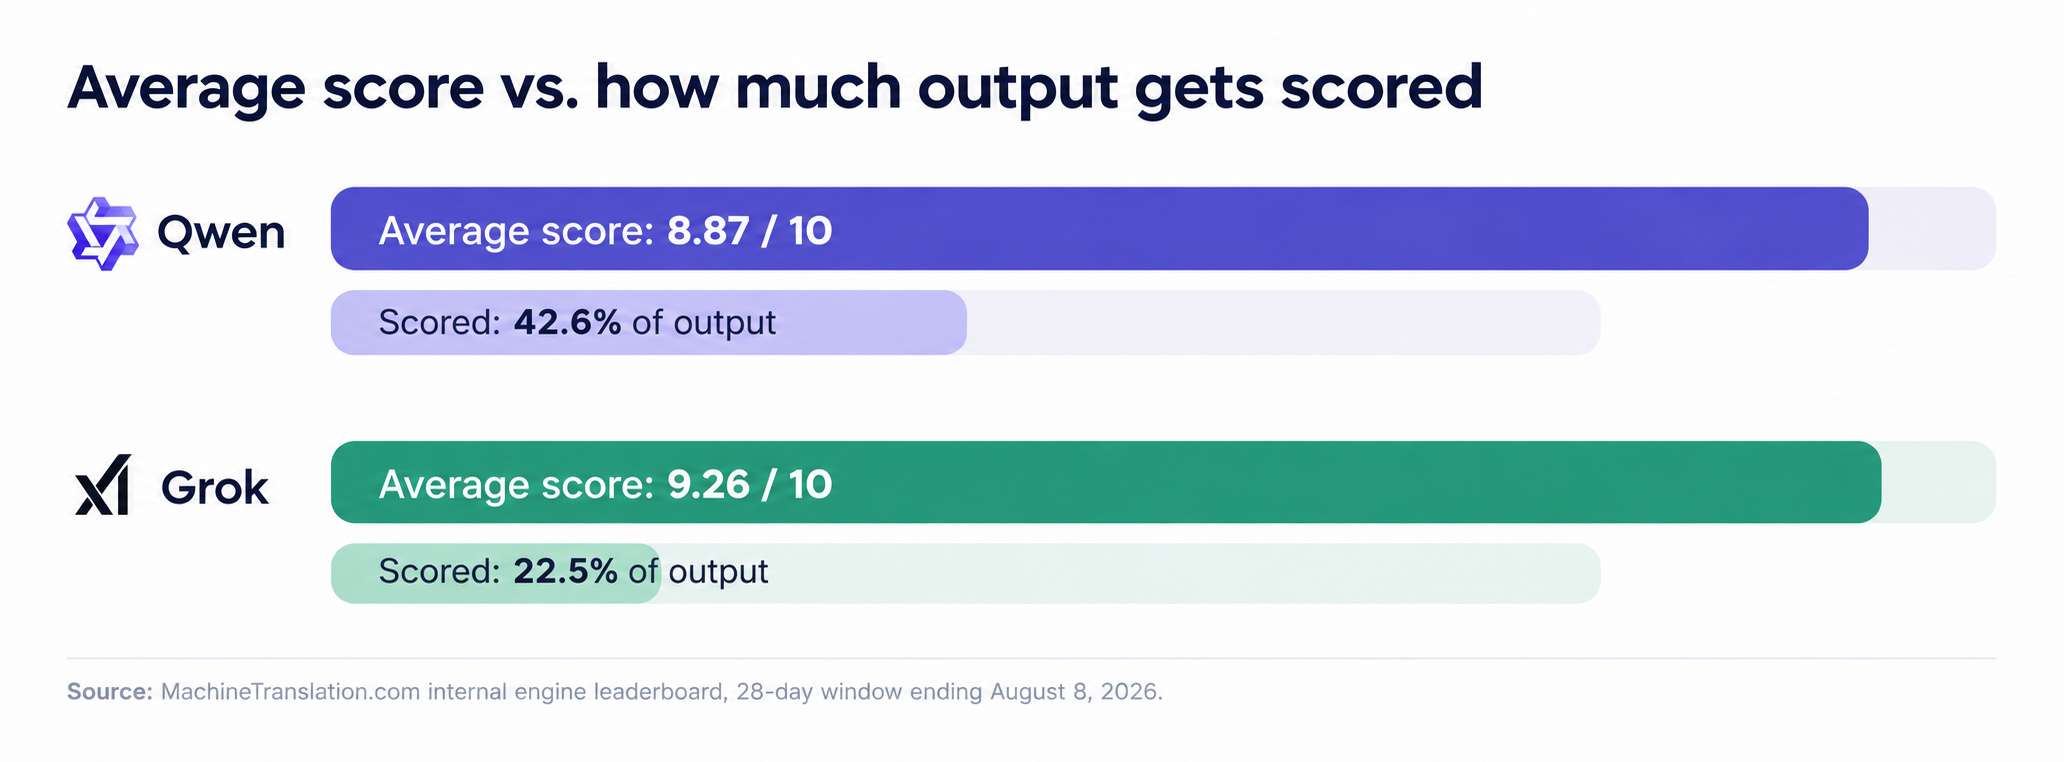
Grok का औसत स्कोर अधिक है, लेकिन यह इसके एक चौथाई से भी कम आउटपुट के स्कोरिंग पर आधारित है, जबकि Qwen के लिए यह लगभग आधा है। ये दोनों बार एक ही कहानी के अलग-अलग हिस्से बताते हैं।
| Qwen | Grok | |
|---|---|---|
| स्कोर किए गए आउटपुट का प्रतिशत | 42.6% | 22.5% |
| औसत स्कोर | 8.87 / 10 | 9.26 / 10 |
| निचले 10% स्कोर | 7.6 | 9.2 |
स्रोत: MachineTranslation.com का इंटरनल इंजन लीडरबोर्ड, 8 अगस्त, 2026 को समाप्त होने वाली 28-दिनों की अवधि।
क्या Grok के उच्च स्कोर का मतलब यह है कि यह एक बेहतर विकल्प है?
अपने आप में नहीं। प्लेटफॉर्म पर Qwen की तुलना में Grok का उपयोग बहुत कम किया जाता है, और इसके एक चौथाई से भी कम ट्रांसलेशन को स्कोर किया जाता है, जबकि Qwen के लगभग आधे ट्रांसलेशन को स्कोर मिलता है। एक छोटा, कम प्रातिनिधिक सैंपल औसत को उस वॉल्यूम की तुलना में बेहतर या बदतर दिखा सकता है जो Qwen देखता है। इस डेटा पर MachineTranslation.com की अपनी रिपोर्टिंग स्कोरिंग कवरेज को केवल एक फुटनोट नहीं, बल्कि एक वास्तविक सीमा मानती है: अपने ट्रैफ़िक के एक छोटे हिस्से पर स्कोर किए गए इंजन का उतनी अच्छी तरह से परीक्षण नहीं किया गया है, जितना कि उसके लगभग आधे आउटपुट पर स्कोर किए गए इंजन का किया गया है।
ईमानदारी से समझें तो Grok के नंबर आशाजनक हैं लेकिन सीमित हैं। औसतन Qwen के नंबर कम हैं लेकिन वे बहुत बड़े और अधिक प्रातिनिधिक आधार पर टिके हैं। दोनों में से कोई भी तथ्य एक-दूसरे को खारिज नहीं करता है।
भाषा कवरेज के बारे में क्या?
न तो Qwen और न ही Grok उन भाषा जोड़ियों की कोई सत्यापित सूची प्रकाशित करता है जहाँ प्रदर्शन में गिरावट आती है, और इसकी पुष्टि करने के लिए कोई स्वतंत्र परीक्षण भी मौजूद नहीं है। पूरे विश्वास के साथ जो कहा जा सकता है वह यह है कि किसी भी मॉडल को एक विशिष्ट भाषा सेट में ट्रांसलेशन क्वालिटी के लिए उस तरह नहीं बनाया गया है जैसे एक समर्पित ट्रांसलेशन प्लेटफॉर्म को बनाया जाता है। MachineTranslation.com सीधे तौर पर 270 से अधिक भाषाओं का परीक्षण और समर्थन करता है, जो कि एक सामान्य-उद्देश्य वाले मॉडल की व्यापक लेकिन अपरीक्षित बहुभाषी क्षमता की तुलना में एक अलग तरह का दावा है।
MachineTranslation.com असल में Qwen और Grok का उपयोग कैसे करता है
MachineTranslation.com हर ट्रांसलेशन पर Qwen, Grok और 20 से अधिक अन्य AI मॉडल चलाता है, फिर उस वर्ज़न को सामने लाता है जिस पर ये मॉडल सबसे अधिक सहमत होते हैं। औसत स्कोर कम होने के कारण किसी भी मॉडल को बाहर नहीं किया जाता है। एक साथ कई मॉडल चलाने का मतलब उन मामलों को पकड़ना है जहाँ औसतन कम स्कोर वाला मॉडल भी किसी विशिष्ट वाक्य को सही ढंग से ट्रांसलेट कर देता है जिसे उच्च स्कोर वाला मॉडल चूक जाता है। दिशा और पेयरिंग के आधार पर भी Qwen का प्रदर्शन अलग-अलग होता है, जिसे केवल एक मॉडल चुनने से पहले जानना जरूरी है; इसे MachineTranslation.com की Qwen बनाम DeepSeek तुलना में अधिक विस्तार से कवर किया गया है। यह करीब से देखने के लिए कि मॉडलों का एक-दूसरे के खिलाफ सीधे परीक्षण कैसे किया जाता है, MachineTranslation.com का फुल मॉडल कम्पेरिजन टेस्टिंग देखें।
अक्सर पूछे जाने वाले प्रश्न
1. ट्रांसलेशन के लिए Qwen या Grok में से कौन बेहतर है?
MachineTranslation.com के अपने 28-दिन के इंजन डेटा के अनुसार, Grok का औसत स्कोर Qwen की तुलना में अधिक है, 10 में से 8.87 के मुकाबले 9.26। लेकिन Grok को इसके आउटपुट के बहुत छोटे और कम प्रतिनिधित्व वाले हिस्से पर स्कोर किया गया है, इसलिए यह उस तरह का स्पष्ट सीधा मुकाबला नहीं है जैसा कि एक मैच्ड-सेगमेंट टेस्ट में होता है।
2. Grok का औसत स्कोर अधिक क्यों है लेकिन स्कोर किए गए अनुवाद कम क्यों हैं?
प्लेटफ़ॉर्म पर Grok का उपयोग कम किया जाता है और इसके आउटपुट का केवल 22.5% ही स्कोर किया जाता है, जबकि Qwen के लिए यह 42.6% है। एक छोटा, कम प्रतिनिधित्व वाला नमूना औसत को बढ़ा या घटा सकता है, यही कारण है कि इस तुलना को दिशात्मक माना जाना चाहिए, न कि निर्णायक।
3. क्या Qwen या Grok अधिक भाषाओं को सपोर्ट करता है?
दोनों सामान्य-उद्देश्य वाले AI मॉडल हैं जिनकी भाषा-विशिष्ट सीमाओं की कोई प्रकाशित, सत्यापित सूची नहीं है। दोनों में से कोई भी विशेष रूप से अनुवाद के लिए नहीं बनाया गया है, जो एक ऐसे प्लेटफ़ॉर्म से अलग है जो मापे गए अनुवाद प्रदर्शन के विकल्प के रूप में व्यापक बहुभाषी प्रशिक्षण पर निर्भर रहने के बजाय सीधे 270+ भाषाओं में अनुवाद गुणवत्ता का परीक्षण और स्कोर करता है।
4. क्या MachineTranslation.com, Qwen और Grok के साथ प्रतिस्पर्धा करता है?
नहीं। MachineTranslation.com हर अनुवाद पर Qwen, Grok और 20 से अधिक अन्य AI मॉडल चलाता है और उस संस्करण को सामने लाता है जिस पर ये मॉडल सबसे अधिक सहमत होते हैं। यह अपने स्वयं के एक अलग मॉडल के रूप में उनके खिलाफ प्रतिस्पर्धा करने के बजाय इस तरह के मॉडल का परीक्षण करता है और उन्हें एक साथ जोड़ता है।
5. MachineTranslation.com अनुवाद के लिए किस AI मॉडल की अनुशंसा करता है?
डिफ़ॉल्ट रूप से किसी की नहीं। विभिन्न मॉडल भाषा युग्म और कंटेंट के प्रकार के अनुसार अलग-अलग प्रदर्शन करते हैं, और अनुवाद की जाने वाली सामग्री के आधार पर उनके बीच का अंतर किसी भी दिशा में जा सकता है। यह भिन्नता ही वह कारण है कि प्लेटफ़ॉर्म स्थायी अनुशंसा के रूप में किसी एक को चुनने के बजाय हर अनुवाद पर कई मॉडल चलाता है।