May 8, 2026
Grok vs. Claude fordításra: mit mutatnak a benchmarkok (2026)
A Grok (xAI) és a Claude (Anthropic) egyaránt alkalmas AI fordítóeszközök, de strukturálisan eltérő erősségekkel rendelkeznek. A legtöbb általános fordítási feladat esetében nem fogsz érdemi különbséget észrevenni közöttük. Két konkrét forgatókönyv esetében (a közelmúlt eseményeiről szóló tartalmak fordítása, valamint a pontosságot igénylő hivatalos dokumentumok fordítása) a különbség valós, és azon alapul, hogyan építették fel az egyes modelleket.
Ez a cikk bemutatja, mit kínálnak valójában az egyes modellek a fordítás terén, hová helyezik őket a független összehasonlító tesztek, és mit érdemes használni, ha önmagában egyik modell eredménye sem elegendő.
Hogyan hasonlítható össze a Grok és a Claude fordítási minősége?
A rövid válasz: A Claude vezet a független professzionális fordítási benchmarkok terén. A Grok specifikus előnye a valós idejű tudáselérés, nem pedig az általános fordítási minőség.
A MachineTranslation.com belső benchmarkjaiban a Claude (3.5 Sonnet szint) 93.8 pontot ér el a 100-ból a fordítási minőség terén — a pontosság, a terminológia és a stílus együttesét tekintve. A Grok nem szerepel a legjobb 14 megoldás között az Intento State of Translation Automation 2025 jelentésében, amely 46 MT-motort és LLM-et értékelt 11 nyelvpárban. A Claude Opus 4 és a Claude Sonnet 3.7 egyaránt szerepel a top 14-ben. Forrás: MachineTranslation.com belső benchmarkjai; Intento State of Translation Automation 2025.
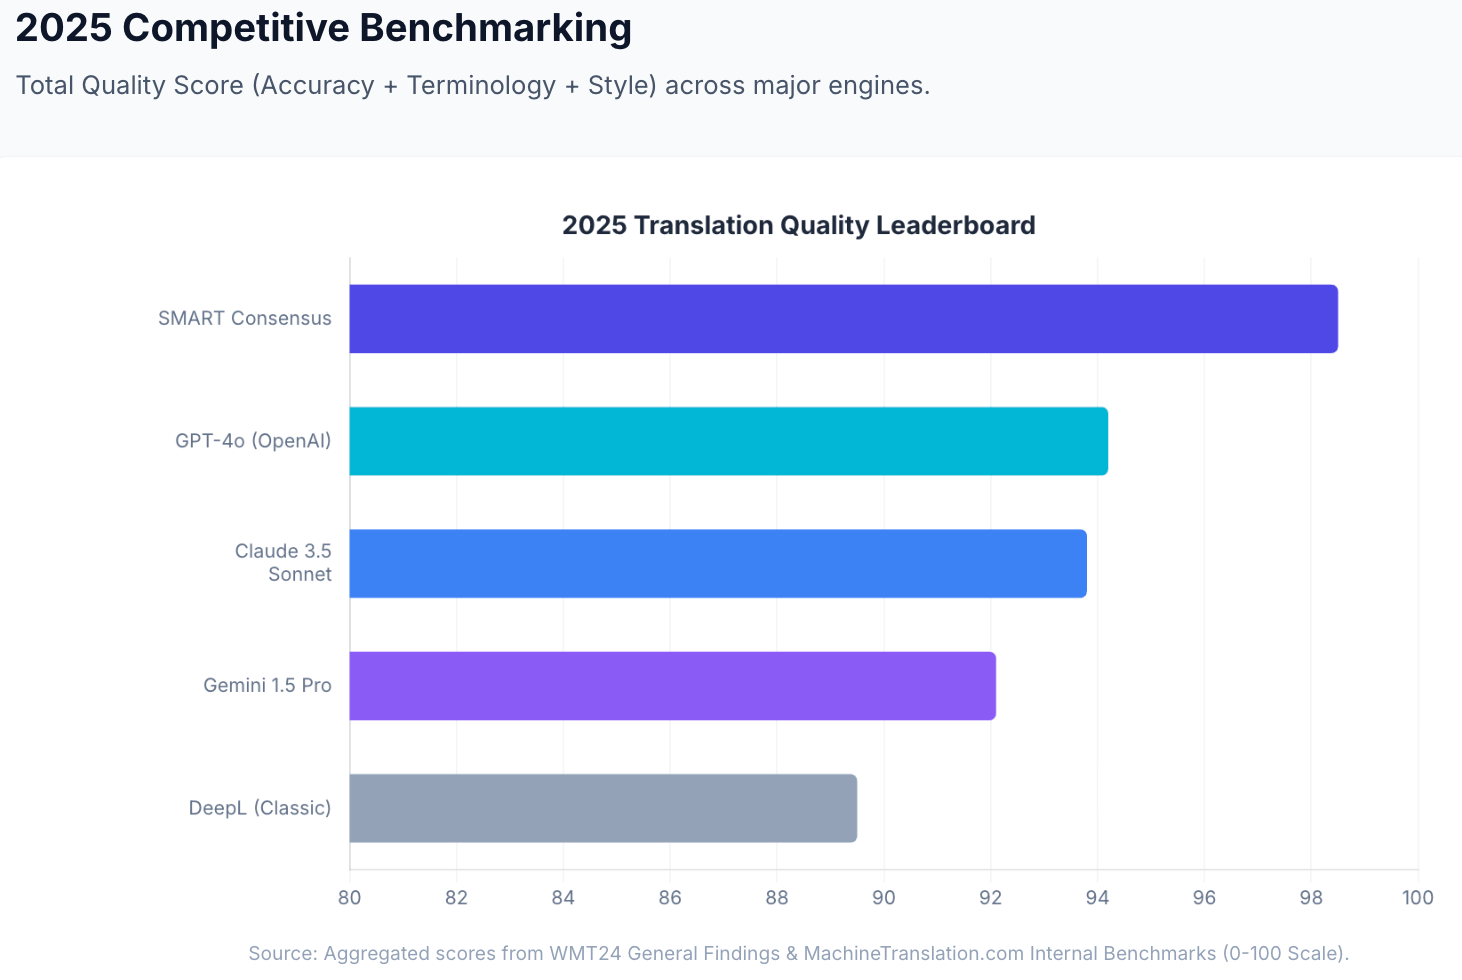
A WMT24 (a fordítóipar elsődleges független benchmark-versenye) során a Claude 3.5 az első helyen végzett 11 nyelvpárból 9-ben, megelőzve a GPT-4-et és a dedikált neurális MT-motorokat. A Lokalise professzionális fordítók által végzett 2025-ös vaktesztjében a Claude 3.5 fordítások 78%-át értékelték „jónak” — ami a legmagasabb arány a tesztelt LLM-ek között.
A Grok nem került kiértékelésre a WMT24-ben vagy az Intento független LQA-értékelésében összehasonlítható szinten. A Slator Pro Guide (2025) a Grok modellt a professzionális környezetben fordításra használt általános célú LLM-ek egyikeként említi a GPT és a Claude mellett, de nem sorolja egyikük elé sem.
| Benchmark | Grok | Claude |
|---|---|---|
| MachineTranslation.com belső minőségi pontszám | Nem mérték benchmark szinten | 93.8/100 (3.5 Sonnet szint) |
| Intento 2025 top 14 megoldás | Nem szerepel a listán | Claude Opus 4, Sonnet 3.7 mindkettő szerepel a listán |
| WMT24 nyelvpárok | Nem értékelték | 1. helyezett 9/11 nyelvpárban |
| Lokalise 2025 vakteszt | Nem értékelték | 78% jó (a legmagasabb az LLM-ek között) |
Forrás: MachineTranslation.com belső benchmarkjai; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Miben van a Groknak valódi előnye?
Valós idejű és aktuális események fordítása. A Grok meghatározó építészeti jellemzője az X (korábban Twitter) platform adataival és az élő internetes kereséssel való integrációja. A Claude-dal és a legtöbb egyéb LLM-mel ellentétben, amelyeket rögzített tudásbázis-lezárási időpontokkal rendelkező statikus adatkészleteken képeztek ki, a Grok valós idejű információkat épít be a kimeneteibe. A közelmúltbeli eseményeket, újonnan megjelent termékeket, újonnan megjelenő politikai terminológiát, friss híreket vagy az elmúlt hetekben történt dolgokra utaló tartalmakat érintő fordítási feladatok esetében a Grok olyan kontextushoz fér hozzá, amelyhez a Claude nem.
Ez kifejezetten a következők esetében fontos: közelmúltbeli eseményekről szóló hírcikkek fordítása, termékbejelentések lokalizálása gyorsan változó piacok számára, olyan újonnan alkotott terminológia vagy szleng kezelése, amely későbbi, mint a többi modell tanítási adatai, valamint minden olyan tartalom, amelynek jelentése attól függ, hogy tudjuk-e, mi történt a közelmúltban.
Újonnan megjelenő és fejlődő terminológia. A technikai területek, az iparágak és a kulturális kontextusok folyamatosan új terminológiát hoznak létre. A nemrégiben alkotott kifejezéseket, új szabályozási szaknyelvet vagy új terméknómenklatúrát érintő fordítási feladatok esetében a Grok frissített betanítása és valós idejű keresése olyan használati mintákhoz biztosít hozzáférést, amelyeket a régebbi tanítóadat-pillanatképek nem rögzítenek.
Grok 4.1 kontextusablak és következtetés. Grok 4.1 (2025 végén) 131K-tokenes kontextusablakkal és továbbfejlesztett érvelési képességekkel rendelkezik, ami alkalmassá teszi az összetett, többrétegű dokumentumok kezelésére, ahol a tagmondatok közötti kapcsolatok és a logikai koherencia számítanak.
Miben van a Claude-nak valódi előnye?
Fordítási minőség a független benchmarkokon. Claude előnyét független szakmai értékelés dokumentálja, nem pedig saját bevalláson alapuló állítások. A WMT24 a Claude 3.5-öt rangsorolta az első helyre 11 nyelvpárból 9-ben a teljes mezőnnyel szemben. A Lokalise 2025-ös vakvizsgálata megállapította, hogy a hivatásos fordítók 78%-os „jó” aránnyal a Claude 3.5 kimenetét részesítették előnyben — ez magasabb, mint a GPT-4, a DeepL és a Google Translate aránya ugyanebben az értékelésben. Ezek vakértékelések: professzionális fordítók értékelték a kimenetet anélkül, hogy tudták volna, melyik modell állította elő.
Konkrét nyelvpárok az Intento 2025 szerint. A Claude Opus 4 és a Sonnet 3.7 a „best” kategóriában szerepelnek az angol-német, angol-japán, angol-olasz, angol-koreai, angol-holland, angol-arab és angol-francia nyelvpárok esetében az Intento humán LQA-értékelésében. Ezen párok esetében a kettő közül a Claude a dokumentáltan erősebb választás.
Precíz hangvétel és árnyalt tartalom. A Lokalise-tanulmányban részt vevő hivatásos fordítók az összes LLM közül a legnagyobb arányban Claude kimenetét részesítették előnyben — ami tükrözi Claude dokumentált erősségét a regiszter, a szerzői hang és a kontextuális jelentés megőrzésében. Irodalmi fordítások, jogi dokumentumok, hivatalos kommunikáció és marketinganyagok esetében, ahol az, hogy hogyan mondanak el valamit, éppoly fontos, mint az, hogy mit mondanak, a Claude következetesen jól teljesít a független értékelések során.
Hosszú dokumentumok koherenciája. A Claude 4.6 Sonnet 200K tokenes kontextusablakot támogat, míg a Claude Opus 4.6 bétában 1M tokent támogat. Hosszú, hivatalos dokumentumok (szerződések, műszaki kézikönyvek, klinikai vizsgálati jelentések) esetén a Claude képes a teljes dokumentumot egyetlen menetben feldolgozni, mindvégig fenntartva a terminológiai következetességet. A töredékekben feldolgozott dokumentumok 28%-kal magasabb terminológiai következetlenségi arányt mutatnak a teljes dokumentumként történő feldolgozáshoz képest. Forrás: MachineTranslation.com belső adatai.
Hogyan hasonlíthatók össze a nyelvi támogatás és az árazás terén?
Nyelvi támogatás: Mind a Grok 4.1, mind a Claude 4.6 támogatja a fordítást a legtöbb főbb világnyelven. A Claude-ot függetlenül értékelték európai és kelet-ázsiai nyelvpárokban, meggyőző eredményekkel. A Grok többnyelvű támogatása javult az egymást követő verziók során. Az alacsony erőforrású nyelvek esetében mindkét modell minősége romlik — az emberi ellenőrzés indokolt az alacsony erőforrású nyelvpárok tartalmánál, függetlenül attól, hogy melyik modellt használják.
Árazás:
| Csomag | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Fogyasztói (havi) | SuperGrok: $30/hónap | Claude Pro: $20/hónap |
| API bemenet (M tokenenként) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API kimenet (M tokenenként) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Ingyenes szint | Igen (sebességkorlátozott az X/Grok.com-on keresztül) | Igen (sebességkorlátozott a claude.ai-on keresztül) |
A fogyasztói szinten a Claude Pro ($20/month) is cheaper than SuperGrok ($30/hónap). Az API szintjén a Grok 4.1 enyhe költségelőnnyel rendelkezik a Claude Sonnet 4.6-tal szemben a nagy bemeneti igényű fordítási munkafolyamatok esetében.
Melyik jobb a konkrét tartalomtípusokhoz?
| Tartalomtípus | Ajánlott modell | Indoklás |
|---|---|---|
| Friss hírek / aktuális események | Grok | Valós idejű adathozzáférés; a statikusan betanított modellekből hiányzik az aktuális kontextus |
| Új terminológia / új termékbevezetések | Grok | Az élő keresési integráció rögzíti a legutóbbi használati mintákat |
| Hivatalos jogi dokumentumok | Claude | WMT24 és Lokalise 2025 független értékelés; hangvétel pontossága |
| Orvosi / klinikai tartalom | Claude | Független benchmark-helyezés; nyelvi regiszter megőrzése |
| Marketing szövegek / kreatív tartalom | Claude | Lokalise 2025 vakteszt-preferencia; hangvételi árnyalatok |
| Műszaki dokumentáció (hosszú) | Claude | 200K-1M kontextusablak; terminológiai konzisztencia a teljes terjedelemben |
| Közösségi média / társalgási tartalom | Bármelyik | Mindkettő jól kezeli a magas erőforrású társalgási párokat |
| Fejlesztői / API integráció | Bármelyik | Mindkettő kínál API-hozzáférést; a Grok némileg olcsóbb a bemeneti tokenek esetében |
Mit használjunk, ha egy modell nem elég
Mind a Grok, mind a Claude egymodelles eszköz. Minden egyes AI-modell (függetlenül attól, hogy mennyire képes) olyan hibákat generál, amelyeket nem képes észlelni a saját kimenetében. Egy gördülékeny, magabiztos fordítás akár a Grok, akár a Claude részéről még mindig lehet szemantikailag hibás, és keresztellenőrzés nélkül nincs mód ennek kiderítésére.
Mind a Grok, mind a Claude szerepel a MachineTranslation.com SMART rendszerének 22 modellje között. A SMART mind a 22 modellt egyidejűleg futtatja (beleértve a Grok és Claude modelleket), és azt a kimenetet adja vissza, amelyben a többség egyetért.
Mit jelent ez a Grok vs. Claude kérdés szempontjából: Grok valós idejű ereje és Claude kontextuális mélysége egyaránt hozzájárul ugyanahhoz a konszenzushoz. Amikor egyetértenek, ez az egyetértés erős minőségi jelzés.
A MachineTranslation.com belső benchmarkjai alapján az egyes csúcskategóriás modellek 93-94 pontot érnek el a 100-ból a fordítás minőségét tekintve. A SMART konszenzusos kimenete eléri a 98.5/100-at. Forrás: MachineTranslation.com belső benchmarkjai és a WMT24 General Machine Translation Findings.
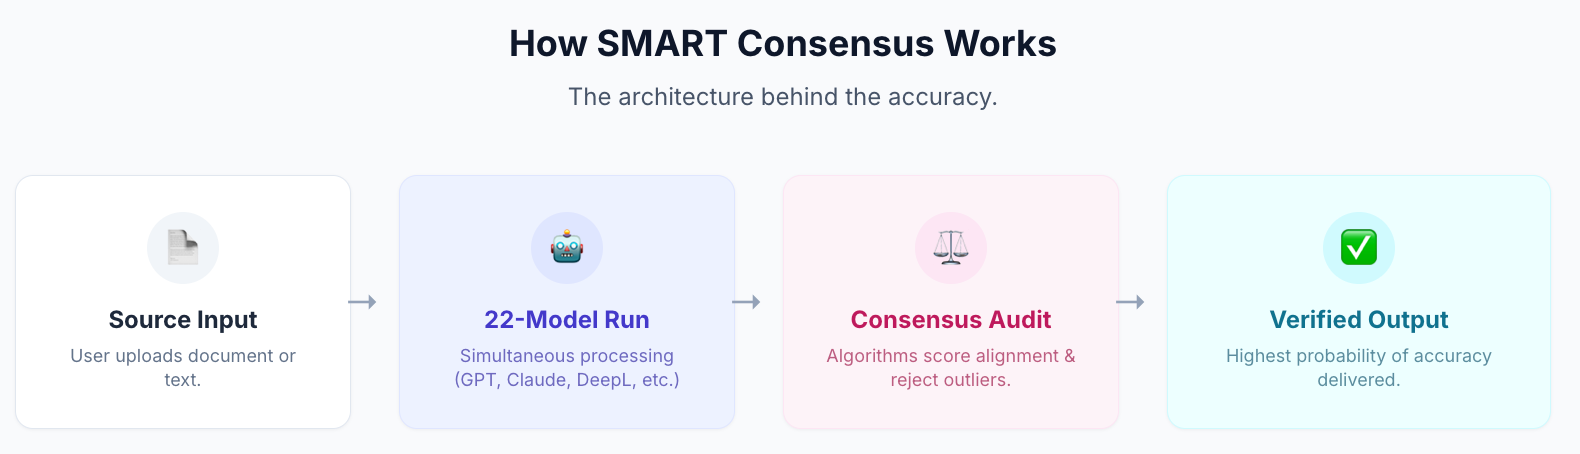
Azok a felhasználók, akik az egymotoros fordításról SMART-ra váltottak, 27%-kal kevesebb időt töltöttek a kimenetek ellenőrzésével és javításával. Forrás: MachineTranslation.com belső adatai.
Nagy kockázatú tartalmak (jogi dokumentumok, hatósági beadványok, orvosi utasítások) esetén a Human Verification a SMART konszenzust egy hitelesített szakmai lektorhoz eszkalálja ugyanazon a platformon belül. Nincs külső ügynökség. 100%-os pontosság garantált.
Fordítson a Grok, Claude és 20 másik modellel a MachineTranslation.com oldalon — ingyenes, regisztráció nem szükséges.
Gyakran ismételt kérdések
1. A Grok jobb a Claude-nál fordításra?
A legtöbb standard fordítási feladat esetében a Claude vezet a független benchmarkokon: első a 11-ből 9 nyelvpárban a WMT24-en, 78%-os „jó” értékelést kapott a Lokalise 2025-ös vaktesztjében, és 93.8/100-as eredményt ért el a MachineTranslation.com belső minőségi benchmarkjain. Grok specifikus előnye az aktuális események ismeretét igénylő tartalmaknál mutatkozik meg, valós idejű adathozzáférése ugyanis olyan kontextust biztosít számára, amellyel a statikusan tanított modellek – köztük a Claude – nem rendelkeznek. Friss hírek, új terminológia és időérzékeny tartalmak esetén a Grok az erősebb választás.
2. Mi a Grok előnye a Claude-dal szemben a fordításban?
A Grok integrálja az X-ről (korábban Twitter) származó valós idejű adatokat és az élő internetes keresést. A statikus adatkészleteken tanított Claude-dal és a legtöbb egyéb LLM-mel ellentétben a Grok képes hozzáférni a friss eseményekkel, az újonnan alkotott terminológiával és az aktuális kontextussal kapcsolatos információkhoz a fordítások generálásakor. Ez kifejezetten erősebbé teszi a hírtartalmak, a nemrég megjelent termékek és minden olyan anyag fordításában, ahol a jelentés az elmúlt néhány hét eseményeitől vagy nyelvi mintázataitól függ.
3. Mi a Claude előnye a Grok-kal szemben a fordítás terén?
A Claude előnye független szakmai értékelés révén dokumentált. A Claude 3.5 az első helyen végzett 11 nyelvpárból 9-ben a WMT24-en, és a Lokalise 2025-ös vaktesztjében a hivatásos fordítók 78%-os „jó” arányban preferálták a kimenetét — ami a legmagasabb az összes tesztelt LLM közül. A Claude szintén szerepel az Intento top 14 megoldása között több nyelvpárban az emberi LQA-értékelésben, míg a Grok nem. Hivatalos, professzionális és nagy téttel bíró fordítási feladatok esetén Claude független benchmark-pozíciója a dokumentált megkülönböztető tényező.
4. Melyik jobb jogi fordításra, a Grok vagy a Claude?
Független értékelések alapján a Claude az erősebb választás jogi fordításra. A Claude 3.5 az első helyen végzett a legtöbb nagy erőforrású európai nyelvpár esetében a WMT24-en, és a legmagasabb vaktesztes preferencia-értékeléseket kapta a hivatásos fordítóktól. Hitelesített pontosságot igénylő jogi tartalmak esetén egyik modell sem elegendő önmagában — a MachineTranslation.com Human Verification szolgáltatása 100%-os pontosságot biztosít egy hitelesített szakmai lektor révén, ugyanazon a platformon belül, külső szolgáltató bevonása nélkül.
5. Elérhető a Grok és a Claude is a MachineTranslation.com-on?
Igen. Mindkettő a MachineTranslation.com SMART rendszerének 22 modellje közé tartozik. Minden SMART fordítás egyidejűleg futtatja a Grok, Claude és 20 másik modellt, és azt a kimenetet adja vissza, amelyben a többség egyetért. Ahelyett, hogy választana közülük, az összes AI-modell konszenzusát kapja meg.
6. Hogyan hasonlítható össze a Grok és a Claude árazása?
A fogyasztói szinten a Claude Pro ára $20/month versus SuperGrok at $30/hónap. API szinten a Grok 4.1 valamivel olcsóbb a bemeneti tokeneknél ($2/M vs. $3/M a Claude Sonnet 4.6 esetében) és a kimenetieknél ($10/M vs. $15/M). A MachineTranslation.com ingyenes csomagja mindkét modellt tartalmazza a SMART 22 modelles konszenzusának részeként, regisztráció nem szükséges.
7. Melyik AI-modell a legjobb hírcikkek fordítására?
Hírcikkek fordításához a Grok strukturális előnnyel rendelkezik: valós idejű adatintegrációja azt jelenti, hogy rendelkezik a leírt események aktuális kontextusával, ami a statikusan tanított modellekből hiányozhat. Általános hírfordítás esetén, ahol a naprakészség nem kritikus, a Claude benchmark-teljesítménye erősebb. Nagy volumenű hírek fordításához, ahol a frissesség és a pontosság egyaránt számít, a MachineTranslation.com SMART mindkét modellt futtatja, és azok konszenzusos kimenetét adja vissza.