November 13, 2026
Qwen vs Gemini a fordításban, és miért számít az irány
Van két modellje és egy nyelvpárokból álló listája, és el kell döntenie, melyik modellre bízza a projektet. A legtöbb Qwen vs Gemini összehasonlítás egyetlen összesített pontszámmal válaszol. Úgy gondolom, egyetlen pontszám elfedi azt, ami eldönti az eredményt, vagyis a fordítás irányát.
A MachineTranslation.com oldalon futó modellek tesztelésén dolgozom, így össze tudom hasonlítani a Qwen és a Gemini teljesítményét 98 olyan nyelvpáron, amelyeket azonos szövegeken pontoztak. A Gemini ezek közül 68 párban ért el magasabb pontszámot, a Qwen pedig 29-ben, az átlagos különbség pedig 0,08 pont a 10-ből. Az összesített adatok önmagukban nem mutatják meg, melyik modellt érdemes választani urduról angolra vagy angolról haiti kreolra.
Ez a cikk bemutatja, hol áll egymáshoz közel a két modell, és hol vezet az egyik vagy a másik. Azt is elmondja, amit egyelőre még nem tudok közölni. Az adataim August 8, 2026 dátummal zárulnak, még azelőtt, hogy a Google bejelentette volna a Gemini 4 modellt októberben, így mindkét modell korábbi verzióit mutatja be.
Legfontosabb tanulságok
- Az azonos szövegen értékelt 98 nyelvpár tekintetében (July 12 to August 8, 2026) a Gemini 68 párban ért el magasabb pontszámot, a Qwen 29 párban, egy párban pedig döntetlen született.
- Az átlagos különbség csekély, 9,06 a Gemini esetében a Qwen 8,98 értékével szemben, és a 98 párból 60 esetében 0,1 ponton belül marad.
- Angolra történő fordításkor a Qwen több mint 0,1 ponttal vezet a 27 párból 7 esetében, a Gemini pedig 3-ban, a többi 17 pedig 0,1 ponton belül van.
- Angolról történő fordításkor a Gemini több mint 0,1 ponttal vezet a 29 párból 13 esetében, a Qwen pedig egyben sem.
- Az adatok azelőtt zárulnak, hogy a Google bejelentette volna a Gemini 4 modellt October 2026 során, így a korábbi Gemini verziókat írják le, és újabb futtatásra
A Qwen vagy a Gemini jobb fordításra?
Ez az iránytól függ, mivel a két modell közel áll egymáshoz, amikor a célnyelv az angol, a legtöbb egyéb nyelvpárban pedig a Gemini ér el magasabb pontszámot. Mind a 98 nyelvpárt figyelembe véve a Gemini 68-ban ért el magasabb pontszámot. A MachineTranslation.com 2026. július 12. és augusztus 8. közötti pontszámai alapján a Gemini átlagosan 9,06 pontot ért el a 10-ből, a Qwen pedig 8,98-at, ami átlagosan 0,08 pontos különbséget jelent.
A panel csak azokat a szegmenseket veszi figyelembe, ahol a ChatGPT, Claude, DeepSeek, Gemini és Qwen mindegyike valós pontszámot kapott, így minden modell azonos forrásszöveg alapján kerül megítélésre. Minden nyelvpárhoz legalább 30 szegmens tartozik. Azért használom ezt a panelt, mert kiküszöböl egy gyakori hibát, mégpedig a modellek eltérő szövegek alapján történő összehasonlítását.
A darabszám alapján a Gemini 68 párban vezet (69%), a Qwen 29 párban (30%), egy pár esetében pedig döntetlen az állás. A darabszám önmagában eltúlozza a különbséget, mivel a 98 párból 60 esetében 0,1 ponton belül van az eltérés. A következő szakaszok irány és különbség szerint bontják le az eredményeket.
Mely fordítási irányok kedveznek az egyes modelleknek?
A Gemini vezet, amikor az angol a forrásnyelv, vagy amikor egyik nyelv sem az angol, a Qwen pedig egy szinten van vele vagy megelőzi, amikor az angol a célnyelv. Angolból fordítva a Gemini több mint 0,1 ponttal vezet a 29 párból 13-ban, a Qwen pedig egyben sem. Angolra fordítva a Qwen ekkora különbséggel vezet a 27 párból 7-ben, a Gemini pedig 3-ban.
| Irány | Nyelvpárok | A Gemini több mint 0,1 ponttal vezet | 0,1 ponton belül | A Qwen több mint 0,1 ponttal vezet | Átlagos különbség |
|---|---|---|---|---|---|
| Angolra | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Angolról | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Egyik nyelv sem angol | 42 | 14 | 27 | 1 | Gemini +0,13 |
Az angolra irányuló fordításoknál 27 párból 17 van 0,1 ponton belül, a Qwen 7 esetben vezet, a Gemini pedig 3 esetben. Az angolról indulóknál 29 párból 16 van 0,1 ponton belül, a Gemini 13 esetben vezet, a Qwen pedig egyben sem. Ahol egyik nyelv sem angol, ott 42-ből 27 van 0,1 ponton belül, a Gemini 14 esetben vezet, a Qwen pedig 1 esetben.
A Qwen 0,1 ponton belül van a Geminihez képest, vagy vezet a 27 angolra irányuló nyelvpárból 24-nél. Irányonként átlagolva a Qwen mintegy 0,04 ponttal vezet az angolra irányuló fordításoknál, míg a Gemini körülbelül 0,16 ponttal vezet az angolról indulóknál, és 0,13 ponttal a két nem angol nyelv között.
Nem tudom, miért alakul ki ez a különbség, és ezek az adatok nem adnak rá választ. Az egyik magyarázat, amelyet először tesztelnék, az egyes modellek mögött álló tanító szövegek összetétele, de ezt a vizsgálatot nem végeztem el. A Qwen hasonló mintázatot mutat a ChatGPT-vel szemben is. Ugyanezen a tesztcsoporton a Qwen vs ChatGPT összehasonlításunk azt találta, hogy a kettő közel azonos szinten áll az angolra irányuló fordításoknál, míg a többi pár 89%-ában a ChatGPT vezet.
Mely nyelvpároknál mutatkoznak a legnagyobb különbségek?
A legnagyobb különbségek a Gemini javára szólnak. 0,51 és 0,95 pont közötti előnnyel vezet az oroszról kazahra, az angolról haiti kreolra, az angolról tagalogra, a spanyolról görögre és az arabról perzsára történő fordításoknál. A Qwen legnagyobb előnyei kisebbek, 0,15 és 0,26 pont közöttiek, és az öt legjobb eredményéből négy angolra irányuló nyelvpár.
| Nyelvpár | Gemini pontszám | Qwen pontszám | Különbség |
|---|---|---|---|
| Oroszról kazahra | 9,27 | 8,32 | Gemini +0,95 |
| Angolról haiti kreolra | 9,19 | 8,27 | Gemini +0,92 |
| Angolról tagalogra | 9,14 | 8,43 | Gemini +0,70 |
| Spanyolról görögre | 8,90 | 8,33 | Gemini +0,57 |
| Arabról perzsára | 8,84 | 8,34 | Gemini +0,51 |
| Urduról angolra | 8,56 | 8,81 | Qwen +0,26 |
| Kínairól angolra | 9,00 | 9,19 | Qwen +0,19 |
| Svédről angolra | 8,29 | 8,46 | Qwen +0,16 |
| Kínairól indonézre | 9,03 | 9,19 | Qwen +0,16 |
| Burmairól angolra | 8,94 | 9,09 | Qwen +0,15 |
Ezeket nem tekinteném végleges rangsornak. A két legnagyobb különbség, az oroszról kazahra és az angolról haiti kreolra, a medián párnál kisebb mintákon alapul. Az angolról tagalogra, a spanyolról görögre és az arabról perzsára nagyobbakon alapul, így ebben a háromban jobban bíznék. Újratesztelném a két kis mintás különbséget, mielőtt támaszkodnék rájuk.
Mit jelent a 0,1 pontos különbség?
Véleményem szerint a 0,1 pont alatti különbség túl kicsi ahhoz, hogy győztest lehessen hirdetni. A 98 párból 60 ebbe a sávba esik, és mindegyik pár értékelése korlátozott számú szegmensen alapul. A 0,1-es határ a saját munkaküszöböm, és nem végeztem szignifikanciavizsgálatot ezeken a párokon.
Egy pontszám bizonyos különbségeket is figyelmen kívül hagy. A gyakori kifejezésekre irányuló tesztjeinkben a „sorry” szót arabul 22 MI-modellen futtattuk át. A Gemini és a Qwen egyaránt a kötetlenebb آسف változatot választotta. A ChatGPT és az összetett eredmény a formális عذرًا alakot választotta. Minden modell 9,5 pontot kapott, így a két szó stílusrétegében eltér, a pontszám mégsem mozdult el.
Ezért értelmezem a különbséget és a stílusrétegbeli példákat együtt. Egy látható stílusbeli eltéréssel párosuló kis különbség emberi döntést igényel. Egy szűk mintán alapuló nagy különbség újratesztelést igényel.
Különböző típusú hibákat követ el a Qwen és a Gemini?
Igen, mert a 2026-os világbajnoki idézeteket vizsgáló tesztünkben mindkét modell hozott legalább egy olyan döntést, amelyet a többi modell nem, és a pontszámok alig mozdultak el. A Gemini Mbappé egyik kifejezését úgy fordította, hogy „with each game”, és Wirtz egy idézetét szó szerint adta vissza, míg a Qwen Scaloni egy idézetének más értelmezését adta. A pontszámok ezekben az esetekben 9,2 és 9,5 között alakultak.
A részletek a világbajnoki idézeteket vizsgáló tesztünkből származnak. Mbappé előretekintéssel kapcsolatos idézeténél a többi modell megtartotta a „match” szót, míg a Gemini a „with each game” kifejezést írta, ami egy apró stílusbeli elcsúszás, és 9,4 pontot kapott. Wirtz egy idézeténél a Gemini szó szerint fordított le egy kifejezést, megváltoztatva annak jelentését, szintén 9,4 ponttal. Scaloni idézeténél a legtöbb modell egyetlen értelmezés felé hajlott, míg a Qwen azt írta, hogy „that is what matters”, és 9,4 pontot kapott. Mbappé taktikai témájú idézeténél a Claude és a DeepSeek a brit labdarúgó-angolt választotta, míg a Gemini, a Qwen és a többiek az amerikai angolt, és a Qwen 9,2 pontot kapott, alacsonyabbat, mint a többiek.
Ezeket apró szokásoknak tekintem. A Gemini példái a stílusrétegről és a szó szerinti megfogalmazásról szólnak. A Qwen példái arról szólnak, hogy egy mondat melyik értelmezését válassza. Négy példa túl kevés ahhoz, hogy mintázatnak tekintsük, de megmutatják, milyen jellegű különbségeket rejt el egyetlen pontszám.
Melyik Qwen modell a legjobb a fordításra?
Az adatainkból ezt nem tudom megmondani, mivel a MachineTranslation.com pontszámai a Qwent egyetlen modellként kezelik, verziócímke nélkül. Az Alibaba Qwen3.8 családja 2026 augusztusában jelent meg a Hugging Face felületén, így jelenleg már több verzió is létezik, és a jelen cikkben szereplő pontszámok nem választják szét őket.
Szeretném ezt verziók szerint bontani, de még nem áll módomban. A platformszintű szám több olyan Qwen verzió átlagát is tartalmazhatja, amely az adott időszakban futott. Ha egy projekthez a Qwen verziói közül választ, érdemes összehasonlítani őket a saját szövegeinek egy mintáján.
Milyen alternatívái vannak a Gemininek a fordítás terén?
A ChatGPT, a Claude, a DeepSeek, a Qwen, a Grok és a Mistral AI mind elérhető a MachineTranslation.com felületén, és a megfelelő alternatíva az adott nyelvpártól függ. A 2026. július 12. és augusztus 8. közötti pontszámaink alapján a Qwen 0,1 ponton belül van a Geminihez képest, vagy vezet a 27 angolra fordító párból 24 esetében. A francia Mistral AI pontszámaink azt mutatják, hogy a franciáról angolra számított átlaga 0,40 ponttal áll a Geminié felett.
Ha az Ön által választott alternatíva a ChatGPT, a válasz szintén nyelvpáronként változik. A közzétett, spanyolról angolra vonatkozó részletezésünkben a Gemini a szegmensek 31%-át nyerte meg, míg a ChatGPT 21%-ot ért el. A francia esetében egyik modell sem győz mindkét irányban. Mivel a választás a nyelvpártól függően változik, a MachineTranslation.com nem egyetlen alternatíva mellett dönt. Egymással párhuzamosan futtatja őket.
A javaslatom az, hogy induljon ki a nyelvpárból és az irányból, majd nézze meg, melyik alternatíva illik hozzá.
Hogyan mutatja meg a MachineTranslation.com, hogy hol tér el egymástól a Qwen és a Gemini?
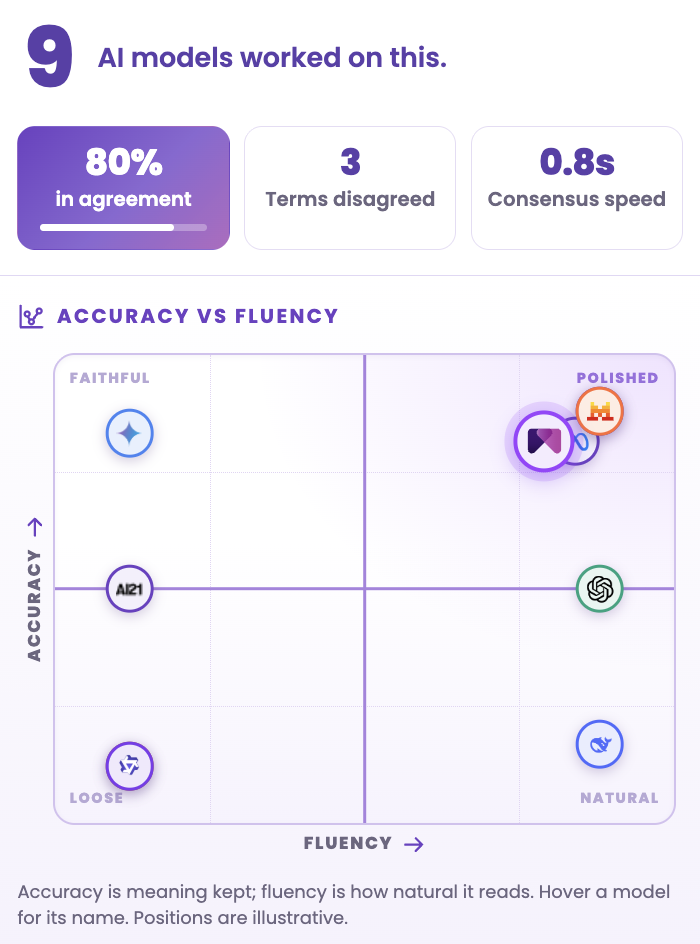
A MachineTranslation.com mindkét modellt futtatja minden fordításnál, és megmutatja, hol értenek egyet a modellek, és hol térnek el. Az egyetértési panel beszámol arról, hogy hány AI-modell dolgozott a szövegen, mekkora az egyetértés aránya, hány kifejezés volt vitatott, és milyen gyorsan alakult ki a konszenzus.
Mennyire naprakészek ezek az eredmények?
Ezek az eredmények a 2026. július 12. és augusztus 8. közötti időszakra vonatkoznak, így az akkor futó Gemini és Qwen verziókat írják le. A Google bejelentette a Gemini 4 modellt 2026 októberében. Az Alibaba Qwen3.8 termékcsaládja 2026 augusztusában jelent meg. Azt javaslom, hogy futtassa le újra a panelt, mielőtt egy új projektnél ezekre a számokra támaszkodna.
Arra számítok, hogy az azonos szövegek összehasonlításának módszere a zajra hagyott ráhagyással továbbra is megállja a helyét. Arra számítok, hogy a különbségek mértéke változni fog. Bármely olyan párt, ahol az éllovas egy új futtatás során megfordul, annak jeleként kezelnék, hogy a korábbi különbség a zajon belül volt.
Hogyan választanék a Qwen és a Gemini között egy projekthez?
Az én álláspontom az, hogy nyelvpár és irány alapján válasszunk, és kerüljük el, hogy egyetlen döntést hozzunk egy egész projektre. A gyakorlatban ez azt jelenti, hogy a 0,1 pont alatti különbséget döntetlennek tekintjük, és számítunk arra, hogy a vezető modell páronként változik. Én a következő sorrendet követném.
- Sorolja fel a projektben szereplő összes nyelvpárt, és jelölje meg az irányukat.
- Check the gap for each pair in this article. Treat a gap under 0,1 points as a tie.
- Ahol a különbség nagyobb, kezdje a vezető modellel, és teszteljen egy mintát a saját szövegéből.
- Ha a tartalma mindkét irányban mozog, számítson arra, hogy a vezető modell páronként változni fog.
- Ellenőrizze újra, amikor valamelyik modell új verziót ad ki.
Mindkét modell 20 másik mellett fut minden fordításnál a MachineTranslation.com oldalon. A rendszer azt a verziót adja vissza, amelyben a legtöbbjük egyetért, így a döntést nem kell egyszerre meghozni a teljes projektre vonatkozóan. A modelleredmények teljes készlete a modellösszehasonlító tesztünkben található.
Gyakran ismételt kérdések
1. A Qwen vagy a Gemini jobb fordításra?
Ez az iránytól függ, mert 27 angol irányú párból 24-ben a Qwen 0,1 ponton belül van a Geminihez képest, vagy vezet. A Gemini továbbra is magasabb pontszámot ért el 98 párból 68-ban a MachineTranslation.com 2026. július 12. és augusztus 8. közötti pontszámaiban. Az átlagos különbség 0,08 pont a 10-ből, így én nyelvpáronként választanék.
2. Melyik Qwen modell a legjobb fordításra?
Az adataink alapján ezt nem tudom megmondani, mivel a MachineTranslation.com pontszámai a Qwent egyetlen modellként kezelik, verziócímke nélkül. Az Alibaba Qwen3.8 családja 2026 augusztusában érkezett a Hugging Face platformra, így ma már több verzió is létezik. Amíg a pontszámok nem különítik el őket, azt javaslom, hogy hasonlítsa össze a verziókat a saját szövege egy mintáján, mielőtt kiválasztana egyet a projekthez.
3. Milyen alternatívái vannak a Gemininek fordításra?
A ChatGPT, a Claude, a DeepSeek, a Qwen, a Grok és a Mistral AI mind fut a MachineTranslation.com oldalon. A 2026. július 12. és augusztus 8. közötti pontszámainkban a Qwen 27 angol irányú párból 24-ben 0,1 ponton belül van a Geminihez képest, vagy vezet. A Mistral AI franciáról angolra mért átlaga 0,40 ponttal volt a Geminié felett. A megfelelő alternatíva a pártól függ.
4. Jobb a Gemini a ChatGPT-nél fordításra?
Ez a nyelvpártól függ, mivel egyetlen mesterséges intelligencia modell sem győz mindenhol. A közzétett, spanyolról angolra vonatkozó részletezésünkben a Gemini a szegmensek 31%-át nyerte meg, míg a ChatGPT 21%-át. A francia esetében egyik modell sem nyer mindkét irányban. Azt javaslom, ellenőrizze a szükséges párt és irányt, mielőtt választana közülük.
5. Pontos a Gemini fordításra?
Igen, mivel a Gemini a MachineTranslation.com July 12 to August 8, 2026 pontszámai alapján 98 nyelvpáron a 10 pontból átlagosan 9,06 pontot ért el. A pontosság azonban nyelvpáronként változik. Előnye az angol forrásnyelv esetében a legnagyobb, és a Qwen több mint 0,1 ponttal jár előtte a 27 angolra irányuló párból 7 esetében.