October 2, 2026
Qwen vs Grok: Melyik AI modell fordít jobban?
A Qwen és a Grok egyaránt általános célú AI modellek, nem pedig kifejezetten fordításra kifejlesztett eszközök, és mindkettő része annak a modellkészletnek, amelyet a MachineTranslation.com minden fordítás során futtat. Ez fontos annak megértéséhez, ami ezután következik. Ez egy áttekintés arról, hogy a platform két saját modellje hogyan teljesít egymással szemben, az ilyen típusú adatokkal járó valós fenntartásokkal együtt, és nem pedig egy verseny két külső kihívó és maga a platform között.
Mi a Qwen és a Grok?
Qwen az Alibaba nagy nyelvi modelljeinek családja, amely jelenleg a Qwen3.8-as generációnál tart, és a platform folyamatos bővítésének részeként került be a MachineTranslation.com modellkészletébe. Grok az xAI modellcsaládja, amely a cikk írásakor jelenleg a Grok 4.7-es verziónál tart, számos kiadáson esett át a cikkben eredetileg összehasonlított verzió óta, és külön csatlakozott a platformhoz. Egyik modellt sem kifejezetten fordításra építették. Mindkettő általános célú rendszer, amelyek szélesebb körű nyelvi képességeik részeként történetesen számos nyelvet kezelnek, ami egy eltérő kiindulópont, mint egy olyan platform esetében, amelyet kifejezetten a fordítási minőségre építettek és teszteltek.
Hogyan viszonyul egymáshoz a Qwen és a Grok a MachineTranslation.com saját adatai alapján?
A platform forgalmának elmúlt 28 napja során a Grok átlagosan magasabb pontszámot ért el, mint a Qwen: 10-ből 9.26-ot a 8.87-tel szemben. A Grok legrosszabbul teljesítő 10%-nyi fordítása még mindig 9.2-es átlagot hozott, míg a Qwen legrosszabb 10%-a 7.6-ra esett vissza, ami az alsó tartományban nagyobb különbséget jelent, mint amit pusztán az átlag sugall.
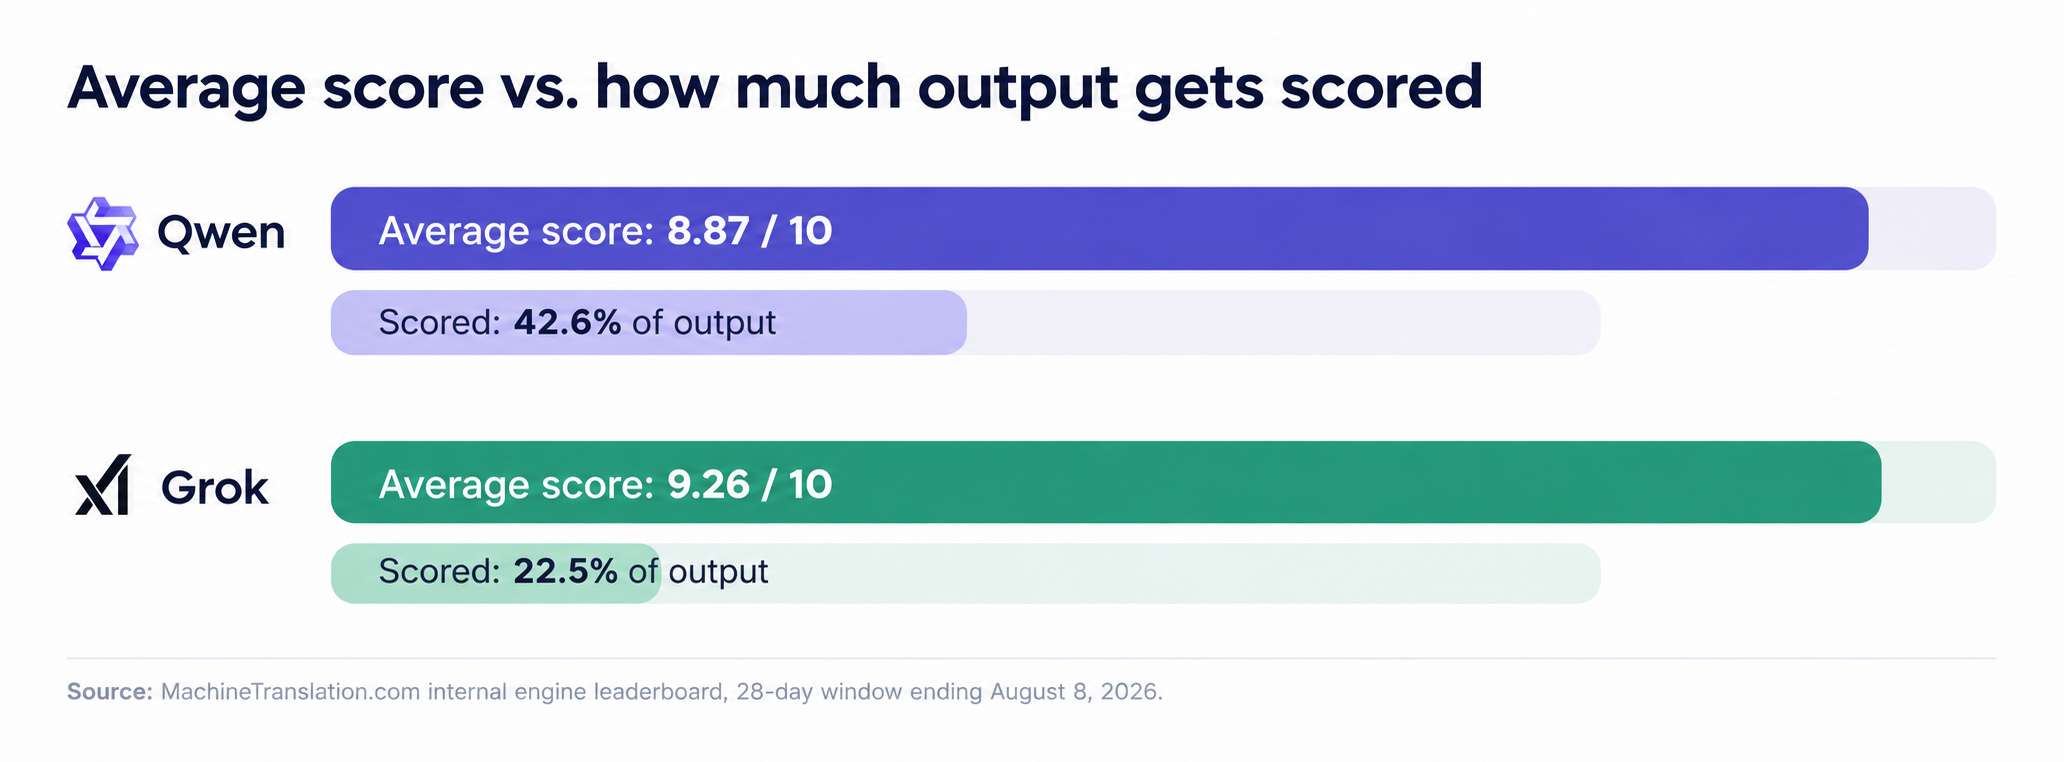
A Grok átlagos pontszáma magasabb, de ez a kimenete kevesebb mint egynegyedének pontozásán alapul, szemben a Qwen közel felével. A két oszlop ugyanannak a történetnek a különböző részeit meséli el.
| Qwen | Grok | |
|---|---|---|
| A pontozott kimenet százaléka | 42.6% | 22.5% |
| Átlagos pontszám | 8.87 / 10 | 9.26 / 10 |
| A pontszámok alsó 10%-a | 7.6 | 9.2 |
Forrás: A MachineTranslation.com belső motorranglistája, a 2026. augusztus 8-án végződő 28 napos időszak.
A Grok magasabb pontszáma azt jelenti, hogy jobb választás?
Önmagában nem. A Grok-ot sokkal ritkábban használják a platformon, mint a Qwen-t, és a fordításainak kevesebb mint negyedét pontozzák egyáltalán, szemben a Qwen közel felével. Egy kisebb, kevésbé reprezentatív minta miatt az átlag jobbnak vagy rosszabbnak tűnhet, mint amilyen a Qwen által tapasztalt azonos volumen esetén lenne. A MachineTranslation.com ezen adatokra vonatkozó saját jelentése a pontozási lefedettséget valós korlátként, és nem csupán lábjegyzetként kezeli: egy olyan motort, amelyet a forgalmának csak egy szűk szeletén pontoztak, nem teszteltek olyan alaposan, mint azt, amelyet a kimenetének közel felén.
A valós helyzet az, hogy a Grok számai ígéretesek, de kevesebb adaton alapulnak. A Qwen számai átlagosan alacsonyabbak, de sokkal nagyobb, reprezentatívabb alapon nyugszanak. Egyik tény sem érvényteleníti a másikat.
Mi a helyzet a nyelvi lefedettséggel?
Sem a Qwen, sem a Grok nem tesz közzé ellenőrzött listát azokról a nyelvpárokról, amelyeknél a teljesítmény visszaesik, és nem létezik független tesztelés sem ennek megerősítésére. Amit biztosan el lehet mondani, hogy egyik modellt sem egy adott nyelvi készletre vonatkozó fordítási minőség köré építették, ellentétben egy dedikált fordítási platformmal. A MachineTranslation.com közvetlenül több mint 270 nyelvet tesztel és támogat, ami teljesen más kategória, mint egy általános célú modell széleskörű, de teszteletlen többnyelvű képessége.
Hogyan használja ténylegesen a MachineTranslation.com a Qwen-t és a Grok-ot
A MachineTranslation.com a Qwen-t, a Grok-ot és több mint 20 másik AI modellt futtat minden fordításon, majd azt a verziót jeleníti meg, amelyben ezek a modellek a leginkább egyetértenek. Egyik modell sincs kizárva egy átlagosan alacsonyabb pontszám miatt. Több modell egyidejű futtatása azt jelenti, hogy észre lehet venni azokat az eseteket, amikor egy átlagosan alacsonyabb pontszámú modell mégis helyesen fordít le egy adott mondatot, amelyet egy magasabb pontszámú modell elhibáz. A Qwen teljesítménye fordítási irányok és nyelvpárok szerint is megoszlik, amit érdemes megismerni egyetlen modell kiválasztása előtt; ezt a MachineTranslation.com Qwen vs DeepSeek összehasonlítása részletesebben is tárgyalja. Ha közelebbről is meg szeretné vizsgálni, hogyan tesztelik a modelleket közvetlenül egymással szemben, tekintse meg a MachineTranslation.com teljes modell-összehasonlító tesztelését.
Gyakran ismételt kérdések
1. A Qwen vagy a Grok jobb a fordításhoz?
A MachineTranslation.com saját 28 napos motoradatai alapján a Grok átlagosan magasabb pontszámot ér el, mint a Qwen: 10-ből 9,26-ot a 8,87-tel szemben. A Grok azonban a kimenetének egy sokkal kisebb, kevésbé reprezentatív szeletén kap pontozást, így ez nem egy tiszta, fej-fej melletti küzdelem, mint amilyen egy azonos szegmenseken végzett teszt lenne.
2. Miért van a Groknak magasabb átlagpontszáma, de kevesebb pontozott fordítása?
A Grok modellt ritkábban használják a platformon, és a kimenetének csak mintegy 22,5%-a kap pontozást, szemben a Qwen 42,6%-ával. Egy kisebb, kevésbé reprezentatív minta felfújhatja vagy alulértékelheti az átlagot, ezért ezt az összehasonlítást iránymutatónak, nem pedig döntő érvényűnek kell tekinteni.
3. A Qwen vagy a Grok támogat több nyelvet?
Mindkettő általános célú AI modell, közzétett, ellenőrzött nyelvi korlátozások listája nélkül. Egyiket sem kifejezetten fordításra építették, ami eltér egy olyan platformtól, amely több mint 270 nyelven közvetlenül teszteli és pontozza a fordítás minőségét, ahelyett, hogy a mért fordítási teljesítmény helyettesítőjeként a széles körű többnyelvű képzésre támaszkodna.
4. A MachineTranslation.com versenyez a Qwennel és a Grokkal?
Nem. A MachineTranslation.com a Qwen, a Grok és több mint 20 másik AI modellt futtat le minden egyes fordításnál, és azt a verziót emeli ki, amelyben ezek a modellek a leginkább megegyeznek. Teszteli és kombinálja az ilyen modelleket, ahelyett, hogy saját, különálló modellként versenyezne velük.
5. Melyik AI modellt ajánlja a MachineTranslation.com fordításhoz?
Alapértelmezés szerint egyiket sem. A különböző modellek nyelvpáronként és tartalomtípusonként eltérően teljesítenek, és a köztük lévő különbség a fordítandó szövegtől függően bármilyen irányba eltolódhat. Pontosan ez a változatosság az oka annak, hogy a platform minden egyes fordításnál több modellt futtat le, ahelyett, hogy egyet választana állandó ajánlásként.