October 2, 2026
Qwen ទល់នឹង Grok៖ តើម៉ូដែល AI មួយណាបកប្រែបានល្អជាង?
Qwen និង Grok សុទ្ធតែជាម៉ូដែល AI សម្រាប់គោលបំណងទូទៅ មិនមែនជាឧបករណ៍បកប្រែជាក់លាក់នោះទេ ហើយម៉ូដែលទាំងពីរនេះគឺជាផ្នែកមួយនៃបណ្តុំម៉ូដែលដែល MachineTranslation.com ដំណើរការសម្រាប់រាល់ការបកប្រែ។ ចំណុចនេះមានសារៈសំខាន់សម្រាប់របៀបយល់ដឹងពីអ្វីដែលនឹងមាននៅខាងក្រោម។ នេះគឺជាការក្រឡេកមើលថាតើម៉ូដែលផ្ទាល់របស់វេទិកាទាំងពីរដំណើរការប្រៀបធៀបគ្នាដោយរបៀបណា ជាមួយនឹងការកត់សម្គាល់ជាក់លាក់ដែលពាក់ព័ន្ធនឹងទិន្នន័យប្រភេទនេះ មិនមែនជាការប្រកួតប្រជែងរវាងភាគីខាងក្រៅទាំងពីរ និងវេទិកាខ្លួនឯងនោះទេ។
តើ Qwen និង Grok ជាអ្វី?
Qwen គឺជាក្រុមម៉ូដែលភាសាខ្នាតធំរបស់ Alibaba ដែលបច្ចុប្បន្នស្ថិតក្នុងជំនាន់ Qwen3.8 របស់ខ្លួន ហើយត្រូវបានបន្ថែមទៅក្នុងបណ្តុំម៉ូដែលរបស់ MachineTranslation.com ជាផ្នែកមួយនៃការពង្រីកជាបន្តបន្ទាប់របស់វេទិកានេះ។ Grok គឺជាស៊េរីម៉ូដែលរបស់ xAI ដែលបច្ចុប្បន្នស្ថិតនៅលើកំណែ Grok 4.7 គិតត្រឹមពេលសរសេរអត្ថបទនេះ ដោយបានឆ្លងកាត់ការចេញផ្សាយជាច្រើនចាប់តាំងពីកំណែដែលអត្ថបទនេះបានប្រៀបធៀបដំបូង និងបានចូលរួមជាមួយវេទិកានេះដោយឡែកពីគ្នា។ គ្មានម៉ូដែលណាមួយត្រូវបានបង្កើតឡើងយ៉ាងជាក់លាក់សម្រាប់ការបកប្រែនោះទេ។ ទាំងពីរគឺជាប្រព័ន្ធសម្រាប់គោលបំណងទូទៅដែលអាចដោះស្រាយភាសាជាច្រើនជាផ្នែកមួយនៃសមត្ថភាពភាសាដ៏ទូលំទូលាយរបស់ខ្លួន ដែលនេះគឺជាចំណុចចាប់ផ្តើមខុសគ្នាពីវេទិកាដែលត្រូវបានបង្កើត និងធ្វើតេស្តផ្តោតលើគុណភាពនៃការបកប្រែជាក់លាក់។
តើ Qwen និង Grok ប្រៀបធៀបគ្នាដូចម្តេចនៅលើទិន្នន័យផ្ទាល់របស់ MachineTranslation.com?
ក្នុងរយៈពេល 28 ថ្ងៃចុងក្រោយនៃទិន្នន័យចរាចរណ៍របស់វេទិកា Grok ទទួលបានពិន្ទុមធ្យមខ្ពស់ជាង Qwen៖ 9.26 លើ 10 ធៀបនឹង 8.87។ 10% នៃការបកប្រែដែលទទួលបានពិន្ទុទាបបំផុតរបស់ Grok នៅតែមានកម្រិតមធ្យម 9.2 ស្របពេលដែល 10% នៃការបកប្រែដែលទទួលបានពិន្ទុទាបបំផុតរបស់ Qwen បានធ្លាក់ចុះដល់ 7.6 ដែលបង្ហាញពីគម្លាតកាន់តែធំនៅកម្រិតទាប ជាងអ្វីដែលមធ្យមភាគតែមួយបានបង្ហាញ។
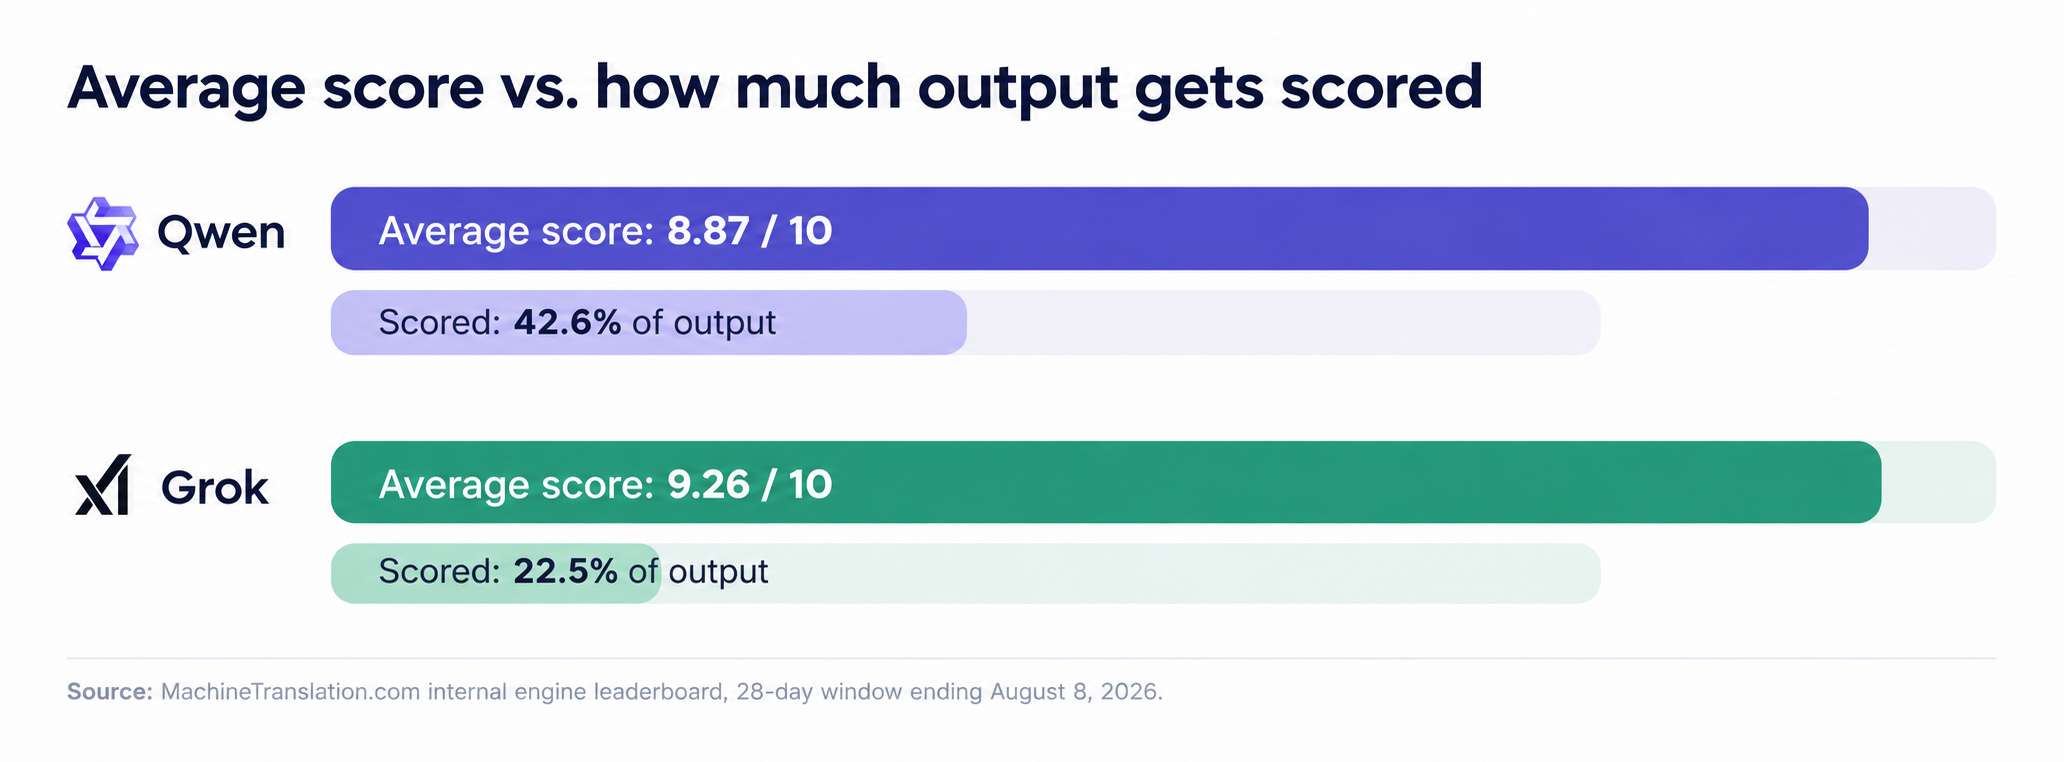
ពិន្ទុមធ្យមរបស់ Grok គឺខ្ពស់ជាង ប៉ុន្តែវាត្រូវបានផ្អែកលើការដាក់ពិន្ទុតិចជាងមួយភាគបួននៃទិន្នផលរបស់វា ធៀបនឹងជិតពាក់កណ្តាលសម្រាប់ Qwen។ របារទាំងពីរនេះប្រាប់ពីផ្នែកផ្សេងគ្នានៃសាច់រឿងតែមួយ។
| Qwen | Grok | |
|---|---|---|
| ភាគរយនៃទិន្នផលដែលបានដាក់ពិន្ទុ | 42.6% | 22.5% |
| ពិន្ទុមធ្យម | 8.87 / 10 | 9.26 / 10 |
| ពិន្ទុ 10% ទាបបំផុត | 7.6 | 9.2 |
ប្រភព៖ តារាងចំណាត់ថ្នាក់ម៉ាស៊ីនផ្ទៃក្នុងរបស់ MachineTranslation.com សម្រាប់រយៈពេល 28 ថ្ងៃ ដែលបញ្ចប់នៅថ្ងៃទី 8 ខែសីហា ឆ្នាំ 2026។
តើពិន្ទុខ្ពស់របស់ Grok មានន័យថាវាជាជម្រើសដ៏ល្អជាងមែនទេ?
មិនមែនដោយសារតែបែបនេះទាំងស្រុងនោះទេ។ Grok ត្រូវបានប្រើប្រាស់តិចជាង Qwen យ៉ាងខ្លាំងនៅលើផ្លែតហ្វមនេះ ហើយមានតិចជាងមួយភាគបួននៃការបកប្រែរបស់វាប៉ុណ្ណោះដែលទទួលបានការដាក់ពិន្ទុ បើធៀបទៅនឹងការបកប្រែជិតពាក់កណ្តាលរបស់ Qwen។ សំណាកគំរូដែលតូចជាង និងមិនសូវតំណាងឲ្យទិន្នន័យរួម អាចធ្វើឱ្យមធ្យមភាគមើលទៅល្អជាង ឬអាក្រក់ជាងអ្វីដែលវាអាចនឹងមាន ធៀបនឹងបរិមាណដូចគ្នាដែល Qwen ជួបប្រទះ។ ការរាយការណ៍ផ្ទាល់របស់ MachineTranslation.com លើទិន្នន័យនេះ ចាត់ទុកវិសាលភាពនៃការដាក់ពិន្ទុជាដែនកំណត់ពិតប្រាកដ មិនមែនគ្រាន់តែជាចំណាំនោះទេ៖ ម៉ាស៊ីនដែលទទួលបានការដាក់ពិន្ទុលើផ្នែកតូចមួយនៃចរាចរណ៍ទិន្នន័យរបស់វា មិនទាន់ត្រូវបានធ្វើតេស្តយ៉ាងហ្មត់ចត់ដូចម៉ាស៊ីនដែលទទួលបានការដាក់ពិន្ទុលើទិន្នផលជិតពាក់កណ្តាលរបស់វានោះទេ។
ការយល់ឃើញដោយស្មោះត្រង់គឺថា តួលេខរបស់ Grok ហាក់មានសង្ឃឹមខ្ពស់ ប៉ុន្តែមានទិន្នន័យតិចតួច។ តួលេខរបស់ Qwen មានកម្រិតមធ្យមទាបជាង ប៉ុន្តែផ្អែកលើមូលដ្ឋានទិន្នន័យធំជាង និងតំណាងឱ្យទិន្នន័យរួមបានល្អជាង។ ការពិតទាំងពីរនេះមិនអាចលុបបំបាត់គ្នាទៅវិញទៅមកបានទេ។
ចុះចំណែកឯវិសាលភាពនៃភាសាវិញយ៉ាងម៉េចដែរ?
ទាំង Qwen និង Grok មិនបានបោះពុម្ពផ្សាយបញ្ជីគូភាសាដែលបានផ្ទៀងផ្ទាត់ ដែលបង្ហាញពីការធ្លាក់ចុះនៃដំណើរការបកប្រែនោះទេ ហើយក៏គ្មានការធ្វើតេស្តឯករាជ្យណាមួយ ដើម្បីបញ្ជាក់ពីបញ្ហានេះដែរ។ អ្វីដែលអាចនិយាយបានដោយទំនុកចិត្តនោះគឺថា ម៉ូដែលទាំងពីរមិនត្រូវបានបង្កើតឡើងដោយផ្តោតលើគុណភាពនៃការបកប្រែឆ្លងកាត់សំណុំភាសាជាក់លាក់ណាមួយ ដូចទៅនឹងផ្លែតហ្វមបកប្រែជំនាញនោះទេ។ MachineTranslation.com ធ្វើតេស្ត និងគាំទ្រដោយផ្ទាល់នូវភាសាជាង 270 ដែលនេះជាការអះអាងមួយប្រភេទផ្សេងពីសមត្ថភាពពហុភាសាដ៏ទូលំទូលាយប៉ុន្តែមិនទាន់បានធ្វើតេស្តរបស់ម៉ូដែលប្រើប្រាស់ទូទៅ។
របៀបដែល MachineTranslation.com ប្រើប្រាស់ Qwen និង Grok ជាក់ស្តែង
MachineTranslation.com ដំណើរការម៉ូដែល Qwen, Grok និងម៉ូដែល AI ជាង 20 ផ្សេងទៀតលើរាល់ការបកប្រែ បន្ទាប់មកបង្ហាញទម្រង់បកប្រែដែលម៉ូដែលទាំងនោះយល់ស្របគ្នាបំផុត។ គ្មានម៉ូដែលណាមួយត្រូវបានដកចេញដោយសារតែការទទួលបានពិន្ទុមធ្យមទាបនោះទេ។ ការដំណើរការម៉ូដែលជាច្រើនក្នុងពេលតែមួយ មានន័យថាជាការចាប់យកករណីដែលម៉ូដែលទទួលបានពិន្ទុមធ្យមទាបនៅតែអាចបកប្រែប្រយោគជាក់លាក់ណាមួយបានត្រឹមត្រូវ ខណៈដែលម៉ូដែលទទួលបានពិន្ទុខ្ពស់បែរជាបកប្រែខុស។ ដំណើរការរបស់ Qwen ក៏បែងចែកតាមទិសដៅ និងការផ្គូផ្គងភាសាក្នុងទម្រង់ដែលគួរដឹងមុននឹងជ្រើសរើសម៉ូដែលតែមួយ ដែលមានរៀបរាប់លម្អិតបន្ថែមនៅក្នុងការប្រៀបធៀបរវាង Qwen និង DeepSeek របស់ MachineTranslation.com។ ដើម្បីពិនិត្យមើលឱ្យកាន់តែច្បាស់អំពីរបៀបដែលម៉ូដែលនីមួយៗត្រូវបានធ្វើតេស្តប្រៀបធៀបគ្នាដោយផ្ទាល់ សូមមើលការធ្វើតេស្តប្រៀបធៀបម៉ូដែលពេញលេញរបស់ MachineTranslation.com។
សំណួរដែលសួរញឹកញាប់
1. តើ Qwen ឬ Grok មួយណាល្អជាងសម្រាប់ការបកប្រែ?
យោងតាមទិន្នន័យម៉ាស៊ីនរយៈពេល 28 ថ្ងៃរបស់ MachineTranslation.com ផ្ទាល់ Grok ទទួលបានពិន្ទុជាមធ្យមខ្ពស់ជាង Qwen គឺ 9.26 ទល់នឹង 8.87 នៃពិន្ទុពេញ 10។ ប៉ុន្តែការដាក់ពិន្ទុរបស់ Grok គឺផ្អែកលើចំនួនទិន្នន័យតូចជាង និងមិនសូវជាតំណាងឱ្យលទ្ធផលបញ្ចេញរបស់វាទាំងមូលនោះទេ ដូច្នេះនេះមិនមែនជាការប្រៀបធៀបទល់មុខគ្នាសុទ្ធសាធដូចទៅនឹងការធ្វើតេស្តផ្នែកដែលត្រូវគ្នានោះទេ។
2. ហេតុអ្វីបានជា Grok មានពិន្ទុជាមធ្យមខ្ពស់ជាង ប៉ុន្តែមានការបកប្រែដែលទទួលបានពិន្ទុតិចជាង?
Grok ត្រូវបានប្រើប្រាស់តិចជាងនៅលើផ្លាតហ្វមនេះ ហើយមានតែប្រហែល 22.5% នៃលទ្ធផលរបស់វាប៉ុណ្ណោះដែលត្រូវបានដាក់ពិន្ទុ ធៀបនឹង 42.6% សម្រាប់ Qwen។ សំណាកទិន្នន័យដែលតូចជាង និងមិនសូវតំណាងឱ្យលទ្ធផលទាំងមូល អាចធ្វើឱ្យពិន្ទុមធ្យមកើនឡើងហួស ឬទាបជាងការពិត ដែលនេះជាមូលហេតុដែលការប្រៀបធៀបនេះគួរតែត្រូវបានចាត់ទុកគ្រាន់តែជាទិសដៅប៉ុណ្ណោះ មិនមែនជាការសន្និដ្ឋានចុងក្រោយទេ។
3. តើ Qwen ឬ Grok គាំទ្រភាសាច្រើនជាង?
ទាំងពីរគឺជាម៉ូដែល AI សម្រាប់គោលបំណងទូទៅ ដែលមិនមានបញ្ជីបញ្ជាក់ពីដែនកំណត់ភាសាជាក់លាក់ដែលត្រូវបានផ្ទៀងផ្ទាត់ និងបោះពុម្ពផ្សាយនោះទេ។ ម៉ូដែលទាំងពីរមិនត្រូវបានបង្កើតឡើងជាពិសេសសម្រាប់ការបកប្រែទេ ដែលនេះខុសពីផ្លាតហ្វមដែលធ្វើតេស្ត និងដាក់ពិន្ទុគុណភាពបកប្រែដោយផ្ទាល់ទៅលើភាសាជាង 270+ ជាជាងការពឹងផ្អែកលើការបណ្តុះបណ្តាលពហុភាសាដ៏ទូលំទូលាយទុកជាតំណាងឱ្យប្រសិទ្ធភាពនៃការបកប្រែដែលបានវាស់វែង។
4. តើ MachineTranslation.com ប្រកួតប្រជែងជាមួយ Qwen និង Grok ដែរឬទេ?
ទេ។ MachineTranslation.com ដំណើរការ Qwen, Grok និងម៉ូដែល AI ជាង 20 ផ្សេងទៀតនៅលើរាល់ការបកប្រែ ហើយបង្ហាញនូវទម្រង់បកប្រែណាដែលម៉ូដែលទាំងនោះយល់ស្របគ្នាច្រើនជាងគេ។ វាធ្វើតេស្ត និងរួមបញ្ចូលគ្នានូវម៉ូដែលដូចទាំងនេះ ជាជាងការប្រកួតប្រជែងជាមួយពួកវាជាម៉ូដែលដាច់ដោយឡែករបស់ខ្លួន។
5. តើម៉ូដែល AI មួយណាដែល MachineTranslation.com ណែនាំសម្រាប់ការបកប្រែ?
មិនមានការកំណត់ជាលំនាំដើមនោះទេ។ ម៉ូដែលផ្សេងៗគ្នាដំណើរការខុសៗគ្នាទៅតាមគូភាសា និងប្រភេទមាតិកា ហើយគម្លាតរវាងពួកវាអាចមានទៅខាងណាក៏បាន អាស្រ័យលើអ្វីដែលកំពុងត្រូវបានបកប្រែ។ ភាពប្រែប្រួលនេះហើយទើបជាមូលហេតុដែលផ្លាតហ្វមដំណើរការម៉ូដែលជាច្រើនលើរាល់ការបកប្រែ ជាជាងជ្រើសរើសយកម៉ូដែលណាមួយជាការណែនាំអចិន្ត្រៃយ៍។