October 9, 2026
Qwen vs ChatGPT: 어떤 AI 모델이 번역을 더 잘할까요?
ChatGPT의 현재 세대 및 Qwen 은 모두 플랫폼 자체와 비교 평가받는 외부의 두 경쟁자가 아니라, MachineTranslation.com이 모든 번역 시 실행하는 모델 풀의 일부입니다. 동일한 세그먼트에서 두 모델로 동일한 텍스트를 번역해 보면, 전반적으로 ChatGPT가 더 많은 언어 쌍에서 우위를 차지합니다. 번역 방향별로 결과를 나누어 보면 한 가지 구체적인 지점에서 격차가 크게 좁혀집니다. 바로 두 모델이 거의 대등한 수준을 보이는 영어로의 번역입니다.
번역에 있어 ChatGPT보다 더 나은 AI가 있을까요?
경쟁 모델들이 발전함에 따라 ChatGPT 대안에 대한 전반적인 관심이 커졌지만, 그 이유는 사용 사례마다 크게 다르며 한 가지로 설명하기 어렵습니다. 특히 번역의 경우, 주관적인 느낌의 문제가 아니라 테스트 가능한 질문, 즉 특정 언어 쌍에서 실제로 어떤 모델의 성능이 더 우수한가를 살펴보는 것이 훨씬 더 유용한 질문입니다.
지난 28일간의 MachineTranslation.com 트래픽에서 두 모델은 98개 언어 쌍에 걸쳐 동일한 원문 텍스트를 번역했습니다. 이 중 77개 언어 쌍에서는 ChatGPT가 더 높은 점수를 기록했고, 21개 언어 쌍에서는 Qwen이 더 높은 점수를 기록했습니다. 일치하는 결과물에 대한 가중 평균 점수는 ChatGPT가 10점 만점에 9.10점, Qwen이 8.98점으로, 평균적으로는 실제적이지만 그리 크지 않은 차이를 보입니다. 그러나 번역 방향을 고려하면 훨씬 더 뚜렷한 격차가 드러납니다.
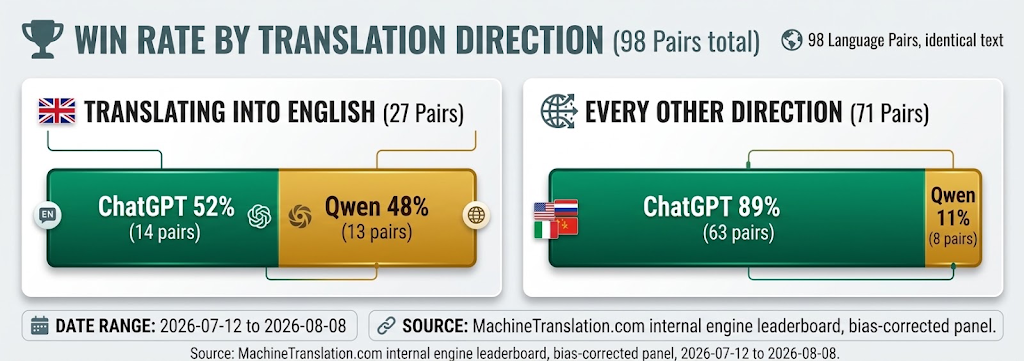
영어로 번역할 때 두 모델은 거의 동점에 가깝습니다. 그 외 모든 번역 방향에서는 ChatGPT가 테스트된 언어 쌍의 대다수에서 우위를 점합니다.
| ChatGPT | Qwen | |
|---|---|---|
| 평가된 결과물 비율 | 54.76% | 42.6% |
| 평균 점수 | 8.89 / 10 | 8.87 / 10 |
| 하위 10% 점수 | 7.8 | 7.6 |
| 영어로 번역 시 승률 | 52% | 48% |
| 그 외 모든 방향에서의 승률 | 89% | 11% |
영어로 번역할 때 격차가 거의 사라지는 이유는 무엇일까요?
데이터는 격차가 어디에서 발생하는지를 보여줄 뿐, 그 이유는 보여주지 않습니다. 분명한 점은 Qwen의 경쟁력이 고르게 나타나지 않는다는 것입니다. 영어가 타깃 언어인 27개 언어 쌍 중 Qwen이 13개를 차지하여 사실상 동전 던지기 수준의 결과를 보였습니다. 영어를 다른 언어로 번역하거나 영어가 아닌 두 언어 간 번역을 포함한 나머지 71개 언어 쌍에서는 ChatGPT가 63개(89%)에서 우위를 점했습니다. Qwen의 대영어 번역 성능이 영어를 다른 언어로 번역하거나 비영어 언어 쌍 번역에도 그대로 이어질 것이라고 가정한다면, 엉뚱한 방향에서 잘못된 교훈을 얻는 셈입니다.
Qwen은 중국 기업인가요? 그리고 이것이 번역에 중요할까요?
Qwen은 중국에 본사를 둔 Alibaba Cloud에서 개발했습니다. 그 자체만으로는 모델이 특정 문장을 얼마나 잘 번역하는지를 바꾸지는 않으며, 위의 데이터는 모델이 어디에서 개발되었는지와 관계없이 실제 결과물 품질을 반영합니다. 중요한 영향을 미칠 수 있는 부분은 데이터 처리입니다. 규제 대상이거나 민감한 콘텐츠(계약서, 의료 기록, 개인정보)를 번역하는 기업은 AI 제공업체가 해당 콘텐츠를 어디에서 처리하고 저장하는지에 대한 문제를 번역 품질 자체와는 별개의 실질적인 실사(due-diligence) 항목으로 다루어야 합니다. 이는 Qwen에만 국한된 것이 아니라 모든 AI 제공업체에 적용되며, MachineTranslation.com이 이러한 의문을 답이 없는 상태로 두지 않고 자체 데이터 처리 및 보안 관행을 직접 공개하는 이유이기도 합니다.
법률 및 비즈니스 번역에서 둘 중 더 신뢰할 수 있는 모델이 있나요?
일관되게 그렇지는 않으며, 그 차이가 항상 어느 모델이 더 높은 점수를 받았는지에 관한 것만은 아닙니다. 실제 계약서 문구를 대상으로 한 MachineTranslation.com의 테스트에서는 법률 텍스트에서 두 모델 중 어느 하나를 신뢰하기 전에 알아두어야 할 두 가지 개별 사례가 발견되었습니다. 관용적 표현의 경우에는 때때로 반대의 결과가 나타나기도 합니다. 별도의 1:1 비교 테스트 결과, ChatGPT는 독일어 관용구를 직역하여 오역한 반면, Qwen은 올바른 관용적 의미를 파악했습니다. 이는 종합 데이터에서 어느 한 모델이 보이는 전반적인 우위가 모든 문장에 일괄적으로 적용되는 것은 아님을 상기시켜 줍니다.
| 테스트 사례 | ChatGPT | Qwen |
|---|---|---|
| "At-will employment" 독일어 번역 | 사용 가능하고 실용적인 표현 | 무관한 법적 개념 적용 |
| 책임 제한 조항 스페인어 번역 | "que surjan de" | "derivados de" (적용 범위를 바꾸는 차이) |
| "Ich verstehe nur Bahnhof" (독일어 관용구) | 직역됨, 부정확함 | 정확한 관용적 의미 |
이 세 가지 사례에서 어느 한 모델도 일관되게 우위를 점하지 못했습니다. 단일 모델의 종합 점수가 특정 용어나 문구에 대한 성능을 예측해주지는 않습니다. 이것이 바로 어떤 모델이 초안을 작성했든 관계없이 법률 및 계약 문서 번역에 인간의 검토 단계가 필요한 이유이기도 합니다.
언어 지원 범위는 어떤가요?
ChatGPT와 Qwen 모두 번역 품질이 저하되는 언어 쌍에 대해 검증되고 독립적으로 확인된 목록을 공개하지 않습니다. 두 모델 모두 광범위한 다국어 학습을 거친 범용 모델이지만, 이는 특정 언어 세트에 대해 측정된 번역 성능과는 다른 개념입니다. MachineTranslation.com은 모델의 일반적인 언어 능력을 실제 번역 성능의 지표로 삼는 대신, 330개 이상의 언어에 걸쳐 번역 품질을 직접 테스트하고 점수를 매깁니다.
비즈니스 번역을 위해 ChatGPT나 Qwen에 붙여넣지 말아야 할 것은 무엇인가요?
ChatGPT와 Qwen 모두 전용 번역 플랫폼으로 구축된 것이 아니며, 민감한 비즈니스 콘텐츠를 범용 채팅 인터페이스에 직접 붙여넣는 것은 다른 소비자용 AI 툴에 붙여넣는 것과 동일한 데이터 처리 관련 의문을 불러일으킵니다. 즉, 입력 내용이 어디서 처리되는지, 보관되는지, 누가 접근할 수 있는지에 대한 문제입니다. 계약서, 의료 기록, 이민 서류, 재무제표는 번역 후가 아니라 번역하기 전에 이러한 질문에 대한 답을 확인해야 하는 콘텐츠입니다. 이것이 바로 어떤 모델을 기반으로 하든 상관없이, 공개되고 검증 가능한 데이터 처리 방식을 갖춘 전용 번역 플랫폼이 범용 채팅 인터페이스와 근본적으로 다른 이유입니다.
MachineTranslation.com이 두 모델을 실제로 활용하는 방법
MachineTranslation.com은 모든 번역에서 ChatGPT, Qwen 및 20개 이상의 기타 AI 모델을 실행한 다음, 해당 모델들이 가장 일치하는 버전을 제시합니다. Qwen과 ChatGPT의 성능이 번역 방향에 따라 극명하게 나뉜다는 점을 고려할 때, 하나의 모델을 고정 기본값으로 선택하는 것은 예측 가능한 비율의 언어 쌍에서 잘못된 선택을 내리게 됨을 의미합니다. 이러한 번역 방향에 따른 패턴은 MachineTranslation.com의 Qwen 대 DeepSeek 비교에서도 동일하게 나타납니다. 현재 모델들이 서로 어떻게 테스트되는지에 대한 전체적인 내용은 MachineTranslation.com의 전체 모델 비교 테스트를 참조하세요.
자주 묻는 질문
1. 번역에는 Qwen과 ChatGPT 중 어느 것이 더 낫나요?
동일한 소스 텍스트로 테스트한 98개 언어 쌍 중 ChatGPT가 77개에서 더 높은 점수를 받았습니다. Qwen이 가장 강력한 성능을 보인 것은 영어로 번역할 때였으며, 이 경우 두 모델은 거의 호각을 이룹니다. 그 외의 모든 방향에서는 ChatGPT가 대다수의 언어 쌍에서 우위를 점하므로, 솔직한 답변을 드리자면 번역 방향이 어디로 향하느냐에 따라 크게 달라집니다.
2. ChatGPT와 Qwen 중 지원하는 언어가 더 많은 것은 무엇인가요?
둘 다 언어별 한계에 대해 검증되고 공개된 목록이 없는 범용 AI 모델입니다. 어느 쪽도 독립적으로 확인된 언어 쌍 지원 범위 데이터를 게시하지 않으며, 이는 다국어 학습에 대한 일반적인 주장에 의존하지 않고 330개 이상의 언어에 걸쳐 번역 품질을 직접 테스트하고 점수를 매기는 플랫폼과는 차이가 있습니다.
3. 법률 및 비즈니스 번역에는 Qwen과 ChatGPT 중 어느 것이 더 낫나요?
전반적으로 어느 한쪽이 확연히 낫다고 보기는 어렵습니다. 독일 고용법 용어를 테스트했을 때 DeepSeek과 ChatGPT는 실용적이고 기능적인 표현을 만들어낸 반면, Claude와 Qwen은 모두 관련 없는 법적 개념을 제시했습니다. 이는 우열이 전반적인 모델의 성능 차이가 아니라 특정 용어와 문맥에 따라 갈린다는 것을 보여줍니다.
4. MachineTranslation.com은 ChatGPT 및 Qwen과 경쟁 관계인가요?
아닙니다. MachineTranslation.com은 모든 번역에서 ChatGPT, Qwen 및 20개 이상의 기타 AI 모델을 실행하고, 해당 모델들이 가장 일치하는 버전을 제시합니다. 별도의 경쟁 모델 역할을 하기보다는 이러한 모델들을 테스트하고 결합하는 방식으로 작동합니다.
5. 대규모 현지화 프로젝트에는 어떤 모델을 선택해야 하나요?
콘텐츠가 여러 언어에 걸쳐 양방향으로 번역되는 경우, 어느 한 모델만을 기본값으로 선택하는 것은 안전하지 않습니다. 여기서 확인된 방향별 성능 차이는 영어로 번역할 때 우수한 성능을 보이는 모델이라도 수십 개의 언어 쌍에 걸쳐 영어에서 다른 언어로 번역할 때는 매우 다른 성능을 보일 수 있음을 의미합니다.
6. 번역에 가장 적합한 Qwen 모델은 무엇인가요?
현재로서는 확인할 수 없습니다. MachineTranslation.com의 추적 시스템은 다른 제공업체와 달리 현재 Qwen을 모델 버전 태그가 없는 단일 엔진으로 기록하고 있어, 보고할 수 있는 하위 버전별 품질 데이터가 존재하지 않습니다. 이 부분이 개선되면 Qwen3.8-Max와 Qwen3.8-27B 간의 실질적인 비교 분석이 가능해질 것이며, 현재로서는 이는 단순한 미측정 세부 사항이 아니라 실제 공백입니다.