October 2, 2026
Qwen vs Grok: 어떤 AI 모델이 더 번역을 잘할까요?
Qwen과 Grok은 번역 전용 도구가 아닌 범용 AI 모델이며, 두 모델 모두 MachineTranslation.com이 모든 번역 작업에 사용하는 모델 풀에 포함되어 있습니다. 이는 앞으로 나올 내용을 어떻게 이해해야 하는지에 있어 중요한 부분입니다. 이 글은 외부의 두 경쟁 모델과 플랫폼 자체의 대결이 아니라, 이러한 데이터에 수반되는 현실적인 한계점들을 고려하면서 플랫폼 내의 두 모델이 서로 어떻게 비교되는지 살펴보는 것입니다.
Qwen과 Grok이란 무엇인가요?
Qwen Alibaba의 대규모 언어 모델 제품군으로, 현재 Qwen3.8 세대에 이르렀으며 플랫폼의 지속적인 확장의 일환으로 MachineTranslation.com의 모델 풀에 추가되었습니다. Grok xAI의 모델 라인으로, 이 글을 작성하는 현재 Grok 4.7 버전에 도달해 있으며, 이 글에서 처음 비교했던 버전 이후 여러 차례의 업데이트를 거쳐 플랫폼에 별도로 합류했습니다. 두 모델 모두 번역만을 위해 특별히 제작되지는 않았습니다. 둘 다 광범위한 언어 기능의 일부로 여러 언어를 처리하는 범용 시스템이며, 이는 오직 번역 품질만을 중심으로 구축되고 테스트된 플랫폼과는 출발점 자체가 다릅니다.
MachineTranslation.com의 자체 데이터에서 Qwen과 Grok은 어떻게 비교될까요?
지난 28일간의 플랫폼 트래픽을 기준으로, Grok은 평균 10점 만점에 9.26점을 기록하여 8.87점을 받은 Qwen보다 더 높은 점수를 받았습니다. Grok의 하위 10% 번역 점수는 여전히 평균 9.2점을 유지한 반면, Qwen의 하위 10% 점수는 7.6점까지 떨어져, 단순히 평균치로만 볼 때보다 하위권에서 더 큰 격차를 보였습니다.
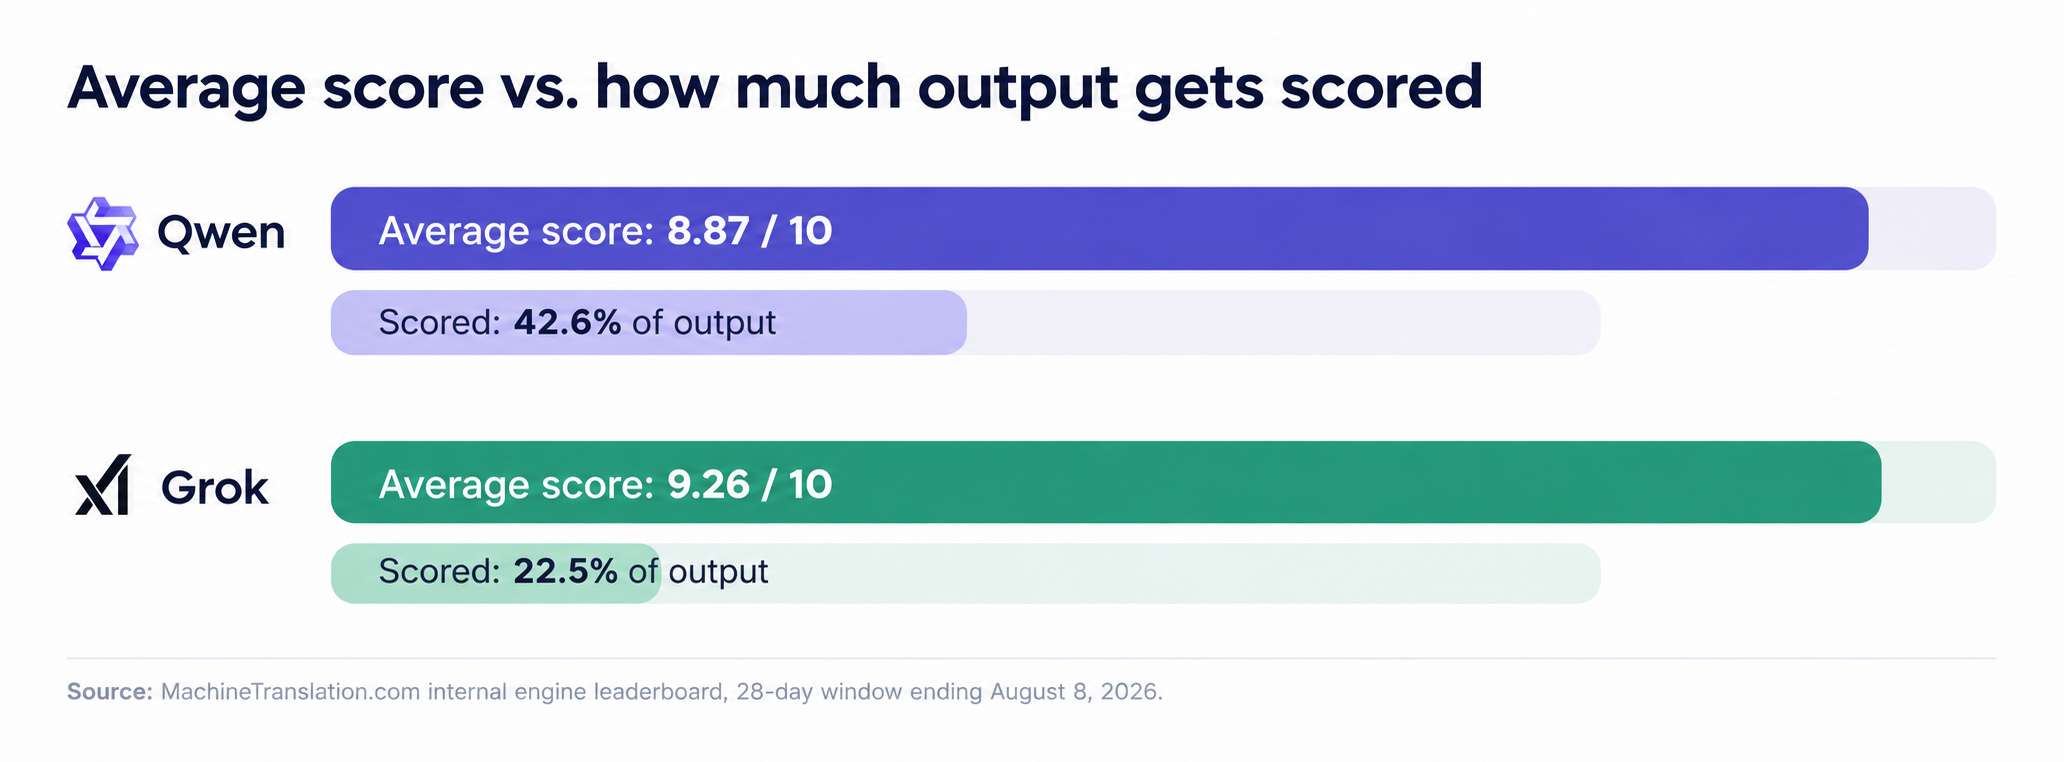
Grok의 평균 점수가 더 높지만, 이는 산출물의 절반 가까이 채점된 Qwen과 달리 전체 산출물의 4분의 1 미만만 채점된 결과에 기반합니다. 두 막대그래프는 동일한 상황의 각기 다른 측면을 보여줍니다.
| Qwen | Grok | |
|---|---|---|
| 채점된 산출물 비율 | 42.6% | 22.5% |
| 평균 점수 | 8.87 / 10 | 9.26 / 10 |
| 하위 10% 점수 | 7.6 | 9.2 |
출처: MachineTranslation.com 내부 엔진 리더보드, 2026년 8월 8일 마감 기준 최근 28일.
Grok의 점수가 더 높다는 것은 Grok이 더 나은 선택이라는 뜻일까요?
그것만으로는 단정할 수 없습니다. 플랫폼에서 Grok은 Qwen보다 훨씬 덜 사용되며, 번역의 거의 절반이 평가되는 Qwen과 달리 Grok은 전체 번역의 4분의 1도 채 평가되지 않습니다. 표본이 작고 대표성이 떨어지면, Qwen이 처리하는 것과 동일한 물량일 때보다 평균이 더 좋거나 나빠 보일 수 있습니다. 이 데이터에 대한 MachineTranslation.com의 자체 보고서는 평가 범위를 단순한 참고 사항이 아니라 실질적인 한계로 다루고 있습니다. 트래픽의 좁은 부분에 대해서만 평가를 받은 엔진은 출력 결과의 절반 가까이 평가를 받은 엔진만큼 철저하게 테스트되었다고 볼 수 없기 때문입니다.
솔직히 말해 Grok의 수치는 유망하지만 데이터가 빈약합니다. Qwen의 수치는 평균적으로 더 낮지만 훨씬 더 크고 대표성 있는 데이터에 기반을 두고 있습니다. 이 두 가지 사실은 서로를 상쇄하지 않습니다.
언어 지원 범위는 어떨까요?
Qwen과 Grok 모두 성능이 떨어지는 언어 쌍에 대해 검증된 목록을 발표하지 않으며, 이를 확인할 독립적인 테스트도 존재하지 않습니다. 확실하게 말할 수 있는 것은, 두 모델 모두 전문 번역 플랫폼처럼 특정 언어 세트에 걸쳐 번역 품질에 중점을 두고 구축되지 않았다는 점입니다. MachineTranslation.com은 270개 이상의 언어를 직접 테스트하고 지원하는데, 이는 범용 모델이 가진 광범위하지만 검증되지 않은 다국어 기능과는 다른 차원의 이야기입니다.
MachineTranslation.com이 Qwen과 Grok을 실제로 활용하는 방법
MachineTranslation.com은 모든 번역에 Qwen, Grok 및 20개 이상의 다른 AI 모델을 실행한 다음, 이 모델들이 가장 동의하는 버전을 노출합니다. 평균 점수가 낮다고 해서 두 모델 중 어느 것도 제외되지 않습니다. 여러 모델을 동시에 실행한다는 것은 평균 점수가 낮은 모델이 평균 점수가 높은 모델이 놓치는 특정 문장을 여전히 올바르게 번역하는 경우를 포착한다는 것을 의미합니다. 또한 단일 모델을 선택하기 전에 알아둘 가치가 있는 번역 방향 및 언어 쌍에 따라 Qwen의 성능이 나뉘는데, 이는 MachineTranslation.com의 Qwen vs DeepSeek 비교에서 더 자세히 다룹니다. 모델이 서로 어떻게 직접 테스트되는지 자세히 알아보려면 MachineTranslation.com의 전체 모델 비교 테스트를 참조하세요.
자주 묻는 질문
1. 번역에는 Qwen과 Grok 중 어느 것이 더 낫나요?
MachineTranslation.com의 자체 28일 엔진 데이터에 따르면, Grok의 평균 점수는 10점 만점에 9.26점으로 8.87점인 Qwen보다 높습니다. 하지만 Grok은 출력물의 훨씬 더 적고 덜 대표적인 부분에 대해서만 채점되었기 때문에, 이는 일치하는 세그먼트를 테스트하는 방식과 같은 깔끔한 일대일 비교라고 할 수 없습니다.
2. Grok의 평균 점수가 더 높은데도 채점된 번역 수가 더 적은 이유는 무엇인가요?
Grok은 플랫폼에서 덜 자주 사용되며 출력물의 약 22.5%만 채점되는 반면, Qwen은 42.6%가 채점됩니다. 표본이 더 작고 대표성이 떨어지면 평균이 부풀려지거나 축소될 수 있으므로, 이 비교는 확정적인 것이 아니라 방향성을 보여주는 것으로 이해해야 합니다.
3. Qwen과 Grok 중 어느 쪽이 더 많은 언어를 지원하나요?
둘 다 언어별 제한 사항에 대해 공식적으로 발표되고 검증된 목록이 없는 범용 AI 모델입니다. 어느 모델도 번역을 위해 특별히 구축되지 않았으며, 이는 측정된 번역 성능을 대신하기 위해 광범위한 다국어 학습에 의존하기보다는 270개 이상의 언어에 걸쳐 번역 품질을 직접 테스트하고 채점하는 플랫폼과는 다릅니다.
4. MachineTranslation.com은 Qwen 및 Grok과 경쟁하나요?
아닙니다. MachineTranslation.com은 모든 번역에 Qwen, Grok 및 20개 이상의 다른 AI 모델을 실행하고 해당 모델들이 가장 많이 일치하는 버전을 제공합니다. 자체적인 별도의 모델로서 경쟁하기보다는 이와 같은 모델들을 테스트하고 결합합니다.
5. MachineTranslation.com은 번역에 어떤 AI 모델을 추천하나요?
기본적으로 추천하는 단일 모델은 없습니다. 언어 쌍과 콘텐츠 유형에 따라 각 모델의 성능이 다르게 나타나며, 번역 대상에 따라 모델 간의 격차는 어느 쪽으로든 나타날 수 있습니다. 이러한 편차 때문에 플랫폼에서는 하나의 모델을 고정적으로 추천하는 대신 모든 번역에 여러 모델을 실행합니다.