May 8, 2026
Grok vs. Claude untuk terjemahan: apa yang ditunjukkan oleh penanda aras (2026)
Grok (xAI) dan Claude (Anthropic) kedua-duanya merupakan alat terjemahan AI yang berkeupayaan, tetapi mempunyai kekuatan yang berbeza dari segi struktur. Bagi kebanyakan tugasan terjemahan umum, anda tidak akan menyedari perbezaan yang ketara antaranya. Bagi dua senario khusus (menterjemah kandungan tentang peristiwa terkini, dan menterjemah dokumen rasmi yang memerlukan ketepatan), perbezaan tersebut adalah nyata dan berasaskan cara setiap model dibina.
Artikel ini merangkumi apa yang sebenarnya ditawarkan oleh setiap model untuk terjemahan, kedudukan mereka mengikut tanda aras bebas, dan perkara yang perlu digunakan apabila output mana-mana model itu sendiri tidak mencukupi.
Bagaimanakah perbandingan Grok dan Claude dari segi kualiti terjemahan?
Jawapan ringkasnya: Claude mendahului dalam penanda aras terjemahan profesional bebas. Kelebihan khusus Grok adalah akses pengetahuan masa nyata, bukannya kualiti terjemahan keseluruhan.
Dalam tanda aras dalaman MachineTranslation.com, Claude (tier 3.5 Sonnet) mendapat skor 93.8 daripada 100 untuk kualiti terjemahan — gabungan ketepatan, terminologi, dan gaya. Grok tidak muncul dalam 14 penyelesaian terbaik dalam State of Translation Automation 2025 oleh Intento, yang menilai 46 enjin MT dan LLMs merentasi 11 pasangan bahasa. Claude Opus 4 dan Claude Sonnet 3.7 kedua-duanya muncul dalam kelompok 14 teratas. Sumber: Penanda aras dalaman MachineTranslation.com; Intento State of Translation Automation 2025.
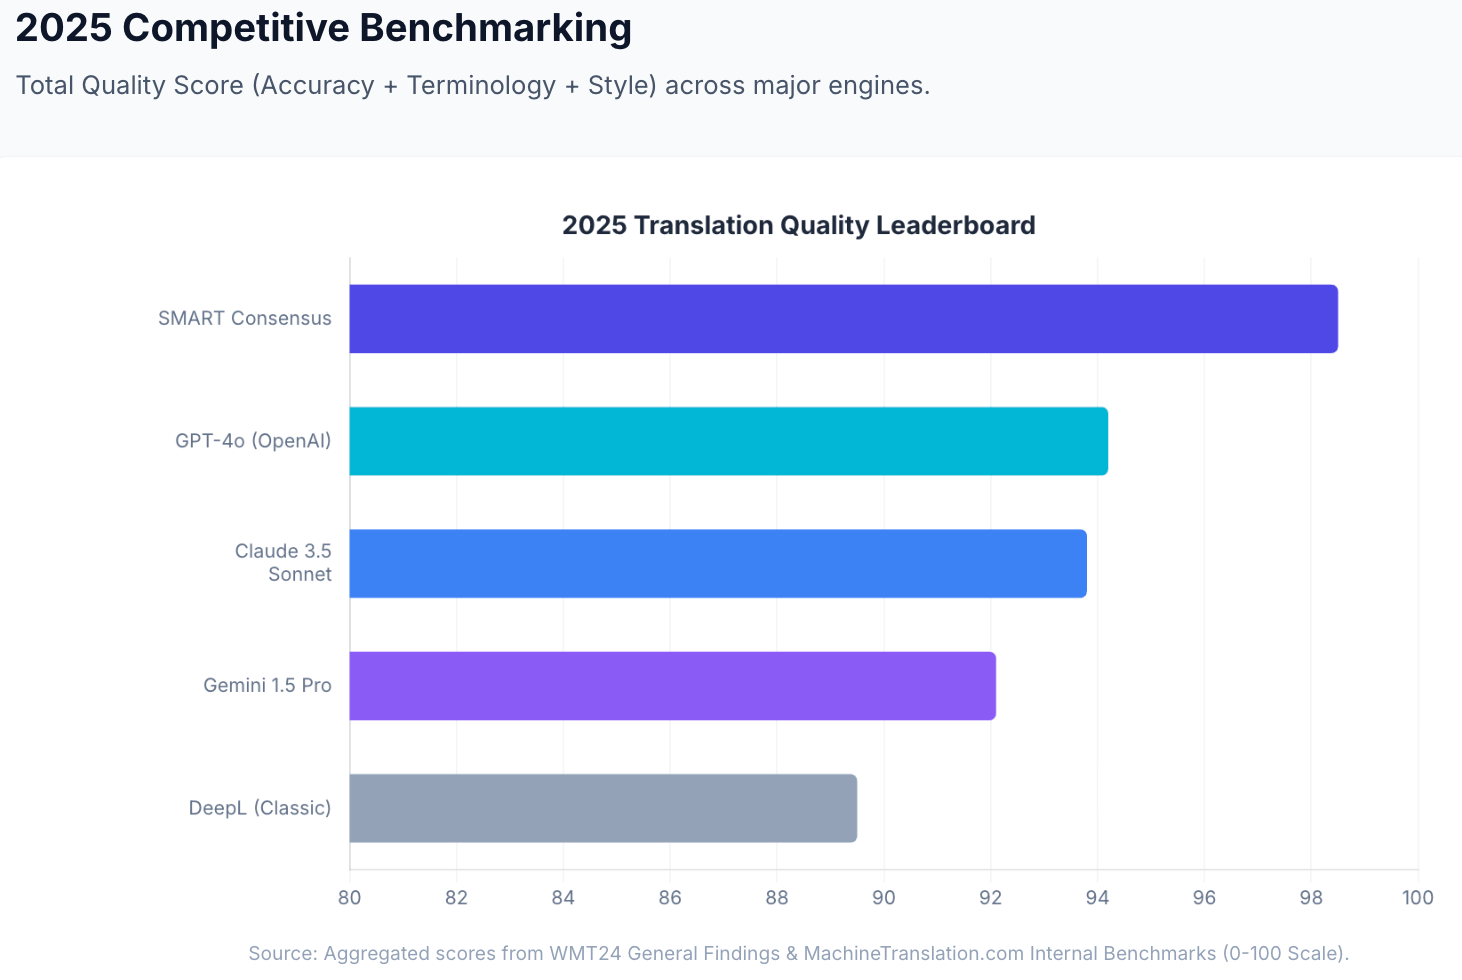
Di WMT24 (pertandingan penanda aras bebas utama industri penterjemahan), Claude 3.5 menduduki tempat pertama dalam 9 daripada 11 pasangan bahasa, mendahului GPT-4 dan enjin MT neural khusus. Dalam kajian buta 2025 Lokalise oleh penterjemah profesional, 78% daripada terjemahan Claude 3.5 dinilai sebagai baik — yang tertinggi bagi mana-mana LLM yang diuji.
Grok belum dinilai dalam WMT24 atau penilaian LQA bebas Intento pada tahap yang setanding. The Slator Pro Guide (2025) menyenaraikan Grok sebagai salah satu LLM kegunaan am yang digunakan untuk terjemahan dalam persekitaran profesional, bersama-sama GPT dan Claude, tetapi tidak meletakkannya di kedudukan yang lebih tinggi daripada kedua-duanya.
| Penanda aras | Grok | Claude |
|---|---|---|
| Skor kualiti dalaman MachineTranslation.com | Tidak diukur pada tahap penanda aras | 93.8/100 (tahap 3.5 Sonnet) |
| 14 penyelesaian terbaik Intento 2025 | Tidak disenaraikan | Claude Opus 4, Sonnet 3.7 kedua-duanya disenaraikan |
| Pasangan bahasa WMT24 | Tidak dinilai | Pertama dalam 9/11 pasangan bahasa |
| Kajian buta Lokalise 2025 | Tidak dinilai | 78% baik (tertinggi daripada mana-mana LLM) |
Sumber: Penanda aras dalaman MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Di manakah Grok mempunyai kelebihan sebenar?
Terjemahan masa nyata dan peristiwa semasa. Ciri seni bina yang mentakrifkan Grok ialah penyepaduannya dengan data platform X (dahulunya Twitter) dan carian internet secara langsung. Tidak seperti Claude dan kebanyakan LLM lain, yang dilatih menggunakan set data statik dengan had pengetahuan yang tetap, Grok menyepadukan maklumat masa nyata ke dalam outputnya. Untuk tugasan terjemahan yang melibatkan peristiwa terkini, produk yang baru dilancarkan, istilah politik yang baru muncul, berita semasa, atau kandungan yang merujuk kepada perkara yang berlaku dalam beberapa minggu kebelakangan ini, Grok mempunyai akses kepada konteks yang tidak dimiliki oleh Claude.
Ini amat penting untuk: menterjemah artikel berita tentang peristiwa terkini, melokalisasikan pengumuman produk untuk pasaran yang bergerak pantas, mengendalikan istilah atau slanga yang baru dicipta yang terkemudian daripada data latihan model lain, dan sebarang kandungan yang maknanya bergantung pada pengetahuan tentang apa yang berlaku baru-baru ini.
Istilah yang baru muncul dan berkembang. Bidang teknikal, industri, dan konteks budaya secara berterusan menghasilkan istilah baharu. Untuk tugasan terjemahan yang melibatkan istilah yang baru dicipta, bahasa kawal selia baharu, atau tatanama produk baharu, latihan Grok yang dikemas kini dan carian masa nyata memberikannya akses kepada pola penggunaan yang tidak ditangkap oleh snapshot data latihan yang lebih lama.
tetingkap konteks dan penaakulan Grok 4.1. Grok 4.1 (setakat akhir 2025) menampilkan tetingkap konteks 131K-token dan keupayaan penaakulan yang dipertingkatkan, menjadikannya berkemampuan mengendalikan dokumen yang kompleks dan berlapis-lapis di mana hubungan klausa dan koheren logik adalah penting.
Di manakah Claude mempunyai kelebihan sebenar?
Kualiti terjemahan pada penanda aras bebas. Kelebihan Claude didokumenkan oleh penilaian profesional bebas dan bukannya dakwaan yang dilaporkan sendiri. WMT24 meletakkan Claude 3.5 di tempat pertama dalam 9 daripada 11 pasangan bahasa berbanding keseluruhan pesaing. Kajian buta 2025 Lokalise mendapati penterjemah profesional lebih menyukai output Claude 3.5 pada kadar baik 78% — lebih tinggi daripada GPT-4, DeepL, dan Google Translate dalam penilaian yang sama. Ini adalah penilaian buta: penterjemah profesional menilai output tanpa mengetahui model mana yang menghasilkannya.
Pasangan bahasa khusus mengikut Intento 2025. Claude Opus 4 and Sonnet 3.7 berada dalam kategori terbaik bagi bahasa Inggeris ke bahasa Jerman, bahasa Inggeris ke bahasa Jepun, bahasa Inggeris ke bahasa Itali, bahasa Inggeris ke bahasa Korea, bahasa Inggeris ke bahasa Belanda, bahasa Inggeris ke bahasa Arab, dan bahasa Inggeris ke bahasa Perancis dalam penilaian LQA manusia Intento. Untuk pasangan ini, Claude ialah pilihan terdokumentasi yang lebih kukuh antara kedua-duanya.
Ketepatan nada dan kandungan bernuansa. Penterjemah profesional dalam kajian Lokalise lebih menyukai output Claude pada kadar tertinggi berbanding mana-mana LLM — mencerminkan kekuatan Claude yang didokumentasikan dalam mengekalkan laras bahasa, suara pengarang, dan makna kontekstual. Untuk terjemahan sastera, dokumen undang-undang, komunikasi rasmi, dan salinan pemasaran di mana cara sesuatu perkara itu diperkatakan adalah sama pentingnya dengan apa yang diperkatakan, Claude secara konsisten berprestasi baik merentasi penilaian bebas.
Koheren dokumen panjang. Claude 4.6 Sonnet menyokong tingkap konteks 200K-token, dengan Claude Opus 4.6 menyokong 1M token dalam beta. Untuk dokumen rasmi yang panjang (kontrak, manual teknikal, laporan percubaan klinikal), Claude boleh memproses keseluruhan dokumen dalam sekali lalu, mengekalkan ketekalan terminologi di keseluruhannya. Dokumen yang diproses secara serpihan menunjukkan kadar ketidakkonsistenan istilah yang 28% lebih tinggi berbanding pemprosesan keseluruhan dokumen. Sumber: Data dalaman MachineTranslation.com.
Bagaimanakah perbandingan mereka dari segi sokongan bahasa dan harga?
Sokongan bahasa: Kedua-dua Grok 4.1 dan Claude 4.6 menyokong terjemahan merentasi kebanyakan bahasa utama dunia. Claude telah dinilai secara bebas merentasi pasangan bahasa Eropah dan Asia Timur dengan keputusan yang kukuh. Sokongan pelbagai bahasa Grok telah bertambah baik merentasi versi yang berturut-turut. Bagi bahasa bersumber rendah, kedua-dua model mengalami penurunan kualiti — semakan manusia adalah wajar untuk kandungan dalam pasangan bahasa bersumber rendah tanpa mengira model mana yang digunakan.
Harga:
| Pelan | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Pengguna (bulanan) | SuperGrok: $30/bulan | Claude Pro: $20/bulan |
| Input API (setiap M token) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Output API (setiap M token) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Peringkat percuma | Ya (dihadkan kadar melalui X/Grok.com) | Ya (dihadkan kadar melalui claude.ai) |
Pada peringkat pengguna, Claude Pro ($20/month) is cheaper than SuperGrok ($30/bulan). Pada peringkat API, Grok 4.1 mempunyai sedikit kelebihan kos berbanding Claude Sonnet 4.6 untuk aliran kerja terjemahan yang padat input.
Yang mana lebih baik untuk jenis kandungan tertentu?
| Jenis kandungan | Model yang disyorkan | Sebab |
|---|---|---|
| Berita terkini / peristiwa semasa | Grok | Akses data masa nyata; model terlatih statik kekurangan konteks semasa |
| Terminologi baharu / pelancaran produk baharu | Grok | Integrasi carian langsung menangkap corak penggunaan terkini |
| Dokumen undang-undang rasmi | Claude | Penilaian bebas WMT24 dan Lokalise 2025; ketepatan nada |
| Kandungan perubatan / klinikal | Claude | Kedudukan penanda aras bebas; pemeliharaan laras bahasa |
| Salinan pemasaran / kandungan kreatif | Claude | Pilihan kajian buta Lokalise 2025; nuansa nada |
| Dokumentasi teknikal (panjang) | Claude | Tingkap konteks 200K-1M; konsistensi terminologi sepanjang teks |
| Media sosial / kandungan perbualan | Mana-mana satu | Kedua-duanya mengendalikan pasangan perbualan bersumber tinggi dengan baik |
| Pembangun / integrasi API | Mana-mana satu | Kedua-duanya menawarkan akses API; Grok sedikit lebih murah untuk token input |
Apa yang perlu digunakan apabila satu model tidak mencukupi
Kedua-dua Grok dan Claude ialah alat model tunggal. Setiap model AI individu (tanpa mengira betapa mampunya ia) menghasilkan ralat yang tidak dapat dikesannya dalam outputnya sendiri. Terjemahan yang lancar dan meyakinkan sama ada daripada Grok atau Claude masih boleh salah dari segi semantik, dan tanpa semakan silang, tiada cara untuk mengetahuinya.
Kedua-dua Grok dan Claude adalah antara 22 model dalam sistem SMART MachineTranslation.com. SMART menjalankan kesemua 22 model secara serentak (termasuk Grok dan Claude) dan mengembalikan output yang dipersetujui oleh majoriti.
Apakah maksud perkara ini untuk persoalan Grok vs. Claude: Kekuatan masa nyata Grok dan kedalaman kontekstual Claude kedua-duanya menyumbang kepada konsensus yang sama. Apabila mereka bersetuju, persetujuan tersebut merupakan isyarat kualiti yang kuat.
Dalam penanda aras dalaman MachineTranslation.com, model peringkat teratas secara individu mendapat skor 93-94 daripada 100 untuk kualiti terjemahan. Output konsensus SMART mencapai 98.5/100. Sumber: Penanda aras dalaman MachineTranslation.com dan WMT24 General Machine Translation Findings.
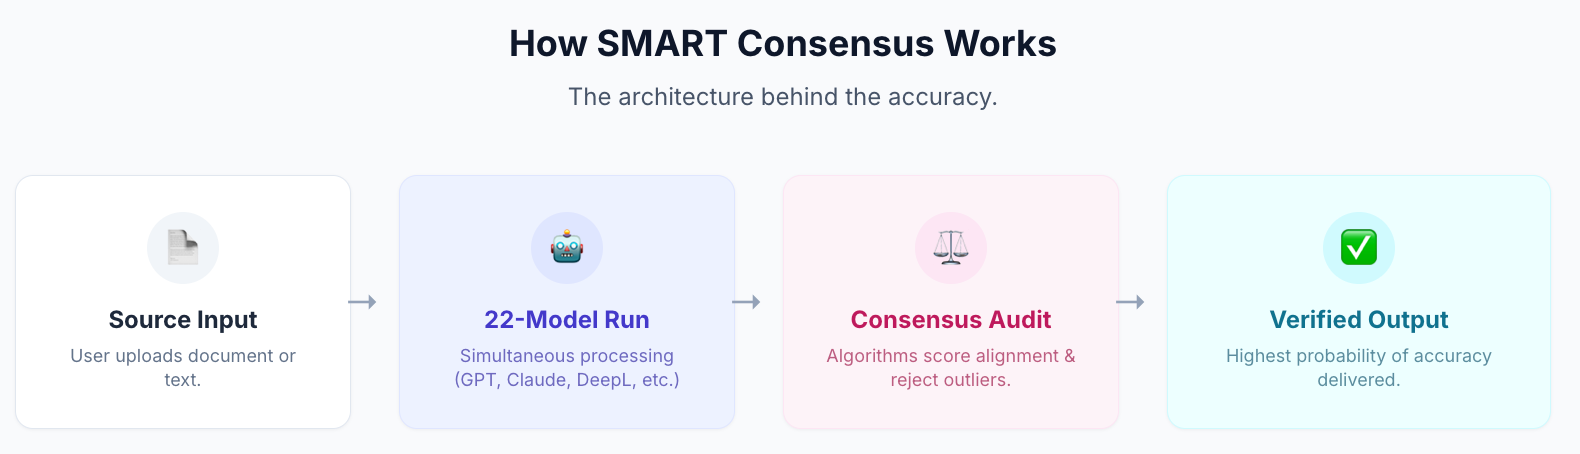
Pengguna yang beralih daripada terjemahan enjin tunggal kepada SMART menghabiskan 27% kurang masa untuk mengesahkan dan membetulkan output. Sumber: Data dalaman MachineTranslation.com.
Untuk kandungan berkepentingan tinggi (dokumen undang-undang, pemfailan kawal selia, arahan perubatan), Human Verification memajukan konsensus SMART kepada pemeriksa profesional bertauliah dalam platform yang sama. Tiada agensi luar. Ketepatan 100% dijamin.
Terjemah dengan Grok, Claude, dan 20 model lain di MachineTranslation.com — percuma, tiada pendaftaran diperlukan.
Soalan lazim
1. Adakah Grok lebih baik daripada Claude untuk terjemahan?
Untuk kebanyakan tugas terjemahan standard, Claude mendahului dalam tanda aras bebas: pertama dalam 9 daripada 11 pasangan bahasa di WMT24, penarafan baik sebanyak 78% dalam kajian buta 2025 Lokalise, dan 93.8/100 dalam tanda aras kualiti dalaman MachineTranslation.com. Kelebihan khusus Grok adalah untuk kandungan yang memerlukan pengetahuan peristiwa semasa, akses data masa nyatanya memberikannya konteks yang tidak dimiliki oleh model terlatih statik termasuk Claude. Untuk berita terkini, istilah yang baru muncul, dan kandungan sensitif masa, Grok adalah pilihan yang lebih kukuh.
2. Apakah kelebihan Grok berbanding Claude untuk terjemahan?
Grok menyepadukan data masa nyata daripada X (dahulunya Twitter) dan carian internet langsung. Tidak seperti Claude dan kebanyakan LLM lain yang dilatih menggunakan set data statik, Grok boleh mengakses maklumat tentang peristiwa terkini, istilah yang baru dicipta, dan konteks semasa apabila menjana terjemahan. Ini menjadikannya secara khusus lebih kuat untuk menterjemah kandungan berita, produk yang baru dikeluarkan, dan sebarang bahan yang maknanya bergantung pada peristiwa atau pola bahasa dari beberapa minggu kebelakangan ini.
3. Apakah kelebihan Claude berbanding Grok untuk terjemahan?
Kelebihan Claude didokumentasikan melalui penilaian profesional yang bebas. Claude 3.5 menduduki tempat pertama dalam 9 daripada 11 pasangan bahasa di WMT24, dan penterjemah profesional dalam kajian buta 2025 Lokalise lebih menyukai outputnya pada kadar baik sebanyak 78% — yang tertinggi bagi mana-mana LLM yang diuji. Claude juga muncul dalam 14 penyelesaian teratas Intento merentasi pelbagai pasangan bahasa dalam penilaian LQA manusia, manakala Grok tidak. Bagi tugasan terjemahan yang rasmi, profesional, dan berisiko tinggi, kedudukan penanda aras bebas Claude merupakan faktor pembeza yang didokumenkan.
4. Yang mana lebih baik untuk terjemahan undang-undang, Grok atau Claude?
Claude ialah pilihan yang lebih kukuh untuk terjemahan undang-undang berdasarkan penilaian bebas. Claude 3.5 menduduki tempat pertama merentasi kebanyakan pasangan bahasa Eropah bersumber tinggi di WMT24 dan menerima penarafan keutamaan kajian buta yang tertinggi daripada penterjemah profesional. Bagi kandungan undang-undang yang memerlukan ketepatan yang diperakui, tiada satu pun model yang mencukupi secara bersendirian — Pengesahan Manusia MachineTranslation.com menyediakan ketepatan 100% daripada penyemak profesional yang diperakui dalam platform yang sama, tanpa memerlukan vendor luaran.
5. Adakah kedua-dua Grok dan Claude tersedia di MachineTranslation.com?
Ya. Kedua-duanya merupakan antara 22 model dalam sistem SMART MachineTranslation.com. Setiap terjemahan SMART menjalankan Grok, Claude, dan 20 model lain secara serentak, mengembalikan output yang dipersetujui oleh majoriti. Daripada memilih antara mereka, anda menerima konsensus semua model AI.
6. Bagaimanakah perbandingan Grok dan Claude dari segi harga?
Pada peringkat pengguna, Claude Pro berharga $20/month versus SuperGrok at $30/bulan. Pada peringkat API, Grok 4.1 adalah sedikit lebih murah untuk token input ($2/M vs. $3/M untuk Claude Sonnet 4.6) dan output ($10/M vs. $15/M). Pelan percuma MachineTranslation.com merangkumi kedua-dua model sebagai sebahagian daripada konsensus 22-model SMART, tiada pendaftaran diperlukan.
7. Model AI manakah yang terbaik untuk menterjemah artikel berita?
Untuk menterjemah artikel berita, Grok mempunyai kelebihan struktur: integrasi data masa nyatanya bermakna ia mempunyai konteks semasa tentang peristiwa yang diterangkan, yang mungkin tidak dimiliki oleh model terlatih secara statik. Untuk terjemahan berita umum di mana aspek terkini tidak kritikal, prestasi penanda aras Claude adalah lebih kukuh. Untuk terjemahan berita bervolum tinggi yang mementingkan kedua-dua kemutakhiran dan ketepatan, SMART MachineTranslation.com menjalankan kedua-dua model dan mengembalikan output konsensus mereka.