November 13, 2026
Qwen vs Gemini untuk terjemahan dan sebab arah terjemahan penting
Anda mempunyai dua model dan senarai pasangan bahasa, dan anda perlu memutuskan model mana yang patut dipercayai untuk projek tersebut. Kebanyakan perbandingan antara Qwen dan Gemini memberikan jawapan dengan satu skor keseluruhan. Saya berpendapat satu skor menyembunyikan perkara yang sebenarnya menentukan hasilnya, iaitu arah terjemahan.
Saya mengusahakan cara kami menguji model yang beroperasi di MachineTranslation.com, jadi saya boleh membandingkan Qwen dan Gemini pada 98 pasangan bahasa yang dinilai berdasarkan teks yang serupa. Gemini memperoleh skor lebih tinggi dalam 68 daripada pasangan tersebut dan Qwen dalam 29, dengan purata jurang sebanyak 0.08 mata daripada 10. Jumlah skor itu sahaja tidak memberitahu anda model mana yang patut dipilih untuk bahasa Urdu ke bahasa Inggeris atau untuk bahasa Inggeris ke Creole Haiti.
Artikel ini menunjukkan di mana kedua-dua model bersaing rapat dan di mana setiap satu mendahului. Ia juga menyatakan apa yang belum dapat saya beritahu anda. Data saya berakhir pada 8 Ogos 2026, sebelum Google mengumumkan Gemini 4 pada bulan Oktober, jadi ia menerangkan versi terdahulu bagi kedua-dua model tersebut.
Dapatan utama
- Merentasi 98 pasangan bahasa yang dinilai berdasarkan teks yang serupa (12 Julai hingga 8 Ogos 2026), Gemini memperoleh skor lebih tinggi dalam 68 pasangan, Qwen dalam 29, dan satu pasangan seri.
- Purata jurang adalah kecil, 9.06 untuk Gemini berbanding 8.98 untuk Qwen, dan 60 daripada 98 pasangan berada dalam lingkungan 0.1 mata.
- Untuk terjemahan ke bahasa Inggeris, Qwen mendahului dengan lebih daripada 0.1 mata dalam 7 daripada 27 pasangan dan Gemini dalam 3; 17 pasangan lagi berada dalam lingkungan 0.1 mata.
- Untuk terjemahan daripada bahasa Inggeris, Gemini mendahului dengan lebih daripada 0.1 mata dalam 13 daripada 29 pasangan dan Qwen tiada.
- Data ini berakhir sebelum Google mengumumkan Gemini 4 pada Oktober 2026, jadi ia menggambarkan versi Gemini yang terdahulu dan memerlukan ujian baharu sebelum sesiapa menganggapnya sebagai maklumat terkini.
Adakah Qwen atau Gemini lebih baik untuk terjemahan?
Ia bergantung pada arah terjemahan, kerana kedua-dua model bersaing rapat apabila bahasa sasaran ialah bahasa Inggeris dan Gemini mendapat skor lebih tinggi dalam kebanyakan pasangan lain. Merentasi kesemua 98 pasangan, Gemini memperoleh skor lebih tinggi dalam 68 pasangan. Dalam skor MachineTranslation.com dari 12 Julai hingga 8 Ogos 2026, Gemini mencatatkan purata 9.06 daripada 10 dan Qwen 8.98, iaitu purata jurang sebanyak 0.08 mata.
Panel ini hanya mengira segmen di mana ChatGPT, Claude, DeepSeek, Gemini, dan Qwen kesemuanya menerima skor sebenar, jadi setiap model dinilai berdasarkan teks sumber yang serupa. Setiap pasangan bahasa mempunyai sekurang-kurangnya 30 segmen. Saya menggunakan panel ini kerana ia menghapuskan kesilapan biasa, iaitu membandingkan model berdasarkan teks yang berbeza.
Berdasarkan kiraan, Gemini mendahului dalam 68 pasangan (69%), Qwen dalam 29 (30%), dan satu pasangan seri. Kiraan sahaja membesar-besarkan jurang tersebut, kerana 60 daripada 98 pasangan berada dalam lingkungan 0.1 mata. Bahagian seterusnya membahagikan keputusan mengikut arah dan margin.
Arah terjemahan manakah yang memberi kelebihan kepada setiap model?
Gemini mendahului apabila bahasa Inggeris menjadi bahasa sumber atau apabila kedua-dua bahasa bukan bahasa Inggeris, manakala Qwen setaraf dengannya atau mendahului apabila bahasa Inggeris menjadi sasaran. Daripada bahasa Inggeris, Gemini mendahului dengan lebih daripada 0.1 mata dalam 13 daripada 29 pasangan dan Qwen tiada langsung. Ke bahasa Inggeris, Qwen mendahului dengan margin tersebut dalam 7 daripada 27 pasangan dan Gemini dalam 3.
| Arah | Pasangan | Gemini mendahului lebih daripada 0.1 | Dalam lingkungan 0.1 mata | Qwen mendahului lebih daripada 0.1 | Jurang purata |
|---|---|---|---|---|---|
| Ke bahasa Inggeris | 27 | 3 | 17 | 7 | Qwen +0.04 |
| Daripada bahasa Inggeris | 29 | 13 | 16 | 0 | Gemini +0.16 |
| Kedua-dua belah bukan bahasa Inggeris | 42 | 14 | 27 | 1 | Gemini +0.13 |
Ke bahasa Inggeris, 17 daripada 27 pasangan berada dalam lingkungan 0.1 mata, Qwen mendahului dalam 7, dan Gemini mendahului dalam 3. Daripada bahasa Inggeris, 16 daripada 29 pasangan berada dalam lingkungan 0.1 mata, Gemini mendahului dalam 13, dan Qwen tidak mendahului dalam mana-mana pasangan. Di mana kedua-dua bahasa bukan bahasa Inggeris, 27 daripada 42 berada dalam lingkungan 0.1 mata, Gemini mendahului dalam 14, dan Qwen mendahului dalam 1.
Qwen berada dalam lingkungan 0.1 mata berbanding Gemini atau mendahului dalam 24 daripada 27 pasangan ke bahasa Inggeris. Berdasarkan purata mengikut arah, Qwen mendahului dengan kira-kira 0.04 mata ke bahasa Inggeris, manakala Gemini mendahului dengan kira-kira 0.16 mata daripada bahasa Inggeris dan 0.13 mata antara dua bahasa bukan bahasa Inggeris.
Saya tidak tahu mengapa perbezaan ini berlaku, dan data ini tidak dapat menjelaskannya. Satu penjelasan yang akan saya uji terlebih dahulu ialah gabungan teks latihan di sebalik setiap model, tetapi saya belum menjalankan ujian tersebut. Qwen menunjukkan corak yang serupa terhadap ChatGPT. Pada panel yang sama, perbandingan Qwen lwn ChatGPT kami mendapati kedua-duanya hampir seimbang ke bahasa Inggeris, dengan ChatGPT mendahului dalam 89% daripada pasangan yang lain.
Pasangan bahasa manakah yang menunjukkan jurang terbesar?
Jurang terbesar memihak kepada Gemini. Ia mendahului sebanyak 0.51 hingga 0.95 mata bagi bahasa Rusia ke bahasa Kazakh, bahasa Inggeris ke bahasa Kreol Haiti, bahasa Inggeris ke bahasa Tagalog, bahasa Sepanyol ke bahasa Greek, dan bahasa Arab ke bahasa Parsi. Kelebihan terbesar Qwen adalah lebih kecil, antara 0.15 dan 0.26 mata, dan empat daripada lima pasangan teratasnya ialah pasangan ke bahasa Inggeris.
| Pasangan bahasa | Skor Gemini | Skor Qwen | Jurang |
|---|---|---|---|
| Rusia ke Kazakh | 9.27 | 8.32 | Gemini +0.95 |
| Inggeris ke Kreol Haiti | 9.19 | 8.27 | Gemini +0.92 |
| Inggeris ke Tagalog | 9.14 | 8.43 | Gemini +0.70 |
| Sepanyol ke Yunani | 8.90 | 8.33 | Gemini +0.57 |
| Arab ke Parsi | 8.84 | 8.34 | Gemini +0.51 |
| Urdu ke Inggeris | 8.56 | 8.81 | Qwen +0.26 |
| Cina ke Inggeris | 9.00 | 9.19 | Qwen +0.19 |
| Bahasa Sweden ke Bahasa Inggeris | 8.29 | 8.46 | Qwen +0.16 |
| Bahasa Cina ke Bahasa Indonesia | 9.03 | 9.19 | Qwen +0.16 |
| Bahasa Burma ke Bahasa Inggeris | 8.94 | 9.09 | Qwen +0.15 |
Saya tidak akan menganggap ini sebagai kedudukan muktamad. Dua jurang terbesar, bahasa Rusia ke bahasa Kazakh dan bahasa Inggeris ke bahasa Kreol Haiti, berasaskan sampel yang lebih kecil berbanding pasangan median. Bahasa Inggeris ke bahasa Tagalog, bahasa Sepanyol ke bahasa Greek, dan bahasa Arab ke bahasa Parsi berasaskan sampel yang lebih besar, jadi saya lebih mempercayai ketiga-tiga pasangan tersebut. Saya akan menguji semula dua jurang bersampel kecil itu sebelum bergantung padanya.
Apakah maksud jurang 0.1 mata?
Pada pandangan saya, jurang di bawah 0.1 mata adalah terlalu kecil untuk menentukan pemenang. Daripada 98 pasangan, 60 berada dalam margin tersebut, dan setiap pasangan dinilai berdasarkan bilangan segmen yang terhad. Garis 0.1 ialah ambang kerja saya sendiri, dan saya belum menjalankan ujian keertian pada pasangan-pasangan ini.
Skor juga terlepas pandang beberapa perbezaan. Dalam ujian frasa lazim kami, kami menguji "sorry" dalam bahasa Arab melalui 22 model AI. Gemini dan Qwen kedua-duanya memilih آسف yang santai. ChatGPT dan hasil gabungan memilih عذرًا yang formal. Setiap model mendapat skor 9.5, jadi kedua-dua perkataan berbeza dari segi laras bahasa dan skor tersebut tidak berubah.
Itulah sebabnya saya melihat margin dan contoh laras bahasa bersama-sama. Jurang yang kecil dengan perbezaan laras bahasa yang ketara memerlukan keputusan manusia. Jurang yang besar pada sampel yang kecil memerlukan ujian semula.
Adakah Qwen dan Gemini melakukan jenis kesilapan yang berbeza?
Ya, kerana dalam ujian petikan Piala Dunia 2026 kami, kedua-dua model membuat sekurang-kurangnya satu pilihan yang tidak dibuat oleh model lain, dan skornya hampir tidak berubah. Gemini menterjemah frasa Mbappé sebagai "with each game" dan menterjemahkan petikan Wirtz perkataan demi perkataan, manakala Qwen memberikan tafsiran berbeza bagi petikan Scaloni. Skor untuk kes-kes ini adalah antara 9.2 hingga 9.5.
Butirannya datang daripada ujian petikan Piala Dunia kami. Mengenai petikan Mbappé tentang memandang ke hadapan, model lain mengekalkan "match" manakala Gemini menulis "with each game", sedikit kesilapan laras bahasa yang mendapat skor 9.4. Mengenai petikan Wirtz, Gemini menterjemah frasa perkataan demi perkataan dan mengubah maksudnya, juga pada 9.4. Mengenai petikan Scaloni, kebanyakan model cenderung kepada satu tafsiran manakala Qwen menulis "that is what matters" dan mendapat skor 9.4. Mengenai petikan taktikal Mbappé, Claude dan DeepSeek memilih bahasa Inggeris bola sepak British manakala Gemini, Qwen, dan yang lain memilih bahasa Inggeris Amerika, dan Qwen mendapat skor 9.2, lebih rendah daripada yang lain.
Saya melihat ini sebagai tabiat kecil. Contoh Gemini adalah tentang laras bahasa dan ungkapan literal. Contoh Qwen pula adalah tentang tafsiran baris mana yang perlu dipilih. Empat contoh terlalu sedikit untuk dianggap sebagai satu corak, tetapi ia menunjukkan jenis perbezaan yang disembunyikan oleh satu skor tunggal.
Model Qwen manakah yang terbaik untuk terjemahan?
Saya tidak dapat memastikannya daripada data kami, kerana skor MachineTranslation.com menganggap Qwen sebagai satu model tanpa tag versi. Daripada Alibaba, keluarga Qwen3.8 tiba di Hugging Face pada Ogos 2026, jadi beberapa versi kini wujud, dan skor dalam artikel ini tidak memisahkannya.
Saya ingin membahagikannya mengikut versi, namun saya belum boleh berbuat demikian. Angka pada peringkat platform mungkin merupakan purata bagi lebih daripada satu versi Qwen yang dijalankan dalam tempoh tersebut. Jika anda sedang memilih antara versi Qwen untuk sesuatu projek, saya mencadangkan agar anda membandingkannya menggunakan sampel teks anda sendiri.
Apakah beberapa alternatif kepada Gemini untuk terjemahan?
ChatGPT, Claude, DeepSeek, Qwen, Grok, dan Mistral AI semuanya beroperasi di MachineTranslation.com, dan alternatif yang tepat bergantung pada pasangan bahasa tersebut. Dalam skor kami dari 12 Julai hingga 8 Ogos 2026, Qwen berada dalam lingkungan 0.1 mata daripada Gemini atau berada di hadapan dalam 24 daripada 27 pasangan ke bahasa Inggeris. Skor bahasa Perancis Mistral AI kami menunjukkan purata bahasa Perancis ke bahasa Inggerisnya berada 0.40 mata di atas Gemini.
Jika alternatif anda ialah ChatGPT, jawapannya juga berbeza mengikut pasangan bahasa. Dalam pecahan bahasa Sepanyol ke bahasa Inggeris yang kami terbitkan, Gemini memenangi 31% segmen dan ChatGPT memenangi 21%. Untuk bahasa Perancis, tiada model yang menang dalam kedua-dua arah. Oleh sebab pilihan berubah mengikut pasangan bahasa, MachineTranslation.com tidak memilih satu alternatif sahaja. Ia menjalankannya bersama-sama.
Cadangan saya adalah untuk bermula daripada pasangan dan arah, kemudian melihat alternatif mana yang sesuai.
Bagaimanakah MachineTranslation.com menunjukkan di mana Qwen dan Gemini tidak bersetuju?
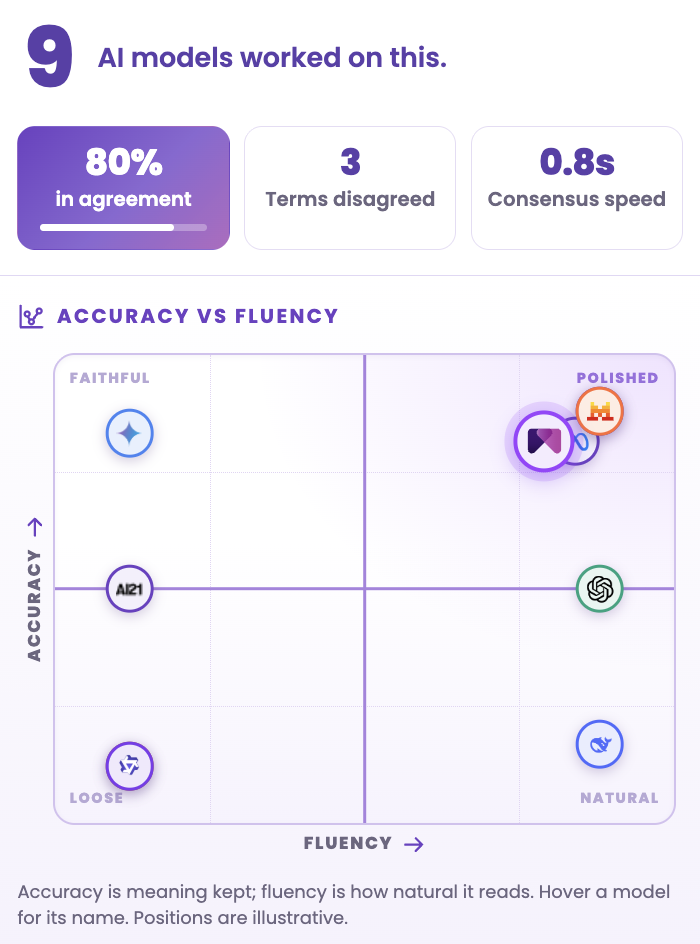
MachineTranslation.com menjalankan kedua-dua model pada setiap terjemahan dan menunjukkan di mana model bersetuju dan di mana ia berbeza. Panel persetujuan melaporkan jumlah model AI yang memproses teks tersebut, bahagian yang bersetuju, jumlah istilah yang dipertikaikan, dan berapa pantas konsensus dicapai.
Sejauh manakah keputusan ini terkini?
Keputusan ini merangkumi July 12 to August 8, 2026, jadi ia menerangkan versi Gemini dan Qwen yang beroperasi pada masa itu. Google mengumumkan Gemini 4 pada October 2026. Siri Qwen3.8 Alibaba tiba pada August 2026. Cadangan saya adalah untuk menjalankan semula panel tersebut sebelum bergantung pada angka ini untuk projek baharu.
Saya menjangkakan kaedah membandingkan teks yang serupa dengan margin untuk hingar akan kekal kukuh. Saya menjangkakan saiz jurang akan berubah. Saya akan menganggap mana-mana pasangan yang penerajunya bertukar pada penilaian baharu sebagai tanda bahawa jurang sebelum ini berada dalam lingkungan hingar.
Bagaimanakah saya akan memilih antara Qwen dan Gemini untuk sesuatu projek?
Pandangan saya adalah untuk memilih mengikut pasangan dan arah serta mengelak daripada membuat satu pilihan untuk keseluruhan projek. Secara praktikal, ini bermakna menganggap jurang di bawah 0.1 mata sebagai seri dan menjangkakan model yang mendahului akan berubah antara pasangan. Inilah susunan yang akan saya ikuti.
- Senaraikan setiap pasangan bahasa dalam projek tersebut dan tandakan arahnya.
- Semak jurang untuk setiap pasangan dalam artikel ini. Anggap jurang bawah 0.1 mata sebagai seri.
- Jika jurangnya lebih besar, mulakan dengan model yang mendahului dan uji sampel teks anda sendiri.
- Jika kandungan anda bergerak dalam kedua-dua arah, jangkakan pendahulu akan berubah antara pasangan.
- Semak semula apabila salah satu model mengeluarkan versi baharu.
Kedua-dua model berjalan bersama-sama 20 model lain pada setiap terjemahan di MachineTranslation.com. Versi yang dipersetujui oleh sebahagian besar daripadanya dikembalikan, jadi pilihan tidak perlu dibuat sekali sahaja untuk keseluruhan projek. Set lengkap keputusan model ada dalam ujian perbandingan model kami.
Soalan lazim
1. Adakah Qwen atau Gemini lebih baik untuk terjemahan?
Ia bergantung pada arahnya, kerana Qwen berada dalam lingkungan 0.1 mata daripada Gemini atau mendahului dalam 24 daripada 27 pasangan ke bahasa Inggeris. Gemini masih memperoleh skor lebih tinggi dalam 68 daripada 98 pasangan dalam skor 12 Julai hingga 8 Ogos 2026 MachineTranslation.com. Jurang puratanya ialah 0.08 mata daripada 10, jadi saya akan memilih mengikut pasangan.
2. Model Qwen yang manakah terbaik untuk terjemahan?
Saya tidak dapat memastikannya daripada data kami, kerana skor MachineTranslation.com menganggap Qwen sebagai satu model tanpa tag versi. Keluarga Qwen3.8 Alibaba mula berada di Hugging Face pada Ogos 2026, jadi kini terdapat beberapa versi. Sehingga skor memisahkannya, saya akan membandingkan versi pada sampel teks anda sendiri sebelum memilih satu untuk sesuatu projek.
3. Apakah beberapa alternatif kepada Gemini untuk terjemahan?
ChatGPT, Claude, DeepSeek, Qwen, Grok, dan Mistral AI semuanya berjalan di MachineTranslation.com. Dalam skor 12 Julai hingga 8 Ogos 2026 kami, Qwen berada dalam lingkungan 0.1 mata daripada Gemini atau mendahului dalam 24 daripada 27 pasangan ke bahasa Inggeris. Purata bahasa Perancis ke bahasa Inggeris Mistral AI berada 0.40 mata di atas Gemini. Alternatif yang tepat bergantung pada pasangan tersebut.
4. Adakah Gemini lebih baik daripada ChatGPT untuk terjemahan?
Ia bergantung pada pasangan bahasa, kerana tiada model AI tunggal yang menang dalam semua keadaan. Dalam pecahan bahasa Sepanyol ke bahasa Inggeris yang kami terbitkan, Gemini memenangi 31% segmen dan ChatGPT memenangi 21%. Bagi bahasa Perancis, tiada model yang menang dalam kedua-dua arah. Saya akan menyemak pasangan dan arah yang anda perlukan sebelum memilih antara kedua-duanya.
5. Adakah Gemini tepat untuk terjemahan?
Ya, kerana Gemini mencatatkan purata 9.06 daripada 10 merentasi 98 pasangan bahasa dalam skor July 12 to August 8, 2026 MachineTranslation.com. Ketepatan masih berbeza mengikut pasangan. Kelebihannya adalah paling besar daripada bahasa Inggeris, dan Qwen mendahuluinya lebih daripada 0.1 mata bagi 7 daripada 27 pasangan ke dalam bahasa Inggeris.