October 2, 2026
Qwen vs Grok: Model AI manakah yang menterjemah dengan lebih baik?
Qwen dan Grok kedua-duanya adalah model AI pelbagai guna, bukan alat khusus untuk terjemahan, dan kedua-duanya adalah sebahagian daripada kumpulan model yang dijalankan oleh MachineTranslation.com untuk setiap terjemahan. Hal ini penting untuk memahami perkara yang akan dibaca seterusnya. Ini adalah pandangan tentang cara dua model platform itu sendiri bersaing antara satu sama lain, dengan kaveat sebenar yang datang bersama data sebegini, dan bukan satu pertandingan antara dua pencabar luar dengan platform itu sendiri.
Apakah itu Qwen dan Grok?
Qwen ialah rangkaian model bahasa besar Alibaba, pada masa ini berada dalam generasi Qwen3.8, dan telah ditambahkan ke dalam kumpulan model MachineTranslation.com sebagai sebahagian daripada pengembangan berterusan platform tersebut. Grok ialah barisan model xAI, pada masa ini pada Grok 4.7 semasa artikel ini ditulis, setelah melalui beberapa keluaran sejak versi asal yang dibandingkan dalam artikel ini, dan menyertai platform tersebut secara berasingan. Kedua-dua model ini tidak dibina khusus untuk terjemahan. Kedua-duanya adalah sistem pelbagai guna yang kebetulan mengendalikan banyak bahasa sebagai sebahagian daripada keupayaan bahasa yang lebih luas, yang merupakan titik permulaan berbeza berbanding dengan platform yang dibina dan diuji khusus berdasarkan kualiti terjemahan.
Bagaimanakah perbandingan Qwen dan Grok pada data MachineTranslation.com sendiri?
Sepanjang 28 hari lalu bagi trafik platform, Grok memperoleh skor purata yang lebih tinggi berbanding Qwen: 9.26 daripada 10 berbanding 8.87. 10% terjemahan Grok dengan skor terburuk masih mencatatkan purata 9.2, manakala 10% skor terburuk Qwen jatuh kepada 7.6, satu jurang yang lebih besar pada tahap rendah daripada apa yang ditunjukkan oleh purata semata-mata.
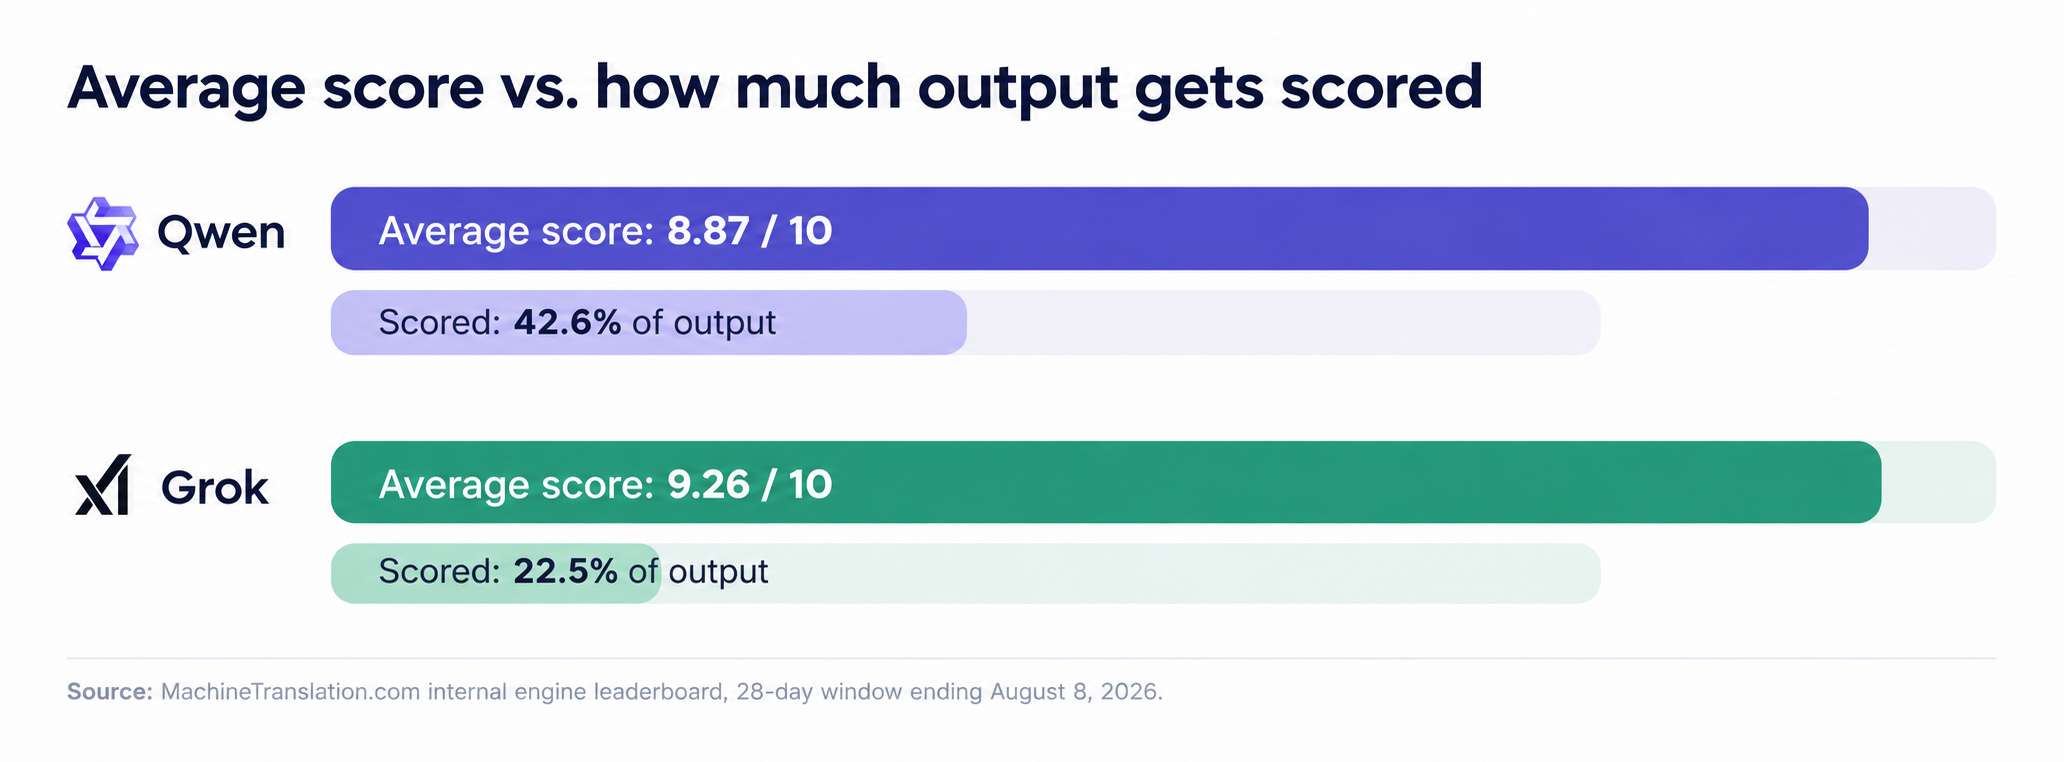
Skor purata Grok adalah lebih tinggi, tetapi ini berdasarkan pada penskoran kurang daripada satu perempat bagi outputnya, berbanding hampir separuh bagi Qwen. Kedua-dua bar ini menceritakan bahagian yang berbeza tentang kisah yang sama.
| Qwen | Grok | |
|---|---|---|
| Peratusan output yang diskor | 42.6% | 22.5% |
| Skor purata | 8.87 / 10 | 9.26 / 10 |
| 10% skor terbawah | 7.6 | 9.2 |
Sumber: Papan pendahulu enjin dalaman MachineTranslation.com, tetingkap 28 hari yang berakhir pada 8 Ogos 2026.
Adakah skor Grok yang lebih tinggi bermakna ia pilihan yang lebih baik?
Bukan berdasarkan itu sahaja. Grok digunakan jauh lebih jarang di platform ini berbanding Qwen, dan kurang daripada satu perempat terjemahannya mendapat skor, berbanding hampir separuh bagi Qwen. Sampel yang lebih kecil dan kurang mewakili boleh menjadikan purata kelihatan lebih baik atau lebih buruk berbanding volum yang sama seperti yang dilihat oleh Qwen. Pelaporan MachineTranslation.com sendiri mengenai data ini menganggap liputan penskoran sebagai batasan sebenar, bukan nota kaki: enjin yang diskor pada sebahagian kecil trafiknya belum diuji selengkap enjin yang diskor ke atas hampir separuh daripada outputnya.
Tafsiran yang jujur ialah angka Grok adalah memberangsangkan tetapi sampelnya lebih kecil. Angka Qwen secara puratanya lebih rendah tetapi bersandarkan kepada asas yang jauh lebih besar dan lebih mewakili. Kedua-dua fakta ini tidak membatalkan satu sama lain.
Bagaimana pula dengan liputan bahasa?
Sama ada Qwen mahupun Grok tidak menerbitkan senarai pasangan bahasa yang disahkan di mana prestasinya merosot, dan tiada ujian bebas wujud untuk mengesahkannya. Apa yang boleh dikatakan dengan yakin ialah kedua-dua model tidak dibina berasaskan kualiti terjemahan merentasi set bahasa khusus seperti platform terjemahan yang berdedikasi. MachineTranslation.com menguji dan menyokong lebih 270 bahasa secara langsung, yang mana ia merupakan dakwaan yang berbeza berbanding keupayaan pelbagai bahasa model tujuan umum yang meluas tetapi belum diuji.
Bagaimana MachineTranslation.com sebenarnya menggunakan Qwen dan Grok
MachineTranslation.com menjalankan Qwen, Grok, dan lebih daripada 20 model AI lain pada setiap terjemahan, kemudian memaparkan versi yang paling disepakati oleh model-model tersebut. Tiada model yang dikecualikan kerana mendapat skor purata yang lebih rendah. Menjalankan banyak model serentak bermakna ia dapat mengesan kes di mana model berskor lebih rendah secara puratanya masih dapat menterjemah ayat tertentu dengan betul yang gagal dilakukan oleh model berskor lebih tinggi. Prestasi Qwen juga terbahagi mengikut arah dan pasangan dalam cara yang wajar diketahui sebelum memilih model tunggal, diliputi dengan lebih mendalam dalam perbandingan Qwen vs DeepSeek oleh MachineTranslation.com. Untuk melihat lebih dekat bagaimana model-model ini diuji antara satu sama lain secara langsung, lihat ujian perbandingan model penuh MachineTranslation.com.
Soalan lazim
1. Adakah Qwen atau Grok lebih baik untuk terjemahan?
Berdasarkan data enjin 28 hari milik MachineTranslation.com sendiri, Grok mendapat skor purata yang lebih tinggi berbanding Qwen, 9.26 berbanding 8.87 daripada 10. Tetapi Grok diskor pada bahagian outputnya yang jauh lebih kecil dan kurang mewakili, jadi ini bukanlah perbandingan langsung yang jelas seperti ujian segmen yang sepadan.
2. Mengapakah Grok mempunyai skor purata yang lebih tinggi tetapi lebih sedikit terjemahan yang diskor?
Grok kurang kerap digunakan pada platform dan hanya sekitar 22.5% daripada outputnya yang diskor, berbanding 42.6% untuk Qwen. Sampel yang lebih kecil dan kurang mewakili boleh meningkatkan atau merendahkan purata, itulah sebabnya perbandingan ini harus dibaca sebagai petunjuk, bukan muktamad.
3. Adakah Qwen atau Grok menyokong lebih banyak bahasa?
Kedua-duanya ialah model AI pelbagai guna tanpa senarai had khusus bahasa yang diterbitkan dan disahkan. Tiada satu pun dibina khusus untuk terjemahan, yang mana ia berbeza daripada platform yang menguji dan menskor kualiti terjemahan merentas 270+ bahasa secara langsung, dan bukannya bergantung pada latihan pelbagai bahasa yang meluas sebagai pengganti kepada prestasi terjemahan yang diukur.
4. Adakah MachineTranslation.com bersaing dengan Qwen dan Grok?
Tidak. MachineTranslation.com menjalankan Qwen, Grok, dan lebih daripada 20 model AI lain pada setiap terjemahan dan memaparkan versi yang paling dipersetujui oleh model-model tersebut. Ia menguji dan menggabungkan model seperti ini dan bukannya bersaing dengan model-model tersebut sebagai sebuah modelnya yang tersendiri.
5. Model AI manakah yang disyorkan oleh MachineTranslation.com untuk terjemahan?
Tiada secara lalai. Model yang berbeza berprestasi secara berbeza mengikut pasangan bahasa dan jenis kandungan, dan jurang antara model-model ini boleh berlaku di mana-mana arah bergantung pada perkara yang diterjemahkan. Variasi itulah sebenarnya sebab mengapa platform ini menjalankan berbilang model pada setiap terjemahan dan bukannya memilih satu model sebagai pengesyoran tetap.