September 9, 2026
Qwen vs DeepSeek: ဘယ် AI မော်ဒယ်က ဘာသာပြန် ပိုကောင်းသလဲ။
ထပ်တူညီသော ဘာသာပြန် segment ၁၂,၀၀၀ ကို Qwen နှင့် DeepSeek တို့ဖြင့် စမ်းသပ်ကြည့်ရာတွင် ဘာသာစကားအစုံ အများစုတွင် DeepSeek က အနိုင်ရရှိသည်။ ဒါက အားလုံးတော့ မဟုတ်သေးပါဘူး။ ရလဒ်များကို ဘာသာပြန်ဆိုသည့် ဦးတည်ချက်အလိုက် ခွဲခြားကြည့်လျှင် တိကျသော ပုံစံတစ်ခု ပေါ်ထွက်လာသည်: အထူးသဖြင့် ပစ်မှတ်ဘာသာစကားမှာ အင်္ဂလိပ်ဖြစ်သည့်အခါ Qwen သည် ကွာဟချက်အများစုကို လျှော့ချနိုင်ပြီး တစ်ခါတစ်ရံတွင် ဦးဆောင်နိုင်ခဲ့သည်။ အင်္ဂလိပ်ဘာသာစကားမှ အခြားမည်သည့်ဘာသာစကားသို့မဆို ပြန်ဆိုရာတွင် DeepSeek က တစ်ခါမကျန်နီးပါး အနိုင်ရသည်။
သင်သည် ဘာသာစကား အတွဲတစ်ခုတည်းကို မဟုတ်ဘဲ ဘာသာစကား ဒါဇင်ပေါင်းများစွာဖြင့် အကြောင်းအရာများကို ဘာသာပြန်ဆိုနေပါက ယခုကဲ့သို့ ခွဲခြားထားမှုသည် တစ်ခုတည်းသော ခြုံငုံအနိုင်ရရှိသူထက် ပိုမိုအရေးကြီးပါသည်။
Qwen နှင့် DeepSeek ဆိုသည်မှာ ဘာလဲ။
Qwen သည် Alibaba ၏ ကြီးမားသော ဘာသာစကား မော်ဒယ် (LLM) မိသားစု ဖြစ်သည်။ လက်ရှိမျိုးဆက်မှာ ၂၀၂၆ ခုနှစ်၊ သြဂုတ်လတွင် ထွက်ရှိခဲ့သည့် Qwen3.8 ဖြစ်သည်: Qwen3.8-Max သည် parameter ပေါင်း ၂.၄ ထရီလီယံ ရှိသည့် API-သာရရှိသော flagship မော်ဒယ်ဖြစ်ပြီး၊ Qwen3.8-27B မှာမူ Apache 2.0 အောက်တွင် ရက်အနည်းငယ်အကြာ၌ ဖြန့်ချိခဲ့ပြီး၊ ကိုယ်ပိုင်ဆာဗာတွင် တင်သုံးလိုသည့် အဖွဲ့များအတွက် ရည်ရွယ်သော ပိုမိုသေးငယ်သည့် open-weight မော်ဒယ် ဖြစ်သည်။
DeepSeek သည် ဆန်းသစ်စွမ်းဆောင်ရည်များကို ကုန်ကျစရိတ် အနည်းငယ်မျှဖြင့် ယှဉ်ပြိုင်နိုင်သည့် mixture-of-experts မော်ဒယ်များကြောင့် လူသိများသော တရုတ် AI ဓာတ်ခွဲခန်းတစ်ခု ဖြစ်သည်။ ၎င်း၏ လက်ရှိမျိုးဆက်ဖြစ်သော DeepSeek V4 ကို ၂၀၂၆ ခုနှစ်၊ ဧပြီလတွင် ဗားရှင်းနှစ်မျိုးဖြင့် မိတ်ဆက်ခဲ့သည်: အရည်အသွေးကို အဓိကထားသည့် လုပ်ငန်းများအတွက် V4 Pro (စုစုပေါင်း parameter ၁.၆ ထရီလီယံ၊ token တစ်ခုချင်းစီအတွက် အသုံးပြုသည့် active parameter ၄၉ ဘီလီယံခန့်) နှင့် တုံ့ပြန်မှုမြန်ဆန်ရန် လိုအပ်သည့် လုပ်ငန်းများအတွက် V4 Flash (စုစုပေါင်း ၂၈၄ ဘီလီယံ၊ active parameter ၁၃ ဘီလီယံခန့်) တို့ ဖြစ်ကြသည်။ နှစ်ခုလုံးကို MIT လိုင်စင်ရ open weights အဖြစ် ဖြန့်ချိထားသည်။
Benchmark များသာမက ဘာသာပြန်ခြင်းတွင် Qwen နှင့် DeepSeek တို့သည် အမှန်တကယ် မည်သို့ နှိုင်းယှဉ်နိုင်သနည်း။
Qwen နှင့် DeepSeek နှိုင်းယှဉ်မှုအများစုသည် ယေဘုယျရည်ရွယ်ချက် benchmark များကို ကိုးကားကြသည်- coding၊ သင်္ချာ၊ ကျိုးကြောင်းဆင်ခြင်ခြင်း။ ၎င်းတို့ထဲမှ တစ်ခုမျှ ဘာသာပြန်အရည်အသွေးကို တိုက်ရိုက်မတိုင်းတာနိုင်သလို၊ မော်ဒယ်တစ်ခုစီကို မတူညီသော မူရင်းစာသားများပေါ်တွင် အသုံးပြုခြင်းက တိကျမှုကွာဟချက်သည် စာသားကိုယ်တိုင်၏ လိုအပ်ချက်ကြောင့်ဖြစ်သည် သို့မဟုတ် မဟုတ်သည်ကို ခွဲခြားသတ်မှတ်ရန် မဖြစ်နိုင်စေပါ။
MachineTranslation.com ၏ လွန်ခဲ့သည့် 28 ရက်အတွင်း ကိုယ်ပိုင် ဘာသာပြန်မှုပမာဏ (traffic) သည် ပိုမိုရှင်းလင်းသော အဖြေကို ပေးစွမ်းနိုင်သည်၊ အကြောင်းမှာ မော်ဒယ်နှစ်ခုလုံးသည် ထပ်တူညီသော မူရင်းစာသားကို ဘာသာပြန်ဆိုခဲ့ကြသောကြောင့် ဖြစ်သည်။ ဘာသာစကားအတွဲ 98 တွဲနှင့် ကိုက်ညီသော စာသားအပိုင်းအစ 12,000 ကျော်တွင် DeepSeek သည် အတွဲပေါင်း 83 တွဲတွင် ပိုမိုမြင့်မားသောရမှတ် ရရှိခဲ့ပြီး Qwen ကမူ 15 တွဲတွင် ပိုမိုမြင့်မားသောရမှတ် ရရှိခဲ့သည်။ ပစ်မှတ်ဘာသာစကား အင်္ဂလိပ်ဖြစ်သော အတွဲ 27 တွဲသို့ ကျဉ်းမြောင်းလိုက်ပါက ကွာဟချက်သည် သိသိသာသာ လျော့နည်းသွားသည် - DeepSeek က ယင်းတို့အနက် 63% (27 တွဲတွင် 17 တွဲ) ကို အနိုင်ရပြီး Qwen က 37% (27 တွဲတွင် 10 တွဲ) ကို အနိုင်ရသည်။ အင်္ဂလိပ်ဘာသာစကား မဟုတ်သော ကျန်ရှိသည့် အတွဲ 71 တွဲတွင်မူ DeepSeek က 92% (71 တွဲတွင် 66 တွဲ) အထိ အနိုင်ရရှိသည်။
ဘာသာပြန်ဆိုမှု ဦးတည်ချက်အလိုက် အနိုင်ရရှိမှုနှုန်း (ဘာသာစကားအတွဲ 98 တွဲ၊ တူညီသောစာသား)
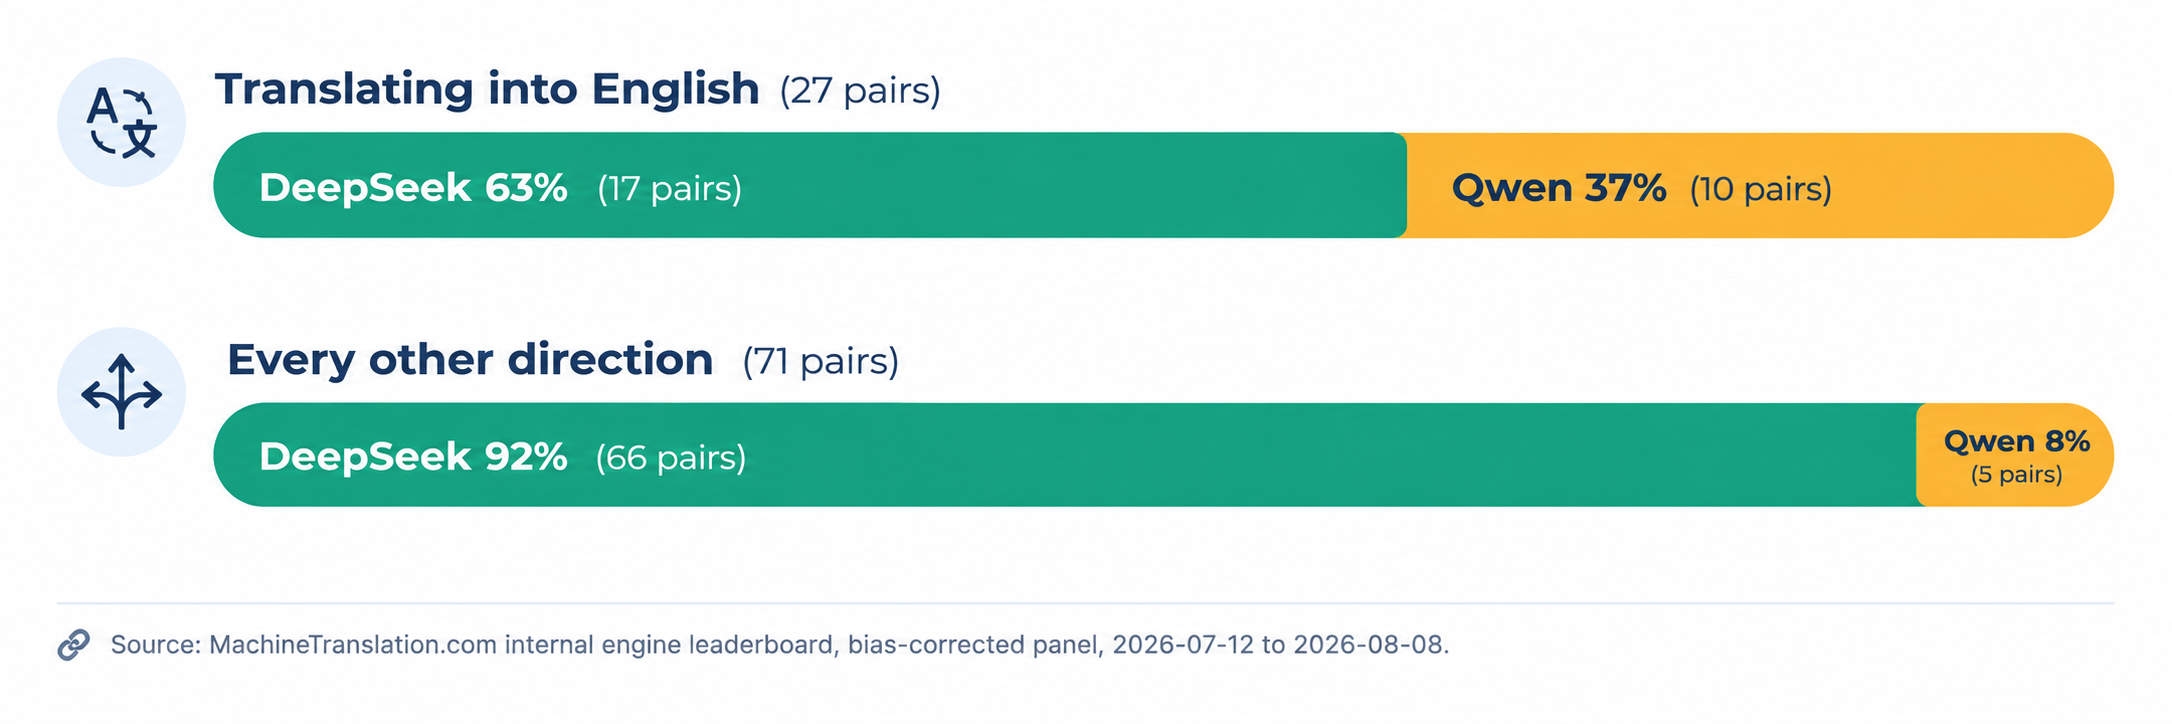
ခြုံငုံကြည့်လျှင် DeepSeek သည် ဘာသာစကားအတွဲအများစုတွင် အနိုင်ရရှိသည်။ Qwen ၏ ယှဉ်ပြိုင်နိုင်စွမ်းရှိသည့် နယ်ပယ်သည် ကျဉ်းမြောင်းသော်လည်း လက်တွေ့ကျသည် - အင်္ဂလိပ်ဘာသာသို့ ပြန်ဆိုရာတွင် အတွဲများ၏ သုံးပုံတစ်ပုံကျော်ကို ၎င်းက ရယူထားသည်။ ဒေတာ: MachineTranslation.com ၏ အတွင်းပိုင်းအင်ဂျင် ဦးဆောင်သူစာရင်း (bias-corrected panel)၊ July 12 to August 8, 2026။
ကိုက်ညီသော စာသားအပိုင်းအစတိုင်းရှိ အလေးပေးပျမ်းမျှနှုန်း (weighted average) အရ DeepSeek သည် 10 မှတ်တွင် 9.13 ရမှတ်ရှိပြီး Qwen သည် 8.98 ရမှတ်ရှိသည်။ ယင်းသည် တကယ့်ကွာဟချက်တစ်ခုဖြစ်သော်လည်း ညီတူညီမျှ ပျံ့နှံ့နေခြင်းမရှိပါ၊ သင့်အကြောင်းအရာများကို ဦးတည်ချက်တစ်ခုထက်မက ပြန်ဆိုရန်လိုအပ်ပါက ဤအချက်ကို သိထားခြင်းက ပိုမိုအသုံးဝင်သည်။ ဤသည်မှာ MachineTranslation.com က ၎င်း၏ မော်ဒယ်အပြည့်အစုံ နှိုင်းယှဉ်မှုစမ်းသပ်ခြင်းတစ်လျှောက်တွင် အသုံးပြုသည့် တိုက်ရိုက်ယှဉ်ပြိုင်မှုနည်းလမ်းအတိုင်းပင်ဖြစ်ပြီး၊ ဤအတွဲတစ်ခုတည်းအတွက်သာ မဟုတ်ပါ။
စုပေါင်းကိန်းဂဏန်းများသည် တစ်ဦးချင်းစီ၏ စမ်းသပ်မှုအခြေအနေများတွင်လည်း ကိုက်ညီမှုရှိသည်။ ပြင်သစ်စကားစု "Elle est directrice adjointe du département commercial" ကို စမ်းသပ်ရာတွင် DeepSeek နှင့် Qwen နှစ်ခုလုံးသည် "deputy director of commercial department" ဟူသော အင်္ဂလိပ်ဘာသာပြန်ဆိုချက်အတိုင်း ထပ်တူထွက်ပေါ်ခဲ့သည်။ ထို တိုက်ရိုက်စမ်းသပ်မှုရလဒ် ကို သင်ကိုယ်တိုင် တိုက်ရိုက် စစ်ဆေးနိုင်သည်။ "as soon as possible" ကို စပိန်ဘာသာသို့ ပြန်ဆိုရာတွင် စမ်းသပ်သည့်အခါ DeepSeek သည် မော်ဒယ်လေးခု၏ တူညီသောသဘောတူညီချက်ဖြစ်သည့် "se haga" အစား "esté hecho" ဟု ဖော်ပြကာ ကွဲထွက်သွားခဲ့ပြီး၊ ၎င်းမှာ အမှားတစ်ခုမဟုတ်ဘဲ ဖြစ်စဉ်နှင့် ရလဒ်ဆိုင်ရာ သဒ္ဒါကွာခြားချက်ကို ထင်ဟပ်စေသည့် အမှန်တကယ် ကွဲလွဲမှုဖြစ်ရပ် တစ်ခုဖြစ်သည်။
Qwen သည် အင်္ဂလိပ်ဘာသာသို့ ပြန်ဆိုရာတွင် အဘယ်ကြောင့် အထူးကောင်းမွန်နေရသနည်း။
ဒေတာသည် အဘယ်ကြောင့်ဖြစ်သည်ကို ရှင်းမပြနိုင်ဘဲ မည်သည့်နေရာတွင်ဖြစ်သည်ကိုသာ ဖော်ပြနိုင်သည်။ Qwen ၏ အင်္ဂလိပ်ဘာသာသို့ အကောင်းဆုံး ပြန်ဆိုနိုင်သော အတွဲအချို့မှာ တမီးလ်၊ တရုတ်၊ ပိုလန်၊ အီတလီနှင့် ဟီဘရူးတို့ ဖြစ်ကြပြီး ၎င်းတို့သည် ယေဘုယျအားဖြင့် မော်ဒယ်ဖန်တီးသူများ ရယူအသုံးပြုနိုင်သည့် ကြီးမားပြီး ကောင်းမွန်စွာ မှတ်တမ်းတင်ထားသော အင်္ဂလိပ်ဘာသာစကား လေ့ကျင့်ရေးဒေတာအစုစု (training corpora) ရှိသည့် မူရင်းဘာသာစကားများ ဖြစ်ကြသည်။ ထိုဦးတည်ရာတစ်ခုအပြင်၊ DeepSeek ၏ အားသာချက်မှာ နေရာတိုင်းနီးပါးတွင် ရှိနေသည် - အင်္ဂလိပ်ဘာသာစကားမှ ပြန်ဆိုခြင်းနှင့် အင်္ဂလိပ်မဟုတ်သော ဘာသာစကားအတွဲများ အချင်းချင်းကြား ပြန်ဆိုခြင်းတို့တွင်လည်း အတူတူပင်ဖြစ်သည်။
ယင်းက ဖော်ပြနေသည်မှာ မည်သည့်မော်ဒယ်ကိုမျှ စံသတ်မှတ်ချက်တစ်ခုအဖြစ် ယေဘုယျသတ်မှတ်၍ မရနိုင်ကြောင်းပင် ဖြစ်သည်။ စပိန်ဘာသာစကားမှ ကုန်ပစ္စည်းစာရင်းများကို ဘာသာစကား ခြောက်မျိုးသို့ ဘာသာပြန်ဆိုပြီး တရုတ်ဘာသာစကားဖြင့် ရေးသားထားသော အကူအညီတောင်းခံလွှာတစ်ခုကို အင်္ဂလိပ်ဘာသာသို့ ပြန်ဆိုရာတွင် တွေ့ရှိခဲ့သည့် လုပ်ဆောင်ရည်အဆင့်သတ်မှတ်ချက်အတိုင်း ရရှိရန် မျှော်လင့်နေသော အဖွဲ့တစ်ခုသည် မှားယွင်းသော ဦးတည်ရာမှ မှားယွင်းသော သင်ခန်းစာကို အသုံးချနေခြင်း ဖြစ်ပါလိမ့်မည်။ ယင်းသည် MachineTranslation.com ၏ စပိန်မှ အင်္ဂလိပ် မော်ဒယ် ခွဲခြမ်းစိတ်ဖြာမှုတွင် တွေ့ရသည့် အချိုးမညီမှုနှင့် အတူတူပင်ဖြစ်ပြီး၊ ထိုခွဲခြမ်းစိတ်ဖြာမှုတွင် ဦးဆောင်နေသော မော်ဒယ်များသည် ပြောင်းပြန်ဦးတည်ချက်တွင် ဦးဆောင်နေသော မော်ဒယ်များနှင့် တူညီမှုမရှိကြပေ။
Are Qwen and DeepSeek free and open-source?
လိုင်စင်သတ်မှတ်ချက်များသည် တစ်ခုနှင့်တစ်ခု မတူညီဘဲ ကွဲပြားသည်။ DeepSeek သည် V4 Pro နှင့် V4 Flash နှစ်ခုလုံးကို အခွင့်ပြုဆုံး open-source စည်းကမ်းချက်များထဲမှ တစ်ခုဖြစ်သည့် MIT အောက်တွင် လိုင်စင်ထုတ်ပေးထားသဖြင့် နှစ်ခုလုံးကို ကန့်သတ်ချက်မရှိဘဲ ကိုယ်ပိုင်ဆာဗာတွင် အခမဲ့ ထားရှိအသုံးပြုနိုင်ပါသည်။ Qwen ကမူ ကွဲပြားပါသည် - Qwen3.8-27B ကို Apache 2.0 အောက်တွင် ဖြန့်ချိထားပြီး ကိုယ်ပိုင်ဆာဗာတွင် အခမဲ့ ထားရှိအသုံးပြုနိုင်သော်လည်း၊ အဓိက မော်ဒယ်ဖြစ်သော Qwen3.8-Max မှာမူ closed-source ဖြစ်ပြီး API သီးသန့်သာ ရရှိနိုင်ကာ Alibaba ၏ ကိုယ်ပိုင်လိုင်စင်အောက်တွင် ရှိနေသည်။
လက်တွေ့တွင်မူ ယင်းက အရည်အသွေး အဆင့်အတန်းနှစ်ခုလုံးတွင် လုံးဝ open-weight ဖြစ်ပြီး MIT လိုင်စင်ရွေးချယ်ခွင့်သည် DeepSeek ဘက်တွင် ရှိနေသည်ဟု ဆိုလိုခြင်း ဖြစ်သည်။ Qwen ဘက်တွင်မူ open-weight ကို အသုံးပြုရန် ရွေးချယ်ခြင်းသည် အဓိက မော်ဒယ်ကို စွန့်လွှတ်ရမည်ဟု ဆိုလိုပါသည်။
What do Qwen and DeepSeek cost to run at scale?
၂၀၂၆ ခုနှစ် မေလတွင် DeepSeek ၏ ကုန်ကျစရိတ်ကို အမြဲတမ်း လျှော့ချပေးခဲ့ပြီးနောက် ၎င်း၏ လက်ရှိထုတ်ပြန်ထားသော API နှုန်းထားများမှာ V4 Pro အတွက် output token တစ်သန်းလျှင် $0.435 per million input tokens (cache miss) and $0.87 ဖြစ်ပြီး၊ latency နည်းပါးစေရန် အကောင်းဆုံး ပြင်ဆင်ထားသော V4 Flash အဆင့်အတွက်မူ ဈေးနှုန်း ပိုမိုသက်သာသည်။
အိမ်ရှင်ဆာဗာသုံး API (hosted API) ကို အသုံးပြုမည့်အစား မော်ဒယ်တစ်ခုခုကို ကိုယ်ပိုင်ဆာဗာတွင် ထားရှိအသုံးပြုမည့် (self-hosting) အဖွဲ့များအတွက် ကုန်ကျစရိတ် နှိုင်းယှဉ်ချက်သည် GPU အခြေခံအဆောက်အအုံပေါ်သို့ လုံးဝ ပြောင်းလဲသွားမည်ဖြစ်ပြီး token တစ်ခုချင်းစီအလိုက် ပေးရသည့် နှုန်းထားထက် parameter အရေအတွက်နှင့် သက်ဝင်လှုပ်ရှားနေသော parameter ထိရောက်မှု (active-parameter efficiency) ပေါ်တွင်သာ မူတည်သွားမည် ဖြစ်သည်။
Is either model safe enough for legal, medical, or regulated content?
မည်သည့်မော်ဒယ်ကမျှ ဘာသာပြန်ခြင်းဆိုင်ရာ သီးသန့် ဘေးကင်းလုံခြုံမှု ထောက်ခံချက်များကို ထုတ်ပြန်ထားခြင်း မရှိသလို၊ အထွေထွေသုံး ဘေးကင်းလုံခြုံမှုဆိုင်ရာ စံနှုန်းများသည်လည်း စည်းမျဉ်းသတ်မှတ်ထားသော အကြောင်းအရာများတွင် အရေးကြီးသည့် ပျက်ကွက်မှုပုံစံများ (ဥပမာ - ဆေးညွှန်းလွဲမှားစွာ ဘာသာပြန်ဆိုမိခြင်း၊ တာဝန်ယူမှုဆိုင်ရာ အပိုဒ်ခွဲ ပြောင်းလဲသွားခြင်း၊ မကိုက်ညီသော ဥပဒေရေးရာ ဝေါဟာရများ ဖြစ်ပေါ်ခြင်း) ကို စမ်းသပ်စစ်ဆေးခြင်း မရှိပါ။ MachineTranslation.com ၏ ကိုယ်ပိုင်စမ်းသပ်မှုတွင် မော်ဒယ်နှစ်ခုလုံးက အထွေထွေအရည်အသွေးစံနှုန်းများတွင် ရမှတ်ကောင်းများ ရရှိခဲ့ကြသော်လည်း ဥပဒေနှင့် ဆေးဘက်ဆိုင်ရာ ဘာသာစကားများတွင် မတူညီသော အတိုင်းအတာများရှိသည့် မတူညီသော ဥပဒေရေးရာ ဝေါဟာရများကို အသုံးပြုခဲ့သည့် အခြေအနေများ အပါအဝင် ဤကဲ့သို့သော မော်ဒယ်များအကြား ကွဲလွဲမှုမျိုးကို အတိအကျ တွေ့ရှိခဲ့ရသည်။
စာချုပ်များ၊ လူဝင်မှုကြီးကြပ်ရေးဆိုင်ရာ စာရွက်စာတမ်းများ သို့မဟုတ် ဆေးဘက်ဆိုင်ရာ အကြောင်းအရာများအတွက် မည်သည့်မော်ဒယ်က ထုတ်လုပ်သည်ဖြစ်စေ AI တစ်ခုတည်း၏ ရလဒ်ကို အပေါ်ယံကြည့်၍ ယုံကြည်မည့်အစား မော်ဒယ်တစ်ခုခု၏ ထွက်ပေါ်လာသော ရလဒ်ကို လူသားဖြင့် စစ်ဆေးအတည်ပြုခြင်း အဆင့်နှင့် ပေါင်းစပ်လုပ်ဆောင်သင့်သည့် အကြောင်းရင်းပင် ဖြစ်သည်။
အကယ်၍ သင်သည် ဘာသာစကား အများအပြားသို့ တစ်ပြိုင်နက်တည်း ဒေသအလိုက် လိုက်လျောညီထွေဖြစ်အောင် ပြောင်းလဲပြင်ဆင်နေခြင်း (localization) ဆိုပါက ယင်းသည် အဘယ်အရာကို ဆိုလိုပါသနည်း။
ဘာသာစကားအတွဲတစ်ခုတည်းအပေါ် အခြေခံထားသည့် နှိုင်းယှဉ်ချက်တစ်ခုသည် နံပါတ် ၄၀ မြောက် ဘာသာစကားအတွဲအကြောင်း ဘာမျှ ပြောပြနိုင်မည်မဟုတ်ပါ။ ယခုဖော်ပြထားသော အင်္ဂလိပ်သို့ ပြန်ဆိုခြင်း/အင်္ဂလိပ်မှ ပြန်ဆိုခြင်း ကွဲပြားမှုသည် ထိုကဲ့သို့သော အတိုင်းအတာဖြင့် အထူးတလည် စမ်းသပ်ခဲ့ခြင်းကြောင့် ဘာသာစကား အတွဲ ၉၈ တွဲ နမူနာတစ်လျှောက်လုံးတွင် တည်ရှိနေခြင်းဖြစ်သည် - Qwen နှင့် DeepSeek နှိုင်းယှဉ်မှု အများစုတွင် လုပ်ဆောင်လေ့ရှိသည့် အင်္ဂလိပ်မှ စပိန်သို့ စမ်းသပ်မှုတစ်ခုတည်းကိုသာ ပြုလုပ်မည်ဆိုပါက DeepSeek က သိသိသာသာ သာလွန်နေသည်ကို ပြသနိုင်မည်ဖြစ်သော်လည်း Tamil၊ Polish သို့မဟုတ် Hebrew ဘာသာစကားများ ပါဝင်လာသည့်အခါ မည်သို့ဖြစ်လာမည်ကိုမူ မည်သည့်အရာမျှ ဖော်ပြနိုင်မည် မဟုတ်ပေ။
ယင်းသည် ကြီးမားသော ဘာသာစကား ပြန်ဆိုခြင်းဆိုင်ရာ အစီအစဉ်တစ်ခုကို ပုံသေအားဖြင့် မော်ဒယ်တစ်ခုတည်း၏ ရလဒ်အပေါ်တွင်သာ ကန့်သတ်မထားသင့်ကြောင်း လက်တွေ့ကျကျ စောဒကတက်နိုင်သည့် အချက်ပင် ဖြစ်သည်။ MachineTranslation.com သည် ဘာသာပြန်ဆိုမှုတိုင်းအတွက် Qwen နှင့် DeepSeek တို့အပြင် အခြားသော မော်ဒယ်ပေါင်း ၂၀ ကျော်ကိုပါ အသုံးပြုပြီး ထိုမော်ဒယ်များ အများဆုံး သဘောတူညီကြသည့် ရလဒ်ကို ဖော်ထုတ်ပြသပေးသဖြင့် ဘာသာစကား ၆၈ မျိုးဖြင့် ထုတ်ဝေမှုတစ်ခုသည် တစ်စုံတစ်ယောက်က ပထမဆုံး စမ်းသပ်ခဲ့သည့် ဘာသာစကားတွဲတစ်ခုတည်းတွင် အနိုင်ရသွားသည့် မည်သည့်မော်ဒယ်အပေါ်တွင်မျှသာ လုံးလုံးလျားလျား မူတည်နေမည် မဟုတ်ပါ။ ရလဒ်တိုင်းအတွက် ပလက်ဖောင်းပေါ်တွင် ဖော်ပြပေးထားသော ဘာသာပြန်ဆိုမှုအလိုက် မော်ဒယ် ခွဲခြမ်းစိတ်ဖြာမှုတွင် မည်သည့်မော်ဒယ်များက သဘောတူညီမှုရှိပြီး မည်သည့်မော်ဒယ်များက ကွဲလွဲနေသည်ကို အတိအကျ ကြည့်ရှုနိုင်ပါသည်။
ဘာသာပြန်ဆိုမှုတိုင်းကို Qwen သို့မဟုတ် DeepSeek တစ်ခုတည်းက ပံ့ပိုးပေးနိုင်သည်ထက် ပိုမိုကျယ်ပြန့်သော မော်ဒယ်အမျိုးမျိုးနှင့် တိုက်ဆိုင်စစ်ဆေးပေးပါသည်၊ ယင်းသည် သင့်အကြောင်းအရာသည် ဦးတည်ချက်တစ်ခုတည်းသို့သာ ဦးတည်မနေတော့သည့်အခါ မည်သို့ဖြစ်လာမည်နည်းဟူသည့်အချက်အတွက် တိုက်ရိုက်အဖြေပင် ဖြစ်သည်။
မကြာခဏ မေးလေ့ရှိသော မေးခွန်းများ
1. ဘာသာပြန်ရန်အတွက် Qwen နှင့် DeepSeek မည်သည်က ပိုကောင်းပါသနည်း။
တူညီသော မူရင်းစာသားအပေါ် စမ်းသပ်ထားသည့် ဘာသာစကား အတွဲ ၉၈ တွဲအနက် ၈၃ တွဲတွင် DeepSeek က ပိုမိုမြင့်မားသော ရမှတ်ကို ရရှိခဲ့သည်။ Qwen ၏ အနိုင်ရမှုများသည် သီးသန့်ဦးတည်ချက်တစ်ခုဖြစ်သည့် အင်္ဂလိပ်ဘာသာစကားသို့ ပြန်ဆိုခြင်းတွင် စုပြုံနေပြီး ထိုဦးတည်ချက်၌ သုံးပုံတစ်ပုံခန့် အနိုင်ရရှိခဲ့သည်။ အခြားသော ဦးတည်ချက်အားလုံးတွင် DeepSeek သည် ၉၀ ရာခိုင်နှုန်းကျော် အနိုင်ရရှိခဲ့သည်။
2. Qwen ကို အခမဲ့ အသုံးပြုနိုင်ပါသလား။
Qwen3.8-27B သည် Apache 2.0 အောက်တွင် open-weight ဖြစ်ပြီး ကိုယ်ပိုင်ဆာဗာတွင် အခမဲ့ ထားရှိအသုံးပြုနိုင်ပါသည်။ အဓိကမော်ဒယ် Qwen3.8-Max မှာမူ closed-source ဖြစ်ပြီး Alibaba Cloud ၏ အခပေး API မှတစ်ဆင့်သာ ရရှိနိုင်ပါသည်။
3. DeepSeek ကို အခမဲ့ သုံးနိုင်ပါသလား။
ဟုတ်ကဲ့။ DeepSeek V4 Pro နှင့် V4 Flash နှစ်မျိုးလုံးကို MIT-licensed open weights ဖြင့် ပံ့ပိုးပေးထားသဖြင့် လိုင်စင်ကုန်ကျစရိတ်မရှိဘဲ နှစ်သက်ရာတစ်ခုကို self-host ပြုလုပ်နိုင်ပါသည်။ မိမိတို့၏ ကိုယ်ပိုင် infrastructure ကို မစီမံခန့်ခွဲလိုသော အဖွဲ့များအတွက် DeepSeek က အခပေး API ကိုလည်း ကမ်းလှမ်းထားပါသည်။
4. Qwen နှင့် DeepSeek တွင် မည်သည့်အရာက ပိုမြန်သနည်း။
DeepSeek V4 Flash ကို latency နည်းပါးစေရန် သီးသန့်ထုတ်လုပ်ထားပြီး V4 Pro ၏ active parameters 49 billion နှင့် နှိုင်းယှဉ်ပါက token တစ်ခုလျှင် active parameters 13 billion ရှိပါသည်။ Qwen ၏ အလားတူ ပိုမိုပေါ့ပါးသော ရွေးချယ်စရာဖြစ်သည့် Qwen3.8-27B သည် mixture-of-experts မဟုတ်ဘဲ dense ဖြစ်သောကြောင့် အရည်အသွေးတူညီသော်လည်း ယေဘုယျအားဖြင့် token တစ်ခုချင်းအလိုက် ပိုမိုနှေးကွေးစေပါသည်။
5. Qwen နှင့် DeepSeek ကို ဘာသာပြန်ရန်အတွက် တွဲဖက်သုံးနိုင်ပါသလား။
ဟုတ်ကဲ့။ MachineTranslation.com သည် ဘာသာပြန်ဆိုမှုတိုင်းအတွက် ဤ model နှစ်ခုအပြင် အခြား model ပေါင်း 20 ကျော်ကိုပါ သုံးစွဲပြီး ၎င်းတို့ အကိုက်ညီဆုံးဖြစ်သည့် ဗားရှင်းကို ဖော်ပြပေးသောကြောင့် သတ်မှတ်ထားသော ဘာသာစကားအတွဲအတွက် ပိုကောင်းမည့် model ဖြစ်ပါစေကြောင်း မျှော်လင့်ပြီး model တစ်ခုတည်းကိုသာ ရွေးချယ်ရသည့် အခက်အခဲ မရှိတော့ပါ။
6. Qwen နှင့် DeepSeek ၏ လိုင်စင်သတ်မှတ်ချက်များအကြား မည်သည့်ကွာခြားချက် ရှိသနည်း။
DeepSeek သည် ၎င်း၏ V4 မူကွဲနှစ်ခုလုံးကို ရရှိနိုင်သမျှတွင် ခွင့်ပြုချက်အပေးဆုံး open-source လိုင်စင်များထဲမှ တစ်ခုဖြစ်သည့် MIT အောက်တွင် လိုင်စင်ချထားပေးပါသည်။ Qwen ကမူ ၎င်း၏ ထုတ်ကုန်များကို ခွဲခြားထားပါသည်— Qwen3.8-27B ကဲ့သို့ သေးငယ်သော model များကို Apache 2.0 အောက်တွင် ပံ့ပိုးပေးထားသော်လည်း အဓိက flagship ဖြစ်သည့် Qwen3.8-Max မှာမူ သီးသန့်လိုင်စင် (custom license) အောက်တွင် closed အဖြစ်သာ ရှိနေပါသည်။