October 2, 2026
Qwen နှင့် Grok: မည်သည့် AI မော်ဒယ်က ဘာသာပြန် ပိုကောင်းသနည်း။
Qwen နှင့် Grok တို့သည် ဘာသာပြန်ခြင်းအတွက် သီးသန့်ထုတ်လုပ်ထားသော ကိရိယာများမဟုတ်ဘဲ အထွေထွေသုံး AI မော်ဒယ်များဖြစ်ကြပြီး ၎င်းတို့နှစ်ခုစလုံးသည် MachineTranslation.com မှ ဘာသာပြန်ဆိုမှုတိုင်းတွင် အသုံးပြုသည့် မော်ဒယ်များအစုအဝေးတွင် ပါဝင်သည်။ အောက်ပါအကြောင်းအရာများကို နားလည်ရန်အတွက် ၎င်းသည် အရေးကြီးပါသည်။ ၎င်းသည် ပြင်ပစိန်ခေါ်သူနှစ်ခုနှင့် ပလက်ဖောင်းကိုယ်တိုင်တို့ကြား ယှဉ်ပြိုင်မှုမဟုတ်ဘဲ၊ ပလက်ဖောင်းရှိ ကိုယ်ပိုင်မော်ဒယ်နှစ်ခုက တစ်ခုနှင့်တစ်ခု မည်သို့စွမ်းဆောင်သည်ကို ထိုသို့သော ဒေတာမျိုးတွင် ပါဝင်လေ့ရှိသည့် အမှန်တကယ် သတိပြုစရာများနှင့်အတူ လေ့လာထားခြင်းဖြစ်သည်။
Qwen နှင့် Grok ဆိုသည်မှာ အဘယ်နည်း။
Qwen သည် Alibaba ၏ large language မော်ဒယ်များအုပ်စုဖြစ်ပြီး၊ လက်ရှိတွင် ၎င်း၏ Qwen3.8 မျိုးဆက်သို့ ရောက်ရှိနေကာ ပလက်ဖောင်း၏ လက်ရှိတိုးချဲ့မှုလုပ်ငန်းစဉ်၏ တစ်စိတ်တစ်ပိုင်းအနေဖြင့် MachineTranslation.com ၏ မော်ဒယ်များအစုအဝေးသို့ ထည့်သွင်းထားခြင်းဖြစ်သည်။ Grok သည် xAI ၏ မော်ဒယ်အမျိုးအစားဖြစ်ပြီး၊ ဤဆောင်းပါးတွင် မူလက နှိုင်းယှဉ်ထားသောဗားရှင်းမှစ၍ ဗားရှင်းအမျိုးမျိုး ထွက်ရှိခဲ့ပြီးနောက် ဤစာကိုရေးသားချိန်တွင် Grok 4.7 သို့ ရောက်ရှိနေကာ၊ ပလက်ဖောင်းသို့ သီးခြားစီ ဝင်ရောက်လာခြင်းဖြစ်သည်။ မည်သည့်မော်ဒယ်ကမျှ ဘာသာပြန်ဆိုရန်အတွက် သီးသန့်တည်ဆောက်ထားခြင်း မဟုတ်ပါ။ နှစ်ခုစလုံးသည် ပိုမိုကျယ်ပြန့်သော ဘာသာစကားစွမ်းရည်၏ တစ်စိတ်တစ်ပိုင်းအနေဖြင့် ဘာသာစကားများစွာကို ကိုင်တွယ်ဖြေရှင်းပေးသော အထွေထွေသုံး စနစ်များဖြစ်ပြီး၊ ၎င်းသည် ဘာသာပြန်အရည်အသွေးအတွက် သီးသန့်တည်ဆောက်ကာ စမ်းသပ်ထားသော ပလက်ဖောင်းတစ်ခုနှင့် မတူညီသော စတင်မှုအမှတ်ဖြစ်သည်။
MachineTranslation.com ၏ ကိုယ်ပိုင်ဒေတာပေါ်တွင် Qwen နှင့် Grok တို့ မည်သို့ ကွာခြားသနည်း။
လွန်ခဲ့သော ၂၈ ရက်အတွင်း ပလက်ဖောင်းအသုံးပြုမှုအရ၊ ပျမ်းမျှအားဖြင့် Grok သည် Qwen ထက် ရမှတ်ပိုများခဲ့သည်- ၁၀ မှတ်တွင် Qwen က ၈.၈၇ ရရှိချိန်တွင် Grok က ၉.၂၆ ရရှိခဲ့သည်။ Grok ၏ ရမှတ်အနည်းဆုံး ၁၀% သော ဘာသာပြန်ဆိုမှုများတွင်ပင် ပျမ်းမျှ ၉.၂ ရရှိခဲ့သော်လည်း၊ Qwen ၏ ရမှတ်အနည်းဆုံး ၁၀% သည် ၇.၆ အထိ ကျဆင်းသွားခဲ့ပြီး ၎င်းသည် ပျမ်းမျှရမှတ်အရ တွေ့ရသည်ထက် အနိမ့်ပိုင်း၌ ပိုမိုကြီးမားသော ကွာဟချက်ဖြစ်သည်။
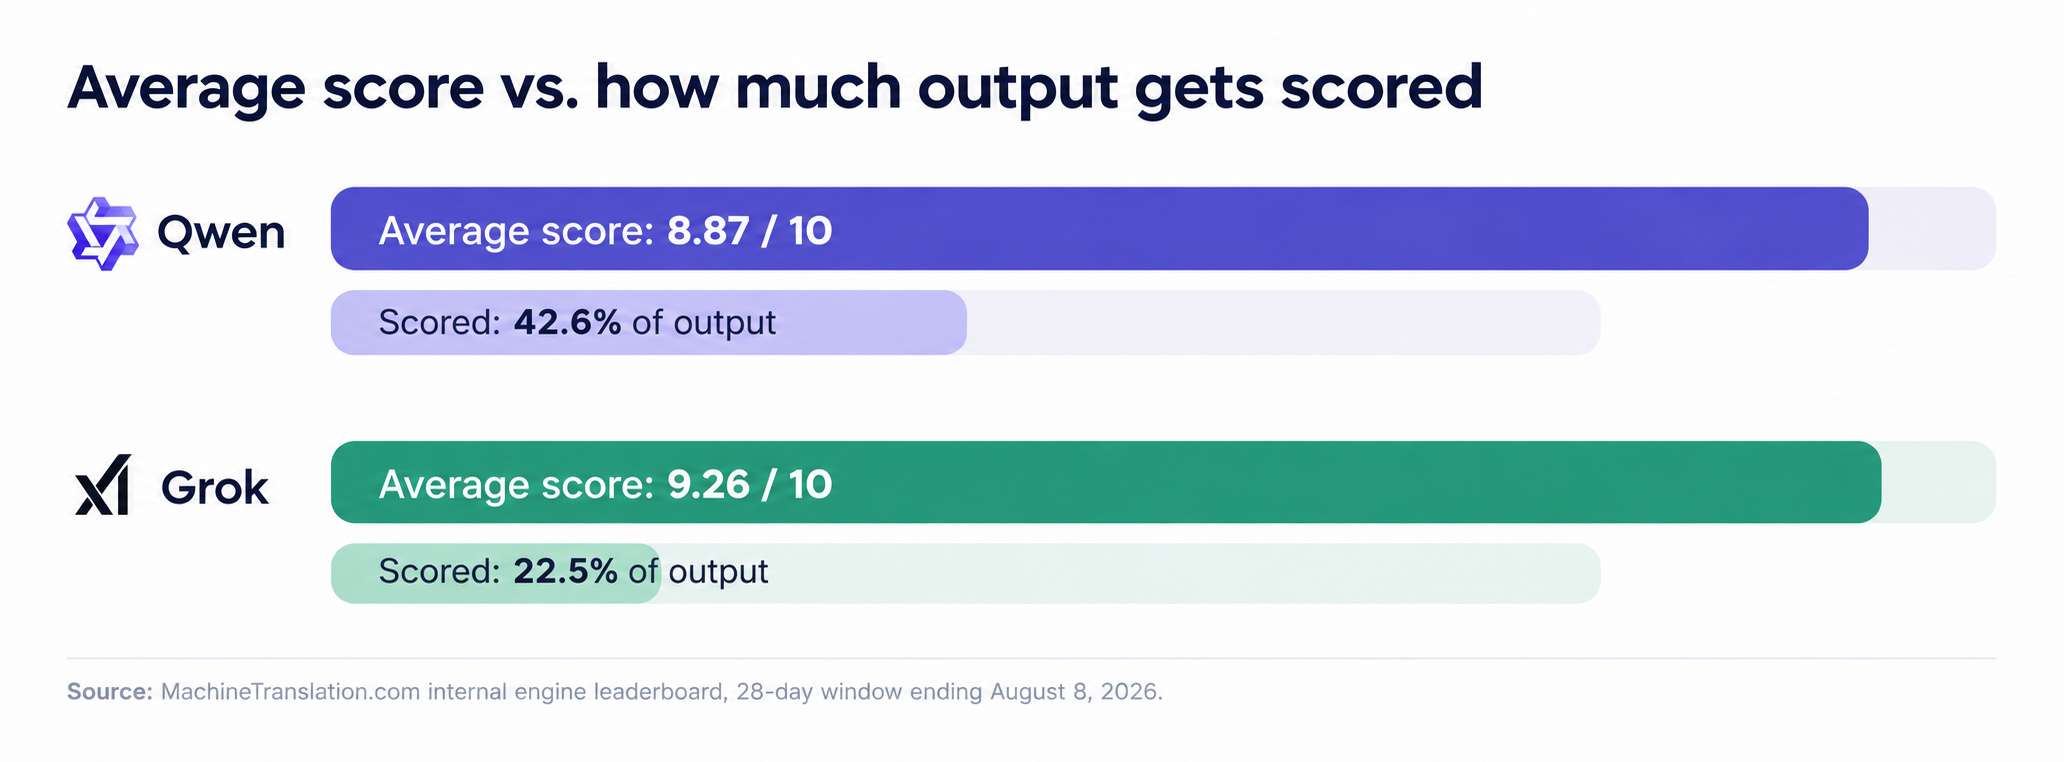
Grok ၏ ပျမ်းမျှရမှတ် ပိုများသော်လည်း၊ ၎င်း၏ ရလဒ်များ၏ လေးပုံတစ်ပုံအောက်သာ ရမှတ်ပေးခံရခြင်းအပေါ် အခြေခံထားပြီး Qwen အတွက်မူ ထက်ဝက်နီးပါး ရမှတ်ပေးခံရသည်။ ဇယားတိုင်နှစ်ခုသည် တူညီသော ဇာတ်လမ်းတစ်ပုဒ်၏ မတူညီသော အပိုင်းများကို ပြောပြနေသည်။
| Qwen | Grok | |
|---|---|---|
| ရမှတ်ပေးခံရသော ရလဒ်ရာခိုင်နှုန်း | 42.6% | 22.5% |
| ပျမ်းမျှရမှတ် | 8.87 / 10 | 9.26 / 10 |
| အနိမ့်ဆုံး ရမှတ် 10% | 7.6 | 9.2 |
အရင်းအမြစ်- MachineTranslation.com ၏ အတွင်းပိုင်းအင်ဂျင် အမှတ်ပေးဇယား၊ August 8, 2026 တွင် ပြီးဆုံးသော 28 ရက်တာ ကာလ။
Grok ၏ ရမှတ်ပိုမြင့်ခြင်းက ၎င်းသည် ပိုမိုကောင်းမွန်သော ရွေးချယ်မှုဖြစ်သည်ဟု ဆိုလိုသလား။
ဒါချည်းသက်သက်တော့ မဟုတ်ပါ။ ပလက်ဖောင်းပေါ်တွင် Grok ကို အသုံးပြုမှုသည် Qwen ထက် များစွာပိုနည်းပြီး Qwen ၏ ဘာသာပြန်ဆိုမှု ထက်ဝက်နီးပါးမှာ အမှတ်ပေးခံရသော်လည်း Grok ၏ ဘာသာပြန်ဆိုမှုများတွင် လေးပုံတစ်ပုံအောက်သာ အမှတ်ပေးခံရပါသည်။ ပိုသေးငယ်ပြီး ကိုယ်စားပြုမှုအားနည်းသော နမူနာတစ်ခုကြောင့် ရရှိလာသည့် ပျမ်းမျှရမှတ်သည် Qwen လက်ခံရရှိသည့် ပမာဏတူနေရာတွင် ရှိသင့်သည်ထက် ပိုကောင်းနေနိုင်သလို ပိုဆိုးနေနိုင်ပါသည်။ ဤဒေတာအပေါ် MachineTranslation.com ၏ ကိုယ်ပိုင်အစီရင်ခံတင်ပြချက်က အမှတ်ပေးမှုလွှမ်းခြုံနိုင်စွမ်းကို အောက်ခြေမှတ်စုတစ်ခုအဖြစ်မဟုတ်ဘဲ အမှန်တကယ် ကန့်သတ်ချက်တစ်ခုအဖြစ် သတ်မှတ်ထားသည်- ၎င်း၏အသုံးပြုမှု အနည်းငယ်ပေါ်တွင်သာ အမှတ်ပေးခံရသော အင်ဂျင်တစ်ခုသည် ၎င်း၏ရလဒ်ထက်ဝက်နီးပါးအပေါ် အမှတ်ပေးခံရသော အင်ဂျင်တစ်ခုလောက် စေ့စပ်သေချာစွာ စမ်းသပ်ခံထားရခြင်း မရှိပါ။
ပွင့်ပွင့်လင်းလင်း ပြောရလျှင် Grok ၏ ကိန်းဂဏန်းများသည် အလားအလာကောင်းသော်လည်း ပိုနည်းပါသည်။ Qwen ၏ ပျမ်းမျှရမှတ်များက ပိုနိမ့်သော်လည်း ပိုမိုကြီးမားပြီး ပိုမိုကိုယ်စားပြုနိုင်သော အခြေခံပေါ်တွင် တည်ရှိသည်။ မည်သည့်အချက်ကမျှ တစ်ခုနှင့်တစ်ခု အစားထိုးပယ်ဖျက်၍ မရပါ။
ဘာသာစကား လွှမ်းခြုံမှုအပိုင်းမှာကော ဘယ်လိုလဲ။
Qwen နှင့် Grok နှစ်ခုစလုံးသည် မည်သည့် ဘာသာစကားတွဲများတွင် စွမ်းဆောင်ရည်ကျဆင်းသွားသည်ကို အတည်ပြုထားသော စာရင်းထုတ်ပြန်ထားခြင်းမရှိသည့်အပြင် ၎င်းကို အတည်ပြုရန် လွတ်လပ်သော စမ်းသပ်မှုမျိုးလည်း မရှိပါ။ ယုံကြည်မှုအပြည့်ဖြင့် ပြောနိုင်သည့်အချက်မှာ အဆိုပါ မော်ဒယ်နှစ်ခုစလုံးသည် သီးသန့်ဘာသာပြန်ပလက်ဖောင်းတစ်ခုကဲ့သို့ သတ်မှတ်ထားသော ဘာသာစကားအစုအဝေးတစ်ခုအတွင်း ဘာသာပြန်အရည်အသွေးကို အဓိကထား တည်ဆောက်ထားခြင်း မဟုတ်ကြောင်းပင်ဖြစ်သည်။ MachineTranslation.com သည် ဘာသာစကားပေါင်း 270 ကျော်ကို တိုက်ရိုက်စမ်းသပ်ပြီး ပံ့ပိုးပေးထားပြီး ၎င်းသည် ယေဘုယျသုံးမော်ဒယ်တစ်ခု၏ ကျယ်ပြန့်သော်လည်း စမ်းသပ်မထားသော ဘာသာစကားမျိုးစုံစွမ်းရည်ဆိုသည့် ဆိုလိုချက်နှင့် ကွဲပြားခြားနားပါသည်။
MachineTranslation.com သည် Qwen နှင့် Grok ကို လက်တွေ့တွင် မည်သို့အသုံးပြုသနည်း
MachineTranslation.com သည် ဘာသာပြန်ဆိုမှုတိုင်းတွင် Qwen၊ Grok နှင့် အခြား AI မော်ဒယ် 20 ကျော်ကို အသုံးပြုထားပြီးနောက် အဆိုပါမော်ဒယ်များ အများဆုံး သဘောတူညီသည့် ဗားရှင်းကို ဖော်ပြပေးပါသည်။ ပျမ်းမျှရမှတ် နိမ့်နေသည့်အတွက် မည်သည့်မော်ဒယ်ကိုမျှ ဖယ်ရှားထားခြင်းမရှိပါ။ မော်ဒယ်များစွာကို တစ်ပြိုင်နက်တည်း အသုံးပြုခြင်းက ရမှတ်ပိုမြင့်သော မော်ဒယ်တစ်ခု လွဲချော်သွားသည့် သီးခြားဝါကျတစ်ခုကို ပျမ်းမျှရမှတ်ပိုနိမ့်သော မော်ဒယ်တစ်ခုက မှန်ကန်စွာ ရရှိနိုင်သည့် အခြေအနေများကို ဖမ်းယူနိုင်ခြင်းကို ဆိုလိုပါသည်။ Qwen ၏ စွမ်းဆောင်ရည်သည် ဘာသာပြန်ဆိုသည့် ဦးတည်ချက်နှင့် ဘာသာစကားတွဲအလိုက် ကွဲပြားမှုများလည်းရှိရာ မော်ဒယ်တစ်ခုတည်းကို မရွေးချယ်မီ သိထားသင့်ပြီး ယင်းကို MachineTranslation.com ၏ Qwen vs DeepSeek နှိုင်းယှဉ်ချက်တွင် ပိုမိုနက်ရှိုင်းစွာ ဖော်ပြထားပါသည်။ မော်ဒယ်များကို အချင်းချင်း တိုက်ရိုက် မည်သို့စမ်းသပ်ထားသည်ကို ပိုမိုလေ့လာလိုပါက MachineTranslation.com ၏ မော်ဒယ်အပြည့်အစုံ နှိုင်းယှဉ်စမ်းသပ်မှု တွင် ကြည့်ရှုပါ။
မကြာခဏ မေးလေ့ရှိသော မေးခွန်းများ
1. ဘာသာပြန်ရန်အတွက် Qwen သို့မဟုတ် Grok က ပိုကောင်းသလား။
MachineTranslation.com ၏ ကိုယ်ပိုင် 28-day engine အချက်အလက်များအရ အမှတ် 10 တွင် Qwen က 8.87 သာ ရရှိသော်လည်း Grok က 9.26 ရရှိထားသဖြင့် ပျမ်းမျှအားဖြင့် Grok ၏ အမှတ်သည် ပိုများပါသည်။ သို့သော် Grok ကို အမှတ်ပေးရာတွင် ၎င်း၏ ထုတ်လုပ်မှုထဲမှ ပိုမိုသေးငယ်ပြီး ကိုယ်စားပြုနိုင်မှု နည်းပါးသည့် အစိတ်အပိုင်းပေါ်တွင်သာ အမှတ်ပေးထားခြင်း ဖြစ်သောကြောင့်၊ ၎င်းသည် တူညီသော အစိတ်အပိုင်းများကို ယှဉ်ပြိုင်စစ်ဆေးသကဲ့သို့ တိကျသော ထိပ်တိုက်ယှဉ်ပြိုင်မှုတစ်ခု မဟုတ်ပါ။
2. အဘယ်ကြောင့် Grok သည် ပျမ်းမျှအမှတ် ပိုများသော်လည်း အမှတ်ပေးခံရသော ဘာသာပြန်ဆိုမှု ပိုနည်းရသနည်း။
ပလက်ဖောင်းပေါ်တွင် Grok ကို အသုံးပြုမှု နည်းပါးပြီး Qwen ၏ 42.6% နှင့် နှိုင်းယှဉ်ပါက ၎င်း၏ ထုတ်လုပ်မှု 22.5% ခန့်သာ အမှတ်ပေးခံရသည်။ ပိုမိုသေးငယ်ပြီး ကိုယ်စားပြုနိုင်မှု နည်းပါးသော နမူနာတစ်ခုသည် ပျမ်းမျှအမှတ်ကို ပိုမိုမြင့်တက်စေနိုင်သလို လျော့ကျသွားစေနိုင်ပါသည်။ ထို့ကြောင့် ဤနှိုင်းယှဉ်ချက်ကို အတိအကျဟု မယူဆဘဲ ဦးတည်ချက်ပြအနေဖြင့်သာ ဖတ်ရှုသင့်ပါသည်။
3. Qwen သို့မဟုတ် Grok သည် ဘာသာစကားများကို ပိုမို ပံ့ပိုးပေးပါသလား။
၎င်းတို့ နှစ်ခုစလုံးသည် တိကျသော ဘာသာစကားဆိုင်ရာ ကန့်သတ်ချက်များအကြောင်းကို အတည်ပြု ထုတ်ပြန်ထားခြင်းမရှိသည့် general-purpose AI model များ ဖြစ်ကြပါသည်။ နှစ်ခုစလုံးသည် ဘာသာပြန်ဆိုရန်အတွက် သီးသန့်တည်ဆောက်ထားခြင်း မဟုတ်သည့်အတွက် ၎င်းသည် တိုင်းတာထားသော ဘာသာပြန်စွမ်းဆောင်ရည်အတွက် အစားထိုးအနေဖြင့် ကျယ်ပြန့်သော ဘာသာစကားစုံ လေ့ကျင့်မှုအပေါ် မှီခိုမည့်အစား၊ ဘာသာစကား 270+ ကျော်၏ ဘာသာပြန်အရည်အသွေးကို တိုက်ရိုက် စမ်းသပ်ပြီး အမှတ်ပေးသည့် ပလက်ဖောင်းတစ်ခုနှင့် ကွာခြားပါသည်။
4. MachineTranslation.com သည် Qwen နှင့် Grok တို့ကို ယှဉ်ပြိုင်ပါသလား။
မယှဉ်ပြိုင်ပါ။ MachineTranslation.com သည် ဘာသာပြန်ဆိုမှုတိုင်းတွင် Qwen၊ Grok နှင့် အခြား AI model 20 ကျော်ကို အသုံးပြုထားပြီး၊ ထို model များအားလုံး အများဆုံး လက်ခံထားသည့် ဗားရှင်းကို ဖော်ပြပေးပါသည်။ ၎င်းသည် သီးခြား ကိုယ်ပိုင် model တစ်ခုအနေဖြင့် ၎င်းတို့နှင့် ယှဉ်ပြိုင်မည့်အစား ထိုကဲ့သို့သော model များကို စမ်းသပ်ပြီး ပေါင်းစပ်အသုံးပြုခြင်း ဖြစ်ပါသည်။
5. MachineTranslation.com သည် ဘာသာပြန်ဆိုရန်အတွက် မည်သည့် AI model ကို အကြံပြုပါသနည်း။
ပုံသေ အကြံပြုထားခြင်း မရှိပါ။ Model အသီးသီးသည် ဘာသာစကားအတွဲနှင့် ကွန်တင့်အမျိုးအစားအပေါ် မူတည်၍ စွမ်းဆောင်ရည် ကွဲပြားကြပြီး ဘာသာပြန်ဆိုမည့်အရာအပေါ် မူတည်၍ ၎င်းတို့ကြားရှိ ကွာဟချက်သည် မည်သည့်ဘက်ကိုမဆို ရောက်ရှိသွားနိုင်ပါသည်။ ထိုသို့ ကွဲပြားမှုများ ရှိနေခြင်းကြောင့် ပလက်ဖောင်းသည် model တစ်ခုတည်းကို ပုံသေရွေးချယ်ပြီး အကြံပြုမည့်အစား ဘာသာပြန်ဆိုမှုတိုင်းတွင် model မျိုးစုံကို အသုံးပြုခြင်း ဖြစ်ပါသည်။