September 25, 2026
Van GPT-3 naar GPT-5: hoe de kwaliteit van AI-vertalingen daadwerkelijk veranderde
GPT-3, GPT-4 en GPT-5 liggen vijf jaar en verschillende architectuurgeneraties uit elkaar, maar de nuttige vraag voor vertaling is niet "welke het slimst is". De vraag is specifieker: wat is er concreet veranderd in hoe deze modellen omgaan met de delen van een taal die zich niet woord voor woord laten vertalen, zoals idiomen, ambiguïteit en register? De verbetering vond plaats op specifieke gebieden, op specifieke momenten, en verliep niet in een rechte lijn van ouder naar nieuwer.
Wat GPT-3 daadwerkelijk bood voor vertaling
OpenAI bracht GPT-3 uit in 2020, voordat het eigen testprogramma van MachineTranslation.com bestond, dus niets hiervan is een bedrijfseigen benchmark. Het is goed gedocumenteerde geschiedenis, geen intern testresultaat. GPT-3 was het eerste model in zijn soort dat vloeiende, natuurlijk klinkende tekst in meerdere talen kon produceren zonder taakspecifieke training, wat het een ware mijlpaal maakte. Specifiek voor vertaling bracht diezelfde vloeiendheid een reëel risico met zich mee: GPT-3 kon een zelfverzekerde, goedgevormde zin in de doeltaal produceren die toch fout was, zonder dat er aan de output te zien was dat er een fout was gemaakt.
Wat er veranderde toen GPT-4 verscheen
GPT-4 werd gelanceerd in maart 2023, en de eigen modeltesten van MachineTranslation.com beginnen rond deze generatie. De verbetering was reëel, maar ongelijkmatig. Bij het testen van de dubbelzinnige Engelse frase "That's sick" in het Japans, was GPT-4.1-nano het enige van zes geteste modellen dat de bewuste dubbele betekenis van de zin reduceerde tot één enkele interpretatie, terwijl de andere vijf de door de oorspronkelijke frase bedoelde ambiguïteit behielden. Idiomen vormden een groter zwak punt: toen de Spaanse uitdrukking "llevarse el gato al agua" tegelijkertijd door vijf GPT-versies werd gehaald, produceerden de kleinere GPT-4o-mini en GPT-4.1-nano allebei dezelfde letterlijke, onjuiste vertaling, waarbij ze het idioom volledig misten.
Ditzelfde patroon was elders ook te zien. Een Duits idioom, "ich verstehe nur Bahnhof", dat door acht GPT- en Claude-subversies werd gehaald, werd specifiek door GPT-4o-mini letterlijk en onjuist vertaald, terwijl een kleiner, nieuwer model in dezelfde test, GPT-4.1-nano, het wel goed had. Generatie en modelgrootte kwamen op geen enkele consistente manier met elkaar overeen, een patroon dat in de modelversietests van MachineTranslation.com diepgaander wordt behandeld.
Wat GPT-5 veranderde voor vertaling
OpenAI introduceerde GPT-5 als een uniform systeem dat, afhankelijk van de taak, routeert tussen een snel standaardmodel en een dieper redeneermodel; een structurele verandering ten opzichte van het enkelvoudige modelontwerp van GPT-4. OpenAI's eigen GPT-5 System Card meldt dat het algehele feitelijke foutenpercentage van het model ongeveer 45% lager ligt dan dat van GPT-4 en 80% lager dan dat van GPT-3, een algemene toename in betrouwbaarheid die ook specifiek bij vertaling zichtbaar is. De tests van MachineTranslation.com tonen de duidelijkste winst op punten waar modellen uit het GPT-4-tijdperk de meeste moeite mee hadden: bij hetzelfde Spaanse idioom waar GPT-4o-mini en GPT-4.1-nano de mist in gingen, kwamen zowel GPT-5.4-mini als GPT-5.4 uit op correcte, idiomatische vertalingen, elk net iets anders verwoord, maar beide met begrip van het idioom zelf.
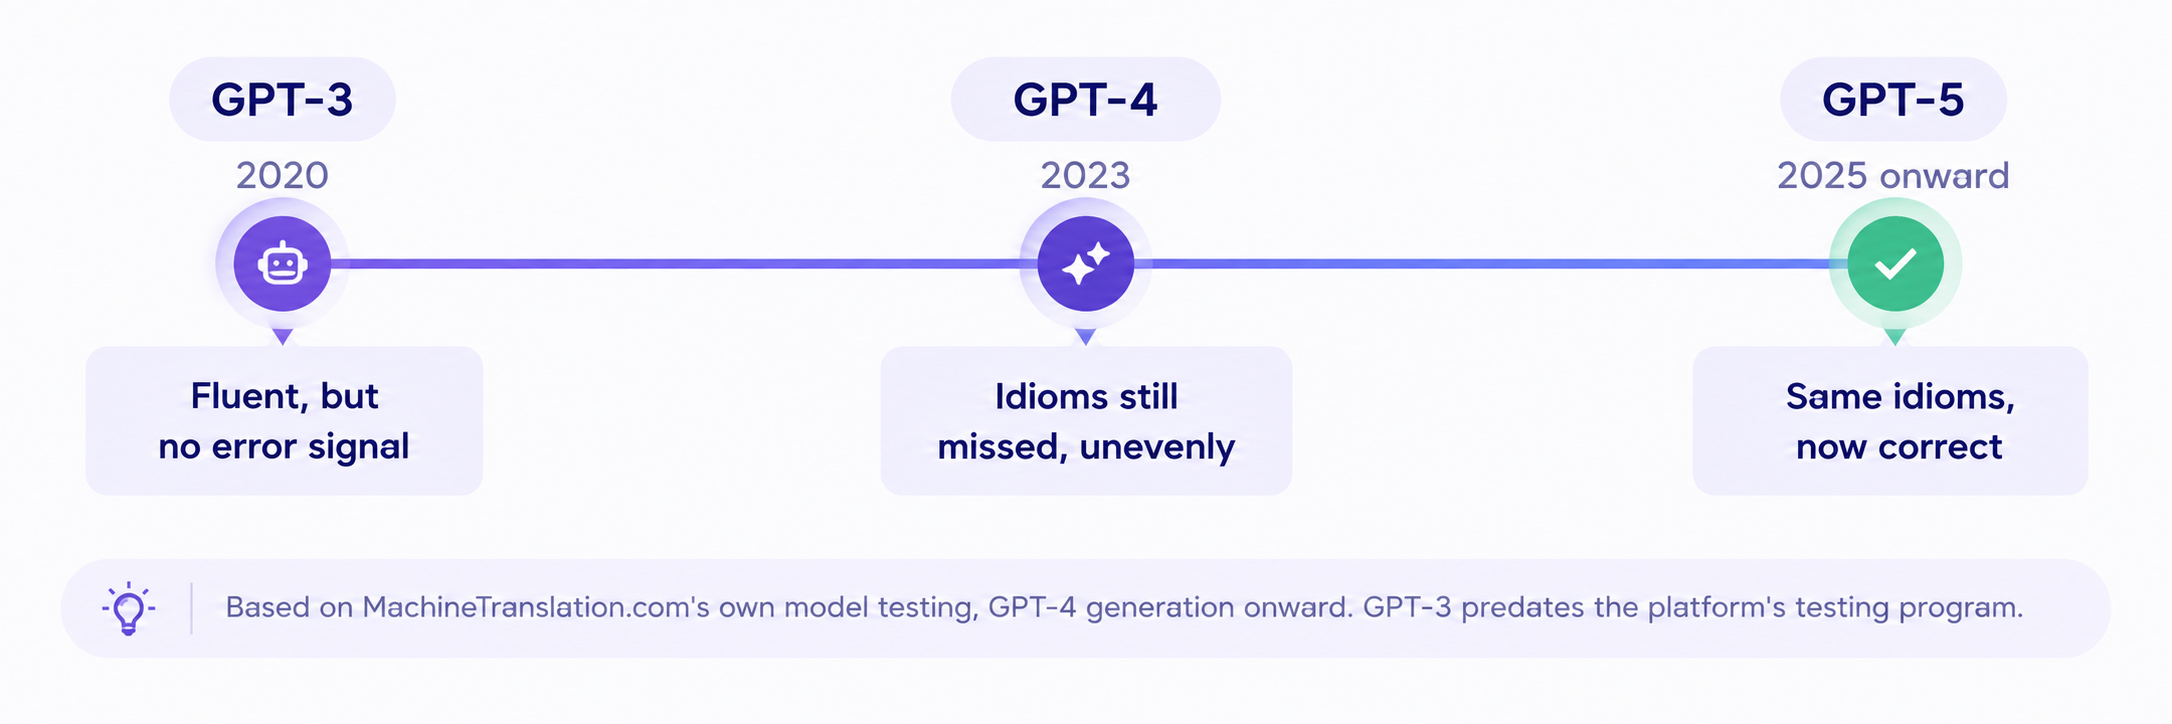
De kloof tussen generaties was geen gestage stijging. Deze concentreerde zich vrijwel volledig op idiomatische en ambigue taal. Bij eenvoudige, rechttoe-rechtaan tekst scoren modellen uit het GPT-4- en GPT-5-tijdperk nagenoeg identiek.
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| Uitgebracht | 2020 | Maart 2023 | 2025, nu op GPT-5.4/5.5 |
| Nu beschikbaar | Nee, uitgefaseerd | Alleen API, uitgefaseerd in ChatGPT | Ja, huidige generatie |
| Omgang met idiomen | Niet getest door MachineTranslation.com (dateert van vóór het programma) | Inconsistent; miste verschillende idiomen volledig | Verwerkte dezelfde idiomen correct die GPT-4 miste |
| Standaard zakelijke tekst | Niet getest door MachineTranslation.com | Sterk, vrijwel identiek aan latere modellen | Sterk, vrijwel identiek aan GPT-4 |
Dat laatste punt is belangrijk: een afzonderlijke test van een standaard zakelijke zin, "please confirm receipt of this document", vertaald naar het Duits, leverde bij elk getest model vrijwel identieke output op, inclusief GPT-4o-mini en modellen uit de GPT-5-generatie. De generatiekloof heeft specifiek betrekking op figuurlijk en dubbelzinnig taalgebruik, en is geen algemeen kwaliteitsverschil.
Betekent een nieuwere GPT-generatie altijd een betere vertaling?
Nee. Bij het testen van een Hebreeuws idioom over verschillende modelfamilies heen, kwamen GPT-5.4-mini en GPT-5.4 uit op twee verschillende, gedeeltelijke interpretaties van dezelfde zin, waarvan er geen enkele volledig juist was, terwijl een ouder, niet-gerelateerd model dichterbij kwam. Een nieuwer model is niet automatisch nauwkeuriger, en een groter of recenter model is niet automatisch de veiligere keuze voor een bepaalde zin.
Waar GPT-5 vandaag de dag staat op het gebied van vertaling
GPT-3 en GPT-4 zijn beide met pensioen gegaan binnen ChatGPT; GPT-4 blijft alleen bereikbaar via de API van OpenAI voor bestaande integraties. De huidige generatie, GPT-5.4 en GPT-5.5, is wat MachineTranslation.com vandaag gebruikt, en deze presteert competitief ten opzichte van de huidige modellen van andere aanbieders, hoewel niet uniform beter voor elk talenpaar. Voor een nadere blik op hoe de huidige GPT-subversies onderling en ten opzichte van modellen zoals Claude en DeepSeek presteren, zie de head-to-head subversietests van MachineTranslation.com, die dieper gaan dan een generatieoverzicht kan.
Wat dit betekent als u op grote schaal lokaliseert
De belangrijkste bevinding voor een omvangrijk lokalisatieprogramma is niet "GPT-5 verslaat GPT-3." Het is dat de modelversie, en niet alleen de modelfamilie, bepaalt of een specifiek idioom of een dubbelzinnige frase correct wordt vertaald, en dat geldt voor elk talenpaar, niet alleen voor het handjevol dat hier wordt getoond. Dit is vooral van belang bij content die überhaupt leunt op toon en figuurlijk taalgebruik, met name marketingteksten en user-generated content, waar een enkel letterlijk vertaald idioom de volledige betekenis van een post of advertentie kan veranderen. Een programma dat content naar tientallen talen overzet, zal in elk daarvan tegen precies dit soort taalgebruik aanlopen. De testreeksen voor subversies en de volledige modelvergelijkingstests van MachineTranslation.com behandelen dit diepgaander. De aanpak van het platform—waarbij bij elke vertaling huidige GPT-modellen naast meer dan 20 andere draaien—bestaat specifiek omdat de versiegeschiedenis van geen enkel afzonderlijk model op zichzelf een betrouwbare garantie biedt.
Veelgestelde vragen
1. Wat is het daadwerkelijke verschil tussen GPT-3, GPT-4 en GPT-5 voor vertalingen?
GPT-3 ging redelijk goed om met eenvoudige tekst, maar had grote moeite met alles wat idiomatisch of dubbelzinnig was. GPT-4 verkleinde dat gat aanzienlijk, maar reduceerde sommige echt dubbelzinnige zinnen nog steeds tot één enkele betekenis in plaats van de ambiguïteit te behouden. De latere subversies van GPT-5 verwerkten idiomen correct die door eerdere modellen uit het GPT-4-tijdperk nog letterlijk en foutief werden vertaald.
2. Is GPT-5 altijd beter dan GPT-4 in vertalen?
Nee. Uit eigen tests van MachineTranslation.com zijn gevallen naar voren gekomen waarin een kleinere, nieuwere subversie beter presteerde dan een grotere, oudere, en het kwaliteitsverschil tussen generaties is vaak specifiek van toepassing op idiomatisch of figuurlijk taalgebruik in plaats van een algemene, algehele verbetering.
3. Biedt OpenAI nog steeds GPT-3 of GPT-4 aan?
Nee. Beide zijn uit ChatGPT verwijderd en vervangen door nieuwere modellen van de GPT-5-generatie. GPT-4 blijft alleen toegankelijk via de API van OpenAI voor bestaande integraties, en niet als een actuele consumentgerichte optie.
4. Welke GPT-versie gebruikt MachineTranslation.com?
MachineTranslation.com draait de huidige modellen van de GPT-5-generatie (GPT-5.4 en GPT-5.5, afhankelijk van het abonnementsniveau) naast meer dan 20 andere AI-modellen bij elke vertaling, in plaats van uitsluitend op GPT te vertrouwen.
5. Hoe verhoudt GPT-5 zich tot andere huidige AI-modellen voor vertaling?
Modellen van de GPT-5-generatie presteren concurrerend, maar niet uniform beter dan modellen zoals Claude, Gemini of DeepSeek. Verschillende modellen winnen bij verschillende taalparen en contenttypes, en dat is waarom MachineTranslation.com ze rechtstreeks tegen elkaar test in plaats van er één als standaard te kiezen.