October 2, 2026
Qwen vs Grok: Welk AI-model vertaalt beter?
Qwen en Grok zijn beide AI-modellen voor algemene doeleinden, geen specifieke vertaaltools, en maken beide deel uit van de poule van modellen die MachineTranslation.com voor elke vertaling gebruikt. Dat is belangrijk voor hoe je het volgende moet lezen. Dit is een blik op hoe twee van de eigen modellen van het platform tegenover elkaar presteren, met de reële kanttekeningen die bij dat soort gegevens horen, en geen wedstrijd tussen twee externe uitdagers en het platform zelf.
Wat zijn Qwen en Grok?
Qwen is Alibaba's familie van grote taalmodellen, momenteel bij de Qwen3.8-generatie, en is toegevoegd aan de modellenpoule van MachineTranslation.com als onderdeel van de voortdurende uitbreiding van het platform. Grok is de modellenlijn van xAI, momenteel bij Grok 4.7 op het moment van schrijven, die verschillende releases heeft doorlopen sinds de versie die in dit artikel oorspronkelijk werd vergeleken, en afzonderlijk aan het platform is toegevoegd. Geen van beide modellen is specifiek gebouwd voor vertalingen. Beide zijn systemen voor algemene doeleinden die toevallig veel talen verwerken als onderdeel van bredere taalcapaciteiten, wat een ander uitgangspunt is dan een platform dat specifiek is gebouwd en getest rond vertaalkwaliteit.
Hoe verhouden Qwen en Grok zich tot elkaar op de eigen data van MachineTranslation.com?
Gedurende de laatste 28 dagen van het platformverkeer scoorde Grok gemiddeld hoger dan Qwen: 9.26 op 10 tegenover 8.87. De slechtst scorende 10% van de vertalingen van Grok behaalde nog steeds een gemiddelde van 9.2, terwijl de slechtst scorende 10% van Qwen daalde naar 7.6, een grotere kloof aan de onderkant dan het gemiddelde alleen doet vermoeden.
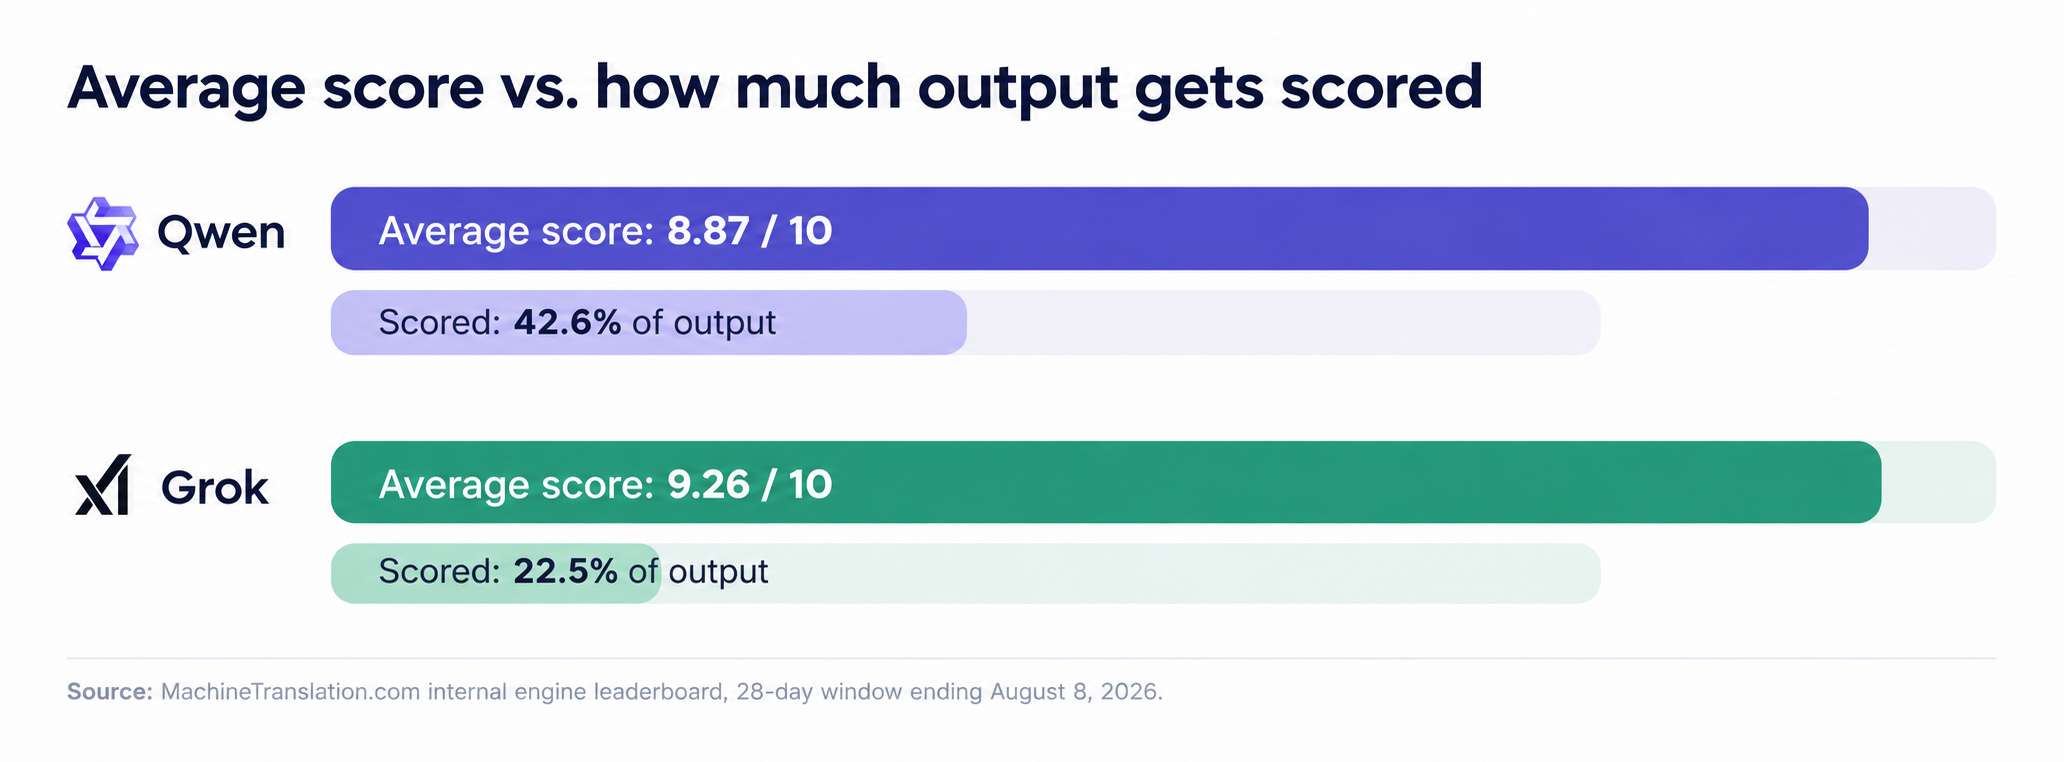
De gemiddelde score van Grok is hoger, maar is gebaseerd op het scoren van minder dan een kwart van de output, tegenover bijna de helft voor Qwen. De twee balken vertellen verschillende delen van hetzelfde verhaal.
| Qwen | Grok | |
|---|---|---|
| Percentage gescoorde output | 42.6% | 22.5% |
| Gemiddelde score | 8.87 / 10 | 9.26 / 10 |
| Laagste 10% van de scores | 7.6 | 9.2 |
Bron: interne engine-ranglijst van MachineTranslation.com, periode van 28 dagen eindigend op 8 augustus 2026.
Betekent de hogere score van Grok dat dit de betere keuze is?
Niet op zichzelf. Grok wordt op het platform veel minder vaak gebruikt dan Qwen, en minder dan een kwart van zijn vertalingen wordt überhaupt gescoord, tegenover bijna de helft van die van Qwen. Een kleinere, minder representatieve steekproef kan een gemiddelde er beter of slechter uit laten zien dan het geval zou zijn bij hetzelfde volume dat Qwen verwerkt. De eigen rapportage van MachineTranslation.com over deze gegevens behandelt de scoredekking als een reële beperking, niet als een voetnoot: een engine die wordt gescoord op een smal deel van het verkeer, is niet zo grondig getest als een engine die wordt gescoord op bijna de helft van de output.
De eerlijke conclusie is dat de cijfers van Grok veelbelovend, maar minder robuust zijn. Die van Qwen zijn gemiddeld lager, maar rusten op een veel grotere, meer representatieve basis. Geen van beide feiten heft het andere op.
Hoe zit het met de taaldekking?
Noch Qwen noch Grok publiceert een geverifieerde lijst van talencombinaties waarbij de prestaties afnemen, en er bestaan geen onafhankelijke tests om dit te bevestigen. Wat met zekerheid kan worden gezegd, is dat geen van beide modellen is gebouwd rond vertaalkwaliteit voor een specifieke set talen, zoals bij een gespecialiseerd vertaalplatform wel het geval is. MachineTranslation.com test en ondersteunt direct meer dan 270 talen, wat een ander soort claim is dan de brede maar ongeteste meertalige capaciteit van een model voor algemene doeleinden.
Hoe MachineTranslation.com Qwen en Grok daadwerkelijk gebruikt
MachineTranslation.com zet Qwen, Grok en meer dan 20 andere AI-modellen in voor elke vertaling, en toont vervolgens de versie waarover deze modellen het het meest eens zijn. Geen van beide modellen wordt uitgesloten vanwege een lagere gemiddelde score. Het tegelijkertijd draaien van meerdere modellen betekent dat de gevallen worden opgevangen waarin een model met een gemiddeld lagere score een specifieke zin toch goed heeft, terwijl een model met een hogere score deze mist. De prestaties van Qwen verschillen ook per richting en talencombinatie op manieren die goed zijn om te weten voordat u voor één enkel model kiest; dit wordt dieper behandeld in de vergelijking tussen Qwen en DeepSeek van MachineTranslation.com. Voor een nadere blik op hoe modellen direct tegen elkaar worden getest, zie de volledige modelvergelijkingstests van MachineTranslation.com.
Veelgestelde vragen
1. Is Qwen of Grok beter voor vertalingen?
Op basis van de eigen 28-daagse engine-data van MachineTranslation.com scoort Grok gemiddeld hoger dan Qwen, 9.26 tegenover 8.87 uit 10. Maar Grok wordt beoordeeld op een veel kleiner, minder representatief deel van zijn output, dus dit is geen zuivere één-op-één vergelijking zoals een test met gekoppelde segmenten dat wel zou zijn.
2. Waarom heeft Grok een hogere gemiddelde score maar minder beoordeelde vertalingen?
Grok wordt minder vaak gebruikt op het platform en slechts ongeveer 22.5% van zijn output wordt beoordeeld, tegenover 42.6% bij Qwen. Een kleinere, minder representatieve steekproef kan een gemiddelde verhogen of verlagen, en daarom moet deze vergelijking als indicatief, en niet als definitief, worden beschouwd.
3. Ondersteunt Qwen of Grok meer talen?
Beide zijn multifunctionele AI-modellen zonder een gepubliceerde, geverifieerde lijst van taalspecifieke beperkingen. Geen van beide is specifiek gebouwd voor vertalingen, wat anders is dan een platform dat de vertaalkwaliteit over 270+ talen direct test en scoort, in plaats van te vertrouwen op brede meertalige training als vervanging voor gemeten vertaalprestaties.
4. Concurreert MachineTranslation.com met Qwen en Grok?
Nee. MachineTranslation.com gebruikt Qwen, Grok en meer dan 20 andere AI-modellen bij elke vertaling en toont de versie waarover deze modellen het het meest eens zijn. Het test en combineert dergelijke modellen in plaats van ermee te concurreren als een eigen, afzonderlijk model.
5. Welk AI-model raadt MachineTranslation.com aan voor vertalingen?
Standaard geen enkel. Verschillende modellen presteren verschillend per talencombinatie en contenttype, en het verschil hiertussen kan beide kanten op vallen, afhankelijk van wat er wordt vertaald. Die variatie is precies de reden waarom het platform bij elke vertaling meerdere modellen gebruikt, in plaats van er één te kiezen als vaste aanbeveling.