May 8, 2026
Grok vs. Claude pentru traducere: ce arată benchmark-urile (2026)
Grok (xAI) și Claude (Anthropic) sunt ambele instrumente de traducere AI capabile, dar au puncte forte diferite din punct de vedere structural. Pentru majoritatea sarcinilor generale de traducere, nu veți observa o diferență semnificativă între ele. Pentru două scenarii specifice (traducerea de conținut despre evenimente recente și traducerea de documente oficiale care necesită precizie), diferența este reală și se bazează pe modul în care a fost construit fiecare model.
Acest articol prezintă ceea ce oferă de fapt fiecare model pentru traducere, unde le plasează testele de referință independente și ce să folosiți atunci când rezultatul niciunuia dintre modele nu este suficient pe cont propriu.
Cum se compară Grok și Claude în ceea ce privește calitatea traducerii?
Răspunsul pe scurt: Claude este lider în benchmark-urile independente de traducere profesională. Avantajul specific al lui Grok este accesul la cunoștințe în timp real, nu calitatea generală a traducerii.
În benchmark-urile interne ale MachineTranslation.com, Claude (nivelul 3.5 Sonnet) obține 93.8 din 100 la calitatea traducerii — acuratețe, terminologie și stil combinate. Grok nu apare în primele 14 soluții din State of Translation Automation 2025 al Intento, care a evaluat 46 de motoare MT și LLM-uri pentru 11 perechi de limbi. Claude Opus 4 și Claude Sonnet 3.7 apar ambele în top 14. Sursă: Benchmarkuri interne ale MachineTranslation.com; Intento State of Translation Automation 2025.
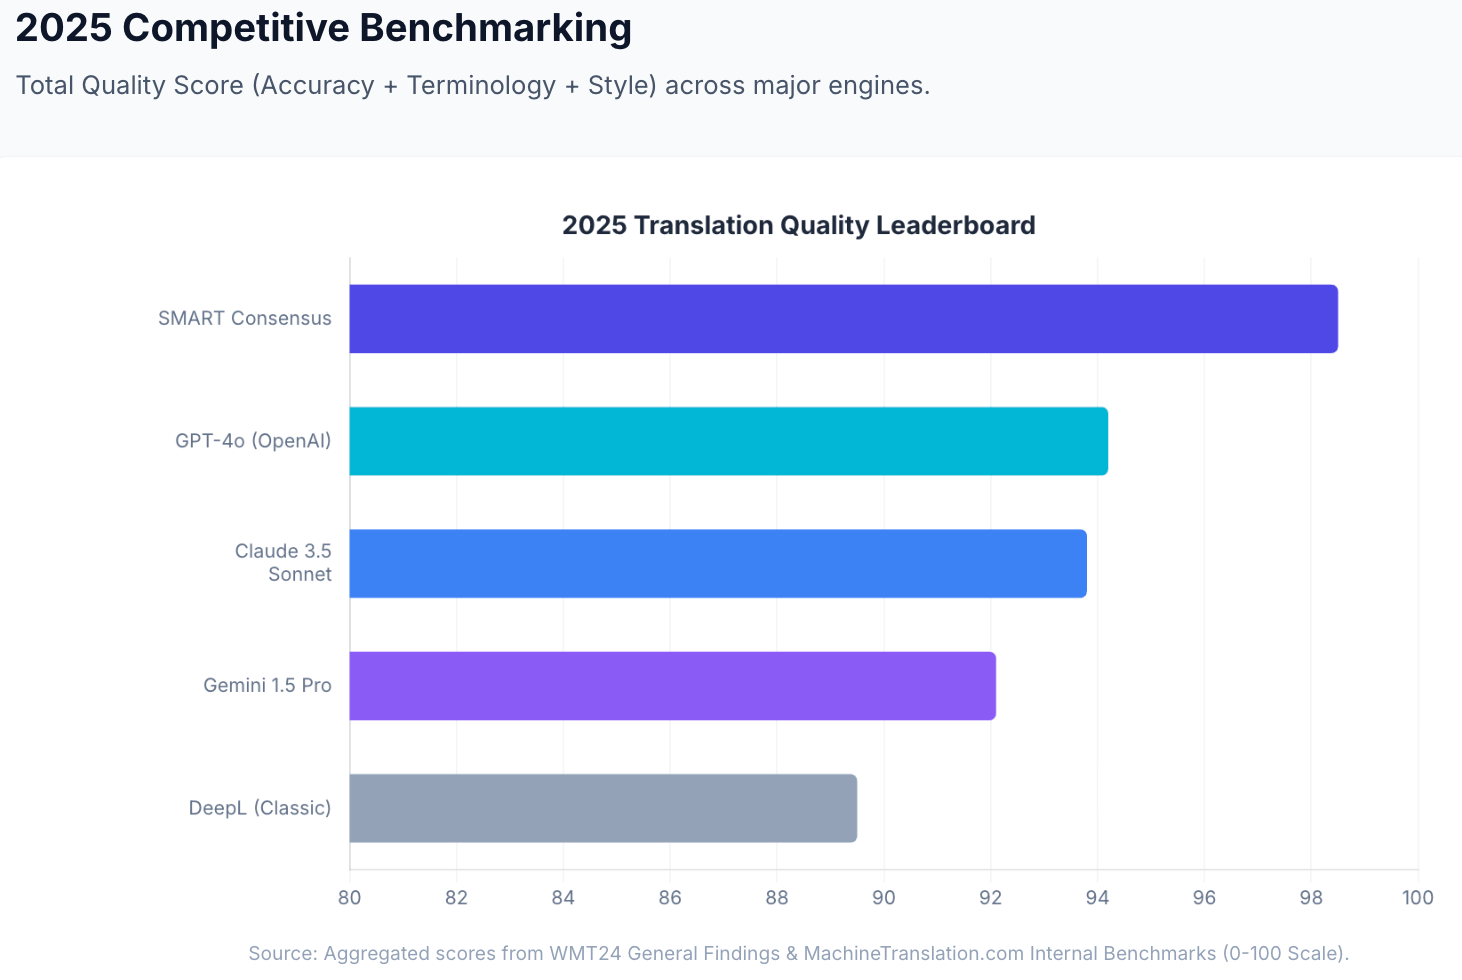
La WMT24 (principala competiție independentă de benchmark din industria traducerilor), Claude 3.5 s-a clasat pe primul loc în 9 din 11 perechi de limbi, devansând GPT-4 și motoarele de traducere automată neuronală dedicate. În studiul de tip blind din 2025 al Lokalise, realizat de traducători profesioniști, 78% dintre traducerile Claude 3.5 au fost evaluate ca „bune” — cel mai ridicat procent dintre toate LLM-urile testate.
Grok nu a fost evaluat în WMT24 sau în evaluarea independentă LQA a Intento la un nivel comparabil. The Slator Pro Guide (2025) listează Grok ca fiind unul dintre LLM-urile de uz general utilizate pentru traducere în medii profesionale, alături de GPT și Claude, dar nu îl clasează deasupra niciunuia dintre ele.
| Benchmark | Grok | Claude |
|---|---|---|
| scorul intern de calitate al MachineTranslation.com | Nemăsurat la nivel de benchmark | 93.8/100 (nivelul 3.5 Sonnet) |
| top 14 soluții Intento 2025 | Nelistat | Claude Opus 4, Sonnet 3.7 ambele listate |
| perechi de limbi WMT24 | Neevaluat | locul 1 în 9/11 perechi de limbi |
| studiul blind Lokalise 2025 | Neevaluat | 78% „bun” (cel mai ridicat dintre toate LLM-urile) |
Sursă: Benchmark-urile interne MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Unde are Grok un avantaj real?
Traducerea în timp real și a evenimentelor actuale. Caracteristica arhitecturală definitorie a lui Grok este integrarea sa cu datele platformei X (fostul Twitter) și căutarea live pe internet. Spre deosebire de Claude și de majoritatea celorlalte LLM-uri, care sunt antrenate pe seturi de date statice cu limite fixe de cunoștințe, Grok încorporează informații în timp real în rezultatele sale. Pentru sarcinile de traducere care implică evenimente recente, produse nou lansate, terminologie politică emergentă, știri de actualitate sau conținut care face referire la lucruri care s-au întâmplat în ultimele săptămâni, Grok are acces la un context pe care Claude nu îl are.
Acest lucru contează în mod special pentru: traducerea articolelor de știri despre evenimente recente, localizarea anunțurilor de produse pentru piețe cu evoluție rapidă, gestionarea terminologiei nou create sau a argoului care apare ulterior datelor de antrenare ale altor modele și orice conținut în care sensul depinde de cunoașterea a ceea ce s-a întâmplat recent.
Terminologie emergentă și în evoluție. Domeniile tehnice, industriile și contextele culturale produc în mod continuu o nouă terminologie. Pentru sarcinile de traducere care implică termeni recent creați, un nou limbaj de reglementare sau o nouă nomenclatură de produse, instruirea actualizată și căutarea în timp real ale Grok îi oferă acces la tipare de utilizare pe care instantaneele de date de instruire mai vechi nu le surprind.
Fereastra de context și raționamentul Grok 4.1. Grok 4.1 (la sfârșitul anului 2025) dispune de o fereastră de context de 131K tokeni și capacități de raționament îmbunătățite, făcându-l capabil în cazul documentelor complexe, pe mai multe niveluri, unde relațiile dintre clauze și coerența logică contează.
Unde are Claude un avantaj real?
Calitatea traducerii pe benchmark-uri independente. Avantajul lui Claude este documentat de o evaluare profesională independentă, mai degrabă decât de afirmații auto-raportate. WMT24 a clasat Claude 3.5 pe primul loc în 9 din 11 perechi de limbi în fața întregii concurențe. Studiul orb realizat de Lokalise în 2025 a constatat că traducătorii profesioniști au preferat output-ul Claude 3.5 cu o rată de „bun” de 78% — mai mare decât în cazul GPT-4, DeepL și Google Translate în aceeași evaluare. Acestea sunt evaluări în orb: traducători profesioniști au evaluat rezultatele fără a ști ce model le-a generat.
Perechi de limbi specifice conform Intento 2025. Claude Opus 4 și Sonnet 3.7 apar în categoria „best” pentru engleză-germană, engleză-japoneză, engleză-italiană, engleză-coreeană, engleză-olandeză, engleză-arabă și engleză-franceză în evaluarea LQA umană realizată de Intento. Pentru aceste perechi, Claude este alegerea mai bine documentată dintre cele două.
Precizia tonului și conținutul nuanțat. Traducătorii profesioniști din studiul Lokalise au preferat output-ul lui Claude în cea mai mare proporție dintre toate LLM-urile — reflectând punctul forte documentat al lui Claude în păstrarea registrului, a vocii autorului și a sensului contextual. Pentru traduceri literare, documente juridice, comunicări formale și texte de marketing, unde modul în care este spus ceva contează la fel de mult ca ceea ce se spune, Claude obține în mod constant rezultate bune în evaluările independente.
Coerența documentelor lungi. Claude 4.6 Sonnet suportă o fereastră de context de 200K de tokeni, în timp ce Claude Opus 4.6 suportă 1M de tokeni în beta. Pentru documente formale lungi (contracte, manuale tehnice, rapoarte de studii clinice), Claude poate procesa întregul document dintr-o singură trecere, menținând consistența terminologică pe tot parcursul acestuia. Documentele procesate pe fragmente prezintă o rată de inconsistență terminologică cu 28% mai mare comparativ cu procesarea documentelor întregi. Sursă: Date interne MachineTranslation.com.
Cum se compară în ceea ce privește suportul lingvistic și prețurile?
Suport lingvistic: Atât Grok 4.1, cât și Claude 4.6 susțin traducerea în majoritatea limbilor majore ale lumii. Claude a fost evaluat în mod independent pe perechi de limbi europene și est-asiatice, cu rezultate solide. Suportul multilingv al lui Grok s-a îmbunătățit de-a lungul versiunilor succesive. Pentru limbile cu resurse limitate, calitatea ambelor modele scade — revizuirea umană este adecvată pentru conținutul în perechi de limbi cu resurse limitate, indiferent de modelul utilizat.
Prețuri:
| Plan | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Consumatori (lunar) | SuperGrok: $30/lună | Claude Pro: $20/lună |
| Input API (per M tokeni) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Output API (per M tokeni) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Nivel gratuit | Da (cu limitare de rată prin X/Grok.com) | Da (cu limitare de rată prin claude.ai) |
La nivelul pentru consumatori, Claude Pro ($20/month) is cheaper than SuperGrok ($30/lună). La nivel de API, Grok 4.1 are un ușor avantaj de cost față de Claude Sonnet 4.6 pentru fluxurile de lucru de traducere cu volum mare de date de intrare.
Care este mai bun pentru tipuri specifice de conținut?
| Tip de conținut | Model recomandat | Motiv |
|---|---|---|
| Știri recente / evenimente actuale | Grok | Acces la date în timp real; modelele antrenate static nu au context actual |
| Terminologie emergentă / lansări de noi produse | Grok | Integrarea căutării live captează tiparele recente de utilizare |
| Documente juridice oficiale | Claude | Evaluare independentă WMT24 și Lokalise 2025; precizie a tonului |
| Conținut medical / clinic | Claude | Poziție în benchmarkuri independente; păstrarea registrului |
| Texte de marketing / conținut creativ | Claude | Preferință în studiul de tip blind Lokalise 2025; nuanțe de ton |
| Documentație tehnică (lungă) | Claude | Fereastră de context de 200K-1M; consistență a terminologiei pe toată lungimea |
| Social media / conținut conversațional | Oricare | Ambele gestionează bine perechile conversaționale cu resurse bogate |
| Dezvoltator / integrare API | Oricare | Ambele oferă acces la API; Grok este ușor mai ieftin pentru tokenii de intrare |
Ce să folosești când un singur model nu este suficient
Atât Grok, cât și Claude sunt instrumente cu un singur model. Fiecare model AI individual (indiferent de cât de capabil este) produce erori pe care nu le poate detecta în propriul său output. O traducere fluentă și sigură pe sine, fie de la Grok, fie de la Claude, poate fi totuși greșită din punct de vedere semantic, iar fără o verificare încrucișată nu există nicio modalitate de a ști.
Atât Grok, cât și Claude se numără printre cele 22 de modele din sistemul SMART al MachineTranslation.com. SMART rulează toate cele 22 de modele simultan (inclusiv Grok și Claude) și returnează rezultatul asupra căruia majoritatea este de acord.
Ce înseamnă acest lucru pentru întrebarea Grok vs. Claude: Puterea în timp real a lui Grok și profunzimea contextuală a lui Claude contribuie ambele la același consens. Când sunt de acord, acel acord este un semnal puternic de calitate.
În benchmark-urile interne ale MachineTranslation.com, modelele individuale de top obțin un scor de 93-94 din 100 în ceea ce privește calitatea traducerii. Output-ul de consens al SMART atinge 98.5/100. Sursă: Analizele comparative interne ale MachineTranslation.com și concluziile WMT24 General Machine Translation.
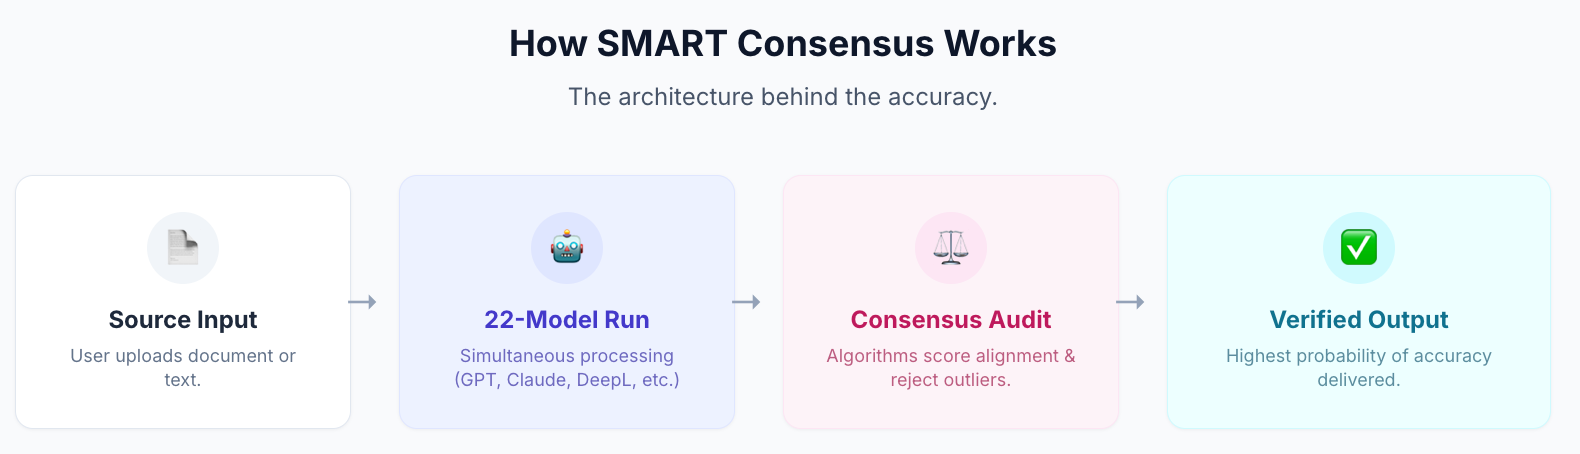
Utilizatorii care au trecut de la traducerea cu un singur motor la SMART au petrecut cu 27% mai puțin timp verificând și corectând rezultatele. Sursă: Date interne MachineTranslation.com.
Pentru conținut cu mize mari (documente juridice, documente de reglementare, instrucțiuni medicale), Human Verification escaladează consensul SMART către un evaluator profesionist certificat în cadrul aceleiași platforme. Fără agenție externă. Acuratețe de 100% garantată.
Traduceți cu Grok, Claude și alte 20 de modele pe MachineTranslation.com — gratuit, fără înregistrare necesară.
Întrebări frecvente
1. Este Grok mai bun decât Claude pentru traducere?
Pentru majoritatea sarcinilor standard de traducere, Claude este lider în benchmark-urile independente: pe primul loc în 9 din 11 perechi de limbi la WMT24, un rating de 78% bun în studiul blind din 2025 al Lokalise și 93.8/100 în benchmark-urile interne de calitate ale MachineTranslation.com. Avantajul specific al lui Grok este pentru conținutul care necesită cunoștințe despre evenimentele actuale, accesul său în timp real la date oferindu-i un context pe care modelele antrenate static, inclusiv Claude, nu îl au. Pentru știri recente, terminologie emergentă și conținut sensibil la timp, Grok este alegerea mai puternică.
2. Care este avantajul lui Grok față de Claude pentru traducere?
Grok integrează date în timp real de pe X (fostul Twitter) și căutare live pe internet. Spre deosebire de Claude și majoritatea celorlalte LLM-uri antrenate pe seturi de date statice, Grok poate accesa informații despre evenimente recente, terminologie nou creată și contextul actual atunci când generează traduceri. Acest lucru îl face în mod special mai puternic pentru traducerea conținutului de știri, a produselor lansate recent și a oricărui material în care sensul depinde de evenimente sau tipare de limbaj din ultimele săptămâni.
3. Care este avantajul lui Claude față de Grok pentru traducere?
Avantajul lui Claude este documentat prin evaluare profesională independentă. Claude 3.5 s-a clasat pe primul loc în 9 din 11 perechi de limbi la WMT24, iar traducătorii profesioniști din studiul blind din 2025 al Lokalise au preferat rezultatele sale cu o rată de „bun” de 78% — cea mai mare dintre toate LLM-urile testate. Claude apare, de asemenea, în topul celor 14 soluții ale Intento pentru mai multe perechi de limbi în evaluarea LQA umană, în timp ce Grok nu. Pentru sarcinile de traducere formale, profesionale și cu mize mari, poziția independentă a lui Claude în benchmark-uri este diferențiatorul documentat.
4. Care este mai bun pentru traducerea juridică, Grok sau Claude?
Claude este alegerea mai solidă pentru traducerea juridică, pe baza unei evaluări independente. Claude 3.5 s-a clasat pe primul loc în majoritatea perechilor de limbi europene cu resurse bogate la WMT24 și a primit cele mai mari evaluări de preferință în studii blind din partea traducătorilor profesioniști. Pentru conținutul juridic care necesită o acuratețe certificată, niciunul dintre modele nu este suficient de unul singur — Human Verification de la MachineTranslation.com oferă o acuratețe de 100% din partea unui revizor profesionist certificat, în cadrul aceleiași platforme, fără a fi necesar un furnizor extern.
5. Sunt disponibili atât Grok, cât și Claude pe MachineTranslation.com?
Da. Ambele se numără printre cele 22 de modele din sistemul SMART al MachineTranslation.com. Fiecare traducere SMART rulează Grok, Claude și alte 20 de modele simultan, returnând rezultatul asupra căruia majoritatea este de acord. În loc să alegeți între ele, primiți consensul tuturor modelelor AI.
6. Cum se compară Grok și Claude în ceea ce privește prețurile?
La nivelul pentru consumatori, Claude Pro costă $20/month versus SuperGrok at $30/lună. La nivel de API, Grok 4.1 este ușor mai ieftin la tokenii de intrare ($2/M vs. $3/M pentru Claude Sonnet 4.6) și de ieșire ($10/M vs. $15/M). Planul gratuit al MachineTranslation.com include ambele modele ca parte a consensului de 22 de modele al SMART, fără a fi necesară înregistrarea.
7. Care model AI este cel mai bun pentru traducerea articolelor de știri?
Pentru traducerea articolelor de știri, Grok are un avantaj structural: integrarea sa de date în timp real înseamnă că are contextul actual despre evenimentele descrise, lucru care le-ar putea lipsi modelelor antrenate static. Pentru traducerea știrilor generale unde actualitatea nu este critică, performanța de referință a lui Claude este superioară. Pentru traducerea de știri în volum mare, unde atât actualitatea, cât și acuratețea contează, SMART de la MachineTranslation.com rulează ambele modele și returnează rezultatul de consens al acestora.