October 2, 2026
Qwen vs Grok: Care model AI traduce mai bine?
Qwen și Grok sunt ambele modele AI de uz general, nu instrumente specifice pentru traducere, și ambele fac parte din grupul de modele pe care MachineTranslation.com le rulează pentru fiecare traducere. Acest lucru contează pentru modul în care trebuie interpretat ceea ce urmează. Aceasta este o analiză a modului în care două dintre modelele proprii ale platformei se descurcă unul împotriva celuilalt, cu rezervele reale care vin cu acest tip de date, nu un concurs între doi competitori externi și platforma însăși.
Ce sunt Qwen și Grok?
Qwen este familia de modele de limbaj de mari dimensiuni a Alibaba, aflată în prezent la generația sa Qwen3.8, și a fost adăugată în grupul de modele al MachineTranslation.com ca parte a extinderii continue a platformei. Grok este linia de modele a xAI, aflată în prezent la versiunea Grok 4.7 la momentul redactării acestui text, trecând prin mai multe versiuni de la cea pe care acest articol a comparat-o inițial, și s-a alăturat platformei separat. Niciunul dintre modele nu a fost construit special pentru traducere. Ambele sunt sisteme de uz general care se întâmplă să gestioneze multe limbi ca parte a unei capacități lingvistice mai largi, ceea ce reprezintă un punct de plecare diferit față de o platformă construită și testată special în jurul calității traducerii.
Cum se compară Qwen și Grok pe datele proprii ale MachineTranslation.com?
În ultimele 28 de zile de trafic pe platformă, Grok a obținut în medie un scor mai mare decât Qwen: 9.26 din 10 față de 8.87. Cele mai slabe 10% dintre traducerile lui Grok au înregistrat totuși o medie de 9.2, în timp ce cele mai slabe 10% ale lui Qwen au scăzut la 7.6, o diferență mai mare la limita inferioară decât sugerează doar media.
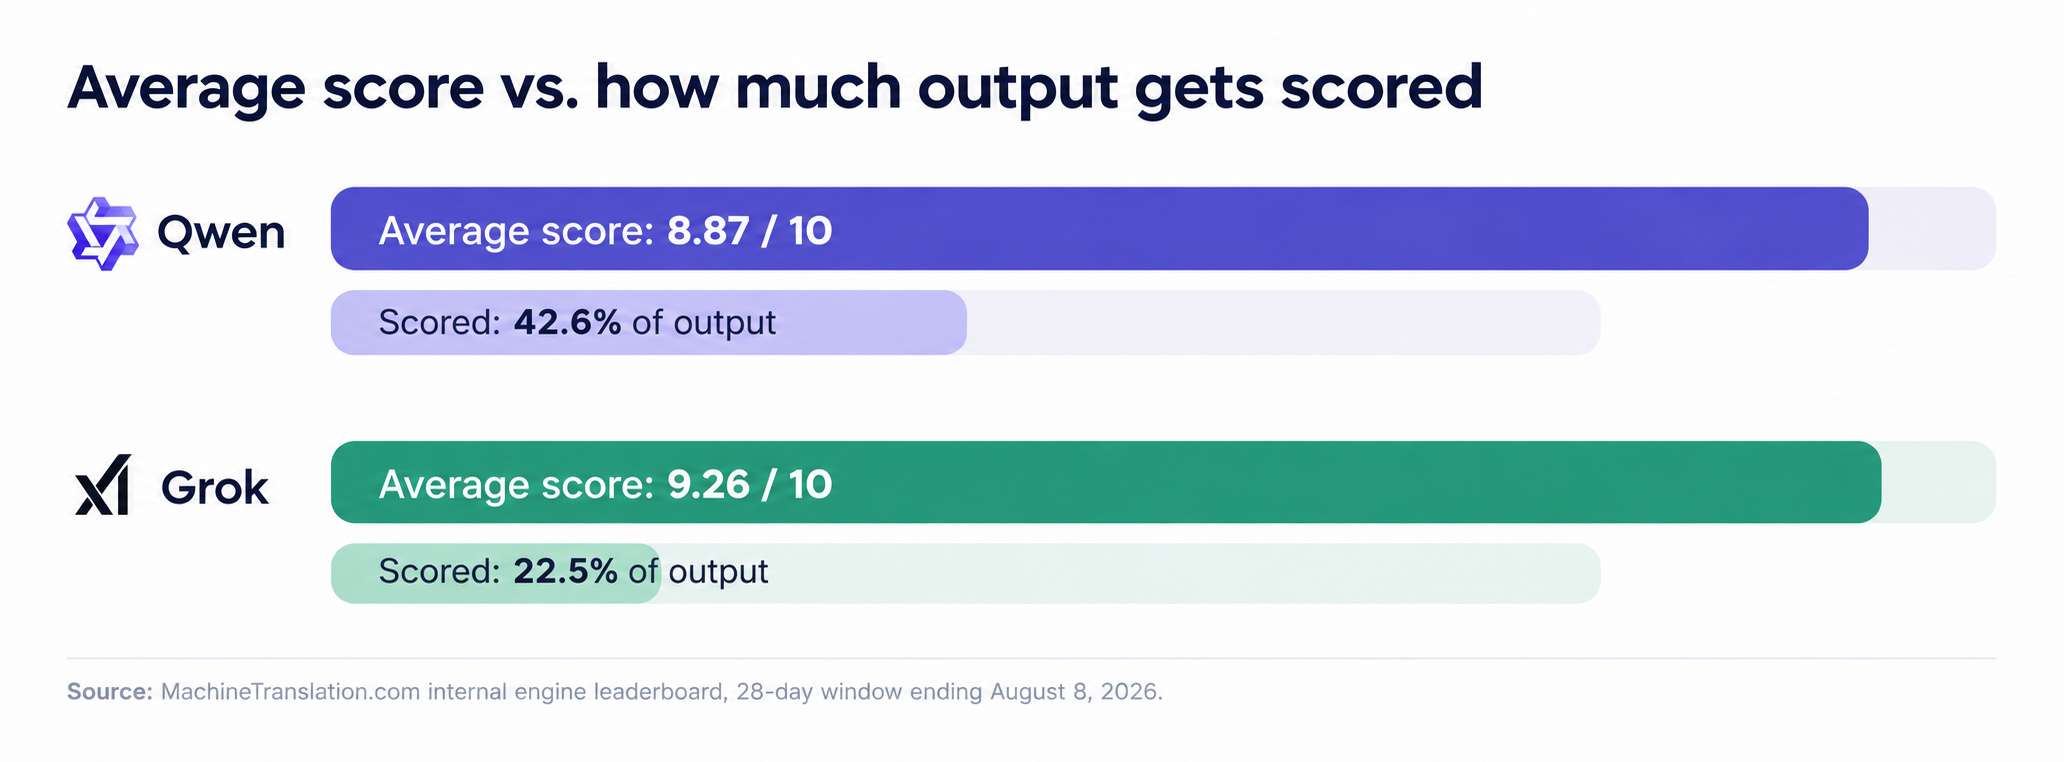
Scorul mediu al lui Grok este mai mare, dar se bazează pe evaluarea a mai puțin de un sfert din rezultatele sale, comparativ cu aproape jumătate pentru Qwen. Cele două bare spun părți diferite ale aceleiași povești.
| Qwen | Grok | |
|---|---|---|
| Procentul de rezultate evaluate | 42.6% | 22.5% |
| Scorul mediu | 8.87 / 10 | 9.26 / 10 |
| Cele mai slabe 10% dintre scoruri | 7.6 | 9.2 |
Sursa: Clasamentul intern al motoarelor MachineTranslation.com, interval de 28 de zile încheiat la 8 august 2026.
Scorul mai mare obținut de Grok înseamnă că este alegerea mai bună?
Nu luat izolat. Grok este utilizat mult mai rar pe platformă decât Qwen și mai puțin de un sfert din traducerile sale primesc un scor, spre deosebire de aproape jumătate dintre cele ale lui Qwen. Un eșantion mai mic și mai puțin reprezentativ poate face ca o medie să pară mai bună sau mai slabă decât ar fi pe același volum pe care îl are Qwen. Propria raportare a MachineTranslation.com privind aceste date tratează acoperirea scorurilor ca pe o limitare reală, nu ca pe o notă de subsol: un motor evaluat pe o porțiune restrânsă din traficul său nu a fost testat la fel de riguros ca unul evaluat pe aproape jumătate din rezultatele sale.
Interpretarea onestă este că cifrele lui Grok sunt promițătoare, dar se bazează pe mai puține date. Cele ale lui Qwen sunt mai mici în medie, dar se bazează pe o fundație mult mai mare și mai reprezentativă. Niciunul dintre aceste fapte nu îl anulează pe celălalt.
Ce putem spune despre acoperirea lingvistică?
Nici Qwen, nici Grok nu publică o listă verificată a perechilor de limbi la care performanța scade și nu există nicio testare independentă care să confirme acest lucru. Ceea ce se poate afirma cu certitudine este că niciunul dintre modele nu a fost construit în jurul calității traducerii pentru un anumit set de limbi, așa cum este o platformă de traducere dedicată. MachineTranslation.com testează și suportă direct peste 270 de limbi, ceea ce reprezintă o afirmație de cu totul altă natură față de capacitatea multilingvă amplă, dar netestată, a unui model de uz general.
Cum utilizează de fapt MachineTranslation.com Qwen și Grok
MachineTranslation.com rulează Qwen, Grok și alte peste 20 de modele AI pe fiecare traducere, apoi afișează versiunea asupra căreia aceste modele sunt cel mai mult de acord. Niciunul dintre modele nu este exclus pentru că a înregistrat un scor mediu mai mic. Rularea mai multor modele în același timp înseamnă surprinderea cazurilor în care un model cu un scor mediu mai mic reușește totuși să traducă corect o anumită propoziție pe care un model cu un scor mai mare o ratează. Performanța lui Qwen variază, de asemenea, în funcție de direcție și de perechea de limbi, în moduri pe care merită să le cunoașteți înainte de a alege un singur model, aspecte acoperite mai detaliat în comparația Qwen vs DeepSeek realizată de MachineTranslation.com. Pentru o privire mai atentă asupra modului în care modelele sunt testate direct unele împotriva celorlalte, consultați testarea completă de comparare a modelelor de la MachineTranslation.com.
Întrebări frecvente
1. Este Qwen sau Grok mai bun pentru traducere?
Conform datelor proprii ale MachineTranslation.com privind motoarele pe o perioadă de 28 de zile, Grok obține în medie un scor mai mare decât Qwen, 9.26 față de 8.87 din 10. Însă Grok este evaluat pe o parte mult mai mică și mai puțin reprezentativă a rezultatelor sale, deci aceasta nu este o comparație directă clară, așa cum ar fi un test pe segmente similare.
2. De ce are Grok un scor mediu mai mare, dar mai puține traduceri evaluate?
Grok este folosit mai rar pe platformă și doar aproximativ 22.5% din rezultatele sale sunt evaluate, față de 42.6% pentru Qwen. Un eșantion mai mic și mai puțin reprezentativ poate umfla sau subestima o medie, motiv pentru care această comparație ar trebui interpretată ca fiind orientativă, nu definitivă.
3. Oferă Qwen sau Grok suport pentru mai multe limbi?
Ambele sunt modele AI de uz general, fără o listă publicată și verificată a limitărilor specifice fiecărei limbi. Niciunul nu este conceput special pentru traduceri, ceea ce diferă de o platformă care testează și evaluează direct calitatea traducerilor în peste 270 de limbi, în loc să se bazeze pe un antrenament multilingv vast ca substitut pentru performanța măsurată a traducerilor.
4. MachineTranslation.com concurează cu Qwen și Grok?
Nu. MachineTranslation.com rulează Qwen, Grok și alte peste 20 de modele AI pe fiecare traducere și afișează versiunea asupra căreia aceste modele sunt cel mai mult de acord. Platforma testează și combină astfel de modele, în loc să concureze cu ele printr-un model propriu și separat.
5. Ce model AI recomandă MachineTranslation.com pentru traduceri?
Niciunul în mod implicit. Modele diferite au performanțe diferite în funcție de perechea de limbi și de tipul de conținut, iar diferența dintre ele poate înclina în oricare direcție, în funcție de ceea ce se traduce. Această variație este exact motivul pentru care platforma rulează mai multe modele pentru fiecare traducere, în loc să aleagă unul singur ca recomandare permanentă.