October 2, 2026
Qwen vs Grok: Ktorý AI model prekladá lepšie?
Qwen a Grok sú univerzálne AI modely, nie špecializované prekladateľské nástroje, a oba sú súčasťou portfólia modelov, ktoré MachineTranslation.com používa pri každom preklade. Na to treba pamätať pri čítaní nasledujúcich riadkov. Ide o pohľad na to, ako si dva z vlastných modelov platformy počínajú v porovnaní navzájom, so všetkými skutočnými výhradami, ktoré sa spájajú s takýmito údajmi, a nie o súboj medzi dvoma externými konkurentmi a samotnou platformou.
Čo sú Qwen a Grok?
Qwen je rodina veľkých jazykových modelov od spoločnosti Alibaba, v súčasnosti vo svojej generácii Qwen3.8, a do portfólia modelov MachineTranslation.com bola pridaná v rámci neustáleho rozširovania platformy. Grok je modelový rad od spoločnosti xAI, v čase písania tohto článku aktuálne vo verzii Grok 4.7, ktorý od verzie pôvodne porovnávanej v tomto článku prešiel niekoľkými vydaniami a k platforme sa pripojil samostatne. Ani jeden z týchto modelov nebol vytvorený špeciálne pre preklad. Oba sú univerzálne systémy, ktoré v rámci svojich širších jazykových schopností dokážu pracovať s mnohými jazykmi, čo je iná východisková pozícia ako v prípade platformy vybudovanej a testovanej špeciálne na kvalitu prekladu.
Ako si Qwen a Grok stoja v porovnaní na základe vlastných dát MachineTranslation.com?
Za posledných 28 dní prevádzky platformy dosiahol Grok v priemere vyššie skóre ako Qwen: 9.26 z 10 v porovnaní s 8.87. Najhoršie hodnotených 10% prekladov modelu Grok malo stále priemer 9.2, zatiaľ čo najhorších 10% modelu Qwen kleslo na 7.6, čo je na dolnom konci väčší rozdiel, než naznačuje len samotný priemer.
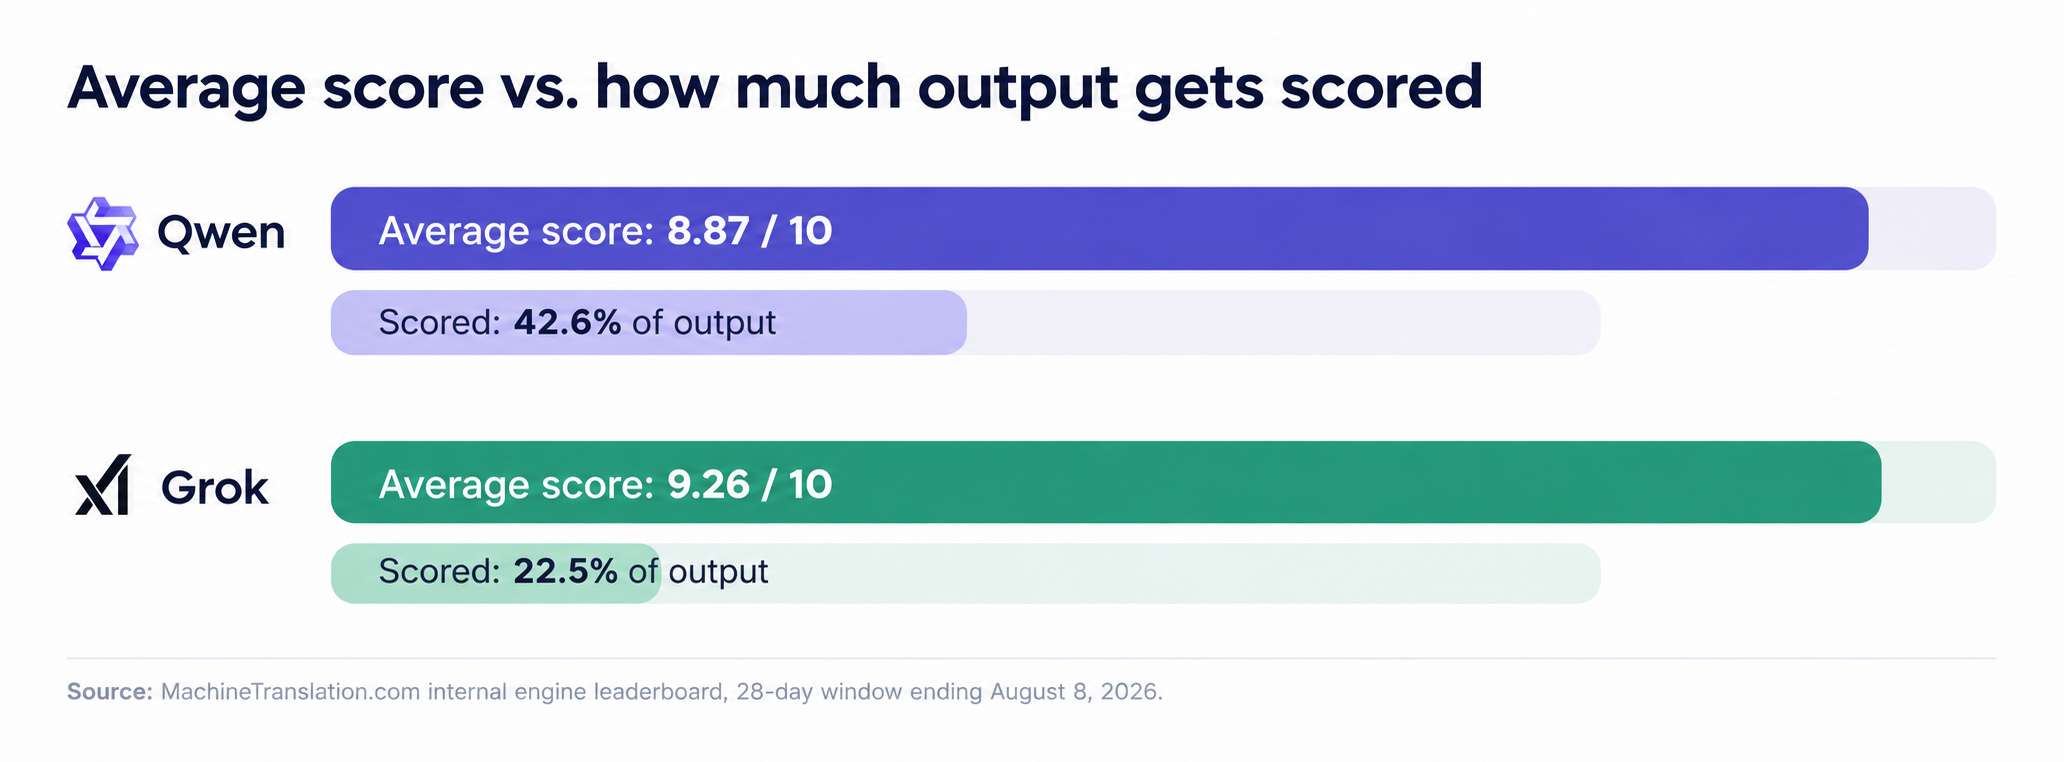
Priemerné skóre modelu Grok je vyššie, ale zakladá sa na hodnotení menej ako štvrtiny jeho výstupov, zatiaľ čo pri modeli Qwen ide o takmer polovicu. Tieto dva stĺpce rozprávajú rôzne časti toho istého príbehu.
| Qwen | Grok | |
|---|---|---|
| Percento hodnotených výstupov | 42.6% | 22.5% |
| Priemerné skóre | 8.87 / 10 | 9.26 / 10 |
| Spodných 10 % skóre | 7.6 | 9.2 |
Zdroj: Interný rebríček enginov MachineTranslation.com, 28-dňové okno končiace August 8, 2026.
Znamená vyššie skóre modelu Grok, že je lepšou voľbou?
Samo osebe nie. Grok sa na platforme používa oveľa menej často ako Qwen a celkovo je hodnotená menej ako štvrtina jeho prekladov, v porovnaní s takmer polovicou u modelu Qwen. Menšia, menej reprezentatívna vzorka môže spôsobiť, že priemer bude vyzerať lepšie alebo horšie, než aký by bol pri rovnakom objeme, aký spracováva Qwen. Vlastné reporty platformy MachineTranslation.com k týmto dátam považujú pokrytie hodnotenia za skutočné obmedzenie, nielen za poznámku pod čiarou: engine hodnotený na úzkom výseku svojej prevádzky nebol testovaný tak dôkladne ako ten, ktorý bol hodnotený na takmer polovici svojho výstupu.
Úprimný pohľad je taký, že čísla modelu Grok sú sľubné, ale menej podložené. Čísla modelu Qwen sú v priemere nižšie, ale opierajú sa o oveľa väčšiu, reprezentatívnejšiu základňu. Žiadny z týchto faktov ten druhý nevylučuje.
A čo jazykové pokrytie?
Ani Qwen, ani Grok nezverejňujú overený zoznam jazykových párov, pri ktorých ich výkonnosť klesá, a neexistuje žiadne nezávislé testovanie, ktoré by to potvrdilo. S istotou možno povedať, že ani jeden z modelov nebol vytvorený s ohľadom na kvalitu prekladu v špecifickom súbore jazykov tak, ako je to v prípade špecializovanej prekladateľskej platformy. MachineTranslation.com priamo testuje a podporuje viac ako 270 jazykov, čo je iné tvrdenie ako široká, ale netestovaná viacjazyčná schopnosť univerzálneho modelu.
Ako MachineTranslation.com v skutočnosti využíva Qwen a Grok
MachineTranslation.com spúšťa Qwen, Grok a viac ako 20 ďalších AI modelov pri každom preklade, a potom zobrazí verziu, na ktorej sa tieto modely najviac zhodujú. Žiadny z modelov nie je vylúčený z dôvodu nižšieho priemerného skóre. Spustenie viacerých modelov naraz znamená podchytenie prípadov, keď model s nižším priemerným skóre stále správne preloží konkrétnu vetu, ktorú model s vyšším skóre nezvládne. Výkonnosť modelu Qwen sa tiež líši v závislosti od smeru a jazykového páru, čo stojí za to vedieť pred výberom jedného modelu; podrobnejšie sa tomu venujeme v porovnaní Qwen vs DeepSeek od MachineTranslation.com. Bližší pohľad na to, ako sú modely priamo testované proti sebe, nájdete v úplnom testovaní porovnania modelov od MachineTranslation.com.
Často kladené otázky
1. Je na preklad lepší Qwen alebo Grok?
Podľa vlastných 28-dňových údajov o prekladacích nástrojoch platformy MachineTranslation.com dosahuje Grok v priemere vyššie skóre ako Qwen, 9.26 oproti 8.87 z 10. Grok je však hodnotený na oveľa menšej a menej reprezentatívnej vzorke svojich výstupov, takže nejde o čisté priame porovnanie tak, ako by to bolo v prípade testu na zhodných segmentoch.
2. Prečo má Grok vyššie priemerné skóre, ale menej hodnotených prekladov?
Grok sa na platforme používa menej často a hodnotí sa len približne 22.5% jeho výstupov v porovnaní so 42.6% pri modeli Qwen. Menšia, menej reprezentatívna vzorka môže priemer umelo zvýšiť alebo znížiť, a preto by sa toto porovnanie malo vnímať len ako orientačné, nie ako definitívne.
3. Podporuje viac jazykov Qwen alebo Grok?
Oba sú univerzálne AI modely bez zverejneného a overeného zoznamu obmedzení pre konkrétne jazyky. Ani jeden nie je vytvorený špeciálne na preklad, čo je podstatný rozdiel oproti platforme, ktorá priamo testuje a hodnotí kvalitu prekladu naprieč 270+ jazykmi, namiesto toho, aby sa spoliehala na rozsiahle viacjazyčné trénovanie ako na náhradu zmeraného prekladateľského výkonu.
4. Konkuruje MachineTranslation.com modelom Qwen a Grok?
Nie. MachineTranslation.com pri každom preklade spúšťa modely Qwen, Grok a viac ako 20 ďalších AI modelov a následne zobrazí verziu, na ktorej sa tieto modely najviac zhodujú. Tieto modely testuje a kombinuje, namiesto toho, aby im konkurovala ako samostatný vlastný model.
5. Ktorý AI model odporúča MachineTranslation.com na preklad?
Štandardne žiadny. Rôzne modely dosahujú odlišné výsledky v závislosti od jazykového páru a typu obsahu, pričom rozdiel medzi nimi sa môže preklopiť na jednu či druhú stranu podľa toho, čo sa práve prekladá. Práve táto variabilita je dôvodom, prečo platforma pri každom preklade spúšťa viacero modelov, namiesto toho, aby vybrala len jeden ako trvalé odporúčanie.