October 2, 2026
Qwen proti Groku: Kateri AI model prevaja bolje?
Qwen in Grok sta splošnonamenska modela umetne inteligence, ne pa specifična prevajalska orodja, in oba sta del nabora modelov, ki jih MachineTranslation.com uporablja pri vsakem prevodu. To je pomembno za razumevanje nadaljevanja. To je pregled tega, kako se dva izmed modelov platforme obneseta med seboj, ob upoštevanju dejanskih omejitev, ki spremljajo tovrstne podatke, in ne tekmovanje med dvema zunanjima izzivalcema in samo platformo.
Kaj sta Qwen in Grok?
Qwen je Alibabina družina velikih jezikovnih modelov, trenutno v svoji generaciji Qwen3.8, in je bila dodana v nabor modelov MachineTranslation.com kot del nenehne širitve platforme. Grok je linija modelov podjetja xAI, v času pisanja tega besedila trenutno pri različici Grok 4.7, ki je od različice, prvotno primerjane v tem članku, prešla skozi več izdaj in se je platformi pridružila ločeno. Noben od modelov ni bil ustvarjen specifično za prevajanje. Oba sta splošnonamenska sistema, ki obvladujeta številne jezike zgolj kot del svojih širših jezikovnih zmožnosti, kar je drugačno izhodišče kot pri platformi, ki je zgrajena in preizkušena specifično za kakovost prevajanja.
Kako se Qwen in Grok primerjata glede na lastne podatke MachineTranslation.com?
V zadnjih 28 dneh prometa na platformi je Grok v povprečju dosegel višjo oceno kot Qwen: 9.26 od 10 v primerjavi z 8.87. Grokovih 10% najslabše ocenjenih prevodov je v povprečju še vedno doseglo oceno 9.2, medtem ko je najslabših 10% pri Qwenu padlo na 7.6, kar je na spodnjem koncu večja razlika, kot bi lahko sklepali zgolj iz povprečja.
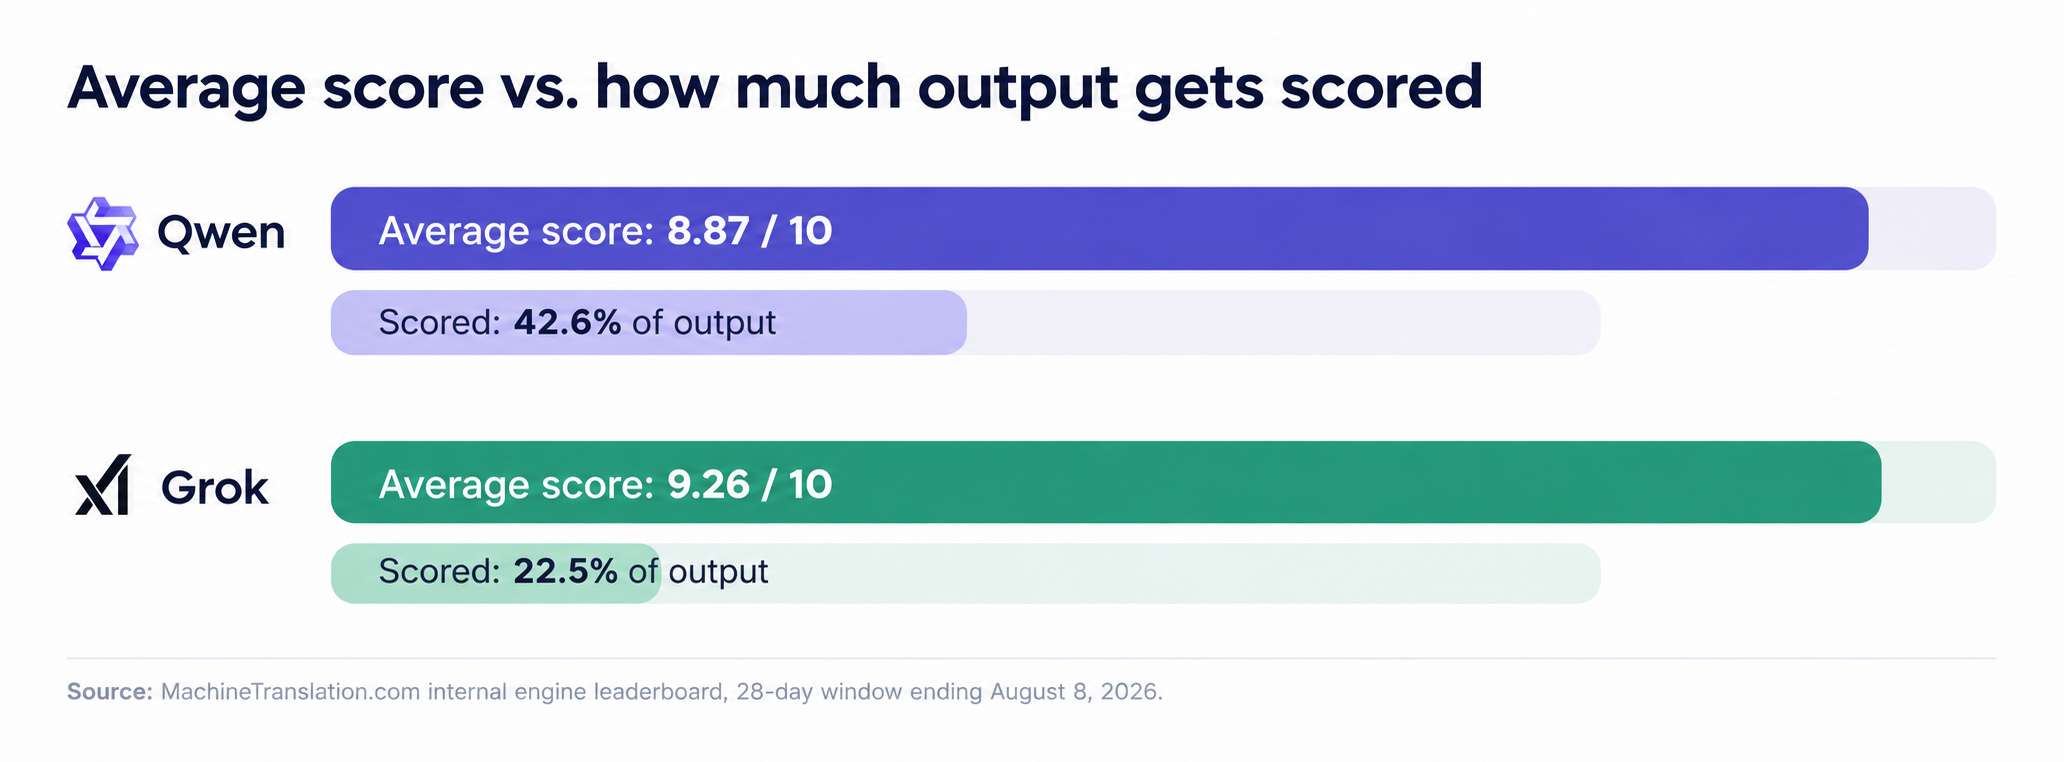
Grokova povprečna ocena je višja, vendar temelji na tem, da je bila ocenjena manj kot četrtina njegovih rezultatov, v primerjavi s skoraj polovico pri Qwenu. Stolpca prikazujeta različna dela iste zgodbe.
| Qwen | Grok | |
|---|---|---|
| Odstotek ocenjenih rezultatov | 42.6% | 22.5% |
| Povprečna ocena | 8.87 / 10 | 9.26 / 10 |
| Spodnjih 10 % rezultatov | 7.6 | 9.2 |
Vir: interna lestvica pogonov MachineTranslation.com, 28-dnevno obdobje, ki se konča 8. avgusta 2026.
Ali višji rezultat modela Grok pomeni, da je boljša izbira?
Samo po sebi ne. Grok se na platformi uporablja precej redkeje kot Qwen in manj kot četrtina njegovih prevodov je sploh ocenjenih, v primerjavi s skoraj polovico pri modelu Qwen. Manjši, manj reprezentativen vzorec lahko povzroči, da je povprečje videti boljše ali slabše, kot bi bilo pri enakem obsegu, s katerim se srečuje Qwen. Lastno poročanje platforme MachineTranslation.com o teh podatkih obravnava pokritost ocenjevanja kot resnično omejitev, ne le kot opombo pod črto: pogon, ki je bil ocenjen na ozkem delu svojega prometa, ni bil tako temeljito preizkušen kot tisti, ki je bil ocenjen na skoraj polovici svojih izpisov.
Poštena ocena je, da so Grokove številke obetavne, a temeljijo na manjšem vzorcu. Qwenove so v povprečju nižje, vendar temeljijo na veliko večji in bolj reprezentativni osnovi. Nobeno od teh dejstev ne izključuje drugega.
Kaj pa jezikovna pokritost?
Niti Qwen niti Grok ne objavljata preverjenega seznama jezikovnih parov, pri katerih učinkovitost upade, in ne obstaja nobeno neodvisno testiranje, ki bi to potrdilo. Z gotovostjo lahko trdimo, da nobeden od modelov ni bil zasnovan z mislijo na kakovost prevajanja v določenem naboru jezikov na način, kot so namenske prevajalske platforme. MachineTranslation.com neposredno testira in podpira več kot 270 jezikov, kar je drugačna trditev kot široka, a nepreverjena večjezična zmogljivost splošnonamenskega modela.
Kako MachineTranslation.com dejansko uporablja Qwen in Grok
MachineTranslation.com pri vsakem prevodu zažene Qwen, Grok in več kot 20 drugih modelov umetne inteligence, nato pa prikaže različico, o kateri se ti modeli najbolj strinjajo. Noben model ni izključen zaradi nižje povprečne ocene. Istočasno izvajanje številnih modelov pomeni, da ujamemo primere, ko model z nižjo povprečno oceno vseeno pravilno prevede določen stavek, ki ga model z višjo oceno zgreši. Učinkovitost modela Qwen se prav tako razlikuje glede na smer in jezikovni par na načine, ki jih je vredno poznati pred izbiro posameznega modela, kar je podrobneje opisano v primerjavi Qwen in DeepSeek na MachineTranslation.com. Za natančnejši vpogled v neposredno testiranje modelov si oglejte celotno testiranje primerjave modelov platforme MachineTranslation.com.
Pogosto zastavljena vprašanja
1. Ali je za prevajanje boljši Qwen ali Grok?
Glede na lastne 28-dnevne podatke o pogonih na MachineTranslation.com, Grok v povprečju dosega višjo oceno kot Qwen, 9.26 v primerjavi z 8.87 od 10. Toda Grok je ocenjen na veliko manjšem, manj reprezentativnem delu svojih rezultatov, zato to ni čista neposredna primerjava, kot bi bil test z ujemajočimi se segmenti.
2. Zakaj ima Grok višjo povprečno oceno, vendar manj ocenjenih prevodov?
Grok se na platformi uporablja redkeje in ocenjenih je le okoli 22.5% njegovih rezultatov, v primerjavi z 42.6% pri Qwenu. Manjši, manj reprezentativen vzorec lahko umetno zviša ali zniža povprečje, zato je treba to primerjavo razumeti kot usmeritveno in ne dokončno.
3. Ali Qwen ali Grok podpira več jezikov?
Oba sta splošnonamenska AI modela brez objavljenega, preverjenega seznama specifičnih jezikovnih omejitev. Nobeden od njiju ni bil ustvarjen posebej za prevajanje, kar je nekaj drugega kot platforma, ki neposredno testira in ocenjuje kakovost prevodov v 270+ jezikih, namesto da bi se zanašala na široko večjezično usposabljanje kot nadomestek za izmerjeno zmogljivost prevajanja.
4. Ali MachineTranslation.com tekmuje s Qwenom in Grokom?
Ne. MachineTranslation.com pri vsakem prevodu uporabi Qwen, Grok in več kot 20 drugih AI modelov ter prikaže tisto različico, pri kateri se ti modeli najbolj ujemajo. Takšne modele testira in združuje, namesto da bi z njimi tekmoval kot samostojen, ločen model.
5. Kateri AI model za prevajanje priporoča MachineTranslation.com?
Privzeto nobenega. Različni modeli se obnesejo različno glede na jezikovni par in vrsto vsebine, razlika med njimi pa lahko niha v eno ali drugo smer, odvisno od tega, kaj se prevaja. Prav ta raznolikost je razlog, zakaj platforma pri vsakem prevodu uporabi več modelov, namesto da bi enega izbrala kot stalno priporočilo.