September 9, 2026
Qwen vs DeepSeek: Ni muundo gani wa AI unaotafsiri vizuri zaidi?
Pitisha sehemu zilezile 12,000 za tafsiri kwenye Qwen na DeepSeek, na DeepSeek inashinda kwenye idadi kubwa ya jozi za lugha. Hiyo siyo habari nzima. Gawanya matokeo kwa mwelekeo, na mtindo fulani mahususi unaonekana: Qwen inapunguza sehemu kubwa ya pengo, na wakati mwingine inaongoza, hasa wakati lugha inayolengwa ni Kiingereza. Kutafsiri kutoka Kiingereza kwenda lugha nyingine yoyote, DeepSeek inashinda karibu kila mara.
Mgawanyiko huo ni muhimu zaidi kuliko mshindi mmoja wa jumla ikiwa unatafsiri maudhui katika dazeni za lugha badala ya jozi moja ya lugha.
Qwen na DeepSeek ni nini?
Qwen ni familia ya Alibaba ya mifano mikubwa ya lugha. Kizazi cha sasa ni Qwen3.8, kilichotolewa mnamo Agosti 2026: Qwen3.8-Max ndio toleo kuu lililofungwa, la API pekee lenye vigezo trilioni 2.4, huku Qwen3.8-27B ikiwa ni muundo mdogo zaidi, wa uzani wazi uliotolewa chini ya Apache 2.0 siku chache baadaye, ukilenga timu zinazotaka kujihost wenyewe.
DeepSeek ni maabara ya Kichina ya AI inayojulikana kwa mifumo ya mixture-of-experts inayofikia utendaji wa kiwango cha juu kwa sehemu ndogo tu ya gharama ya inference. Kizazi chake cha sasa, DeepSeek V4, kilizinduliwa mnamo Aprili 2026 katika matoleo mawili tofauti: V4 Pro (vigezo trilioni 1.6 kwa jumla, karibu bilioni 49 zikiwa amilifu kwa kila tokeni) kwa ajili ya kazi inayolenga ubora, na V4 Flash (bilioni 284 kwa jumla, karibu bilioni 13 amilifu) kwa ajili ya kazi zinazojali latency. Zote mbili zinasambazwa kama open weights zenye leseni ya MIT.
Ni kwa namna gani hasa Qwen na DeepSeek zinalingana kwenye tafsiri, na si benchmarks tu?
Ulinganishaji mwingi kati ya Qwen na DeepSeek unataja benchmarks za madhumuni ya jumla: uandishi wa kodi, hisabati, na uwezo wa kufikiri. Hakuna hata moja kati ya hizo inayopima ubora wa tafsiri moja kwa moja, na kuendesha kila modeli kwenye maandishi tofauti ya chanzo hufanya iwe vigumu kutofautisha pengo lolote la usahihi na kile ambacho maandishi yenyewe yalihitaji.
Trafiki ya tafsiri ya MachineTranslation.com yenyewe katika siku 28 zilizopita inatoa jibu lililo wazi zaidi, kwa sababu modeli zote mbili zilitafsiri maandishi yaleyale ya chanzo. Kwenye jozi 98 za lugha na zaidi ya sehemu 12,000 zilizolinganishwa, DeepSeek ilipata alama za juu zaidi katika jozi 83; Qwen ilipata alama za juu zaidi katika 15. Ukipunguza hiyo hadi jozi 27 ambapo lugha lengwa ni Kiingereza, pengo hilo linapungua sana: DeepSeek inashinda 63% ya hizo (17 kati ya 27), Qwen inashinda 37% (10 kati ya 27). Katika jozi 71 zilizobaki, ambapo Kiingereza siyo lugha lengwa, DeepSeek inashinda 92% (66 kati ya 71).
Kiwango cha ushindi kwa mwelekeo wa tafsiri (jozi 98 za lugha, maandishi yaleyale)
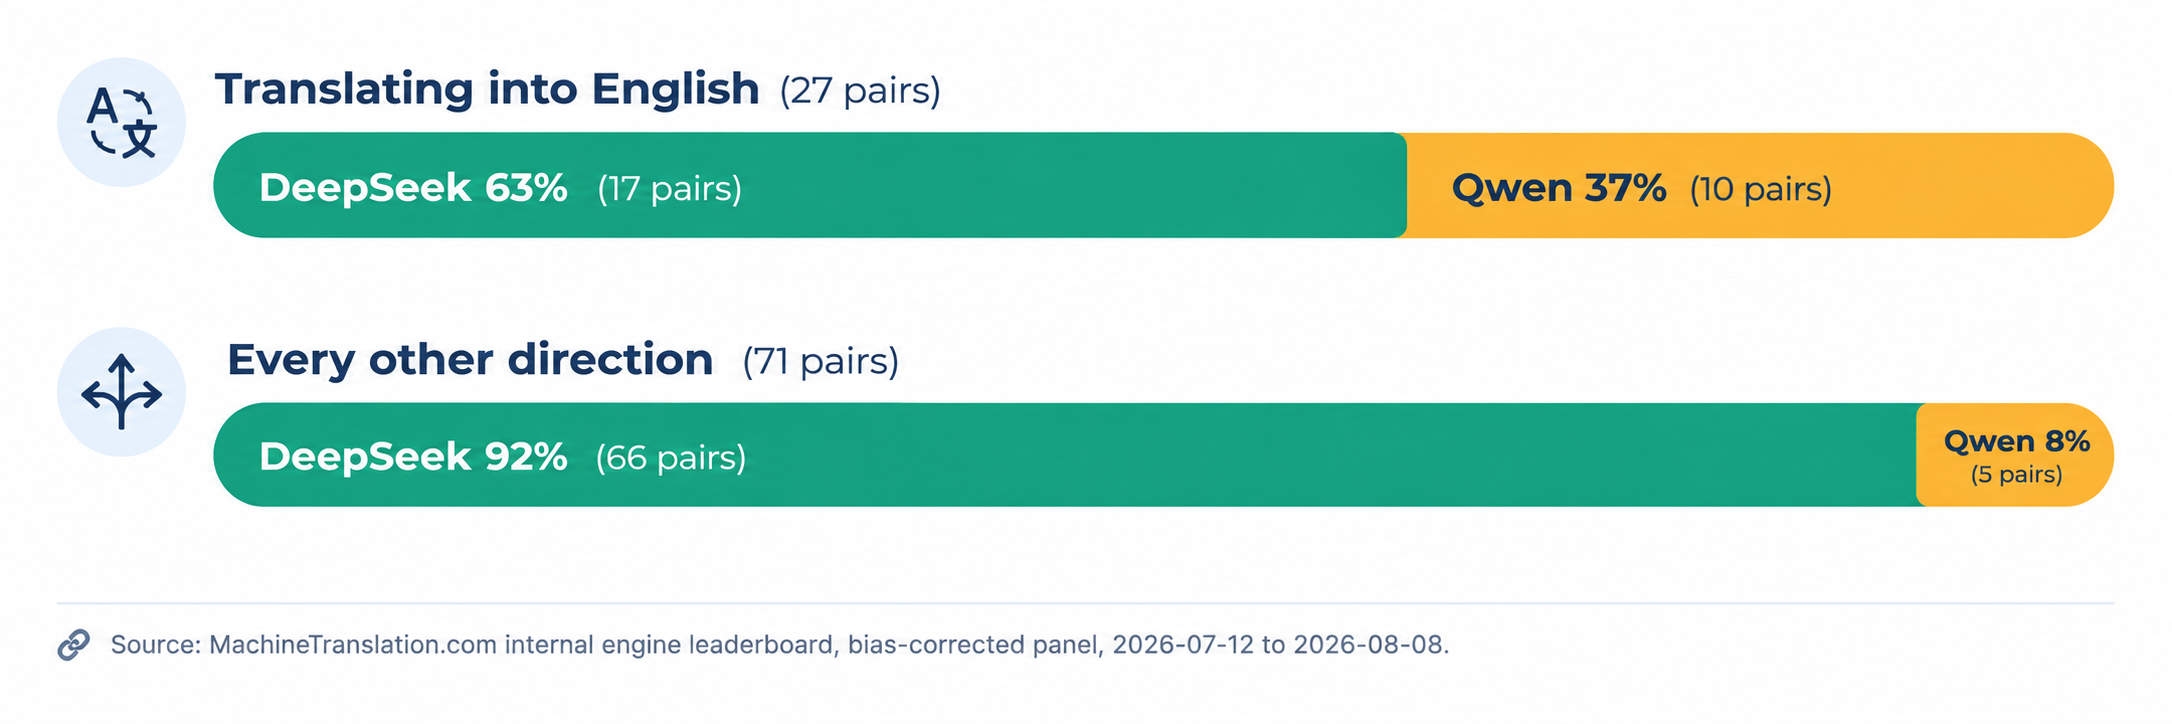
DeepSeek inashinda idadi kubwa ya jozi za lugha kwa jumla. Fursa ya ushindani ya Qwen ni ndogo lakini ni halisi: kutafsiri kwenda kwenye Kiingereza, ambapo inachukua zaidi ya thuluthi moja ya jozi hizo. Data: Ubao wa wanaoongoza wa injini za ndani wa MachineTranslation.com, jopo lililosahihishwa upendeleo, Julai 12 hadi Agosti 8, 2026.
Wastani uliowekewa uzito katika kila sehemu iliyolinganishwa unaweka DeepSeek katika alama 9.13 kati ya 10 na Qwen katika 8.98. Hilo ni pengo halisi, lakini halijasambazwa kwa usawa, jambo ambalo ni muhimu zaidi kujua ikiwa maudhui yako yanaenda katika mwelekeo zaidi ya mmoja. Hii ni mbinu ileile ya ana kwa ana ambayo MachineTranslation.com inatumia kwenye jaribio lake kamili la ulinganishaji wa modeli, si tu kwa jozi hii moja.
Nambari za jumla zinashikilia ukweli katika visa vya majaribio ya kibinafsi pia. Wakati wa kujaribu msemo wa Kifaransa "Elle est directrice adjointe du département commercial," DeepSeek na Qwen zilipatana kwenye tafsiri ileile ya Kiingereza, "deputy director of commercial department". Unaweza kuangalia matokeo hayo ya jaribio la papo hapo moja kwa moja. Wakati wa kujaribu "as soon as possible" iliyotafsiriwa kwenda Kihispania, DeepSeek ilitofautiana na makubaliano ya modeli nne kwa kutumia "esté hecho" badala ya "se haga" ambayo ni kesi halisi ya utofauti inayoonyesha tofauti ya kisarufi kati ya mchakato na matokeo, wala si kosa.
Kwa nini Qwen inafanya vizuri zaidi katika kutafsiri kwenda kwenye Kiingereza hasa?
Data haielezi kwa nini, inaeleza wapi pekee. Baadhi ya jozi zenye nguvu zaidi za Qwen za kutafsiri kwenda Kiingereza ni Kitamil, Kichina, Kipolandi, Kiitaliano, na Kiebrania ambazo ni lugha za chanzo zenye korpasi kubwa za mafunzo ya lugha ya Kiingereza zilizohifadhiwa vyema ambazo zinapatikana kwa watengenezaji wa modeli kwa ujumla. Nje ya mwelekeo huo mmoja, faida ya DeepSeek inajidhihirisha karibu kila mahali: kutoka Kiingereza, na kati ya jozi za lugha zisizo za Kiingereza sawa.
Kinachokataliwa hapa ni kuchukulia mtindo wowote ule kama chaguo-msingi la jumla. Timu inayotafsiri orodha za bidhaa kutoka Kihispania kwenda lugha sita na kutarajia kiwango kile kile cha utendaji kazi ilichokiona wakati ikitafsiri tiketi ya usaidizi ya Kichina kwenda Kiingereza itakuwa inatumia somo lisilo sahihi kutoka kwenye mwelekeo usio sahihi, ambalo ni ulinganifu usio sawa unaojitokeza kwenye uchanganuzi wa mtindo wa Kihispania-hadi-Kiingereza wa MachineTranslation.com , ambapo mitindo inayoongoza si ile ile inayooongoza katika mwelekeo kinyume.
Je, Qwen na DeepSeek ni za bure na chanzo wazi?
Ugawaji wa leseni unatofautiana kwa kila moja. DeepSeek inatoa leseni ya V4 Pro na V4 Flash chini ya MIT, mojawapo ya masharti ya chanzo wazi yenye kuruhusu zaidi yanayopatikana, kwa hivyo zote mbili ni bure kujihostia wenyewe bila kizuizi. Qwen imegawanyika: Qwen3.8-27B inatolewa chini ya Apache 2.0 na ni bure kujihostia wenyewe, lakini mtindo mkuu wa Qwen3.8-Max unabaki kuwa closed, wa API pekee, na chini ya leseni maalum ya Alibaba yenyewe.
Kiuhalisia, hiyo inamaanisha kuwa chaguo la open-weight kamili, lenye leseni ya MIT lipo upande wa DeepSeek katika viwango vyote viwili vya ubora. Kwa upande wa Qwen, kuchagua open-weight inamaanisha kuacha mtindo mkuu.
Je, Qwen na DeepSeek zinagharimu kiasi gani kuziendesha kwa kiwango kikubwa?
Kufuatia kupunguzwa kwa bei kwa kudumu kwa DeepSeek mnamo Mei 2026, viwango vyake vya sasa vya API vilivyochapishwa ni $0.435 per million input tokens (cache miss) and $0.87 kwa kila output tokens milioni moja kwa ajili ya V4 Pro, huku V4 Flash ikiwa na bei ya chini zaidi kwa kiwango chake cha latency-optimized.
Kwa timu zinazojihostia wenyewe mtindo wowote badala ya kutumia API iliyohostiwa, ulinganisho wa gharama unahamia kabisa kwenye miundombinu ya GPU na unakuwa ni zao la parameter count na active-parameter efficiency badala ya kiwango cha kila tokeni.
Je, kuna mtindo wowote ulio salama vya kutosha kwa maudhui ya kisheria, matibabu, au yaliyodhibitiwa?
Hakuna mtindo unaochapisha vyeti vya usalama mahususi kwa ajili ya tafsiri, na vigezo vya usalama vya jumla havijaribu failure modes ambazo ni muhimu katika maudhui yaliyodhibitiwa: kipimo cha dawa kilichotafsiriwa vibaya, kipengele cha dhima kilichobadilishwa, au neno la kisheria lisilo thabiti. Vipimo vya MachineTranslation.com vyenyewe vimegundua hasa aina hii ya utofauti kati ya mitindo kwenye lugha ya kisheria na ya matibabu, ikiwa ni pamoja na matukio ambapo mitindo ilitumia maneno tofauti ya kisheria yenye upeo tofauti ingawa yote mawili yalipata alama nzuri kwenye vipimo vya ubora vya jumla.
Kwa mikataba, hati za uhamiaji, au maudhui ya kliniki, hiyo ndiyo sababu ya kuoanisha matokeo ya mtindo wowote ule na hatua ya uhakiki wa kibinadamu badala ya kuamini matokeo ya AI moja hivi hivi, bila kujali ni mtindo gani ulioyapata.
Hii ina maana gani ikiwa unafanya ujanibishaji katika lugha nyingi kwa mara moja?
Ulinganisho unaojengwa kwenye jozi moja ya lugha haukuambii chochote kuhusu jozi ya arubaini. Mgawanyiko wa kuingia-Kiingereza/kutoka-Kiingereza ulioandikwa hapa ulijitokeza katika sampuli ya jozi 98 hasa kwa sababu ulijaribiwa kwa kiwango hicho: jaribio moja la Kiingereza-kwenda-Kihispania, ambalo ndilo ulinganisho mwingi wa Qwen vs DeepSeek hufanya, lingemwonesha DeepSeek akiwa mbele kwa urahisi na lisingesema chochote kuhusu kile kinachotokea mara tu Kitamil, Kipolandi, au Kiebrania vinapoingia kwenye mchakato.
Hiyo ndiyo hoja ya msingi ya kutofungia programu kubwa ya ujanibishaji kwenye matokeo ya mtindo mmoja tu kama chaguo-msingi. MachineTranslation.com inaendesha Qwen na DeepSeek zote mbili, pamoja na mitindo mingine zaidi ya 20, kwenye kila tafsiri na kuonyesha toleo ambalo mitindo hiyo inakubaliana zaidi, kwa hivyo uzinduzi wa lugha 68 hautegemei mtindo wowote uliotokea kushinda jozi ile moja ambayo mtu alijaribu kwanza. Unaweza kuona hasa ni mitindo gani iliyokubaliana au kutofautiana kwenye tafsiri yoyote ile katika uchanganuzi wa mtindo kwa kila tafsiri ambao jukwaa huonyesha kwa kila matokeo.
Kila tafsiri inakaguliwa dhidi ya anuwai pana ya mitindo kuliko ile ambayo Qwen au DeepSeek pekee zinaweza kutoa, ambalo ndilo jibu la moja kwa moja la kile kinachotokea mara tu maudhui yako yanapoacha kwenda mwelekeo mmoja tu.
Maswali yanayoulizwa mara kwa mara
1. Je, Qwen au DeepSeek ni bora zaidi kwa tafsiri?
Katika jozi 98 za lugha zilizojaribiwa kwenye matini chanzi inayofanana, DeepSeek ilpata alama za juu zaidi katika 83 kati yake. Ushindi wa Qwen umejilundika kwenye mwelekeo mmoja maalum: kutafsiri kwenda Kiingereza, ambapo inashinda karibu thuluthi moja ya wakati. Katika kila mwelekeo mwingine, DeepSeek inashinda zaidi ya 90% ya wakati.
2. Je, Qwen ni ya bure kutumia?
Qwen3.8-27B ina open-weight chini ya Apache 2.0 na ni bure kujihostia wenyewe. Mtindo mkuu wa Qwen3.8-Max ni closed na unapatikana tu kupitia API ya kulipia ya Alibaba Cloud.
3. Je, DeepSeek ni bure kutumia?
Ndiyo. Zote mbili DeepSeek V4 Pro na V4 Flash zinakuja na uzani wazi wenye leseni ya MIT, kwa hivyo unaweza kujihostia mojawapo bila gharama yoyote ya leseni. DeepSeek pia inatoa API ya kulipia kwa timu ambazo hazitaki kusimamia miundombinu yao wenyewe.
4. Ipi ni ya haraka zaidi, Qwen au DeepSeek?
DeepSeek V4 Flash imeundwa mahususi kwa ajili ya muda mfupi wa kusubiri, ikiwa na vigezo amilifu bilioni 13 kwa kila tokeni dhidi ya bilioni 49 za V4 Pro. Chaguo jepesi linalolingana la Qwen, Qwen3.8-27B, ni dense badala ya mixture-of-experts, jambo ambalo kwa ujumla huifanya kuwa polepole zaidi kwa kila token katika ubora unaolingana.
5. Je, ninaweza kutumia Qwen na DeepSeek pamoja kwa ajili ya tafsiri?
Ndiyo. MachineTranslation.com inaendesha miundo yote miwili, pamoja na mingine zaidi ya 20, kwenye kila tafsiri na kuonyesha toleo ambalo inakubaliana nalo zaidi, kwa hivyo hukwami kuchagua muundo mmoja na kutumaini kuwa ndilo chaguo thabiti zaidi kwa jozi hiyo maalum ya lugha.
6. Kuna tofauti gani kati ya leseni za Qwen na DeepSeek?
DeepSeek inatoa leseni kwa lahaja zote mbili za V4 chini ya MIT, mojawapo ya leseni za chanzo wazi zinazoruhusu mambo mengi zaidi zinazopatikana. Qwen inagawanya safu ya mifano yake: mifano midogo zaidi kama Qwen3.8-27B hutolewa chini ya Apache 2.0, lakini mfano mkuu wa Qwen3.8-Max unabaki kuwa funge chini ya leseni maalum.