October 2, 2026
Qwen dhidi ya Grok: Ni modeli ipi ya AI inayotafsiri vizuri zaidi?
Qwen na Grok yote ni mifumo ya AI yenye matumizi ya jumla, sio zana maalum za kutafsiri, na yote ni sehemu ya mkusanyiko wa mifumo ambayo MachineTranslation.com inatumia kwenye kila tafsiri. Hilo ni muhimu kwa jinsi ya kusoma yafuatayo. Huku ni kuangalia jinsi mifumo miwili ya jukwaa lenyewe inavyofanya kazi dhidi ya kila mmoja, pamoja na maonyo halisi yanayokuja na aina hiyo ya data, sio shindano kati ya washindani wawili wa nje na jukwaa lenyewe.
Qwen na Grok ni nini?
Qwen ni kundi la Alibaba la mifumo mikubwa ya lugha, kwa sasa likiwa katika kizazi chake cha Qwen3.8, na liliongezwa kwenye mkusanyiko wa mifumo wa MachineTranslation.com kama sehemu ya upanuzi unaoendelea wa jukwaa. Grok ni mfululizo wa mifumo ya xAI, ambayo kwa sasa ipo kwenye Grok 4.7 wakati wa uandishi huu, ikiwa imepitia matoleo kadhaa tangu toleo ambalo makala hii ililinganisha hapo awali, na kujiunga na jukwaa kando. Hakuna mfumo uliojengwa mahususi kwa ajili ya kutafsiri. Yote ni mifumo ya matumizi ya jumla ambayo inashughulikia lugha nyingi kama sehemu ya uwezo mpana wa lugha, ambalo ni hatua tofauti ya kuanzia ikilinganishwa na jukwaa lililojengwa na kujaribiwa hasa kwa ajili ya ubora wa tafsiri.
Je, Qwen na Grok zinalinganishwaje kwenye data za MachineTranslation.com yenyewe?
Kwa siku 28 zilizopita za matumizi ya jukwaa, Grok ilipata alama za wastani za juu zaidi kuliko Qwen: 9.26 kati ya 10 dhidi ya 8.87. Asilimia 10 ya tafsiri za Grok zilizopata alama za chini zaidi bado zilikuwa na wastani wa 9.2, huku asilimia 10 ya zile za Qwen zilizopata alama za chini zaidi zikishuka hadi 7.6, ambalo ni pengo kubwa zaidi kwenye kiwango cha chini kuliko kile kinachoonyeshwa na wastani pekee.
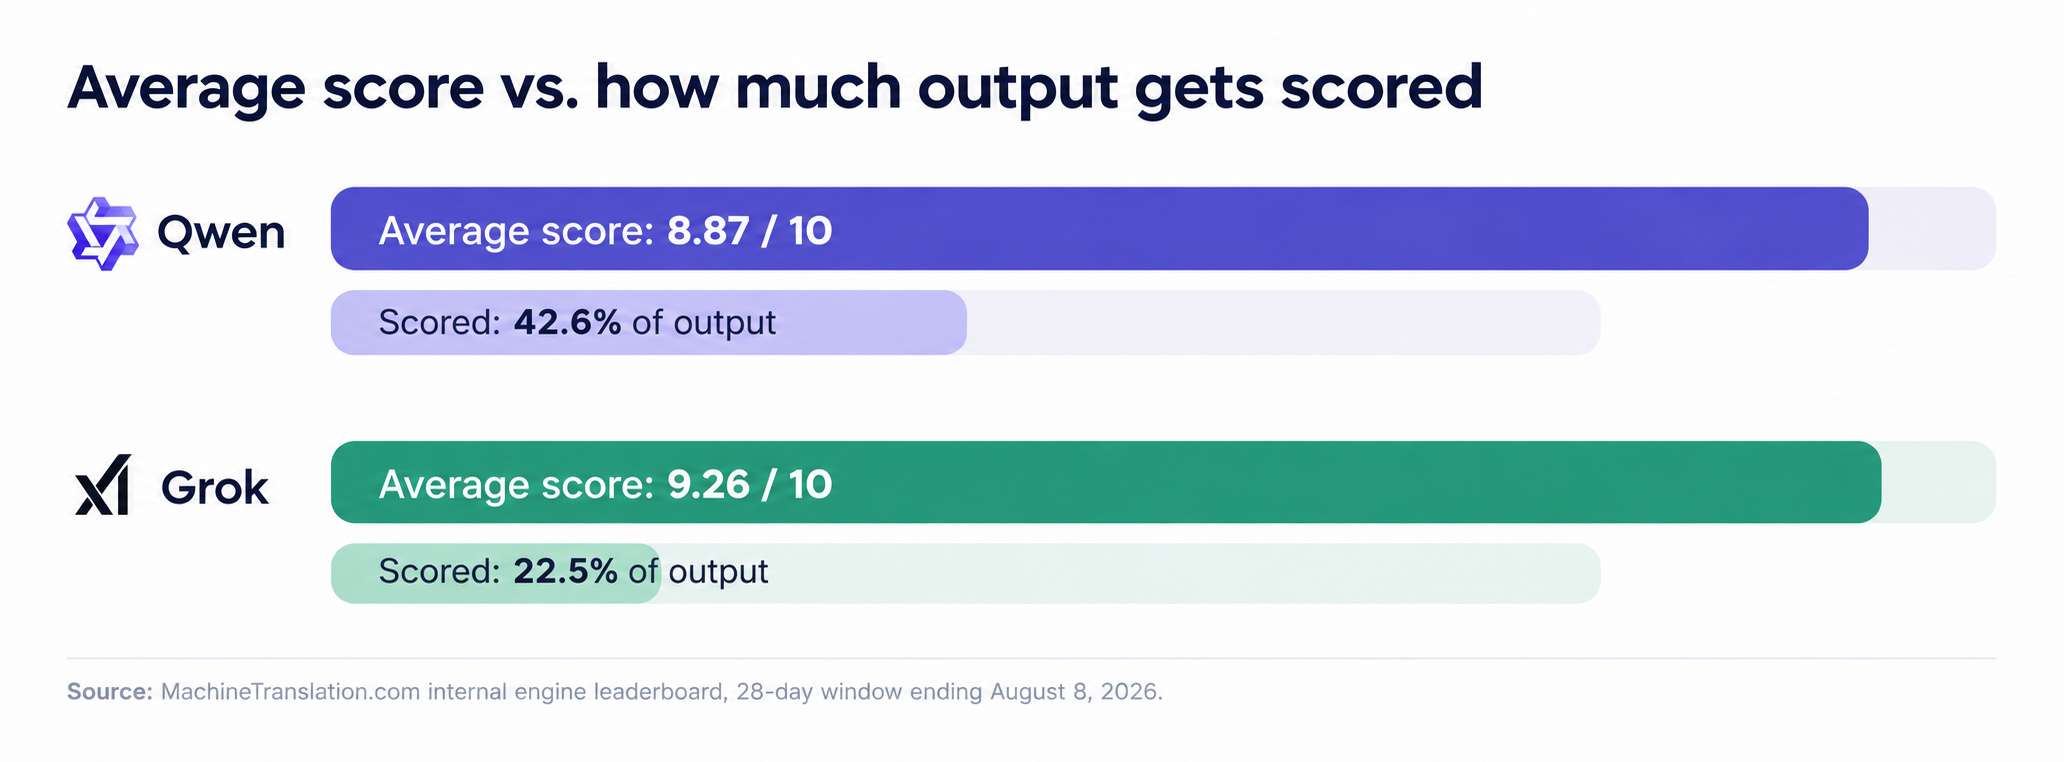
Wastani wa alama wa Grok ni wa juu zaidi, lakini unatokana na uwekaji alama kwa chini ya robo ya matokeo yake, dhidi ya karibu nusu kwa Qwen. Nguzo hizo mbili zinasimulia sehemu tofauti za hadithi hiyo hiyo.
| Qwen | Grok | |
|---|---|---|
| Asilimia ya matokeo yaliyopewa alama | 42.6% | 22.5% |
| Wastani wa alama | 8.87 / 10 | 9.26 / 10 |
| 10% ya chini ya alama | 7.6 | 9.2 |
Chanzo: Ubao wa ndani wa wanaoongoza wa injini wa MachineTranslation.com, kipindi cha siku 28 kinachoishia Agosti 8, 2026.
Je, alama za juu za Grok inamaanisha kuwa ndilo chaguo bora zaidi?
Si yenyewe pekee. Grok inatumiwa mara chache sana kwenye jukwaa ikilinganishwa na Qwen, na chini ya robo ya tafsiri zake hupewa alama, ikilinganishwa na karibu nusu ya zile za Qwen. Sampuli ndogo na isiyo na uwakilishi mzuri inaweza kufanya wastani uonekane mzuri au mbaya zaidi kuliko vile ungeonekana kwa kiwango sawa na kile ambacho Qwen inakipata. Ripoti ya MachineTranslation.com yenyewe kuhusu data hii inachukulia ufikiaji wa utoaji wa alama kama kikomo halisi, na sio tu kama maelezo ya chini: injini iliyopewa alama kwenye sehemu ndogo ya matumizi yake haijajaribiwa kikamilifu kama ile iliyopewa alama katika karibu nusu ya matokeo yake.
Ukweli ni kwamba nambari za Grok zinatia matumaini lakini ni chache. Zile za Qwen ni za chini kwa wastani lakini zinategemea msingi mkubwa zaidi na unaowakilisha vyema zaidi. Hakuna ukweli unaofuta mwingine.
Vipi kuhusu ufikiaji wa lugha?
Qwen wala Grok haichapishi orodha iliyothibitishwa ya jozi za lugha ambapo utendaji hupungua, na hakuna majaribio huru yanayopatikana kuthibitisha hili. Kinachoweza kusemwa kwa uhakika ni kwamba hakuna modeli iliyojengwa kuzingatia ubora wa tafsiri katika seti maalum ya lugha kama ilivyo kwa jukwaa maalum la tafsiri. MachineTranslation.com inajaribu na kusaidia zaidi ya lugha 270 moja kwa moja, ambalo ni dai tofauti ikilinganishwa na uwezo mpana lakini ambao haujajaribiwa wa lugha nyingi wa modeli ya matumizi ya jumla.
Jinsi MachineTranslation.com inavyotumia Qwen na Grok kiuhalisia
MachineTranslation.com inaendesha Qwen, Grok, na zaidi ya modeli zingine 20 za AI kwenye kila tafsiri, kisha huleta toleo ambalo modeli hizo zinakubaliana zaidi. Hakuna modeli inayotengwa kwa kupata alama za chini kwa wastani. Kuendesha modeli nyingi kwa wakati mmoja kunamaanisha kupata matukio ambapo modeli yenye alama za chini kwa wastani bado hupata sentensi mahususi kwa usahihi ambayo modeli yenye alama za juu huikosa. Utendaji wa Qwen pia unagawanyika kwa mwelekeo na jozi kwa njia ambazo ni muhimu kujua kabla ya kuchagua modeli moja, ambazo zimeelezewa kwa kina zaidi katika ulinganisho wa Qwen dhidi ya DeepSeek wa MachineTranslation.com. Kwa mtazamo wa karibu wa jinsi modeli zinavyojaribiwa dhidi ya nyingine moja kwa moja, tazama majaribio kamili ya ulinganisho wa modeli ya MachineTranslation.com.
Maswali yanayoulizwa mara kwa mara
1. Je, kati ya Qwen na Grok ipi ni bora kwa tafsiri?
Kwenye data ya injini ya siku 28 ya MachineTranslation.com yenyewe, Grok inapata alama za juu kwa wastani kuliko Qwen, 9.26 dhidi ya 8.87 kati ya 10. Lakini Grok inapimwa kwenye sehemu ndogo zaidi, isiyowakilisha sana ya matokeo yake, kwa hivyo huu sio ulinganisho wa moja kwa moja jinsi ambavyo jaribio la vipande vilivyolinganishwa lingekuwa.
2. Kwa nini Grok ina alama ya wastani ya juu lakini ina tafsiri chache zilizopata alama?
Grok inatumiwa mara chache zaidi kwenye jukwaa na ni takriban 22.5% pekee ya matokeo yake inayopata alama, dhidi ya 42.6% ya Qwen. Sampuli ndogo zaidi, na isiyowakilisha sana inaweza kuongeza au kupunguza wastani, ndiyo maana ulinganisho huu unapaswa kuchukuliwa kama wa kutoa mwelekeo tu, na sio wa mwisho.
3. Je, Qwen au Grok inaauni lugha nyingi zaidi?
Zote ni modeli za AI za matumizi ya jumla bila orodha iliyochapishwa na iliyothibitishwa ya vikwazo maalum vya lugha. Hakuna iliyoundwa mahususi kwa ajili ya tafsiri, jambo ambalo ni tofauti na jukwaa ambalo hujaribu na kutoa alama za ubora wa tafsiri katika lugha 270+ moja kwa moja, badala ya kutegemea mafunzo mapana ya lugha nyingi kama mbadala wa utendaji wa tafsiri uliopimwa.
4. Je, MachineTranslation.com inashindana na Qwen na Grok?
Hapana. MachineTranslation.com inaendesha Qwen, Grok, na zaidi ya modeli nyingine 20 za AI kwenye kila tafsiri na hutoa toleo ambalo modeli hizo zinakubaliana nalo zaidi. Inajaribu na kujumuisha modeli kama hizi badala ya kushindana nazo kama modeli yake inayojitegemea.
5. Je, MachineTranslation.com inapendekeza modeli gani ya AI kwa ajili ya tafsiri?
Hakuna kwa chaguo-msingi. Modeli tofauti hufanya kazi kwa utofauti kulingana na jozi ya lugha na aina ya maudhui, na pengo kati yao linaweza kuegemea upande wowote kulingana na kile kinachotafsiriwa. Utofauti huo ndio sababu hasa inayofanya jukwaa kuendesha modeli nyingi kwenye kila tafsiri badala ya kuchagua moja kama pendekezo la kudumu.