September 25, 2026
จาก GPT-3 สู่ GPT-5: คุณภาพการแปลของ AI เปลี่ยนแปลงไปอย่างไรในความเป็นจริง
GPT-3, GPT-4 และ GPT-5 มีช่วงเวลาห่างกันถึงห้าปีและผ่านสถาปัตยกรรมมาหลายเจเนอเรชัน แต่คำถามที่เป็นประโยชน์สำหรับการแปลไม่ใช่ "รุ่นไหนฉลาดที่สุด" หากแต่มีความเฉพาะเจาะจงยิ่งกว่านั้น นั่นคือ มีอะไรที่เปลี่ยนแปลงไปอย่างเจาะจงบ้างในวิธีที่โมเดลเหล่านี้จัดการกับส่วนของภาษาที่ไม่สามารถแปลแบบคำต่อคำได้ เช่น สำนวน ความกำกวม และระดับภาษา? การพัฒนานี้เกิดขึ้นในจุดที่เฉพาะเจาะจง ณ ช่วงเวลาที่เฉพาะเจาะจง และไม่ได้พัฒนาเป็นเส้นตรงจากรุ่นเก่าไปสู่รุ่นใหม่
สิ่งที่ GPT-3 นำเสนอสำหรับการแปลอย่างแท้จริง
OpenAI เปิดตัว GPT-3 ในปี 2020 ก่อนที่โปรแกรมการทดสอบของ MachineTranslation.com จะเกิดขึ้น ดังนั้นข้อมูลในที่นี้จึงไม่ใช่เกณฑ์มาตรฐานเฉพาะ แต่เป็นประวัติศาสตร์ที่มีการบันทึกไว้อย่างชัดเจน ไม่ใช่ผลการทดสอบภายใน GPT-3 เป็นโมเดลแรกในประเภทนี้ที่สามารถสร้างข้อความที่สละสลวยและเป็นธรรมชาติเหมือนมนุษย์ได้ในหลายภาษาโดยไม่ต้องผ่านการฝึกฝนสำหรับงานเฉพาะด้าน ซึ่งทำให้มันกลายเป็นหมุดหมายสำคัญอย่างแท้จริง แต่สำหรับการแปลโดยเฉพาะ ความสละสลวยนั้นกลับสร้างความเสี่ยงที่แท้จริงขึ้นมา นั่นคือ GPT-3 สามารถสร้างประโยคที่มีโครงสร้างดีและดูมั่นใจในภาษาปลายทางแต่ยังคงผิดพลาด โดยไม่มีสิ่งใดในผลลัพธ์ที่ส่งสัญญาณเลยว่ามีข้อผิดพลาดเกิดขึ้น
สิ่งที่เปลี่ยนไปเมื่อ GPT-4 มาถึง
GPT-4 เปิดตัวในเดือนมีนาคม 2023 และการทดสอบโมเดลของ MachineTranslation.com เองก็เริ่มต้นขึ้นในช่วงเจเนอเรชันนี้ การพัฒนานั้นเกิดขึ้นจริงแต่ไม่สม่ำเสมอ ในการทดสอบวลีภาษาอังกฤษที่มีความกำกวมอย่าง "That's sick" เป็นภาษาญี่ปุ่น GPT-4.1-nano เป็นโมเดลเดียวจากหกโมเดลที่ทดสอบซึ่งลดทอนความหมายสองแง่สองง่ามโดยเจตนาของประโยคให้เหลือเพียงการตีความแบบเดียว ในขณะที่อีกห้าโมเดลสามารถรักษาความกำกวมตามที่วลีต้นฉบับตั้งใจไว้ได้ ส่วนสำนวนถือเป็นจุดอ่อนที่ใหญ่กว่า โดยเมื่อทดสอบสำนวนภาษาสเปน "llevarse el gato al agua" กับโมเดล GPT ทั้งห้ารุ่นพร้อมกัน โมเดลขนาดเล็กกว่าอย่าง GPT-4o-mini และ GPT-4.1-nano ต่างให้ผลการแปลตรงตัวที่ผิดพลาดเหมือนกัน โดยมองข้ามความเป็นสำนวนไปอย่างสิ้นเชิง
รูปแบบเดียวกันนี้ยังปรากฏในกรณีอื่นๆ อีกด้วย สำนวนภาษาเยอรมัน "ich verstehe nur Bahnhof" เมื่อทดสอบกับรุ่นย่อยของ GPT และ Claude จำนวนแปดรุ่น พบว่า GPT-4o-mini แปลตรงตัวและผิดพลาดโดยเฉพาะ ในขณะที่โมเดลที่ใหม่กว่าและมีขนาดเล็กกว่าในการทดสอบเดียวกันอย่าง GPT-4.1-nano กลับแปลได้ถูกต้อง เจเนอเรชันและขนาดของโมเดลไม่ได้สอดคล้องกันในทิศทางเดียวกันอย่างสม่ำเสมอ ซึ่งเป็นรูปแบบที่การทดสอบเวอร์ชันโมเดลของ MachineTranslation.com ครอบคลุมในเชิงลึกยิ่งขึ้น
สิ่งที่ GPT-5 เปลี่ยนแปลงไปสำหรับการแปล
OpenAI แนะนำ GPT-5 ในฐานะระบบรวมศูนย์ที่กำหนดเส้นทางการประมวลผลระหว่างโมเดลเริ่มต้นที่รวดเร็วและโมเดลการใช้เหตุผลเชิงลึกตามแต่งานที่ได้รับมอบหมาย ซึ่งเป็นการเปลี่ยนแปลงเชิงโครงสร้างจากการออกแบบโมเดลเดี่ยวของ GPT-4 ทั้งนี้ GPT-5 System Card ของ OpenAI เองรายงานว่า อัตราข้อผิดพลาดด้านข้อเท็จจริงโดยรวมของโมเดลต่ำกว่าของ GPT-4 ราว 45% และต่ำกว่าของ GPT-3 ถึง 80% ซึ่งเป็นความน่าเชื่อถือโดยรวมที่เพิ่มขึ้นและแสดงให้เห็นในงานแปลโดยเฉพาะด้วยเช่นกัน การทดสอบของ MachineTranslation.com แสดงให้เห็นถึงการพัฒนาที่ชัดเจนที่สุดในจุดที่โมเดลยุค GPT-4 มีปัญหามากที่สุด นั่นคือสำนวนภาษาสเปนเดียวกันกับที่ GPT-4o-mini และ GPT-4.1-nano แปลผิดพลาด ทั้ง GPT-5.4-mini และ GPT-5.4 ต่างให้ผลการแปลตามสำนวนที่ถูกต้อง แม้แต่ละโมเดลจะใช้ถ้อยคำต่างกันเล็กน้อย แต่ต่างก็เข้าใจตัวสำนวนเอง
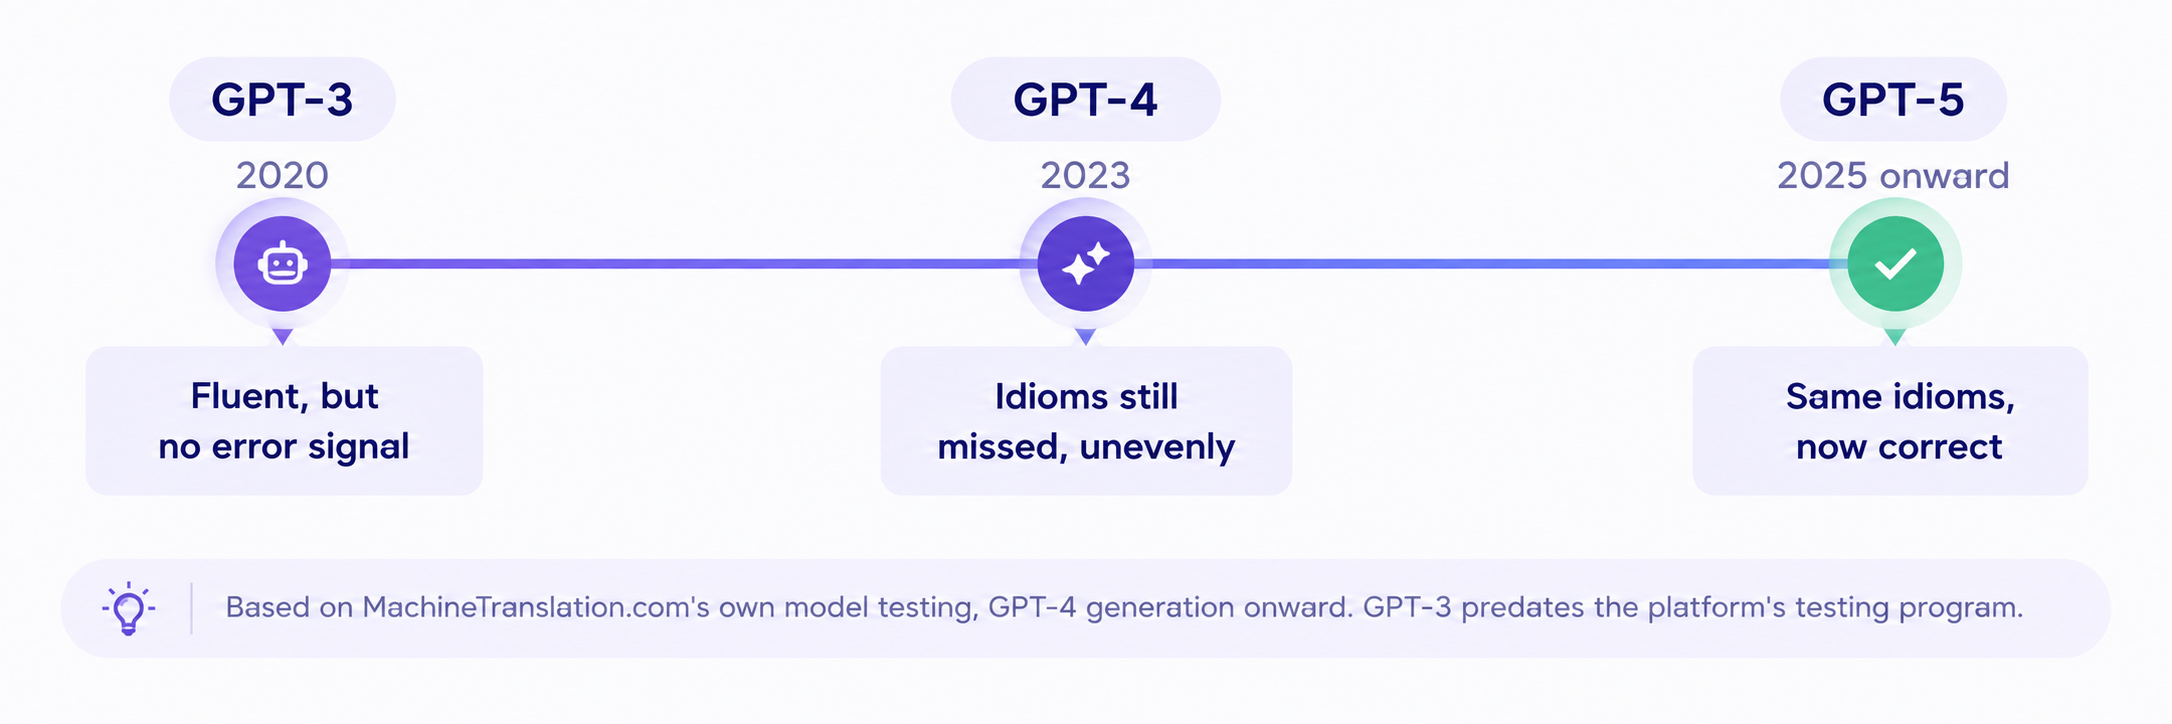
ช่องว่างระหว่างเจเนอเรชันไม่ได้เป็นการไต่ระดับขึ้นอย่างคงที่ แต่กระจุกตัวอยู่เกือบทั้งหมดในเรื่องของภาษาที่เป็นสำนวนและมีความกำกวม สำหรับข้อความตรงไปตรงมา โมเดลในยุค GPT-4 และ GPT-5 ทำคะแนนได้ใกล้เคียงกันแทบไม่ต่าง
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| เปิดตัว | 2020 | มีนาคม 2023 | 2025 ปัจจุบันอยู่ที่ GPT-5.4/5.5 |
| เปิดให้ใช้งานในปัจจุบัน | ไม่ ยุติการให้บริการแล้ว | เฉพาะ API ยุติการให้บริการบน ChatGPT แล้ว | ใช่ เจเนอเรชันปัจจุบัน |
| การจัดการสำนวน | ไม่ได้รับการทดสอบโดย MachineTranslation.com (เกิดขึ้นก่อนเริ่มโครงการทดสอบ) | ไม่สม่ำเสมอ พลาดสำนวนไปหลายสำนวนโดยสิ้นเชิง | จัดการสำนวนเดียวกันกับที่ GPT-4 พลาดได้อย่างถูกต้อง |
| ข้อความทางธุรกิจมาตรฐาน | ไม่ได้รับการทดสอบโดย MachineTranslation.com | ทำได้ดี แทบไม่ต่างจากโมเดลรุ่นหลังๆ | ทำได้ดี แทบไม่ต่างจาก GPT-4 |
จุดสุดท้ายนี้มีความสำคัญ: การทดสอบแยกต่างหากกับวลีทางธุรกิจมาตรฐานอย่าง "please confirm receipt of this document" ที่แปลเป็นภาษาเยอรมัน ให้ผลลัพธ์ที่แทบจะเหมือนกันในทุกโมเดลที่ทดสอบ ซึ่งรวมถึง GPT-4o-mini และโมเดลเจเนอเรชัน GPT-5 ด้วย ช่องว่างระหว่างเจเนอเรชันจึงเกิดขึ้นเฉพาะกับภาษาเชิงเปรียบเทียบและภาษาที่กำกวม ไม่ใช่ความแตกต่างด้านคุณภาพโดยรวมทั้งหมด
GPT เจเนอเรชันที่ใหม่กว่าหมายถึงการแปลที่ดีกว่าเสมอไปหรือไม่?
ไม่ การทดสอบสำนวนภาษาฮีบรูข้ามตระกูลโมเดลพบว่า GPT-5.4-mini และ GPT-5.4 ตีความวลีเดียวกันออกมาสองแบบที่ต่างกันและถูกต้องเพียงบางส่วน โดยไม่มีโมเดลใดถูกต้องอย่างสมบูรณ์ ในขณะที่โมเดลรุ่นเก่ากว่าที่ไม่เกี่ยวข้องกันกลับแปลได้ใกล้เคียงมากกว่า โมเดลที่ใหม่กว่าไม่ได้แปลได้แม่นยำกว่าโดยอัตโนมัติเสมอไป และโมเดลที่ใหญ่กว่าหรือใหม่กว่าก็ไม่ได้เป็นตัวเลือกที่ปลอดภัยกว่าเสมอไปสำหรับประโยคใดประโยคหนึ่ง
จุดยืนของ GPT-5 สำหรับงานแปลในปัจจุบัน
ทั้ง GPT-3 และ GPT-4 ถูกปลดระวางจาก ChatGPT แล้ว โดย GPT-4 ยังคงเข้าถึงได้ผ่าน API ของ OpenAI สำหรับการเชื่อมต่อระบบที่มีอยู่เดิมเท่านั้น ส่วนรุ่นปัจจุบันอย่าง GPT-5.4 และ GPT-5.5 คือสิ่งที่ MachineTranslation.com ใช้งานอยู่ในปัจจุบัน และมีประสิทธิภาพที่แข่งขันได้ดีกับโมเดลรุ่นปัจจุบันจากผู้ให้บริการรายอื่น แม้ว่าจะไม่ได้เหนือกว่าในทุกคู่ภาษาอย่างเสมอหน้ากันก็ตาม สำหรับการเจาะลึกว่า sub-version ของ GPT ในปัจจุบันเปรียบเทียบกันเองและเทียบกับโมเดลอย่าง Claude และ DeepSeek เป็นอย่างไร โปรดดูการทดสอบ sub-version แบบตัวต่อตัวของ MachineTranslation.com ซึ่งจะลงลึกได้มากกว่าภาพรวมระดับเจเนอเรชัน
สิ่งนี้มีความหมายอย่างไรหากคุณกำลังทำ localization ในสเกลใหญ่
ข้อค้นพบที่สำคัญที่สุดสำหรับโปรแกรม localization ขนาดใหญ่ไม่ใช่ "GPT-5 เอาชนะ GPT-3" แต่คือเวอร์ชันของโมเดล ไม่ใช่แค่ตระกูลโมเดล ที่เป็นตัวกำหนดว่าสำนวนหรือวลีที่มีความกำกวมจะได้รับการแปลอย่างถูกต้องหรือไม่ และสิ่งนี้เป็นจริงในทุกคู่ภาษา ไม่ใช่แค่ไม่กี่ภาษาที่แสดงไว้ที่นี่ เรื่องนี้สำคัญที่สุดในเนื้อหาที่เน้นน้ำเสียงและภาษาเชิงเปรียบเทียบตั้งแต่แรก โดยเฉพาะ marketing copy และ user-generated content ซึ่งการแปลสำนวนตรงตัวเพียงสำนวนเดียวอาจเปลี่ยนความหมายทั้งหมดของโพสต์หรือโฆษณาได้ โปรแกรมที่แปลเนื้อหาเป็นภาษาต่างๆ หลายสิบภาษาย่อมต้องพบเจอกับภาษาประเภทนี้ในทุกๆ ภาษาอย่างแน่นอน ซีรีส์การทดสอบ sub-version และการทดสอบเปรียบเทียบโมเดลแบบเต็มรูปแบบของ MachineTranslation.com ครอบคลุมเรื่องนี้ในเชิงลึกยิ่งขึ้น แนวทางของแพลตฟอร์มที่รันโมเดล GPT รุ่นปัจจุบันควบคู่ไปกับโมเดลอื่นๆ อีกกว่า 20 โมเดลในการแปลทุกครั้งนั้น มีขึ้นโดยเฉพาะเพราะประวัติเวอร์ชันของโมเดลเพียงตัวเดียวไม่สามารถรับประกันความน่าเชื่อถือได้เพียงพอด้วยตัวมันเอง
คำถามที่พบบ่อย
1. ความแตกต่างที่แท้จริงระหว่าง GPT-3, GPT-4 และ GPT-5 สำหรับงานแปลคืออะไร?
GPT-3 จัดการกับข้อความที่ตรงไปตรงมาได้ค่อนข้างดี แต่ประสบปัญหาอย่างหนักกับข้อความที่เป็นสำนวนหรือมีความกำกวม GPT-4 ช่วยลดช่องว่างดังกล่าวลงได้อย่างมีนัยสำคัญ แต่ก็ยังยุบวลีที่มีความกำกวมจริงๆ ให้เหลือเพียงความหมายเดียวแทนที่จะรักษาความกำกวมนั้นไว้ ส่วน sub-version รุ่นหลังๆ ของ GPT-5 สามารถจัดการกับสำนวนที่โมเดลในยุค GPT-4 รุ่นก่อนๆ แปลตรงตัวและแปลผิดได้อย่างถูกต้อง
2. GPT-5 แปลได้ดีกว่า GPT-4 เสมอไปหรือไม่?
ไม่ การทดสอบของ MachineTranslation.com เองพบกรณีที่ sub-version ที่เล็กกว่าและใหม่กว่าทำผลงานได้ดีกว่าโมเดลที่ใหญ่กว่าและเก่ากว่า และช่องว่างด้านคุณภาพระหว่างเจเนอเรชันมักจะเกิดขึ้นเฉพาะกับภาษาที่เป็นสำนวนหรือภาษาเชิงเปรียบเทียบ มากกว่าจะเป็นการพัฒนาที่ดีขึ้นรอบด้านในภาพรวม
3. OpenAI ยังให้บริการ GPT-3 หรือ GPT-4 อยู่หรือไม่?
ไม่ ทั้งสองโมเดลถูกปลดระวางจาก ChatGPT แล้ว และถูกแทนที่ด้วยโมเดลในเจเนอเรชัน GPT-5 ที่ใหม่กว่า โดย GPT-4 ยังคงเข้าถึงได้ผ่าน API ของ OpenAI สำหรับการเชื่อมต่อระบบเดิมที่มีอยู่เท่านั้น ไม่ได้เป็นตัวเลือกสำหรับผู้ใช้งานทั่วไปในปัจจุบันอีกต่อไป
4. MachineTranslation.com ใช้ GPT เวอร์ชันใด?
MachineTranslation.com รันโมเดลเจเนอเรชัน GPT-5 ในปัจจุบัน (GPT-5.4 และ GPT-5.5 ขึ้นอยู่กับระดับแพ็กเกจ) ควบคู่ไปกับโมเดล AI อื่นๆ อีกกว่า 20 โมเดลในการแปลทุกครั้ง แทนที่จะพึ่งพา GPT เพียงอย่างเดียว
5. GPT-5 มีประสิทธิภาพอย่างไรเมื่อเทียบกับโมเดล AI อื่นๆ ในปัจจุบันสำหรับการแปลภาษา?
โมเดลเจเนอเรชัน GPT-5 มีประสิทธิภาพในระดับที่แข่งขันได้ แต่ไม่ได้ดีกว่าโมเดลอย่าง Claude, Gemini หรือ DeepSeek เสมอไปในทุกกรณี แต่ละโมเดลมีความโดดเด่นในคู่ภาษาและประเภทเนื้อหาที่แตกต่างกันไป ซึ่งเป็นเหตุผลที่ MachineTranslation.com นำโมเดลเหล่านี้มาทดสอบเปรียบเทียบกันโดยตรง แทนที่จะเลือกโมเดลใดโมเดลหนึ่งเป็นค่าเริ่มต้น