April 16, 2026
Grok vs ChatGPT สำหรับการแปล: คุณควรเลือกใช้ตัวไหนในปี 2026?
คุณน่าจะเปิดแท็บของหนึ่งในนั้นค้างไว้อยู่แล้ว คำถามคือ ผลลัพธ์ที่ได้นั้นมีความแม่นยำเพียงพอที่จะนำไปใช้งานหรือไม่ (สำหรับเอกสารของลูกค้า หน้าสินค้า หรือข้อกำหนดในสัญญา) โดยไม่ต้องเสียเวลาอีก 20 นาทีหลังจากนั้นเพื่อคอยระแวงและตรวจสอบทุกประโยคซ้ำ
บทความนี้เปรียบเทียบ Grok 4.1 และ ChatGPT (GPT-5.4) สำหรับการใช้งานด้านการแปลโดยเฉพาะ: สิ่งที่แต่ละโมเดลทำได้ดี จุดที่แต่ละโมเดลทำได้ไม่ดี และสิ่งที่คุณต้องการเมื่อไม่มีโมเดลใดที่ตอบโจทย์ได้ดีพอ
Grok คืออะไรและมีวิวัฒนาการอย่างไร?
Grok คือโมเดลภาษาขนาดใหญ่ที่พัฒนาโดย xAI บริษัท AI ที่ก่อตั้งโดย Elon Musk ในปี 2023 (ปัจจุบันเป็นส่วนหนึ่งของ SpaceX หลังจากการเข้าซื้อกิจการในเดือนกุมภาพันธ์ 2026) นับตั้งแต่เปิดตัว Grok ได้พัฒนาผ่านสี่เจเนอเรชันหลัก: Grok 1 (2023), Grok 2 (2024), Grok 3 (กุมภาพันธ์ 2025) และ Grok 4 (กรกฎาคม 2025) โดยมี Grok 4.1 พร้อมใช้งานตั้งแต่ปลายปี 2025
คุณลักษณะทางสถาปัตยกรรมที่โดดเด่นของ Grok คือการเข้าถึงข้อมูลแบบเรียลไทม์ แตกต่างจากโมเดลภาษาขนาดใหญ่ส่วนใหญ่ที่ได้รับการฝึกฝนด้วยชุดข้อมูลแบบคงที่ Grok ผสานรวมการค้นหาเว็บแบบสดและข้อมูลจากแพลตฟอร์ม X (เดิมคือ Twitter) เข้าไว้ในผลลัพธ์ของมัน สิ่งนี้ทำให้มันมีความสามารถที่โดดเด่นเป็นพิเศษสำหรับเนื้อหาที่เกี่ยวข้องกับเหตุการณ์ปัจจุบัน คำศัพท์ที่กำลังเกิดขึ้นใหม่ ภาษาในอุตสาหกรรมที่เพิ่งบัญญัติขึ้นใหม่ หรือข้อมูลต้นทางที่ต้องคำนึงถึงเรื่องเวลา — ซึ่งเป็นหมวดหมู่ที่โมเดลที่ได้รับการฝึกฝนจากข้อมูลชุดเก่าอาจนำเสนอสำนวนภาษาที่ล้าสมัยหรือพลาดบริบทล่าสุดไป
สำหรับการแปลโดยเฉพาะแล้ว การเข้าถึงข้อมูลแบบเรียลไทม์ของ Grok ถือเป็นข้อได้เปรียบที่แท้จริงในกรณีการใช้งานเฉพาะกลุ่มแต่มีความสำคัญ ได้แก่ การแปลเนื้อหาข่าว ข่าวประชาสัมพันธ์ ข้อมูลอัปเดตเกี่ยวกับกฎระเบียบ และเนื้อหาที่อ้างอิงถึงเหตุการณ์ปัจจุบันหรือคำศัพท์ที่เพิ่งเกิดขึ้นใหม่ การรองรับหลายภาษาของมันได้รับการปรับปรุงให้ดีขึ้นในโมเดลแต่ละรุ่นที่ตามมา Grok 4.1 มาพร้อมกับหน้าต่างบริบทขนาด 131K โทเค็น การแสดงผลหลายภาษาที่ได้รับการปรับปรุง และการใช้งานเครื่องมือแบบเนทีฟพร้อมการผสานรวมการค้นหาแบบเรียลไทม์
จุดที่ Grok ยังคงมีประสิทธิภาพด้อยกว่าเมื่อเทียบกับโครงสร้างพื้นฐานสำหรับการแปลโดยเฉพาะ คือ มันเป็นโมเดลอเนกประสงค์ ไม่ใช่โมเดลสำหรับการแปลโดยเฉพาะ มันสร้างผลลัพธ์เพียงอย่างเดียวโดยไม่มีกลไกการตรวจสอบภายใน คุณภาพของผลลัพธ์จะแตกต่างกันไปตามคู่ภาษาและประเภทของเนื้อหา และไม่มีการตรวจสอบข้ามโมเดลเพื่อดักจับผลลัพธ์เมื่อเกิดข้อผิดพลาด
ChatGPT คืออะไร และ GPT-5.4 เปลี่ยนแปลงอะไรบ้าง?
ChatGPT คือ AI เชิงสนทนาที่พัฒนาโดย OpenAI ซึ่งสร้างขึ้นบนสถาปัตยกรรม GPT (Generative Pre-trained Transformer) ของตนเอง เปิดตัวในเดือนพฤศจิกายน 2022 และกลายเป็นแอปพลิเคชันสำหรับผู้บริโภคที่เติบโตเร็วที่สุดในประวัติศาสตร์ โมเดลปัจจุบัน ณ เดือนเมษายน 2026 คือ GPT-5.4 ซึ่งเปิดตัวเมื่อวันที่ 5 มีนาคม 2026
สำหรับงานแปลภาษา ChatGPT เป็นหนึ่งใน LLM อเนกประสงค์ที่ทรงพลังที่สุดที่มีอยู่ในปัจจุบัน ในการทดสอบเกณฑ์มาตรฐานภายในของ MachineTranslation.com จากเนื้อหาผสมผสานระหว่างด้านเทคนิคและการตลาดจำนวน 5,000 คำ ChatGPT ทำคะแนนความแม่นยำได้ 89.8% — โดยทำผลงานได้ดีในด้านคุณภาพระดับผิวเผิน แต่มีการสร้างข้อมูลที่ไม่มีอยู่จริงในประโยคสำคัญสองประโยคระหว่างการทดสอบนั้น จากการทดสอบมาตรฐานทางวิทยาศาสตร์ที่เป็นอิสระ GPT-5.4 ทำคะแนนได้ 92.0% ในการทดสอบ GPQA Diamond (การให้เหตุผลทางวิทยาศาสตร์ระดับปริญญาเอก) ซึ่งแสดงให้เห็นถึงประสิทธิภาพที่ยอดเยี่ยมในเนื้อหาที่ซับซ้อนและอิงตามข้อเท็จจริงที่ความถูกต้องมีความสำคัญอย่างยิ่ง
ChatGPT รองรับภาษาต่าง ๆ มากมาย และสามารถจัดการกับโครงสร้างประโยคที่ซับซ้อน การใช้สำนวน และระดับภาษาที่เป็นทางการได้เป็นอย่างดีในคู่ภาษาหลักของยุโรปและเอเชีย จุดอ่อนในการแปลของมันเป็นเรื่องเชิงโครงสร้างมากกว่าเรื่องของคุณภาพ: เช่นเดียวกับระบบ AI แบบโมเดลเดี่ยวทุกระบบ มันไม่สามารถตรวจสอบผลลัพธ์ของตัวเองได้ เมื่อมันเกิดอาการประสาทหลอน (สร้างบทแปลที่ฟังดูสละสลวยแต่ผิดพลาดทางข้อเท็จจริงหรือความหมาย) ก็ไม่มีสัญญาณใดๆ แจ้งเตือนผู้ใช้
ความแม่นยำในการแปลของ Grok และ ChatGPT เมื่อเปรียบเทียบกันแล้วเป็นอย่างไร?
เครื่องมือทั้งสองให้ผลลัพธ์การแปลที่มีคุณภาพสูงสำหรับเนื้อหาทั่วไป ความแตกต่างที่มีนัยสำคัญจะปรากฏให้เห็นที่ขอบเขต — เมื่อเนื้อหามีความเฉพาะทาง เป็นเรื่องทางเทคนิค มีความอ่อนไหวต่อเวลา หรือมีเดิมพันสูง
จุดที่ Grok ได้เปรียบ: เนื้อหาเกี่ยวกับเหตุการณ์ปัจจุบัน คำศัพท์ที่เกิดขึ้นใหม่ และข้อมูลที่ต้องอาศัยบริบทที่เป็นปัจจุบัน การผสานรวมระบบค้นหาแบบเรียลไทม์ของ Grok หมายความว่ามันสามารถดึงรูปแบบการใช้งานล่าสุดมาใช้ได้เมื่อแปลบทความข่าว การเปิดตัวผลิตภัณฑ์ หรือการอัปเดตข้อบังคับ — ซึ่งเป็นเนื้อหาที่โมเดลที่ได้รับการฝึกฝนด้วยข้อมูลจากเมื่อหกเดือนก่อนอาจใช้สำนวนภาษาที่ล้าสมัย
จุดที่ ChatGPT ได้เปรียบ: เนื้อหาที่มีโครงสร้างและอัดแน่นไปด้วยข้อเท็จจริง — ข้อความทางวิทยาศาสตร์ กฎหมาย และทางเทคนิค ซึ่งความถูกต้องของคำศัพท์เฉพาะทางที่กำหนดไว้แล้วมีความสำคัญมากกว่าความเป็นปัจจุบัน คะแนนเบนช์มาร์ก GPQA ที่ 92.0% ของ GPT-5.4 และอัตราการกล่าวอ้างที่เป็นเท็จที่ต่ำกว่ารุ่นก่อนหน้า 33% ทำให้มันเป็นตัวเลือกที่แข็งแกร่งกว่าสำหรับการแปลระดับมืออาชีพที่มีความแม่นยำสูงของเนื้อหาต้นฉบับที่มีความซับซ้อน
สิ่งที่ไม่มีเครื่องมือใดทำได้: ตรวจสอบผลลัพธ์ของตนเอง โมเดล LLM ระดับแนวหน้าแต่ละตัว (รวมถึงทั้ง Grok และ ChatGPT) เกิดอาการประสาทหลอนหรือกุข้อมูลขึ้นมาเองประมาณ 10% ถึง 18% ของเวลาทั้งหมดในระหว่างการทำงานแปล อ้างอิงจากข้อมูลที่สังเคราะห์จากรายงาน State of Translation Automation 2025 ของ Intento และผลการศึกษา WMT24 General Machine Translation Findings สำหรับเนื้อหาที่เป็นมืออาชีพ ติดต่อกับลูกค้า หรืออยู่ภายใต้การควบคุมดูแล ช่วงดังกล่าวไม่ใช่ค่าความคลาดเคลื่อนที่ยอมรับได้
| Grok 4.1 | ChatGPT (GPT-5.4) | |
|---|---|---|
| เหมาะที่สุดสำหรับ | เนื้อหาที่อ่อนไหวต่อเวลาและเกี่ยวกับเหตุการณ์ปัจจุบัน | เนื้อหาที่มีโครงสร้าง เป็นทางเทคนิค และหนาแน่นไปด้วยข้อเท็จจริง |
| การเข้าถึงข้อมูลแบบเรียลไทม์ | ใช่ — มีการผสานรวมกับ X แบบสดและเว็บ | ไม่ — ข้อมูลการฝึกอบรมแบบคงที่ |
| เกณฑ์มาตรฐานความถูกต้อง | AIME 2025: 91.7% (การให้เหตุผลทางคณิตศาสตร์) | GPQA Diamond: 92.0% (การใช้เหตุผลทางวิทยาศาสตร์) |
| เกณฑ์มาตรฐานการแปล | ---- | 89.8% จากเนื้อหาแบบผสม 5,000 คำ (โดยมีประโยคที่เกิดอาการประสาทหลอน 2 ประโยค) |
| การตรวจสอบผลลัพธ์ | โมเดลเดี่ยว ไม่มีสัญญาณการตรวจสอบ | โมเดลเดี่ยว ไม่มีสัญญาณการตรวจสอบ |
| อัตราการเกิดอาการประสาทหลอน (โมเดลเดี่ยว) | 10–18% (Intento/WMT24) | 10–18% (Intento/WMT24) |
การรองรับภาษาของ Grok และ ChatGPT แตกต่างกันอย่างไร?
ChatGPT รองรับกลุ่มภาษาที่หลากหลายในทุกตระกูลภาษาหลัก มีประสิทธิภาพสูงสุดในคู่ภาษาของยุโรปและภาษาหลักในเอเชีย (จีน ญี่ปุ่น เกาหลี) โดยคุณภาพอาจมีความสม่ำเสมอน้อยกว่าบ้างในกลุ่มภาษาที่มีทรัพยากรน้อย
Grok ได้ขยายการรองรับหลายภาษาอย่างต่อเนื่องในรุ่นต่างๆ ของโมเดล Grok 4.1 ได้รับการปรับปรุงอย่างมีนัยสำคัญจากเวอร์ชันก่อนหน้าสำหรับผลลัพธ์ที่ไม่ใช่ภาษาอังกฤษ แม้ว่าจะยังคงเน้นไปที่คู่ภาษาที่มีทรัพยากรสูงซึ่งมีข้อมูลสำหรับฝึกสอนจำนวนมากก็ตาม
MachineTranslation.com รองรับมากกว่า 330 ภาษา โดยการรวบรวมโมเดล AI 22 โมเดลพร้อมกัน (รวมถึงทั้ง Grok และ ChatGPT) และเลือกผลลัพธ์ที่เสียงส่วนใหญ่เห็นพ้องต้องกัน สำหรับทีมที่ทำงานในหลายตลาดหรือคู่ภาษาที่พบได้น้อยกว่า แนวทางนี้ช่วยขจัดความจำเป็นในการประเมินเครื่องมือแต่ละชิ้นกับแต่ละภาษาแยกกัน
สำหรับคำแนะนำเกี่ยวกับคู่ภาษาเฉพาะ: อังกฤษเป็นสเปน, อังกฤษเป็นฝรั่งเศส, อังกฤษเป็นเยอรมัน
ราคาเปรียบเทียบกันอย่างไรระหว่าง Grok และ ChatGPT?
Grok (xAI):
- ระดับฟรี: ใช้งานได้ผ่าน X พร้อมสิทธิ์เข้าถึง Grok แบบจำกัด
- X Premium+: $22/เดือน — รวมสิทธิ์เข้าถึงแชทบอท Grok
- SuperGrok: $30/เดือน — เพิ่มขีดความสามารถ
- API (Grok 4.1): $0.20 per 1 million input tokens / $0.50 ต่อ 1 ล้านเอาต์พุตโทเคน — หนึ่งในอัตราค่าบริการ API ที่ต่ำที่สุดในตลาด LLM
ChatGPT (OpenAI):
- ระดับฟรี: ใช้งานได้โดยมีขีดความสามารถจำกัด
- ChatGPT Plus: $20/เดือน
- ChatGPT Pro: $200/เดือน
- API (GPT-5.4): $1.75 per 1 million input tokens / $14.00 ต่อ 1 ล้านโทเค็นเอาต์พุต
MachineTranslation.com:
- ฟรี: จำกัดการใช้งานรายวันโดยไม่ต้องสมัครสมาชิก ระบบจะรีเซ็ตการแปลทุก 24 ชั่วโมง
- แผน Pro: $39/เดือน — แปลได้ไม่จำกัด, ประมวลผลเอกสาร, คงรูปแบบเดิมไว้
- เข้าใช้งานได้เต็มรูปแบบ 24 ชั่วโมง: $9.50 (จ่ายครั้งเดียว ไม่มีต่ออายุอัตโนมัติ)
ราคา API ของ Grok ต่ำกว่าของ ChatGPT อย่างเห็นได้ชัด ซึ่งทำให้คุ้มค่าใช้จ่ายสำหรับการใช้งาน API ในปริมาณมาก อย่างไรก็ตาม สำหรับการแปลโดยเฉพาะ ค่าใช้จ่ายต่อโทเค็นเป็นเพียงมิติเดียวเท่านั้น — คุณภาพของผลลัพธ์ การตรวจสอบ และค่าใช้จ่ายในการแก้ไขข้อผิดพลาดมีความสำคัญเท่า ๆ กันในบริบทระดับมืออาชีพ
ระบบใดมี API ที่ดีกว่าสำหรับเวิร์กโฟลว์การแปล?
API ของ Grok เปิดให้บริการอย่างเต็มรูปแบบพร้อมกับการเปลี่ยนรูปแบบการคิดราคาตามการใช้งานจริงของ xAI ในเดือนตุลาคม 2025 ราคาอยู่ในกลุ่มที่ต่ำที่สุดในตลาด โดยอยู่ที่ $0.20 ต่อ 1 ล้าน input token (Grok 4.1) เอกสารประกอบการใช้งานได้รับการขยายเพิ่มขึ้นอย่างมากนับตั้งแต่ Grok 3 รุ่นเบต้า สำหรับนักพัฒนาที่สร้างไปป์ไลน์ซึ่งต้องการการรวมข้อมูลแบบเรียลไทม์ API ของ Grok ถือเป็นตัวเลือกที่แข็งแกร่ง
API ของ ChatGPT (OpenAI) เป็น API ของ LLM ที่มีความสมบูรณ์และมีเอกสารประกอบอย่างแพร่หลายที่สุดที่มีอยู่ รองรับการเรียกใช้งานฟังก์ชัน ผลลัพธ์ที่มีโครงสร้าง GPT แบบกำหนดเอง และระบบนิเวศการเชื่อมต่อที่กว้างขวาง ที่ราคา $1.75 ต่อ 1 ล้านอินพุตโทเค็นสำหรับ GPT-5.4 มันแพงกว่า Grok อย่างเห็นได้ชัด แต่ก็มีความสามารถในการปรับแต่งที่ลึกซึ้งกว่าและประวัติความเสถียรที่เวิร์กโฟลว์ระดับองค์กรมักต้องการ
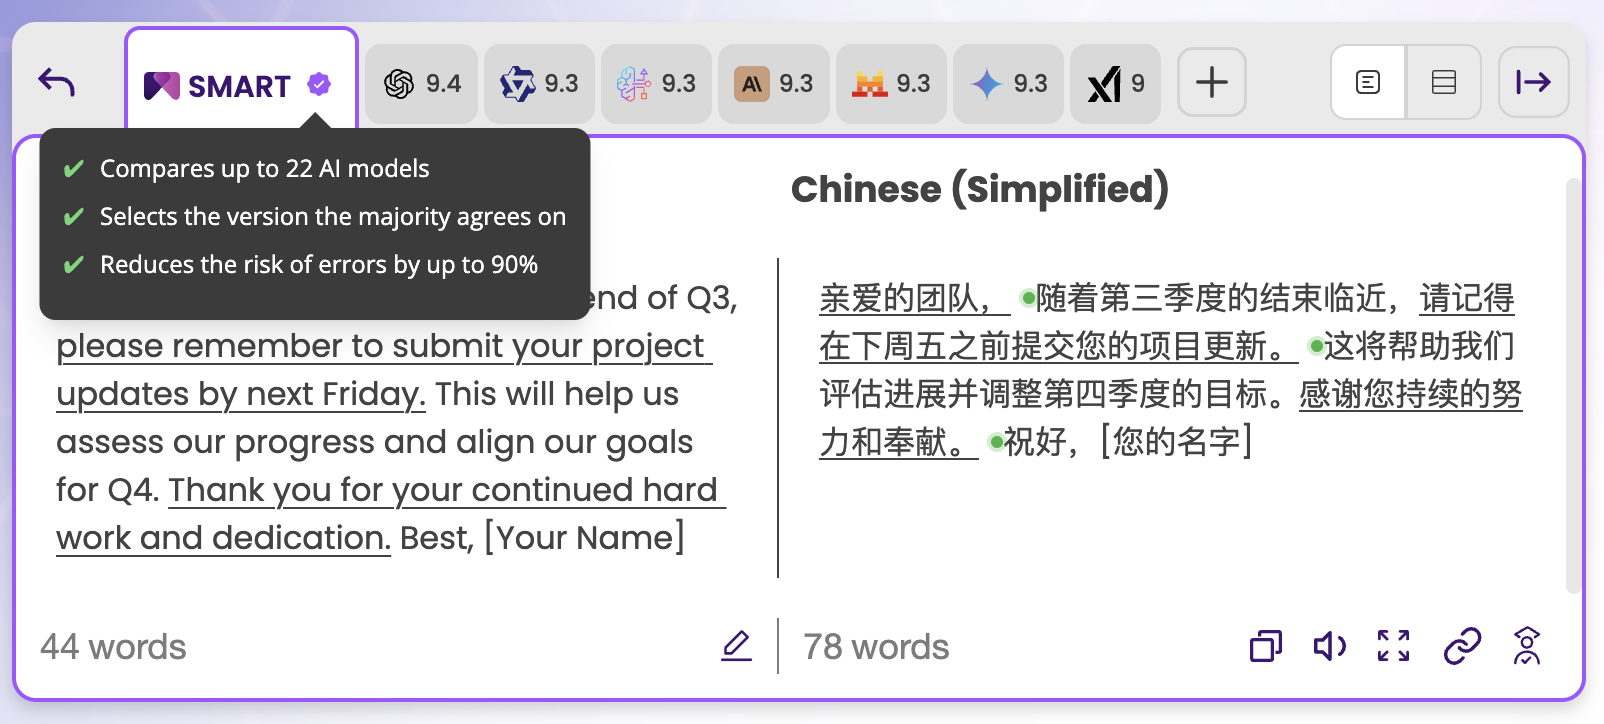
API ของ MachineTranslation.com จะส่งคำขอผ่านทั้ง 22 โมเดลพร้อมกัน (รวมถึงทั้ง Grok และ ChatGPT) และส่งคืนผลลัพธ์ฉันทามติแบบ SMART สำหรับนักพัฒนาที่ต้องการคุณภาพการแปลที่ได้รับการตรวจสอบแล้วในระดับสเกล การเรียกใช้ API เพียงครั้งเดียวจะช่วยลดความจำเป็นในการจัดการ ประเมิน และเปรียบเทียบการเชื่อมต่อระบบแปลภาษาหลายระบบแยกกันด้วยตนเอง
สำหรับภาพรวมของตัวเลือก API การแปลภาษาและราคา: การเปรียบเทียบ API การแปลภาษา
เครื่องมือใดดีกว่าสำหรับการแปลประเภทใด?
ใช้ Grok 4.1 สำหรับ:
- เนื้อหาเกี่ยวกับเหตุการณ์ปัจจุบัน บทความข่าว และข่าวประชาสัมพันธ์ที่บริบทที่ทันเหตุการณ์มีความสำคัญ
- การแปลเนื้อหาที่มีคำศัพท์ใหม่ ๆ หรือภาษาเฉพาะในอุตสาหกรรมที่เพิ่งบัญญัติขึ้น
- การแปลปริมาณมากที่มีความสำคัญไม่สูงมากนัก ซึ่งต้นทุนต่อโทเค็นเป็นปัจจัยหลักที่ต้องพิจารณา
- เนื้อหาที่อ้างอิงถึงเหตุการณ์ทางวัฒนธรรมล่าสุดหรือรูปแบบภาษาในโซเชียลมีเดีย
ใช้ ChatGPT (GPT-5.4) สำหรับ:
- เนื้อหาทางเทคนิค วิทยาศาสตร์ และวิชาชีพที่ความถูกต้องเชิงโครงสร้างมีความสำคัญ
- ข้อความทางกฎหมาย การเงิน หรือการแพทย์ที่มีคำศัพท์เฉพาะทางที่กำหนดไว้แล้ว
- เอกสารขนาดยาวที่ความสอดคล้องในการเชื่อมโยงเหตุผลตลอดทั้งข้อความมีความสำคัญ
- บริบทใดก็ตามที่มีการใช้งานการผสานรวมระบบนิเวศที่กว้างขวางของ GPT (Word, Notion, Zapier ฯลฯ) อยู่แล้ว
ในทั้งสองกรณี: ไม่มีเครื่องมือใดเลยที่ตรวจสอบความถูกต้องของผลลัพธ์ของตัวเอง และไม่มีเครื่องมือใดที่แสดงระดับความมั่นใจก่อนที่คุณจะส่งคำแปล
คุณจะทำอย่างไรเมื่อต้องการความถูกต้องแม่นยำอย่างแน่นอน?
ทั้ง Grok และ ChatGPT ต่างก็ให้ผลลัพธ์การแปลที่มีประโยชน์ พวกมันล้มเหลวในรูปแบบโครงสร้างเดียวกัน: โมเดลเพียงโมเดลเดียวไม่สามารถตรวจจับข้อผิดพลาดที่มันสร้างขึ้นเองได้ เมื่อ Grok แปลคำศัพท์ทางกฎหมายผิดพลาด หรือ ChatGPT เกิดอาการหลอนสร้างประโยคขึ้นมาสองประโยคในระหว่างกลางของเอกสารทางเทคนิค (เหมือนอย่างที่เกิดขึ้นในการทดสอบเปรียบเทียบมาตรฐานภายในขนาด 5,000 คำของ MachineTranslation.com) ก็ไม่มีอะไรในผลลัพธ์ที่บอกคุณได้ว่าสิ่งนั้นเกิดขึ้นที่จุดใด
นั่นคือปัญหาที่กลไก SMART ของ MachineTranslation.com ได้รับการออกแบบมาเพื่อแก้ไขโดยเฉพาะ SMART ส่งการแปลทุกรายการผ่านโมเดล AI 22 โมเดลพร้อมกัน (รวมถึง Grok และ ChatGPT ในจำนวนนั้นด้วย) จากนั้นจึงใช้การตรวจสอบฉันทามติ: คำแปลที่โมเดลส่วนใหญ่เห็นพ้องต้องกันจะได้รับการเลือก เนื่องจากอาการประสาทหลอนในการแปลเป็นเรื่องเฉพาะเจาะจงของแต่ละโมเดล ความเห็นพ้องระหว่างโมเดลจึงช่วยกรองสิ่งเหล่านั้นออกไปในเชิงโครงสร้าง
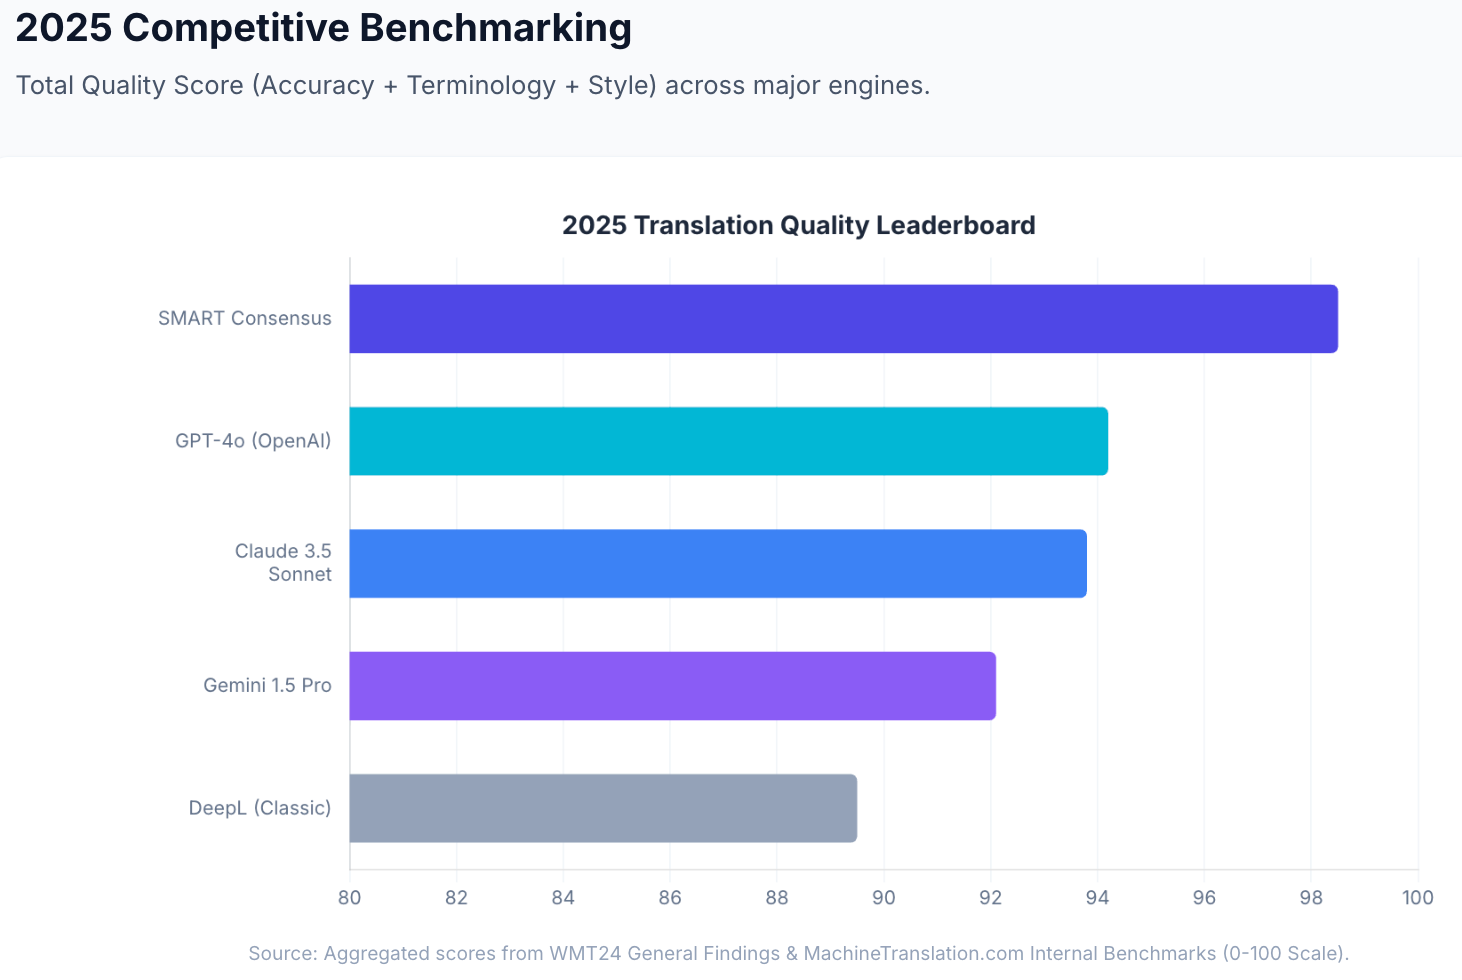
ผลการทดสอบเกณฑ์มาตรฐานภายในแสดงให้เห็นว่าแนวทางฉันทามติ SMART ได้รับคะแนนคุณภาพโดยรวม 98.5 จาก 100 คะแนน (เมื่อเทียบกับ GPT-4o ที่ได้ 94.2 ในชุดเกณฑ์มาตรฐานเดียวกัน) และลดความเสี่ยงของข้อผิดพลาดร้ายแรงในการแปลลง 90% การแปลที่ดำเนินการผ่าน SMART ช่วยลดข้อผิดพลาดร้ายแรงให้เหลือต่ำกว่า 2% เมื่อเทียบกับอัตราการหลอน (hallucination) ที่ 10–18% ของ LLM แบบโมเดลเดี่ยว ซึ่งรวมถึง Grok และ ChatGPT (ที่มา: รายงานภายในของ MachineTranslation.com; รายงานสถานะระบบอัตโนมัติของการแปลของ Intento ปี 2025; ข้อค้นพบเกี่ยวกับการแปลด้วยเครื่องทั่วไปของ WMT24)
สำหรับงานแปลที่ต้องการความถูกต้องแน่นอนอย่างสมบูรณ์ (การยื่นเอกสารทางกฎหมาย, เอกสารทางคลินิก, การยื่นเอกสารตามข้อกำหนดควบคุม) มีบริการตรวจสอบโดยมนุษย์พร้อมให้บริการภายในแพลตฟอร์มเดียวกัน ไม่มีหน่วยงานภายนอก รับประกันความแม่นยำ 100%
เริ่มแปลได้ที่ MachineTranslation.com — ฟรี ไม่ต้องสมัครสมาชิก รัน Grok, ChatGPT และโมเดล AI อื่นๆ อีก 20 โมเดลพร้อมกัน และรับคำแปลที่ทุกโมเดลเห็นตรงกัน
คำถามที่พบบ่อย
1. Grok ดีกว่า ChatGPT สำหรับการแปลหรือไม่?
ไม่มีตัวใดที่ดีกว่าอย่างชัดเจนในทุกงานแปล Grok 4.1 มีข้อได้เปรียบเฉพาะตัวในการแปลเนื้อหาเกี่ยวกับเหตุการณ์ปัจจุบันและข้อมูลที่มีคำศัพท์ใหม่ๆ เนื่องจากมีการบูรณาการข้อมูลเว็บและข้อมูลจาก X แบบเรียลไทม์ ChatGPT (GPT-5.4) เป็นผู้นำในด้านเกณฑ์มาตรฐานความถูกต้องเชิงโครงสร้าง และมีประสิทธิภาพมากกว่าสำหรับข้อความทางเทคนิค วิทยาศาสตร์ และกฎหมาย ทั้งสองมีข้อจำกัดหลักที่เหมือนกันคือ ในฐานะที่เป็นระบบโมเดลเดี่ยว ต่างก็ไม่สามารถตรวจสอบผลลัพธ์ของตัวเองได้
2. Grok สามารถแปลเอกสารได้หรือไม่?
Grok สามารถแปลข้อความที่วาง และแปลเอกสารที่อัปโหลดได้ ทั้งนี้ขึ้นอยู่กับแพ็กเกจการใช้งาน อย่างไรก็ตาม มันไม่ใช่เครื่องมือแปลภาษาโดยเฉพาะ และไม่มีฟีเจอร์อย่างเช่น การคงรูปแบบเดิม การให้คะแนนคุณภาพการแปล หรือการตรวจสอบข้ามโมเดล สำหรับการแปลเอกสารโดยยังคงรักษาโครงร่างเดิมไว้ MachineTranslation.com รองรับไฟล์ขนาดสูงสุดถึง 30MB ทั้งในรูปแบบ PDF, DOCX, TXT, CSV, XLSX และรูปภาพ
3. ChatGPT มีความแม่นยำเพียงใดในการแปลในปี 2026?
ในการทดสอบเปรียบเทียบภายในของ MachineTranslation.com จากเนื้อหาผสมผสานระหว่างด้านเทคนิคและการตลาดจำนวน 5,000 คำ ChatGPT ทำคะแนนความแม่นยำได้ 89.8% — ซึ่งถือว่าสูง แต่มีการสร้างข้อมูลที่ไม่มีอยู่จริงในสองประโยคระหว่างการทดสอบเดียวกัน ในการทดสอบมาตรฐานการให้เหตุผลทางวิทยาศาสตร์ (GPQA Diamond) GPT-5.4 ทำคะแนนได้ 92.0% เช่นเดียวกับ LLM แบบโมเดลเดี่ยวทั้งหมด อาการประสาทหลอนของ ChatGPT เกิดขึ้นในอัตรา 10–18% ในงานแปล ตามรายงาน Intento State of Translation Automation 2025 และผลการศึกษาของ WMT24
4. ราคาของ Grok ในปี 2026 อยู่ที่เท่าไหร่?
Grok สามารถเข้าถึงได้ผ่าน X Premium+ ($22/month) or SuperGrok ($30/เดือน) สำหรับการใช้งานทั่วไป API ของ xAI (Grok 4.1) มีราคาอยู่ที่ $0.20 per 1 million input tokens and $0.50 ดอลลาร์ ต่อ 1 ล้านโทเค็นเอาต์พุต ซึ่งเป็นหนึ่งในอัตราค่าบริการ API ที่ต่ำที่สุดในกลุ่ม LLM รายใหญ่
5. MachineTranslation.com ใช้ Grok และ ChatGPT หรือไม่?
ใช่ ทั้ง Grok และ ChatGPT เป็นหนึ่งในโมเดล AI ทั้ง 22 โมเดลที่ MachineTranslation.com ประมวลผลพร้อมกันผ่านระบบ SMART ของตน แทนที่จะพึ่งพาเครื่องมือใดเครื่องมือหนึ่งเพียงอย่างเดียว SMART จะเลือกคำแปลที่โมเดลส่วนใหญ่จากทั้งหมด 22 โมเดลเห็นพ้องต้องกัน — ซึ่งช่วยดึงจุดเด่นของแต่ละโมเดลออกมา ในขณะเดียวกันก็กรองข้อผิดพลาดเฉพาะตัวของโมเดลออกไป รายชื่อโมเดลทั้งหมดรวมถึง ChatGPT, Claude, Gemini, DeepL, Google, Grok และอีก 16 รายการ
6. เครื่องมือ AI ใดดีกว่าสำหรับการแปลเอกสารทางกฎหมายหรือทางการแพทย์?
สำหรับเนื้อหาที่อยู่ภายใต้กฎระเบียบ ลำพังเพียง Grok หรือ ChatGPT อย่างใดอย่างหนึ่งก็ไม่เพียงพอ — ทั้งคู่ต่างสร้างข้อมูลที่บิดเบือน (hallucination) ในอัตรา 10–18% ในงานแปล ซึ่งก่อให้เกิดความรับผิดทางกฎหมายโดยตรงสำหรับเอกสารทางกฎหมายและทางการแพทย์ ฉันทามติ SMART ของ MachineTranslation.com ช่วยลดอัตราความผิดพลาดนั้นให้เหลือต่ำกว่า 2% และมีบริการตรวจสอบโดยมนุษย์ในแพลตฟอร์มเดียวกัน พร้อมการรับประกันความถูกต้องแม่นยำ 100% สำหรับเนื้อหาที่จำเป็นต้องใช้
แปลภาษาด้วย Grok, ChatGPT และโมเดล AI อื่นๆ อีก 20 โมเดลพร้อมกันที่ MachineTranslation.com — ฟรี ไม่ต้องลงทะเบียน