June 5, 2026
AI เดียวกัน โมเดลต่างกัน — และการแปลก็ต่างกันอย่างสิ้นเชิง
ฉันกำลังทำการทดสอบภายในเกี่ยวกับบางสิ่งที่เราไม่ค่อยได้พูดถึงมากนัก ในอุตสาหกรรมการแปล: ไม่ใช่ว่าระบบ AI ที่แตกต่างกันแปล แตกต่างกันหรือไม่ แต่เป็นเวอร์ชันที่แตกต่างกันของ AI เดียวกันแปล แตกต่างกันหรือไม่ — และแตกต่างกันมากน้อยเพียงใด
สัปดาห์ที่แล้ว ฉันได้ทดสอบสำนวนภาษาสเปนเดียวผ่าน ChatGPT ห้าเวอร์ชัน พร้อมกันบนแพลตฟอร์มทดสอบภายในของ MachineTranslation.com ผลลัพธ์ที่ได้ทำให้ฉันหยุดคิด
สองเวอร์ชันให้ผลการแปลที่แท้จริงแล้วไม่มีความหมายใน ภาษาอังกฤษ สามเวอร์ชันผลิตคำแปลที่ถูกต้องตามสำนวน และทั้งสามคนที่ถูกต้องก็ไม่เห็นด้วยกับกันและกัน ทั้งห้าคนคือ
ChatGPT ทั้งหมดห้าอันเป็นของ OpenAI AI ตัวเดียวกัน โมเดลต่างกัน — และผลลัพธ์ก็ต่างกันสุดขั้ว
ที่ฉันแชร์เรื่องนี้ตอนนี้เพราะฉันคิดว่ามันสำคัญ ไม่ใช่เพราะฉันมีคำตอบที่ ชัดเจน ฉันไม่ แต่การสังเกตการณ์นั้นน่าสนใจพอที่จะ นำออกสู่โลกภายนอก
สารบัญ
- การทดสอบ: สำนวนสเปนหนึ่งสำนวน, ห้าเวอร์ชันของ GPT
- เหตุใดสำนวนนี้จึงเป็นกรณีทดสอบที่ดี
- การแยกความหมายตรงตัวกับสำนวนบอกอะไรเราเกี่ยวกับการฝึกฝนโมเดลเหล่านี้
- นัยที่ดูเหมือนจะไม่มีใครพูดถึง
- แม้แต่การแปลที่ ถูกต้อง ก็ยังขัดแย้งกันเอง
- สิ่งที่ฉันยังไม่รู้
- สองคำถามวิจัยที่ควรพิจารณา
การทดสอบ: สำนวนสเปนหนึ่งสำนวน, GPT ห้าเวอร์ชัน
วลีที่ฉันทดสอบคือ llevarse el gato al agua.
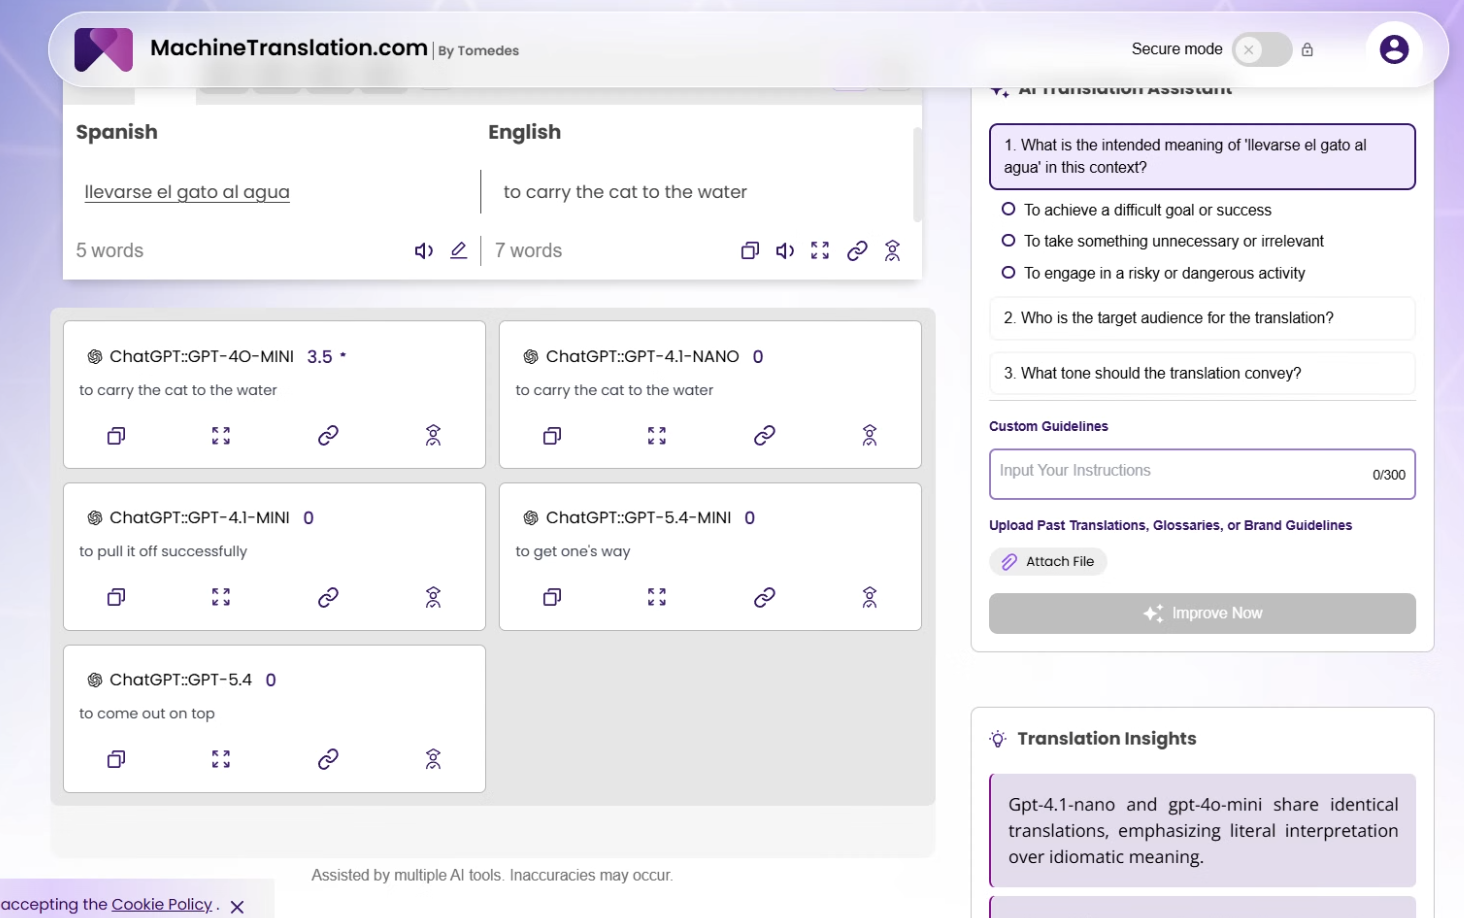
นี่คือสิ่งที่แต่ละเวอร์ชันสร้างขึ้น:
| โมเดล | ผลลัพธ์ | เป็นสำนวนหรือไม่? |
|---|---|---|
| ChatGPT::GPT-4o-MINI | แบกแมวไปที่น้ำ | ❌ ตรงตัว |
| ChatGPT::GPT-4.1-NANO | แบกแมวไปที่น้ำ | ❌ ตรงตัว |
| ChatGPT::GPT-4.1-MINI | ทำสำเร็จ | ✅ ถูกต้อง |
| ChatGPT::GPT-5.4-MINI | เอาชนะใจ | ✅ บางส่วน |
| ChatGPT::GPT-5.4 | เป็นผู้ชนะ | ✅ ถูกต้อง |
วลีนี้หมายถึงการบรรลุสิ่งที่ยากลำบากโดยเอาชนะอุปสรรค, การ คว้าชัยชนะที่ยากลำบาก มันไม่เกี่ยวกับแมวหรือน้ำเลย การแปลตามตัวอักษรไม่ใช่การแปล เป็นการถอดความทีละคำ ของวลีที่โมเดลไม่สามารถจดจำได้ว่าเป็นสำนวน.
GPT-4o-MINI และ GPT-4.1-NANO ให้ผลลัพธ์เหมือนกันทุกประการ ไม่เหมือนกัน เหมือนกันทุกประการ การแปลของเราได้ระบุสิ่งนี้โดยตรง: GPT-4.1-nano และ GPT-4o-mini มีการแปลที่เหมือนกัน โดยเน้นการตีความตามตัวอักษร มากกว่าความหมายเชิงสำนวน
GPT-4.1-MINI, GPT-5.4-MINI และ GPT-5.4 แต่ละตัวสร้างผลลัพธ์ที่ ถูกต้องพอที่จะจดจำได้ — แต่ไม่เหมือนกัน
เหตุใดสำนวนนี้จึงเป็นกรณีทดสอบที่ดี
ฉันต้องการระบุให้ชัดเจนว่าทำไม llevarse el gato al agua จึงเป็นอินพุตทดสอบที่มีประโยชน์ แทนที่จะเป็นอินพุตที่เลือกมาเฉพาะ
มันเป็นสำนวนที่ได้รับการยอมรับอย่างดี ปรากฏในวรรณกรรม วารสารศาสตร์ และการพูดในชีวิตประจำวัน มันไม่คลุมเครือ โมเดลใดๆ ที่ได้รับการฝึกฝนจากคลังข้อมูลภาษาสเปนที่สมเหตุสมผลควรจะเคยพบเจอ คำถามไม่ใช่ว่าโมเดลเคยเห็นวลีนั้นหรือไม่ คำถาม คือมันทำอะไรกับมัน ความล้มเหลวที่แย่ที่สุดในการแปลสำนวนไม่ใช่การแปลที่แย่ มันกำลังสร้างการแปลตามตัวอักษรที่ ดูเหมือนว่า ยอมรับได้สำหรับผู้ที่ไม่รู้ภาษาเป้าหมาย.
To carry the cat to the water เป็นภาษาอังกฤษที่ถูกต้องตามหลักไวยากรณ์ มัน ถูกสร้างขึ้นอย่างถูกต้อง ฟังดูเหมือนจะเป็นสิ่งที่อาจมีความหมายบางอย่าง ผู้ใช้ที่ไม่พูดภาษาสเปนอาจอ่านมัน พยักหน้า และก้าวต่อไป — โดยไม่รู้เลยว่าความหมายเดิมได้สูญเสียไปโดยสิ้นเชิง
นั่นคือโหมดความล้มเหลวที่ฉันใส่ใจ ไม่ใช่ข้อผิดพลาดที่เห็นได้ชัด ผู้ที่มองไม่เห็น .
สิ่งที่การแบ่งแยกตามตัวอักษรไปสู่สำนวนบอกเราเกี่ยวกับวิธีการฝึกโมเดลเหล่านี้
รูปแบบที่นี่ไม่ใช่เรื่องสุ่ม โมเดลทั้งสองที่สร้างการแปลตามตัวอักษร (GPT-4o-MINI และ GPT-4.1-NANO) เป็นโมเดลที่เล็กกว่า และเบากว่า ซึ่งปรับให้เหมาะสมกับความเร็วและประสิทธิภาพด้านต้นทุน โมเดลทั้งสาม ที่สร้างการแปลที่เป็นสำนวน (GPT-4.1-MINI, GPT-5.4-MINI, GPT-5.4) แสดงถึงรุ่นหรือ ขนาดพารามิเตอร์ที่แตกต่างกัน.
สิ่งนี้บ่งชี้ถึงสิ่งที่ฉันคิดว่ายังไม่ได้สำรวจอย่างเพียงพอ: ความสามารถทางสำนวนในการแปลจะเพิ่มขึ้นตามความจุของโมเดลในลักษณะที่ไม่ปรากฏในเกณฑ์มาตรฐานทั่วไป.
เกณฑ์มาตรฐานภาษาทั่วไปทดสอบการใช้เหตุผล ความรู้ การเขียนโค้ด คณิตศาสตร์ โดยทั่วไปแล้ว พวกเขาไม่ได้ทดสอบว่าโมเดลสามารถระบุได้หรือไม่ว่า วลีที่ว่า it's raining cats and dogs ไม่ได้เกี่ยวกับสภาพอากาศ หรือว่า llevarse el gato al agua ไม่ได้เกี่ยวกับการทำให้แมวได้รับน้ำ สำนวนต่างๆ อยู่ที่จุดตัดของความรู้ทางวัฒนธรรม การอนุมานตามบริบท และการจดจำรูปแบบ — และจุดตัดนั้นดูเหมือนจะ ต้องการความจุของโมเดลในระดับหนึ่งที่โมเดลขนาดเล็กไม่สามารถ ผ่านได้อย่างสม่ำเสมอ
สิ่งที่ฉันไม่ได้อ้างคือ: โมเดลขนาดใหญ่เป็นนักแปลที่ดีกว่าเสมอไป ฉันไม่มีหลักฐานสำหรับเรื่องนั้นตามกฎทั่วไป สิ่งที่ฉัน กำลังสังเกต: สำหรับเนื้อหาสำนวนโดยเฉพาะ ช่องว่างของเวอร์ชันภายในครอบครัวนั้นใหญ่กว่าที่ฉันคาดไว้
นัยที่ดูเหมือนจะไม่มีใครพูดถึง
ผู้ใช้ส่วนใหญ่ที่ใช้เครื่องมือแปลภาษา AI ไม่ทราบว่าเวอร์ชัน ของ AI นั้นคือเวอร์ชันใด พวกเขาเปิดผลิตภัณฑ์ เลือกคู่ภาษา และรับผลลัพธ์ การกำหนดเส้นทางโมเดลนั้นมองไม่เห็นสำหรับพวกเขา
สิ่งนี้มีความสำคัญเมื่อใช้งานในวงกว้าง MachineTranslation.com ประมวลผลงานแปลภาษาอังกฤษเป็นภาษาสเปนกว่าหลายแสนรายการในช่วงเวลา 90 วัน หากส่วนสำคัญของงานเหล่านั้นเกี่ยวข้องกับเนื้อหาที่เป็นสำนวน (ข้อความทางการตลาด ภาษาทางกฎหมาย ข้อความวรรณกรรม การสื่อสารทั่วไป) และเครื่องมือที่จัดการงานเหล่านั้นได้นำผู้ใช้ไปยังโมเดลที่เล็กกว่าโดยที่พวกเขาไม่ทราบ การแบกแมวไปหาน้ำ ก็จะปรากฏในผลลัพธ์จริง ในเอกสารจริง สำหรับคนจริงที่เชื่อถือผลลัพธ์นั้น อุตสาหกรรมการแปลได้ใช้เวลาหลายปีในการเปรียบเทียบผู้ให้บริการ AI DeepL เทียบกับ Google
โคลด ปะทะ แชทจีพีที การเปรียบเทียบเหล่านั้นมีประโยชน์ แต่ภายในผู้ให้บริการรายเดียว ช่องว่างของเวอร์ชันอาจมีความสำคัญเท่ากัน และเป็นช่องว่างที่กรอบการเปรียบเทียบส่วนใหญ่ไม่ได้วัดผล เนื่องจากไม่ได้ทดสอบในระดับเวอร์ชันของโมเดล เมื่อมีคนพูดว่า ฉันใช้ ChatGPT เพื่อการแปล ประโยคนั้นก็ไม่เฉพาะเจาะจงเพียงพอที่จะมีความหมาย
ChatGPT ตัวไหน? นาโน? 4o-มินิ? 4.1-มินิ? 5.4? คำตอบเปลี่ยนผลลัพธ์ในลักษณะ ที่ไม่ใช่เรื่องเล็กน้อย อย่างน้อยก็สำหรับเนื้อหาที่เป็นสำนวน.
แม้แต่การแปลที่ ถูกต้อง ก็ยังไม่ตรงกัน
นี่คือส่วนที่ฉันพบว่าน่าสนใจที่สุด และฉันยังไม่ได้คิดออกอย่างถ่องแท้ว่าจะทำอย่างไรกับมัน
โมเดลทั้งสามที่ให้การแปลที่เป็นสำนวนได้ให้ผลลัพธ์ที่แตกต่างกันสามแบบ :
- GPT-4.1-MINI: to pull it off successfully
- GPT-5.4-MINI: to get one's way
- GPT-5.4: to come out on top
ทั้งสามแบบสามารถอธิบายเป็นภาษาอังกฤษได้ว่า llevarse el gato al agua. แต่สิ่งเหล่านี้ไม่เท่าเทียมกัน ที่จะทำให้สำเร็จ
เน้นการดำเนินการที่ยากลำบาก คุณ ทำสิ่งที่ยากและมันก็ได้ผล การทำตามความต้องการของตนเองเน้น ผลลัพธ์ที่คุณต้องการให้สำเร็จ โดยเน้นที่ ความยากลำบากน้อยลง เป็นที่หนึ่ง เน้นชัยชนะในการแข่งขัน ชนะเหนือผู้อื่น
สำนวนสเปนดั้งเดิมใกล้เคียงกับความหมายแรกที่สุด วลีนี้มีความหมายแฝงของการเอาชนะการต่อต้าน ไม่ใช่แค่การเลือกผลลัพธ์อย่างใดอย่างหนึ่งและให้มันเกิดขึ้น แต่การ เอาชนะใจ และ เป็นฝ่ายชนะ นั้นไม่ผิด เพียงแต่ไม่แม่นยำในทิศทางที่ต่างกันเท่านั้นเอง สิ่งนี้ทำให้เกิดคำถามที่ฉันพบว่ายากจริงๆ: เมื่อโมเดลสามแบบแต่ละแบบให้การแปลสำนวนที่ถูกต้องแต่แตกต่างกัน คุณจะประเมินได้อย่างไรว่าอันไหนดีที่สุด
คะแนน BLEU เปรียบเทียบกับคำแปลอ้างอิงหนึ่งรายการ — แต่ใครเป็นคนเขียนคำแปลอ้างอิง และพวกเขาจะเลือกคำแปลใดจากสามรายการนี้? ตัวแทนแปลภาษา AI ของเรา ได้ถามคำถามที่ถูกต้องก่อนที่จะให้ผลลัพธ์ใดๆ:
ความหมายที่ตั้งใจของ 'llevarse el gato al agua' ในบริบทนี้คืออะไร มีสามทางเลือกให้เลือก — บรรลุเป้าหมายที่ยากลำบาก, เอาสิ่งที่ไม่จำเป็น, หรือทำกิจกรรมที่มีความเสี่ยง คำถามนั้นไม่ใช่คำถามประดับประดา เป็นกลไกที่ความกำกวมตามบริบท ได้รับการแก้ไขก่อนที่การแปลจะเสร็จสมบูรณ์
แต่ประเด็นยังคงอยู่: คำตอบที่ถูกต้องสามคำ, ความหมายที่แตกต่างกันสาม ระดับ เครื่องมือประเมินการแปลไม่ได้ถูกสร้างขึ้น สำหรับความแตกต่างเล็กน้อยประเภทนี้
สิ่งที่ฉันยังไม่รู้
ฉันต้องการที่จะซื่อสัตย์เกี่ยวกับข้อจำกัดของสิ่งที่การทดสอบนี้แสดงให้เห็น
สำนวนเดียว คู่ภาษาเดียว การทดสอบภายในหนึ่งวัน นั่นไม่ใช่การศึกษา เป็นข้อสังเกต ฉันไม่รู้ว่ารูปแบบนี้ (โมเดลขนาดเล็กที่ใช้การแปลตรงตัวตามค่าเริ่มต้น โมเดลขนาดใหญ่ที่ใช้สำนวน) ยังคงใช้ได้กับ: * สำนวนภาษาสเปนอื่นๆ * คู่ภาษาอื่นๆ ที่มีประเพณีสำนวนที่หลากหลาย (อาหรับ ญี่ปุ่น รัสเซีย นึกถึงได้ทั้งหมด) * เนื้อหาที่ไม่ใช่สำนวนซึ่งความแตกต่างไม่สามารถนำมาใช้ได้ * กรณีพิเศษที่โมเดลขนาดเล็กแปลสำนวนได้ถูกต้องและโมเดลขนาดใหญ่แปลผิด ฉันไม่รู้ด้วยว่านี่เป็นคุณสมบัติที่คงที่ของโมเดลเหล่านี้หรือไม่ หรือเป็นสิ่งที่เปลี่ยนแปลงไปตามการอัปเดตและการปรับแต่ง ผู้ให้บริการโมเดลไม่ได้เผยแพร่บันทึกการเปลี่ยนแปลงที่เฉพาะเจาะจงสำหรับการแปล โมเดลเวอร์ชันที่จัดการกับ llevarse el gato al agua ได้อย่างถูกต้องในวันนี้ อาจได้รับการอัปเดตในเดือนหน้า และเราจะไม่มีทางรู้ สิ่งที่ฉันรู้:
- การทดสอบนี้ให้ผลลัพธ์ที่น่าสนใจมากจนฉันต้องการทำการทดสอบเพิ่มเติมอย่างเป็นระบบมากขึ้น
- ในคู่ภาษาและประเภทเนื้อหาที่หลากหลายมากขึ้น
- มื่อฉันมีอะไรจะแบ่งปันอีก ฉันจะแบ่งปัน
คำถามวิจัยสองข้อที่ควรค่าแก่การพิจารณา
ฉันจะปิดท้ายด้วยคำถามสองข้อที่การทดสอบนี้ทิ้งไว้ให้ฉัน ฉันจะไม่ ตอบคำถามเหล่านั้น ฉันยังไม่มีข้อมูลเพียงพอที่จะทำเช่นนั้น แต่ ฉันคิดว่านี่เป็นคำถามที่ถูกต้องที่จะถาม
ประการแรก: ที่ขีดจำกัดพารามิเตอร์ใดที่ความสามารถในการใช้สำนวน จะเชื่อถือได้
การก้าวกระโดดจาก GPT-4o-MINI และ GPT-4.1-NANO (ทั้งคู่เป็นแบบตรงไปตรงมา) ไปสู่ GPT-4.1-MINI (แบบสำนวน) บ่งชี้ว่ามีขีดจำกัดอยู่ที่ใดที่หนึ่ง ในช่วงขนาดพารามิเตอร์ระหว่างขนาดโมเดลเหล่านั้น ซึ่งการจดจำสำนวน จะเปิดขึ้น มันสอดคล้องกันไหม สำนวน นี้ใช้ได้กับทุกภาษาหรือไม่ หรือขึ้นอยู่กับว่าภาษานั้นมีตัวแทนในข้อมูลการฝึกอบรมได้ดีเพียงใด ฉันไม่รู้ แต่การทราบ จะเป็นประโยชน์สำหรับทุกคนที่สร้างขั้นตอนการทำงานการแปล
ประการที่สอง: การไม่เปิดเผยเวอร์ชันของโมเดลมีค่าใช้จ่ายต่อผู้ใช้อย่างไรในวงกว้าง
หากผู้ใช้ส่งเอกสาร 1,000 ฉบับต่อเดือนผ่านเครื่องมือที่ ไม่เปิดเผยว่ากำลังใช้เวอร์ชันโมเดลใด (และเอกสารบางส่วน มีเนื้อหาที่เป็นสำนวน) ความล้มเหลวในการแปลตรงตัวเกิดขึ้นบ่อยเพียงใดโดยที่มองไม่เห็น? พวกเขาจะรู้ได้อย่างไร? ต้นทุนที่แท้จริงของการไม่เคยค้นพบคือเท่าใด?
ฉันคิดว่านี่เป็นคำถามที่สำคัญกว่าการเปรียบเทียบ AI ใดดีที่สุดสำหรับการแปล ส่วนใหญ่ที่ เผยแพร่อยู่ในขณะนี้ คำตอบไม่ใช่ ใช้โมเดลที่ใหญ่ที่สุด คำตอบอาจจะเป็น: รู้ว่าคุณกำลังใช้อะไร ทดสอบด้วยเนื้อหาของคุณเอง และอย่าสันนิษฐานว่าชื่อของผู้ให้บริการรายใดรายหนึ่ง เป็นการรับประกันพฤติกรรมที่สอดคล้องกันตลอดช่วงโมเดลของพวกเขา
นั่นคือ อย่างน้อยที่สุด คือสิ่งที่ฉันได้รับจากการทดสอบนี้
คำถามวิจัย
1. ขนาดของโมเดลสามารถทำนายคุณภาพการแปลสำนวนได้อย่างน่าเชื่อถือหรือไม่? จากการทดสอบเพียงครั้งเดียวนี้: โมเดลที่เล็กกว่าและปรับให้เหมาะสมกับประสิทธิภาพภายในตระกูล AI เดียวกัน จะแปลสำนวนสเปนที่จัดตั้งขึ้นอย่างเป็นรูปธรรมตามตัวอักษร
ในขณะที่เวอร์ชันที่ใหญ่กว่า/ใหม่กว่าของโมเดลเดียวกันจะสร้างการแปลสำนวนที่ถูกต้อง คำถามต่อไปคือสิ่งนี้จะใช้ได้กับหมวดหมู่สำนวนและคู่ภาษาทั้งหมดหรือไม่ ฉันจะทำการทดสอบเพิ่มเติม
2. ทำไม การแปลสำนวนที่ถูกต้อง สามแบบถึงให้ผลลัพธ์ที่แตกต่างกันอย่างมีความหมายสามแบบ? GPT-4.1-MINI, GPT-5.4-MINI และ GPT-5.4 ต่างก็แปลสำนวน ได้อย่างถูกต้องตามสำนวน แต่เป็นการแปลเป็นสำนวนภาษาอังกฤษที่แตกต่างกัน
โดยมีความหมายแฝงที่แตกต่างกันเล็กน้อย สิ่งนี้ชี้ให้เห็น ว่าคุณภาพของการแปลสำนวนมีอย่างน้อยสองมิติ: ไม่ว่าโมเดลจะรับรู้สำนวนนั้นหรือไม่ และ เลือกการแสดงออกที่เทียบเท่ากันจากตัวเลือกที่มีอยู่ ในภาษาเป้าหมาย ตัวชี้วัดคุณภาพการแปลมาตรฐานไม่สามารถแยกสองมิตินี้ออกจากกันได้อย่างชัดเจน ฉันคิดว่าพวกเขาควรจะทำเช่นนั้น.
โพสต์นี้อิงจากการทดสอบภายในบนแพลตฟอร์มการพัฒนาของ MachineTranslation.com การทดสอบหลายโมเดลที่แสดงไว้ ณ ที่นี้ ยังไม่เปิดให้สาธารณชนใช้งาน ฉันกำลังแบ่งปันสิ่งที่ค้นพบเพราะฉันคิดว่าข้อสังเกตนี้มีประโยชน์ไม่ว่าคุณจะแปลภาษาที่ไหนก็ตาม