September 25, 2026
从 GPT-3 到 GPT-5:AI 翻译质量究竟发生了怎样的变化
GPT-3、GPT-4 和 GPT-5 之间相隔了五年时间与数代架构演进,但对翻译而言,真正有价值的问题并非“哪一个最聪明”。这个问题更加聚焦:这些模型在处理语言中无法逐字直译的部分(如成语习语、歧义表达和语体风格)时,究竟发生了哪些具体变化?这种提升发生在特定的维度和节点上,并且并非从旧到新呈简单的线性发展。
GPT-3 究竟为翻译带来了什么
OpenAI 于 2020 年发布了 GPT-3,当时 MachineTranslation.com 自己的测试项目尚未建立,因此本文内容并非专有基准评测,而是有据可查的历史事实,并非内部测试结果。GPT-3 是首个无需针对特定任务进行训练、就能生成流畅且地道自然的多语言文本的同类模型,堪称真正的里程碑。但具体到翻译领域,这种流畅性却带来了切实的风险:GPT-3 可以在目标语言中生成看似自信、结构完好却仍然错误的句子,而其输出结果却没有任何迹象表明已经出错。
GPT-4 到来时带来了哪些改变
GPT-4 于 2023 年 3 月推出,MachineTranslation.com 自身的模型测试也大致从这一代开始跟进。其性能提升真实可见,却并不均衡。在将兼具多重涵义的英语短语“That's sick”翻译为日语的测试中,在受测的六个模型中,只有 GPT-4.1-nano 将该短语原意中的双重含义压缩成了单一解释,而其余五个模型都保留了原短语本意中的歧义感。成语习语则是更大的短板:在对五个 GPT 版本同时测试西班牙语成语“llevarse el gato al agua”时,体量较小的 GPT-4o-mini 和 GPT-4.1-nano 都给出了相同的字面直译错误,完全遗漏了成语本义。
同样的规律也出现在其他地方。在用八个 GPT 和 Claude 子版本测试德语成语“ich verstehe nur Bahnhof”时,GPT-4o-mini 给出了字面直译的错误翻译,而在同一次测试中,较小且较新的模型 GPT-4.1-nano 却翻译正确了。模型代际与模型大小之间并没有呈现出一致的对应关系,MachineTranslation.com 的模型版本测试对此进行了更深入的探讨。
GPT-5 为翻译带来了哪些改变
OpenAI 将 GPT-5 作为一个统一系统推出,该系统能够根据任务在快速默认模型与深度推理模型之间进行路由调度,这与 GPT-4 的单一模型设计相比是一项结构性变革。OpenAI 自己的 GPT-5 System Card 显示,该模型的总体事实错误率比 GPT-4 低约 45%,比 GPT-3 低 80%,这种通用可靠性的提升在翻译任务中同样得到了具体体现。MachineTranslation.com 的测试表明,在 GPT-4 时代模型表现最为挣扎的地方,其提升最为明显:对于 GPT-4o-mini 和 GPT-4.1-nano 均翻译错误的同一个西班牙语成语,GPT-5.4-mini 和 GPT-5.4 都给出了正确且地道的翻译,两者表述略有不同,但都准确理解了成语本身。
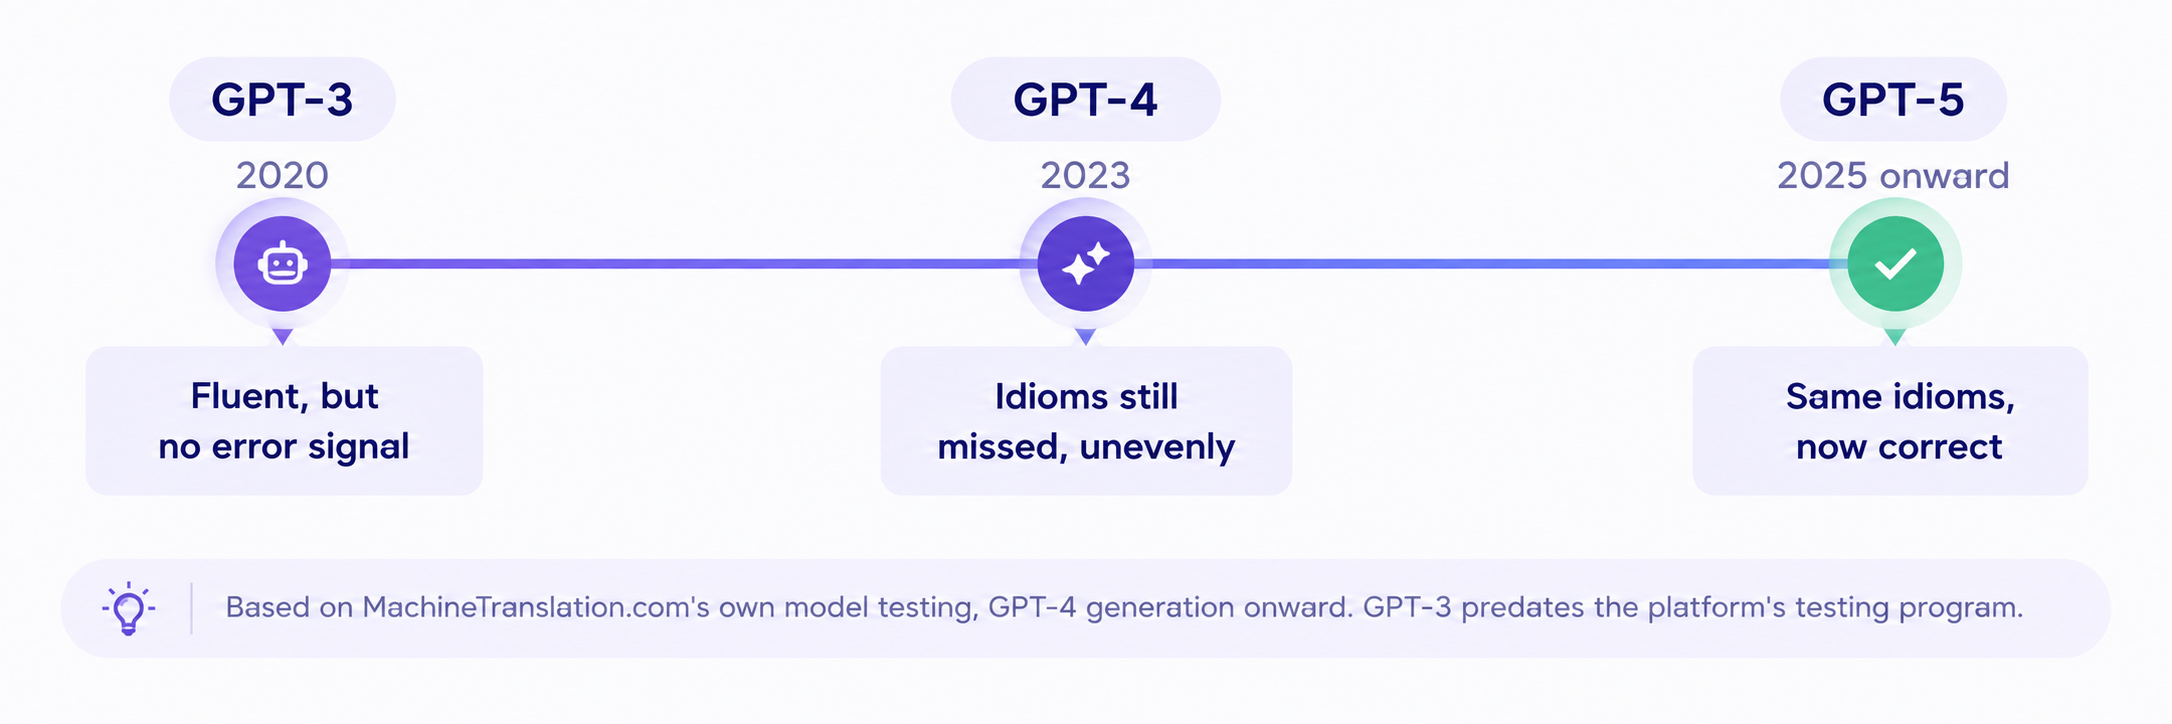
代际之间的差距并非稳步攀升,而是几乎完全集中在习语和歧义语言的处理上。在直白常规的文本上,GPT-4 时代和 GPT-5 时代模型的得分几乎完全一致。
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| 发布时间 | 2020 | 2023 年 3 月 | 2025年,现为 GPT-5.4/5.5 |
| 目前是否可用 | 否,已停用 | 仅限 API,已从 ChatGPT 下线 | 是,当前一代 |
| 习语处理 | MachineTranslation.com 未测试(早于该评测项目推出) | 表现不稳定;完全未能识别多个习语 | 正确处理了 GPT-4 漏译的相同习语 |
| 标准商务文本 | MachineTranslation.com 未测试 | 表现强劲,与后续模型几乎一致 | 表现强劲,与 GPT-4 几乎一致 |
最后一点至关重要:在另一项针对标准商务短语“please confirm receipt of this document”翻译成德语的独立测试中,包括 GPT-4o-mini 和 GPT-5 代模型在内的所有受测模型给出的结果几乎完全一致。代际差距仅体现在比喻性和歧义性语言的处理上,而非整体质量上的全面差异。
更新一代的 GPT 是否总意味着更好的翻译?
并不如此。在跨模型系列测试一个希伯来语习语时,GPT-5.4-mini 和 GPT-5.4 对同一短语给出了两种不同且不完整的解释,两者均未完全正确,而一个更早期的非相关模型反而更接近正确答案。更新的模型并不自然意味着更准确,对于给定的句子,更大或更新的模型也并不自然是更稳妥的选择。
GPT-5 当下的翻译水平如何
GPT-3 和 GPT-4 均已从 ChatGPT 中退役;GPT-4 仅能通过 OpenAI 的 API 供现有集成使用。当前一代的 GPT-5.4 和 GPT-5.5 是 MachineTranslation.com 目前运行的模型,与其他提供商的当前模型相比,它们展现出了很强的竞争力,尽管并非在每个语言对上都全面占优。欲详细了解当前 GPT 子版本之间的对比,以及它们与 Claude 和 DeepSeek 等模型的横向测评,请参阅 MachineTranslation.com 的子版本直接对比测试,该测试比代际概述更为深入。
这对大规模本地化意味着什么
对于大型本地化项目而言,最重要的发现并非“GPT-5 击败了 GPT-3”。而是具体的模型版本(而不仅是模型系列)决定了特定习语或歧义短语能否被正确翻译,并且这一点适用于每一个语言对,而不仅仅是这里展示的少数几个。对于本就侧重语气和比喻性语言的内容——尤其是营销文案和用户生成内容——这一点最为重要,在这些内容中,一个被直译的习语就可能改变整篇帖子或广告的含义。一个将内容翻译成数十种语言的项目,在每一种语言中都会遇到这类表达。MachineTranslation.com 的子版本测试系列和完整模型对比测试对这一问题进行了更深入的探讨。该平台在每次翻译中让当前 GPT 模型与 20 多个其他模型并行运行,其原因正是没有任何单一模型的版本迭代能够独自提供足够可靠的保障。
常见问题
1. GPT-3、GPT-4 和 GPT-5 在翻译方面的真正区别是什么?
GPT-3 能够较好地处理通俗直白的文本,但在应对任何习语或歧义表达时表现非常吃力。GPT-4 显著缩小了这一差距,但仍将一些确实具有多义性的短语归结为单一含义,未能保留原有的歧义。GPT-5 的较新子版本则正确处理了早先 GPT-4 时代模型直译出错的习语。
2. 在翻译方面,GPT-5 是否总是优于 GPT-4?
并非如此。MachineTranslation.com 自身的测试发现,在某些情况下,较小、较新的子版本表现反而优于较大、较旧的子版本,而且代际之间的质量差距往往体现在习语或比喻性语言上,而非全面的普遍提升。
3. OpenAI 目前还提供 GPT-3 或 GPT-4 吗?
不提供了。两者均已从 ChatGPT 中退役,并由更新的 GPT-5 代模型取代。GPT-4 仅作为现有集成通过 OpenAI 的 API 提供访问,不再面向普通消费者。
4. MachineTranslation.com 使用哪个 GPT 版本?
MachineTranslation.com 在每次翻译中运行当前的 GPT-5 代模型(根据方案级别使用 GPT-5.4 和 GPT-5.5),并与 20 多个其他 AI 模型协同工作,而不是仅仅依赖 GPT。
5. 在翻译方面,GPT-5 与当前其他 AI 模型相比表现如何?
GPT-5 代模型的表现颇具竞争力,但并非全面优于 Claude、Gemini 或 DeepSeek 等模型。不同的模型在不同的语言对和内容类型上各有胜出,这也是为什么 MachineTranslation.com 会直接对它们进行相互对比测试,而不是默认选择某一个模型。