May 15, 2026
Claude vs. Qwen 翻译对比:每个模型实际上在何处领先
2025年7月,Alibaba发布了Qwen3-MT —— 一款专为翻译构建的机器翻译模型,而非为此重新调整用途的通用LLM。经过数万亿多语言和翻译 token 的强化学习训练,它支持 92 种语言,并在 WMT24 多语言基准测试中取得了与 GPT-4.1 和 Gemini 2.5 Pro 相当的 BLEU 评分,同时在中英和英德测试集上超越了 GPT-4.1-mini 和 Gemini 2.5 Flash。来源:Alibaba Qwen, qwenlm.github.io, July 2025.
由 Anthropic 开发的 Claude 没有专门针对翻译的变体。它是一个通用大语言模型,在处理翻译的同时,还支持推理、编程、分析和写作。它的翻译质量非常出色(在独立评估中通过欧洲语言对得到了证实),但它不像 Qwen3-MT 那样是从头开始专为翻译而构建的。
这种不对称性定义了2026年的对比。Qwen 带来了两项独特的资产:具有深厚中文源训练的通用 Qwen LLM,以及一个专用的翻译模型。Claude在欧洲语言质量和语气精准度方面具有经证实的卓越表现。理解它们各自的领先方向,意味着要理解其结构优势所体现的语言家族和内容类型。
什么是 Qwen,自 2025 年以来发生了什么变化?
Qwen 是阿里云的大语言模型系列,在中文和亚洲语言处理方面具有独特优势,这反映了其训练来源和商业部署背景。
自本文原始版本发布以来,Qwen 系列已显著扩展。截至2026年5月:
Qwen 3.5 (2026年3月) — 当前的通用 Qwen LLM,参数规模跨越 0.5B 到 397B 以上。基于20+万亿token进行训练,凭借卓越的中文词汇量和语义深度,它在中文、日文和韩文基准测试中处于领先地位,并已部署于90,000+家企业。开发者分析确认:在中文、日文和韩文文本处理方面,没有开源模型能与 Qwen 匹敌。来源:AI Magicx, March 2026.
Qwen3-MT (July 2025) — Alibaba 的翻译专用模型,基于 Qwen3 架构构建,搭载轻量级 Mixture-of-Experts 骨干网络。专为跨92种语言的翻译进行了强化学习训练,它在 WMT24 多语言基准测试中取得了与 GPT-4.1 和 Gemini 2.5 Pro 相比极具竞争力的性能——且计算成本显著降低。这使得 Qwen 成为少数几个拥有专为翻译构建的模型的 AI 提供商之一。来源:Marktechpost,2025年7月。
MachineTranslation.com 的 SMART 系统中使用的 Qwen 是通用的 Qwen LLM,具体而言,根据 Intento 的 2025 年系统文档,是 Qwen 2.5 72B Instruct Turbo 和 QwQ 32B 变体。
Claude目前处于 Sonnet 4.6 和 Opus 4.6(2026年2月)。Claude没有翻译专用的变体;其所有的翻译能力都源自其通用训练。Claude 4 延续了 Claude 3.5 和 3.7 所确立的发展轨迹——在欧洲语言对、语气精准度以及专业内容的上下文理解方面表现强劲。
Qwen 在翻译方面有哪些结构性优势?
Qwen 的优势是结构性的,且深植于其训练源头:中文、日文和韩文内容最能体现 Qwen 的深度。
中文语言处理。Qwen是由Alibaba从零开始训练的,以中文作为主要语言而非次要语言。大多数源自西方的LLM(包括 Claude)主要使用英文数据进行训练,并加入了其他语言。Qwen的训练语料库反映了中文书面语在各种语体、领域和历史时期中的深厚底蕴。对于商务中文翻译、中译英翻译以及含有文化内涵表述的中文内容,Qwen 的训练深度能生成更自然、更少“翻译腔”的输出。
Intento 的 2025 年评估发现,简体中文表现优异,在所评估的解决方案中未检测到任何重大或严重错误,部分原因在于针对中文表现最佳的模型包括了经过深厚中文训练的系统。Qwen3-MT 特别在中英测试集上取得了领先的 BLEU 得分,在该语言对上超越了 GPT-4.1-mini 和 Gemini 2.5 Flash。来源:Qwen官方博客,2025年7月。
日语和韩语。更广泛的 CJK(中文、日文、韩文)语言组呈现出与欧洲语言在结构上不同的翻译挑战——不同的书写系统、不同的语序、不同的敬语和语域系统。Qwen的训练在中文之外,还包括对日语和韩语的深度覆盖。对于针对亚洲市场构建多语言产品的开发团队而言,Qwen 的 CJK 性能意味着在结构上最具挑战性的语言对上,译后编辑工作更少。
开源的可及性与成本。Qwen的开放权重模型可以部署在本地或自定义基础设施上。这为数据敏感型组织(即翻译机密文件、医疗记录或专有商业内容的组织)提供了完全在自身环境中运行 Qwen 的选择,而无需让数据离开其基础设施。Claude 是一个闭源的、仅限 API 的模型;没有自托管选项。
使用 Qwen3-MT 进行的翻译专用训练。专用翻译模型的存在,为 Qwen 提供了一个 Claude 所不具备的选择:在这个模型中,每一个训练决策都是专门为了提升翻译质量、而非通用能力而做出的。对于构建翻译优先工作流的团队,Qwen3-MT的强化学习方法(直接针对翻译忠实度而非通用语言质量进行优化)可以在标准专业内容上产生更一致的输出。
Claude在翻译方面有哪些结构性优势?
Claude的优势在于欧洲语言质量、语气和语域的精准度,以及在专业和文学内容上经证实的表现。
欧洲语言对。在 Intento 2025 年的人工 LQA 评估中,Claude (Opus 4 and Sonnet 3.7) 在英语译德语、英语译意大利语、英语译荷兰语、英语译法语以及英语译阿拉伯语中均位列“最佳”类别。这些是独立的、人工评分的评估——而非自行报告的基准。在同一评估中,Qwen并未进入欧洲语言对的第一梯队。对于欧洲专业内容,Claude 在各项独立评估中的表现更为强劲。
语气精准度与语域。Claude的训练高度重视自然语言等效性和语气忠实度。由 AI Tool Clash(2026年2月)进行的200句独立测试发现,Claude 综合得分 8.3/10,而 ChatGPT 为 7.9,其中习语字面直译错误显著更少(8% 对比 34%),且对文学语调和语域的保留能力更强。虽然这次对比是 Claude 对比 ChatGPT,而非 Claude 直接对比 Qwen,但它反映了 Claude 在上下文理解方面已被证实的优势,尤其适用于语气并非次要因素的内容。
西方语境中的专业且正式的内容。对于注重西方商业语体、法律正式性或欧洲文化背景的内容(如德语合同、面向法国受众的营销内容、意大利语的企业传播),Claude 源自西方的训练赋予了其深层的文化语境,而这正是 Qwen 并未优先考虑的。
长文档在语气内容上的一致性。Claude Sonnet 4.6 的 200K-token 上下文窗口和 Claude Opus 4.6 的 1M-token beta 窗口支持无需分块的完整文档处理。对于叙事内容、营销活动或需要在整个文档中保持一致语气的长篇报告,Claude 的上下文处理能力可以将语域和语调一致性维持在适合专业评审的水平。
针对特定内容类型,它们相比如何?
| 内容类型 | 更优选择 | 原因 |
|---|---|---|
| 中英 / 英中 | Qwen | 原生训练深度;Qwen3-MT 翻译专用模型;Intento 发现其在中文方面表现卓越 |
| 日韩内容 | Qwen | CJK 训练深度;没有西方源头的 LLM 能在 CJK 处理上媲美 Qwen |
| 欧洲语言(德语、意大利语、荷兰语、法语) | Claude | Intento 2025 德语、意大利语、荷兰语顶级水平;独立的评估地位 |
| 文学及语气敏感型翻译 | Claude | AI Tool Clash 综合评分 8.3/10;文学段落评分 9.2/10;强大的语域保留能力 |
| 歧义源文本 | Claude | 呈现两种解释,而不是仅局限于其中一种 |
| 机密 / 本地托管工作流 | Qwen | 开放权重部署;无 API 依赖;数据保留在本地 |
| 翻译优先的 API 工作流 | Qwen3-MT | 专为翻译构建的模型;针对忠实度进行了强化学习(RL)优化;支持 92 种语言 |
| 通用专业欧洲内容 | 两者皆可 | 两者均能以相当的质量水平覆盖高资源欧洲语言对 |
跨内容类型的模式反映了结构性的训练差异:Qwen适用于亚洲语言和特定翻译部署,Claude适用于欧洲语言质量和依赖语气精准度的内容。对于不属于这两种极端情况的内容(高资源语言中的通用专业交流),两者之间的差异,其影响远没有其中任何一个模型与经过验证的共识输出之间的差异那么大。
当两者都是同一系统的一部分时,该如何选择
Qwen 和 Claude 都在 MachineTranslation.com 的 SMART 系统的 22 个模型之列。SMART同时运行全部22个模型(包括 Qwen (Qwen 2.5 72B Instruct Turbo, QwQ 32B) 和 Claude (Sonnet 4.6等效级别)),并返回大多数模型达成一致的输出,同时附带翻译质量评分。
特别是针对中译英或英译中内容,SMART系统结合了 Qwen 的CJK深度、Claude 的语气理解、Google广泛的中文语料库以及其他19个模型。当 Qwen 的中文训练输出与 Claude 对同一段落的上下文解读一致时,这种一致性就是一个强烈的质量信号。当它们产生分歧时(相比清晰的标准文本,这更容易发生在模棱两可的段落或含有文化背景的内容中),MachineTranslation.com 会呈现这种不确定性,而不是给出一个自信的错误答案。
在 MachineTranslation.com 的内部基准测试中,包括 Claude 和 Qwen 在内的单个顶尖模型在翻译质量上达到了 93–94 分(满分 100 分)。22模型共识达到98.5/100。
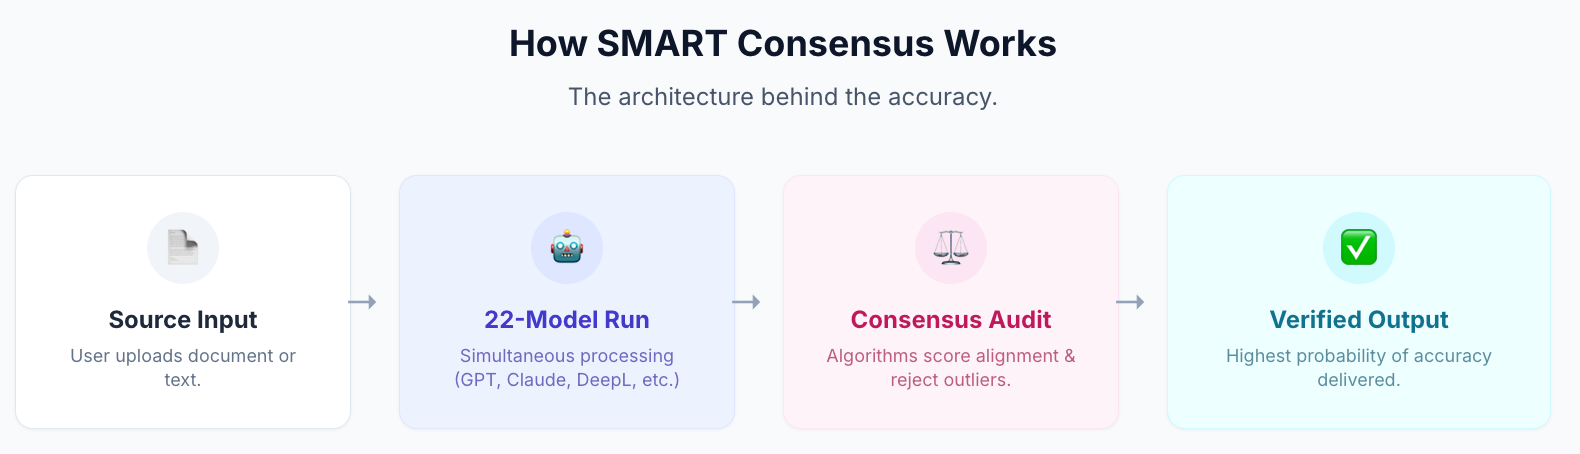
对于高风险内容(法律呈递材料、临床文档、受监管材料),人工验证会将共识结果升级至同一平台内的认证专业审核员。100%准确率保证。
使用 Qwen、Claude 以及其他 20 种模型在 MachineTranslation.com 进行翻译 —— 免费,无需注册。
常见问题
1.在中文翻译方面,Qwen 比 Claude 更好吗?
对于中译英和英译中,Qwen 具有结构性优势:它是由 Alibaba 从零开始基于中文语言数据训练的,中文是其主要训练语言,而非次要语言。Alibaba也在2025年7月发布了Qwen3-MT——这是一款翻译专用模型,在中英测试集上取得了领先的BLEU得分,表现优于GPT-4.1-mini和Gemini 2.5 Flash。特别是针对中文翻译,Qwen 是有据可查的更强选择。
2。对于欧洲语言,Claude比Qwen更好吗?
是的,基于独立评估。Claude Opus 4 和 Sonnet 3.7 在 Intento 的 2025 年英语至德语、意大利语、荷兰语和法语的人工 LQA 评估中位列第一梯队。在同一评估中,Qwen并未出现在欧洲语言对的第一梯队中。对于注重语域和语气的欧洲专业内容,Claude的独立评估地位更强。
3.什么是 Qwen3-MT?
Qwen3-MT (qwen-mt-turbo) 是 Alibaba 于 2025 年 7 月发布的一款机器翻译模型,基于 Qwen3 架构构建。与通用 LLMs 不同,它是专门为翻译设计和训练的——采用了轻量级的 Mixture-of-Experts 骨干网络和针对翻译保真度进行优化的强化学习。它支持 92 种语言,在 WMT24 基准测试中实现了与 GPT-4.1 和 Gemini 2.5 Pro 相比具有竞争力的性能,并包含高级定制选项,包括术语干预和领域提示。
4.Qwen可以在本地运行以进行机密翻译吗?
可以。Qwen 的开放权重模型可以部署在本地基础设施上,无需将数据发送到外部 API。这使得 Qwen 成为具有严格数据主权要求的机构的选择——例如翻译机密文件的医疗机构、法律团队和金融机构。Claude是一个闭源、仅限API的模型,不提供自托管选项。
5。哪个更适合日语和韩语翻译?
Qwen.开发者分析一致认为 Qwen 是用于 CJK(中文、日文、韩文)处理的最强开放模型。其在亚洲语言方面的训练深度,反映了 Alibaba 在亚洲市场 90,000+ 家企业中的商业部署背景。在当前的基准测试中,没有源自西方的开源模型在 CJK 文本处理方面能与 Qwen 媲美。
6.Qwen和Claude在MachineTranslation.com上都可以使用吗?
是的。两者均在MachineTranslation.com的SMART系统的22个模型之列。每次 SMART 翻译都会同时运行 Qwen、Claude 以及其他 20 个模型,并返回大多数模型达成一致的输出结果。特别是针对中文内容,在同一个共识中同时具备 Qwen 的 CJK 深度和 Claude 的上下文理解能力显得尤为宝贵。
7.自最初的对比(Claude 3.7 vs Qwen 2.5)以来,这两种模型发生了哪些变化?
Claude 已升级至 Sonnet 4.6 和 Opus 4.6(2026年2月),在指令遵循、推理以及多语言能力方面均有所提升。Qwen 已在通用模型上升级至 Qwen 3.5 (March 2026),并发布了 Qwen3-MT (July 2025) —— 一款在最初对比时还不存在的翻译专用模型。每个模型所持有的结构性优势(Qwen 针对 CJK,Claude 针对欧洲语言)在历代中始终保持一致。