May 8, 2026
Grok vs. Claude 翻译对比:基准测试结果表明了什么 (2026)
Grok (xAI) 和 Claude (Anthropic) 都是功能强大的 AI 翻译工具,但它们在结构上有着不同的优势。 对于大多数通用翻译任务,您不会注意到它们之间有明显的区别。 对于两种特定场景(翻译关于近期事件的内容,以及翻译需要精确度的正式文件),这种差异是真实存在的,并且源于每个模型的构建方式。
本文涵盖了每个模型在翻译方面实际提供的内容、独立基准测试对它们的定位,以及当任何一个模型单独的输出都不足时该使用什么。
Grok 和 Claude 在翻译质量上相比如何?
简短的回答: Claude在独立专业翻译基准测试中处于领先地位。 Grok 的具体优势在于实时知识获取,而非整体翻译质量。
在 MachineTranslation.com 的内部基准测试中,Claude(3.5 Sonnet 级别)在翻译质量(结合了准确性、术语和风格)上得分 93.8(满分 100 分)。 Grok并未出现在Intento的State of Translation Automation 2025前14个解决方案中,该报告在11个语言对中评估了46个MT引擎和LLMs。 Claude Opus 4 和 Claude Sonnet 3.7 都出现在前 14 名中。 来源: MachineTranslation.com 内部基准测试;Intento State of Translation Automation 2025。
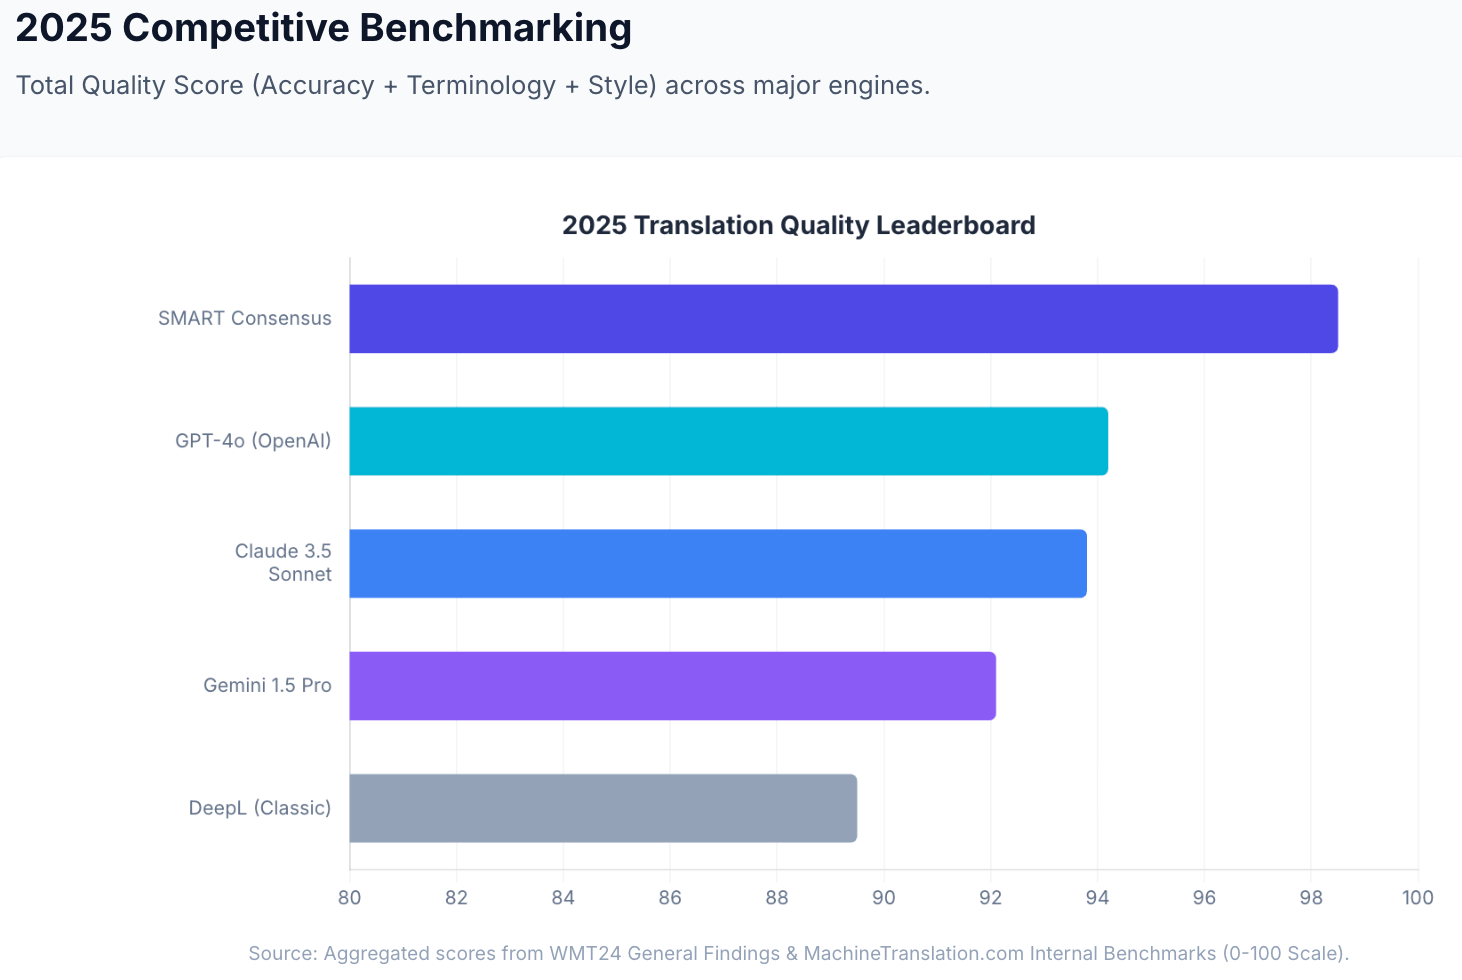
在 WMT24 (翻译行业主要的独立基准测试竞赛)中,Claude 3.5 在 11 个语言对中的 9 个中排名第一,领先于 GPT-4 和专用的 neural MT 引擎。 在 Lokalise 2025 年由专业译员进行的盲测研究中,78% 的 Claude 3.5 翻译被评为“好”——这是所有接受测试的 LLM 中最高的。
Grok 尚未在 WMT24 或 Intento 的独立 LQA 评估中接受同等水平的评估。 The Slator Pro Guide (2025) 将 Grok 列为专业环境中用于翻译的通用 LLMs 之一,与 GPT 和 Claude 并列,但并未将其排在两者之上。
| 基准测试 | Grok | Claude |
|---|---|---|
| MachineTranslation.com 内部质量评分 | 未在基准测试级别进行评估 | 93.8/100 (3.5 Sonnet 级别) |
| Intento 2025 前 14 大解决方案 | 未列出 | Claude Opus 4 和 Sonnet 3.7 均被列出 |
| WMT24 语言对 | 未评估 | 在 9/11 个语言对中排名第一 |
| Lokalise 2025 盲测 | 未评估 | 78% “好”(在所有 LLM 中最高) |
来源: MachineTranslation.com 内部基准;Intento State of Translation Automation 2025;WMT24 General MT Findings;Lokalise 2025。
Grok 在哪里拥有真正的优势?
实时与时事翻译。 Grok 最具定义性的架构特征是其与 X(前身为 Twitter)平台数据和实时互联网搜索的整合。 与 Claude 和大多数其他在具有固定知识截止期的静态数据集上训练的 LLMs 不同,Grok 将实时信息融入其输出中。 对于涉及近期事件、新发布的产品、新兴政治术语、时事新闻或引用过去几周内发生的事情的内容的翻译任务,Grok 可以获取 Claude 无法获取的上下文。
这在以下情况下尤为重要:翻译关于近期事件的新闻报道、为快速变化的市场本地化产品发布声明、处理晚于其他模型训练数据的新造术语或俚语,以及任何其含义取决于了解最近发生的事情的内容。
新兴和不断演变的术语。 技术领域、行业和文化背景不断产生新的术语。 对于涉及新造词、新监管语言或新产品命名的翻译任务,Grok 更新后的训练和实时搜索使其能够获取较旧的训练数据快照无法捕获的使用模式。
Grok 4.1 上下文窗口与推理。 Grok 4.1(截至2025年底)拥有131K-token的上下文窗口和提升的推理能力,使其能够应对复杂的、多层次的文档,在这些文档中,条款关系和逻辑连贯性至关重要。
Claude在哪些方面拥有真正的优势?
在独立基准测试中的翻译质量。 Claude的优势是由独立的专业评估所证实的,而非其自我宣称。 WMT24在11个语言对中的9个中,将Claude 3.5排在所有竞争对手的首位。 Lokalise的2025年盲测研究发现,专业译员更青睐 Claude 3.5 的输出,其“好”评率达 78%——在同一评估中高于 GPT-4、DeepL 和 Google Translate。 这些是盲评:专业译员在不知道输出是由哪个模型生成的情况下对其进行了评估。
依据 Intento 2025 的具体语言对。 在 Intento 的人工 LQA 评估中,Claude Opus 4 和 Sonnet 3.7 在英语到德语、英语到日语、英语到意大利语、英语到韩语、英语到荷兰语、英语到阿拉伯语以及英语到法语中均处于“最佳”类别。 对于这些配对,Claude 是两者中更有据可查的更强选择。
语气精准度与细腻的内容。 在 Lokalise 的研究中,专业译员对 Claude 输出的偏好率在所有 LLM 中最高——这反映了 Claude 在保留语域、作者笔调和语境意义方面经证实的优势。 对于文学翻译、法律文件、正式沟通和营销文案等表达方式与表达内容同样重要的领域,Claude 在各项独立评估中始终表现出色。
长文档连贯性。 Claude 4.6 Sonnet 支持 200K-token 的上下文窗口,其中 Claude Opus 4.6 在 beta 版中支持 1M token。 对于长篇正式文档(合同、技术手册、临床试验报告),Claude 可以一次性处理整份文档,始终保持术语一致性。 与整篇文档处理相比,分段处理的文档其术语不一致率高出 28%。 来源: MachineTranslation.com 内部数据。
它们在语言支持和定价方面对比如何?
语言支持: Grok 4.1 和 Claude 4.6 都支持大多数世界主要语言之间的翻译。 Claude已在欧洲和东亚语言对中接受了独立评估,并取得了优异的成绩。 Grok的多语言支持在历代版本中均有所提升。 对于低资源语言,两种模型的质量都会下降——无论使用哪种模型,对于低资源语言对的内容,人工审核都是合适的。
定价:
| 计划 | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| 个人用户(每月) | SuperGrok: $30/月 | Claude Pro: $20/月 |
| API 输入(每百万 tokens) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API 输出(每百万 tokens) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| 免费层级 | 是(通过 X/Grok.com 限制频率) | 是(通过 claude.ai 限制频率) |
在个人用户层级,Claude Pro($20/month) is cheaper than SuperGrok ($30/月)。 在 API 层面,对于高输入量的翻译工作流,Grok 4.1 相比 Claude Sonnet 4.6 具有微弱的成本优势。
针对特定内容类型,哪一个更好?
| 内容类型 | 推荐模型 | 原因 |
|---|---|---|
| 最近新闻 / 时事 | Grok | 实时数据访问;静态训练的模型缺乏最新上下文 |
| 新兴术语 / 新产品发布 | Grok | 实时搜索集成可捕获最新的使用模式 |
| 正式法律文件 | Claude | WMT24 和 Lokalise 2025 独立评估;语气精准度 |
| 医疗 / 临床内容 | Claude | 独立基准测试表现;语域保留 |
| 营销文案 / 创意内容 | Claude | Lokalise 2025 双盲研究偏好;语气细微差别 |
| 技术文档(长篇) | Claude | 200K-1M 上下文窗口;跨篇幅的术语一致性 |
| 社交媒体 / 对话内容 | 两者皆可 | 两者都能很好地处理高资源对话对 |
| 开发者 / API 集成 | 两者皆可 | 两者均提供 API 访问;Grok 在输入 Token 上稍便宜一些 |
当单一模型不够用时该使用什么
Grok 和 Claude 都是单一模型工具。 每个独立的 AI 模型(无论其能力有多强)都会产生其无法在自身输出中检测到的错误。 来自 Grok 或 Claude 的流畅且自信的翻译仍可能在语义上存在错误,如果不进行交叉核对,就无法得知。
Grok 和 Claude 都在 MachineTranslation.com 的 SMART 系统的 22 个模型之列。 SMART 同时运行所有 22 个模型(包括 Grok 和 Claude),并返回多数模型达成共识的输出。
这对于 Grok 与 Claude 的问题意味着: Grok 的实时优势和 Claude 的上下文深度都促成了相同的共识。 当它们达成一致时,这种一致性就是一个强烈的质量信号。
在 MachineTranslation.com 的内部基准测试中,单个顶级模型在翻译质量上的得分为 93-94 分(满分 100 分)。 SMART的共识输出达到98.5/100。 来源: MachineTranslation.com 内部基准与 WMT24 General Machine Translation Findings。
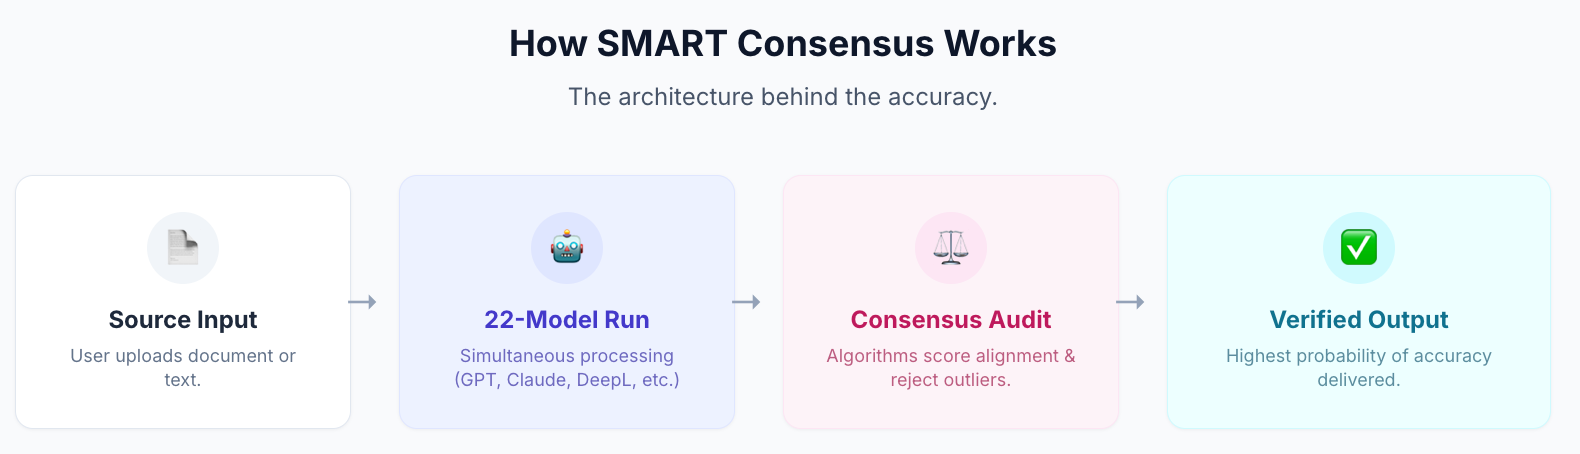
从单引擎翻译切换到 SMART 的用户在验证和纠正输出上所花费的时间减少了 27%。 来源: MachineTranslation.com 内部数据。
对于高风险内容(法律文件、监管申报文件、医疗说明书),人工验证会将 SMART 共识转交至同一平台内的认证专业审校人员。 无外部机构。 100%准确率保证。
在 MachineTranslation.com 使用 Grok、Claude 以及其他 20 种模型进行翻译 — 免费,无需注册。
常见问题
1. 在翻译方面,Grok 比 Claude 更好吗?
对于大多数标准翻译任务,Claude 在独立基准测试中处于领先地位:在 WMT24 的 11 个语言对中有 9 个排名第一,在 Lokalise 的 2025 年盲测研究中获得 78% 的“好”评,以及在 MachineTranslation.com 的内部质量基准测试中获得 93.8/100 分。 Grok 的特定优势在于处理需要时事知识的内容,其实时数据访问能力赋予了它包括 Claude 在内的静态训练模型所不具备的上下文信息。 对于近期新闻、新兴术语和时效性内容,Grok 是更佳的选择。
2。 Grok 相比 Claude 在翻译上有什么优势?
Grok 集成了来自 X(前身为 Twitter)的实时数据和实时网络搜索。 与在静态数据集上训练的 Claude 以及大多数其他 LLMs 不同,Grok 在生成翻译时能够获取有关近期事件、新造术语和当前上下文的信息。 这使得它在翻译新闻内容、最近发布的产品,以及任何含义取决于过去几周内的事件或语言模式的材料时,具有特别的优势。
3. 在翻译方面,Claude 相比 Grok 有何优势?
Claude 的优势已通过独立的专业评估得到证实。 Claude 3.5 在 WMT24 的 11 个语言对中有 9 个排名第一,且在 Lokalise 2025 年的盲测研究中,专业译员对其输出的偏好率达到了 78% 的“好”评率——这是所有受测 LLM 中最高的。 Claude 也出现在 Intento 跨多个语言对的人工 LQA 评估前 14 个解决方案中,而 Grok 则没有。 对于正式、专业和高风险的翻译任务,Claude的独立基准地位是其有据可查的差异化优势。
4。 对于法律翻译,Grok 和 Claude 哪个更好?
根据独立评估,Claude 是法律翻译更优的选择。 Claude 3.5 在 WMT24 的大多数高资源欧洲语言对中排名第一,并获得了专业译员最高的盲测偏好评级。 对于需要认证准确性的法律内容,单靠任何一个模型都是不够的——MachineTranslation.com 的 Human Verification 在同一平台内提供来自认证专业审校人员的 100% 准确性,无需外部供应商。
5. Grok和Claude都可以在MachineTranslation.com上使用吗?
是的。 两者均在MachineTranslation.com的SMART系统的22个模型之列。 每一次 SMART 翻译都会同时运行 Grok、Claude 和其他 20 个模型,并返回大多数模型一致同意的输出。 与其在它们之间做出选择,您将获得所有 AI 模型的共识。
6. Grok和Claude在价格上相比如何?
在消费级层级,Claude Pro的价格为$20/month versus SuperGrok at $30/月。 在 API 层面,Grok 4.1 在 input tokens(Claude Sonnet 4.6 为 $2/M vs. $3/M)和 output($10/M vs. $15/M)上稍微便宜一些。 MachineTranslation.com 的免费计划包含这两个模型,作为 SMART 的 22 模型共识的一部分,无需注册。
7。 哪种 AI 模型最适合翻译新闻文章?
在翻译新闻文章方面,Grok 具有结构性优势:其实时数据集成意味着它拥有所描述事件的最新背景信息,而静态训练的模型可能会缺乏这一点。 对于时效性要求不高的通用新闻翻译,Claude 的基准表现更强。 对于时效性和准确性都很重要的大批量新闻翻译,MachineTranslation.com's SMART 会同时运行两个模型并返回它们的共识输出。