October 9, 2026
Qwen vs ChatGPT:哪个 AI 模型翻译得更好?
ChatGPT 的当前一代 和 Qwen 都是 MachineTranslation.com 在每次翻译时运行的模型池的一部分,而不是与平台本身进行对比评估的两个外部竞争对手。在相同的句段上通过两者运行相同的文本,ChatGPT 在整体上赢得了更大份额的语言对。按方向细分结果后,差距在一个特定领域急剧收窄:在译入英语的方向上,两者几乎不相上下。
有在翻译方面优于 ChatGPT 的 AI 吗?
随着竞争对手模型的改进,人们对 ChatGPT 替代品的普遍兴趣日益浓厚,不过原因因使用场景而异,无法一概而论。具体到翻译领域,更有价值的问题是在特定的语言对上哪个模型实际表现更好,这是一个可以通过测试验证的问题,而非主观情绪。
在 MachineTranslation.com 过去 28 天的流量中,两个模型在 98 个语言对上翻译了相同的源文本。ChatGPT 在其中的 77 个语言对中得分更高;Qwen 在 21 个语言对中得分更高。匹配输出的加权平均得分显示,ChatGPT 为 9.10 分(满分 10 分),Qwen 为 8.98 分,平均而言这一差距虽真实存在但并不算大,然而一旦将翻译方向考量在内,就掩盖了更为显著的差距分化。
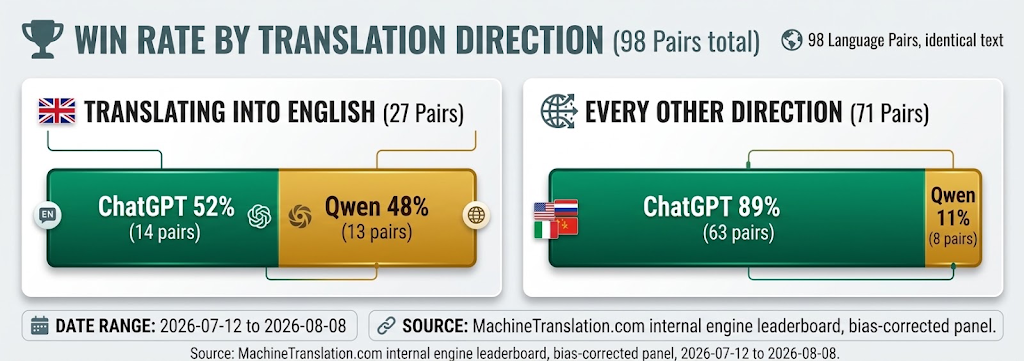
在译入英语方面,这两个模型几乎打成平手。在其他所有方向上,ChatGPT 在绝大多数受测语言对中均胜出。
| ChatGPT | Qwen | |
|---|---|---|
| 输出评分占比 | 54.76% | 42.6% |
| 平均得分 | 8.89 / 10 | 8.87 / 10 |
| 得分最低的 10% | 7.8 | 7.6 |
| 胜率(译入英语) | 52% | 48% |
| 胜率(所有其他方向) | 89% | 11% |
为什么在译入英语时差距几乎消失了?
数据展示了分歧发生在哪里,而不是原因。显而易见的是,Qwen 的竞争力分布并不均匀。在目标语言为英语的 27 个语言对中,Qwen 赢下了 13 个,基本等同于抛硬币的概率。而在剩下的 71 个语言对中(包括从英语译出以及在两种非英语语言之间互译),ChatGPT 赢下了 63 个,占比达 89%。如果某个团队假设 Qwen 在译入英语方面的表现在译出或非英语对的翻译中也能保持,那就是从错误的方向得出了错误的结论。
Qwen 是一家中国公司吗?这对翻译有影响吗?
Qwen 由总部位于中国的 Alibaba Cloud 开发。就其本身而言,这并不会改变该模型翻译特定句子的水平,上述数据反映的是实际的输出质量,与模型的开发地无关。可能产生影响的地方在于数据处理:翻译受监管或敏感内容(合同、医疗记录、个人信息)的企业应将 AI 提供商在哪里处理和存储此类内容的问题视为一项切实的尽职调查事项,这与翻译质量本身是分开的。这适用于任何 AI 提供商,并非仅针对 Qwen,这也是 MachineTranslation.com 直接公布自己的数据处理和安全规范,而不是对该问题避而不谈的部分原因。
在法律和商业翻译方面,哪款模型更可靠?
并非总是如此,而且这种差异并不单单取决于哪个模型的得分更高。MachineTranslation.com 针对真实合同语言的测试发现了两个典型个案,在决定是否信任任一模型处理法律文本之前,了解这两点十分必要。习语表达有时则恰恰相反:在另一项面对面测试中,ChatGPT 对一个德语习语进行了字面直译且译文有误,而 Qwen 则给出了准确的习语含义;这提醒我们,任何一个模型在总体数据中的综合领先优势,具体到单个句子上时并不总是成立。
| 测试案例 | ChatGPT | Qwen |
|---|---|---|
| 将“At-will employment”译为德语 | 可用、符合实际功能的表述 | 采用了毫不相关的法律概念 |
| 将责任限制条款译为西班牙语 | "que surjan de" | "derivados de"(改变责任范围的差异) |
| “Ich verstehe nur Bahnhof”(德语习语) | 字面直译,译文有误 | 习语含义正确 |
在这三个案例中,没有哪个模型能够始终保持胜出:单一模型的综合评分并不能预测其在某个具体术语或短语上的表现。这也正是为什么无论由哪个模型生成初稿,法律与合同文本都能从人工核对环节中受益的原因。
那么语言覆盖范围如何?
ChatGPT 和 Qwen 都没有公布经过验证、独立确认的翻译质量下降的语言对列表。两者都是具有广泛多语言训练的通用模型,但这与在特定语言集上测量的翻译性能是两码事。MachineTranslation.com 直接对 330 多种语言的翻译质量进行测试和评分,而不是将模型的通用语言能力作为其真实翻译效果的替代参考。
在进行商务翻译时,哪些内容不应该直接粘贴到 ChatGPT 或 Qwen 中?
ChatGPT 和 Qwen 都不是专为翻译构建的平台,将敏感的商业内容直接粘贴到通用聊天界面中,会面临与粘贴到任何其他消费级 AI 工具中相同的数据处理问题:输入内容在哪里处理、是否会被保留以及谁有权访问。合同、医疗记录、移民文件和财务报表正是需要在翻译前(而不是翻译后)明确回答这一问题的内容。这也是为什么拥有公开、可验证的数据处理规范的专用翻译平台与通用聊天界面有着本质区别的真正原因,无论其底层使用的是哪种模型。
MachineTranslation.com 实际上是如何使用这两种模型的
MachineTranslation.com 在每次翻译中都会运行 ChatGPT、Qwen 以及其他 20 多个 AI 模型,然后呈现这些模型最为一致认可的版本。鉴于 Qwen 和 ChatGPT 的性能在不同翻译方向上差异巨大,将单一模型作为固定默认选项意味着会在相当一部分可预测的语言对上做出错误判断。这种取决于翻译方向的模式同样出现在 MachineTranslation.com 的 Qwen 与 DeepSeek 对比中。如需全面了解当前各模型之间的对比测试情况,请参阅 MachineTranslation.com 的完整模型对比测试。
常见问题解答
1. 用于翻译,Qwen 和 ChatGPT 哪个更好?
在针对完全相同源文本测试的 98 个语言对中,ChatGPT 在其中 77 个语言对上的得分更高。Qwen 表现最好的是英译方向,在这一方向上两者几乎打平。在其他所有方向上,ChatGPT 赢得了绝大多数语言对,因此客观的答案很大程度上取决于内容的翻译方向。
2. ChatGPT 和 Qwen 谁支持的语言更多?
两者都是通用 AI 模型,没有经过验证、公开公布的特定语言限制列表。两者都没有发布经独立确认的语言对覆盖数据,这与直接对 330 多种语言的翻译质量进行测试和评分、而非依赖关于多语言训练的笼统声明的平台截然不同。
3. 针对法律和商务翻译,Qwen 和 ChatGPT 哪个更好?
两者都无法在所有方面始终表现得更好。在测试一个德国劳动法术语时,DeepSeek 和 ChatGPT 给出了可用且实用的表述,而 Claude 和 Qwen 则都引用了无关的法律概念,这表明差异取决于具体术语和语境,而不是哪个模型整体上更强。
4. MachineTranslation.com 与 ChatGPT 和 Qwen 是竞争关系吗?
不是。MachineTranslation.com 在每次翻译时都会运行 ChatGPT、Qwen 和其他 20 多个 AI 模型,并呈现这些模型最为一致认可的版本。它测试并整合了这些模型,而不是作为一个独立的、与之竞争的模型存在。
5. 针对大型本地化项目,我应该选择哪种模型?
一旦内容涉及多种语言的双向互译,单靠任何一个模型都不是稳妥的默认选择。本文记录的特定语向差异表明,一个在译入英语时表现出色的模型,在译出英语时表现可能会截然不同,在同时处理数十个语言对时尤其如此。
6. 哪个 Qwen 模型最适合翻译?
目前尚无法确定。与其他提供商不同,MachineTranslation.com 目前的追踪系统将 Qwen 记录为单一引擎,未附带模型版本标签,因此不存在可供报告的各子版本质量数据。一旦该问题得以解决,届时就能对 Qwen3.8-Max 和 Qwen3.8-27B 进行真正的详细对比;而就目前而言,这确实是一个空白,而不仅仅是未测量的细节。