September 9, 2026
Qwen vs DeepSeek:哪个AI模型翻译得更好?
通过 Qwen 和 DeepSeek 运行相同的 12,000 个翻译句段,DeepSeek 在大多数语言对中胜出。这还不是事情的全貌。将结果按方向拆分,就会呈现出一种特定的规律:Qwen 缩小了大部分差距,有时甚至会取得领先,特别是当目标语言为英语时。在将英语翻译成其他任何语言时,DeepSeek 几乎每次都能胜出。
如果你是在几十种语言之间翻译内容,而不是仅针对一个语言对,那么这种分化比一个单一的总体赢家更为重要。
什么是 Qwen 和 DeepSeek?
Qwen 是 Alibaba 的大语言模型系列。当前一代是 Qwen3.8,于 2026 年 8 月发布:Qwen3.8-Max 是参数量达 2.4 万亿的闭源、仅限 API 的旗舰模型,而 Qwen3.8-27B 则是几天后在 Apache 2.0 协议下发布的较小规模的开放权重模型,面向希望自托管的团队。
DeepSeek 是一家中国 AI 实验室,以混合专家模型而闻名,这些模型能以极低的推理成本提供媲美前沿水平的性能。其当前一代 DeepSeek V4 于 2026 年 4 月发布,共有两个版本:V4 Pro(总参数量 1.6 万亿,每 token 激活量约 490 亿)用于注重质量的工作,而 V4 Flash(总参数量 2840 亿,激活量约 130 亿)则用于对延迟敏感的工作负载。两者都以 MIT许可的开源权重.
除了基准测试,Qwen 和 DeepSeek 在翻译上的实际对比究竟如何?
大多数 Qwen 与 DeepSeek 的对比都引用了通用基准测试:编程、数学、推理。这些都无法直接衡量翻译质量,而且在不同的源文本上运行每个模型,使得任何准确性差异都无法与文本本身的要求区分开来。
MachineTranslation.com 过去 28 天自身的翻译流量提供了一个更清晰的答案,因为两个模型翻译的是完全相同的源文本。在 98 个语言对和 12,000 多个匹配句段中,DeepSeek 在 83 个语言对中得分更高;Qwen 在 15 个语言对中得分更高。将范围缩小到目标语言为英语的 27 个语言对,差距会急剧缩小:DeepSeek 赢得了其中 63%(27 个中的 17 个),Qwen 赢得了 37%(27 个中的 10 个)。在其余 71 个非英语为目标语言的语言对中,DeepSeek 赢得了 92%(71 个中的 66 个)。
按翻译方向划分的胜率(98 个语言对,相同文本)
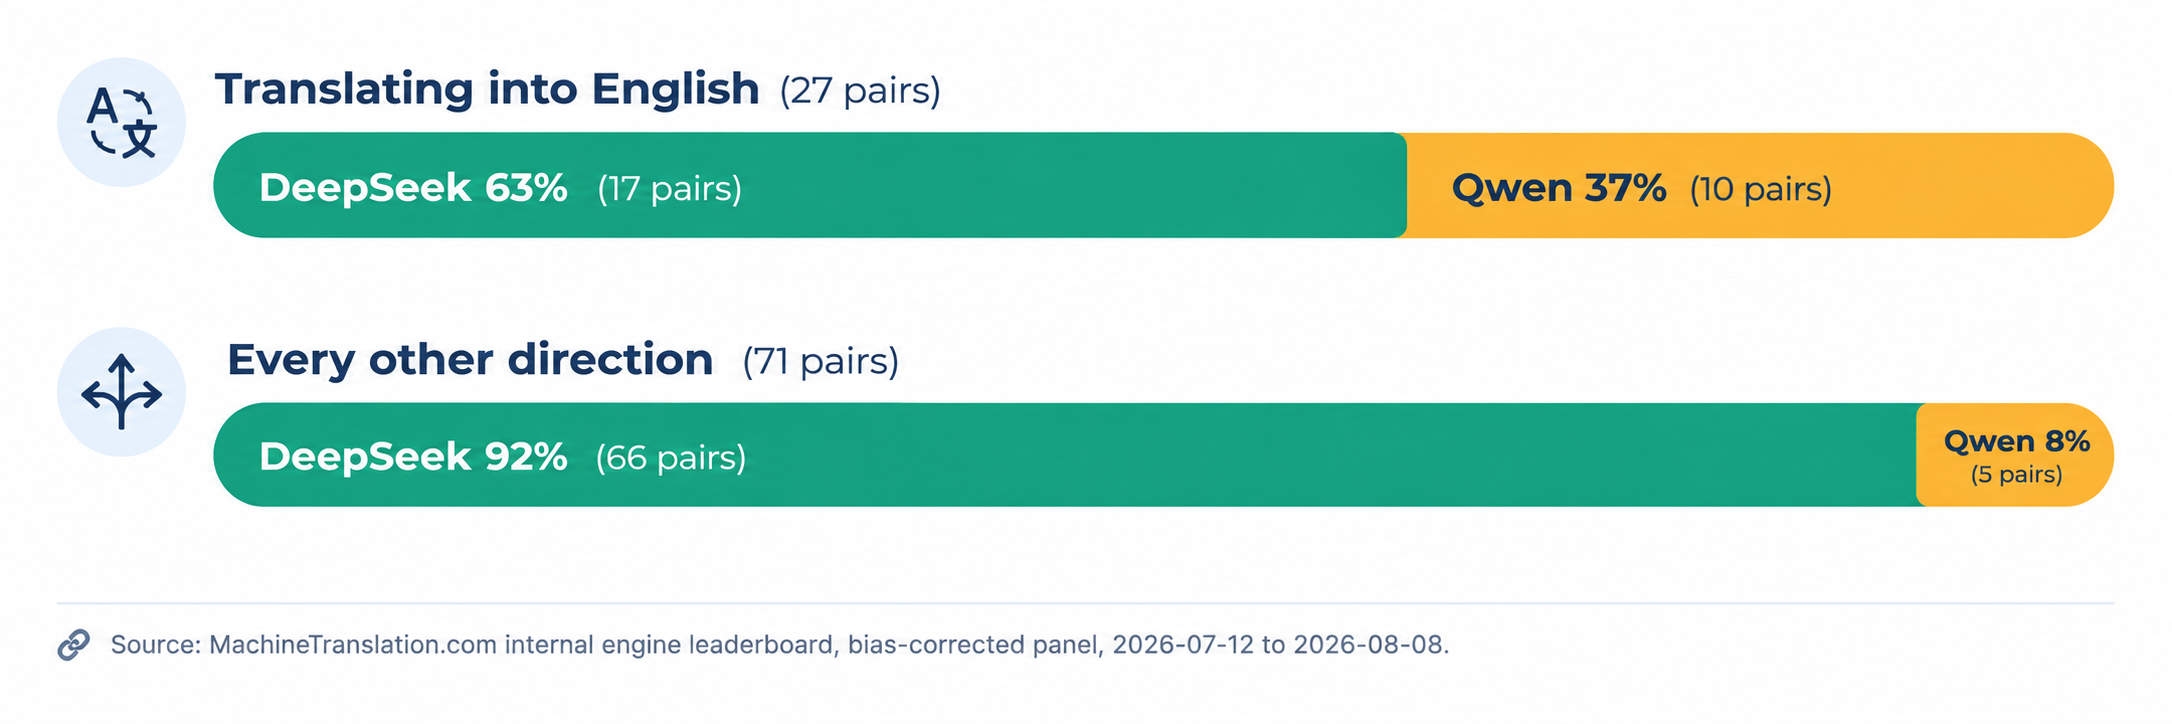
总体而言,DeepSeek 在绝大多数语言对中胜出。Qwen 的竞争窗口很窄但确实存在:在翻译成英语时,它在超过三分之一的语言对中胜出。数据:MachineTranslation.com 的内部引擎排行榜,纠偏评估小组,2026 年 7 月 12 日至 8 月 8 日。
所有匹配句段的加权平均得分显示,DeepSeek 得分为 9.13(满分 10 分),Qwen 得分为 8.98。这是一个真实的差距,但分布并不均匀。如果您的内容涉及多个翻译方向,了解这一点会更有用。这也是 MachineTranslation.com 在其 完整模型对比测试中所采用的相同两两对决方法,不仅限于这一对模型。
总体数据在单个测试案例中也站得住脚。在测试法语短语 "Elle est directrice adjointe du département commercial" 时,DeepSeek 和 Qwen 趋于相同的英语翻译:"deputy director of commercial department"。您可以直接查看该 在线测试结果 。在测试将 "as soon as possible" 翻译成西班牙语时,DeepSeek 偏离了四个模型的共识,使用了 "esté hecho" 而不是 "se haga",这是一个 真实的差异案例 ,反映了“过程与结果”的语法区别,而非错误。
为什么 Qwen 专门在翻译成英语时表现更好?
数据并没有解释原因,只指出了在哪些方向。Qwen 表现最强的一些译成英语的语言对包括泰米尔语、中文、波兰语、意大利语和希伯来语,这些源语言通常都拥有模型构建者可获取的、大规模且记录完善的英文训练语料库。除了这一方向之外,DeepSeek 的优势几乎无处不在:无论是在源语言为英语的翻译中,还是在非英语语言对之间的翻译中皆是如此。
这排除了一点,那就是将任何一个模型视为通用的默认选择。如果一个团队将产品列表从西班牙语翻译成六种语言,并期望获得与将中文支持工单翻译成英语时相同的性能排名,那么他们就是从错误的方向上吸取了错误的教训。这种不对称性同样体现在 MachineTranslation.com 的 西班牙语到英语模型细分,其中领先的模型与反向翻译中领先的模型并不相同。
Qwen 和 DeepSeek 是免费且开源的吗?
两者的许可协议划分各不相同。DeepSeek 在 MIT 许可协议下授权 V4 Pro 和 V4 Flash,这是最宽松的开源条款之一,因此两者均可免费进行无限制的自主托管。Qwen 则有所不同:Qwen3.8-27B 在 Apache 2.0 许可协议下发布,可免费自主托管,但旗舰模型 Qwen3.8-Max 仍保持闭源,仅限 API 访问,并采用 Alibaba 自有的定制许可协议。
实际上,这意味着在 DeepSeek 方面,在两个质量层级上都存在完全开放权重、采用 MIT 许可协议的选择。在 Qwen 方面,选择开放权重意味着要放弃旗舰模型。
大规模运行 Qwen 和 DeepSeek 的成本是多少?
继 DeepSeek 在 May 2026 永久降价之后,其目前公布的 API 费率为:V4 Pro 每百万输出 token $0.435 per million input tokens (cache miss) and $0.87,而针对延迟优化层级的 V4 Flash 定价更低。
对于选择自主托管任一模型而非使用托管 API 的团队来说,成本对比完全转向 GPU 基础设施,并取决于参数量和活跃参数效率,而不是按 token 计费的费率。
这两种模型是否足够安全,可用于法律、医疗或受监管的内容?
这两种模型均未发布针对翻译的安全认证,且通用安全基准测试并未针对受监管内容中至关重要的失效模式进行测试:例如剂量翻译错误、责任条款偏差、法律术语不一致等。MachineTranslation.com 的自身测试发现,模型在法律和医疗语言上确实存在此类差异,包括在通用质量指标上得分都很高,但模型却使用了 适用范围不同的不同法律术语 的情况。
对于合同、移民文件或临床内容,情况正是如此,需要将任何一个模型的输出与 人工核对步骤 相结合,而不是盲目相信单一的 AI 输出,无论该输出是由哪个模型生成的。
如果您同时进行多种语言的本地化,这意味着什么?
基于单一语言对的对比几乎无法告诉您关于第四十个语言对的任何信息。本文记录的“译入英语/译出英语”的划分在 98 个语言对样本中成立,正是因为测试达到了这一规模:而大多数 Qwen 与 DeepSeek 对比运行的单一“英语到西班牙语”测试,只会显示 DeepSeek 遥遥领先,而无法说明一旦将泰米尔语、波兰语或希伯来语纳入流程后会发生什么。
这就是为什么在默认情况下,不要将大型本地化项目绑定到单一模型输出的实际理由。MachineTranslation.com 在每次翻译中都会运行 Qwen 和 DeepSeek 以及其他 20 多个模型,并呈现这些模型最一致的版本,因此 68 种语言的部署不会仅依赖于某个恰好在他人首次测试的单一语言对中胜出的模型。您可以在该平台为每个结果显示的 单次翻译模型细分 中,准确地看到哪些模型在任何特定翻译上达成了一致或产生了分歧。
每次翻译都会对照比单纯的 Qwen 或 DeepSeek 范围更广的模型进行检测,这直接回答了当您的内容不再仅仅单向流动时会发生什么。
常见问题解答
1.Qwen 和 DeepSeek 哪一个更适合翻译?
在针对相同源文本测试的 98 个语言对中,DeepSeek 在其中 83 个语言对中得分更高。Qwen 的胜出集中在一个特定方向:译入英语,在此方向上它赢得了大约三分之一的次数。在所有其他方向上,DeepSeek 的胜率超过 90%。
2.Qwen 可以免费使用吗?
Qwen3.8-27B 在 Apache 2.0 协议下开放权重,并可免费自主托管。旗舰模型 Qwen3.8-Max 是闭源的,仅能通过 Alibaba Cloud 的付费 API 获取。
3.DeepSeek 是免费使用的吗?
是的。DeepSeek V4 Pro 和 V4 Flash 都附带 MIT 许可的开源权重,因此您可以自行托管其中任何一个,而无需支付许可费用。DeepSeek 还为不想管理自己基础设施的团队提供付费 API。
4.Qwen 和 DeepSeek 哪个更快?
DeepSeek V4 Flash 专为低延迟而设计,每个 token 的活动参数为 130 亿个,而 V4 Pro 则为 490 亿个。Qwen 的同等轻量级选项 Qwen3.8-27B 是稠密模型而非混合专家模型,这通常使其在同等质量下每个 token 的速度较慢。
5.我可以将 Qwen 和 DeepSeek 结合用于翻译吗?
可以。MachineTranslation.com 在每次翻译中都会运行这两个模型以及其他 20 多个模型,并呈现它们最一致的版本,因此您无需纠结于选择某一个模型并寄希望于它是该特定语言对更强大的选择。
6.Qwen 和 DeepSeek 的许可协议有什么区别?
DeepSeek 在 MIT 许可下授权这两个 V4 变体,这是目前最宽松的开源许可证之一。Qwen 拆分了其产品阵容:较小的模型(如 Qwen3.8-27B)在 Apache 2.0 许可下发布,但旗舰模型 Qwen3.8-Max 则保持封闭状态,并采用自定义许可。