November 13, 2026
Qwen vs Gemini 翻译对比以及为何翻译方向至关重要
面对两个模型和一份语言对列表,你需要决定把项目托付给哪一个模型。大多数 Qwen 与 Gemini 的对比评测往往只给出一个总分。我认为,单一的分数掩盖了决定结果的关键因素,那就是翻译的方向。
我的工作涉及评估在 MachineTranslation.com 上运行的模型,因此我能够对比 Qwen 和 Gemini 在基于相同文本评分的 98 个语言对上的表现。在这些语言对中,Gemini 在 68 个语言对中得分更高,Qwen 在 29 个语言对中胜出,满分 10 分的情况下平均差距为 0.08 分。单凭总数并不能告诉你乌尔都语到英语或英语到海地克里奥尔语该选用哪一个模型。
本文展示了这两个模型在哪些方面表现接近,以及各自在哪些方面处于领先地位。本文还会说明我目前尚无法确定的内容。我的数据截止于 August 8, 2026,早于 Google 在 October 宣布 Gemini 4,因此它描述的是这两个模型的早期版本。
核心要点
- 在基于相同文本评分的 98 个语言对中(July 12 to August 8, 2026),Gemini 在 68 个语言对中得分更高,Qwen 在 29 个语言对中得分更高,还有一个语言对持平。
- 平均差距很小,Gemini 为 9.06 分,Qwen 为 8.98 分,98 个语言对中有 60 个的分差在 0.1 分以内。
- 在翻译成英语时,27 个语言对中有 7 个 Qwen 领先超过 0.1 分,Gemini 领先超过 0.1 分的有 3 个;其余 17 个语言对的分差在 0.1 分以内。
- 在从英语向外翻译时,29 个语言对中有 13 个 Gemini 领先超过 0.1 分,而 Qwen 没有一个领先超过 0.1 分。
- 该数据截止于 Google 在 October 2026 宣布 Gemini 4 之前,因此它描述的是较早的 Gemini 版本,在任何人将其视为最新数据之前都需要重新运行测试。
翻译方面 Qwen 和 Gemini 哪个更好?
这取决于翻译方向,因为当目标语言为英语时,这两个模型的表现很接近,而在大多数其他语言对中 Gemini 的得分更高。在所有 98 个语言对中,Gemini 在 68 个语言对中得分更高。在 MachineTranslation.com 从 July 12 to August 8, 2026 的评分中,满分 10 分的情况下 Gemini 平均为 9.06 分,Qwen 为 8.98 分,平均差距为 0.0
该面板仅统计 ChatGPT、Claude、DeepSeek、Gemini 和 Qwen 均获得真实评分的句段,因此每个模型都是基于完全相同的源文本进行评判的。每个语言对至少包含 30 个句段。我使用此面板是因为它消除了一个常见错误,即在不同的文本上比较模型。
从数量上看,Gemini 在 68 个语言对中领先(69%),Qwen 在 29 个语言对中领先(30%),还有 1 个语言对持平。仅看数量会夸大差距,因为 98 个语言对中有 60 个的分差在 0.1 分以内。接下来的部分将按翻译方向和分差对结果进行细分。
哪些翻译方向对各个模型更为有利?
当英语为源语言或两种语言均非英语时,Gemini 处于领先地位,而当英语为目标语言时,Qwen 与其持平或领先。在从英语译出时,Gemini 在 29 个语言对中有 13 个领先超过 0.1 分,而 Qwen 则无一领先。在译入英语时,Qwen 在 27 个语言对中有 7 个以该幅度领先,而 Gemini 只有 3 个。
| 方向 | 语言对 | Gemini 领先超过 0.1 | 差距在 0.1 分以内 | Qwen 领先超过 0.1 | 平均分差 |
|---|---|---|---|---|---|
| 译入英语 | 27 | 3 | 17 | 7 | Qwen +0.04 |
| 译出英语 | 29 | 13 | 16 | 0 | Gemini +0.16 |
| 非英语互译 | 42 | 14 | 27 | 1 | Gemini +0.13 |
在译入英语方向,27 个语言对中有 17 个差距在 0.1 分以内,Qwen 在 7 个中领先,Gemini 在 3 个中领先。在译出英语方向,29 个语言对中有 16 个差距在 0.1 分以内,Gemini 在 13 个中领先,Qwen 无一领先。在两种语言均非英语的情况下,42 个语言对中有 27 个差距在 0.1 分以内,Gemini 在 14 个中领先,Qwen 在 1 个中领先。
在译入英语的 27 个语言对中,Qwen 在 24 个语言对中与 Gemini 的差距在 0.1 分以内或处于领先。按方向平均计算,Qwen 在译入英语方向领先约 0.04 分,而 Gemini 在译出英语方向领先约 0.16 分,在两种非英语语言之间领先 0.13 分。
我不知道为什么会出现这种分化,这些数据也无法告诉我原因。我会首先验证的一个解释是每个模型背后的训练文本配比,但我尚未进行该测试。Qwen 在与 ChatGPT 的对比中也呈现出类似的格局。在同一个评测集上,我们对 Qwen 与 ChatGPT 的对比发现两者在译入英语方向几乎持平,而 ChatGPT 在其余 89% 的语言对中处于领先。
哪些语言对的差距最大?
最大的差距倾向于 Gemini。在俄语到哈萨克语、英语到海地克里奥尔语、英语到他加禄语、西班牙语到希腊语以及阿拉伯语到波斯语中,它的领先优势达到 0.51 至 0.95 分。Qwen 的最大领先幅度较小,在 0.15 至 0.26 分之间,且其优势最大的前五个语言对中有四个是译入英语。
| 语言对 | Gemini 得分 | Qwen 得分 | 分差 |
|---|---|---|---|
| 俄语至哈萨克语 | 9.27 | 8.32 | Gemini +0.95 |
| 英语至海地克里奥尔语 | 9.19 | 8.27 | Gemini +0.92 |
| 英语至他加禄语 | 9.14 | 8.43 | Gemini +0.70 |
| 西班牙语到希腊语 | 8.90 | 8.33 | Gemini +0.57 |
| 阿拉伯语到波斯语 | 8.84 | 8.34 | Gemini +0.51 |
| 乌尔都语到英语 | 8.56 | 8.81 | Qwen +0.26 |
| 中文到英语 | 9.00 | 9.19 | Qwen +0.19 |
| 瑞典语到英语 | 8.29 | 8.46 | Qwen +0.16 |
| 中文到印尼语 | 9.03 | 9.19 | Qwen +0.16 |
| 缅甸语到英语 | 8.94 | 9.09 | Qwen +0.15 |
我不会将这些视为最终排名。差距最大的两个语言对,俄语到哈萨克语以及英语到海地克里奥尔语,其基于的样本量小于中位数语言对。英语到他加禄语、西班牙语到希腊语以及阿拉伯语到波斯语则基于更大的样本量,因此我更信任这三组。在依赖这两个样本较少的差距数据之前,我会对其重新进行测试。
0.1 分的差距意味着什么?
在我看来,低于 0.1 分的差距太小,不足以判定胜负。在 98 个语言对中,有 60 个都处于这一差距之内,而且每个语言对的评分所依据的句段数量都是有限的。0.1 分是我自己设定的实用阈值,我尚未对这些语言对进行显著性检验。
评分也会遗漏某些差异。在我们的常用短语测试中,我们让 22 个 AI 模型翻译了阿拉伯语的“sorry”。Gemini 和 Qwen 都选择了非正式的 آسف。ChatGPT 和综合结果则选择了正式的 عذرًا。每个模型的得分都是 9.5,因此这两个词虽然语域不同,评分却毫无变化。
这就是为什么我会将分差与语域示例结合起来看。如果分差很小但存在明显的语域差异,就需要人工裁决。如果是小样本上的大分差,则需要重新测试。
Qwen 和 Gemini 会犯不同类型的错误吗?
是的,因为在我们的 2026 年世界杯语录测试中,两个模型都做出了至少一个其他模型没有的选择,而评分几乎没有变动。Gemini 将 Mbappé 的一句话翻译为“with each game”,并逐字直译了 Wirtz 的引述,而 Qwen 则对 Scaloni 的引述给出了不同的解读。这些案例的评分在 9.2 到 9.5 之间。
具体细节来自我们的世界杯语录测试。在 Mbappé 关于展望未来的语录中,其他模型保留了“match”,而 Gemini 则写成了“with each game”,这种语域上的微小瑕疵获得了 9.4 分。在 Wirtz 的语录中,Gemini 逐字直译了一个短语并改变了原意,得分同样是 9.4。在 Scaloni 的语录中,大多数模型倾向于同一种理解,而 Qwen 则写成了“that is what matters”,得分为 9.4。在 Mbappé 的战术语录中,Claude 和 DeepSeek 选择了英式足球英语,而 Gemini、Qwen 以及其他模型选择了美式英语,Qwen 得分为 9.2,低于其他模型。
我认为这些属于细微的习惯。Gemini 的例子主要涉及语域和字面直译。Qwen 的例子则关乎对一句话不同理解的选择。四个例子不足以构成一种规律,但它们展示了单一评分所掩盖的差异类型。
哪个 Qwen 模型最适合翻译?
仅从我们的数据中无法得出结论,因为 MachineTranslation.com 的评分将 Qwen 视为没有版本标签的单一模型。Alibaba 的 Qwen3.8 系列 于 2026 年 8 月登陆 Hugging Face,因此现在存在多个版本,而本文中的评分并未将它们区分开来。
我希望能按版本进行细分,但目前还无法做到。平台层面的数据可能是该时间窗口内运行的多个 Qwen 版本的平均值。如果您要在项目中选择不同的 Qwen 版本,我建议使用您自己的文本样本对它们进行对比。
在翻译方面有哪些可以替代 Gemini 的选择?
ChatGPT、Claude、DeepSeek、Qwen、Grok 和 Mistral AI 均可在 MachineTranslation.com 上运行,而合适的人选取决于具体语言对。在我们 2026 年 7 月 12 日至 8 月 8 日的评分中,在 27 个译入英语的语言对中,Qwen 有 24 个语言对与 Gemini 的差距在 0.1 分以内或处于领先。我们的 Mistral AI 法语评分显示,其法语到英语的平均得分比 Gemini 高出 0.40 分。
如果您考虑的替代方案是 ChatGPT,答案同样因语言对而异。在我们发布的西班牙语到英语详细分析中,Gemini 赢得了 31% 的句段,而 ChatGPT 赢得了 21%。在法语方面,两个模型都没能在双向翻译中都获胜。因为选择会随语言对的不同而改变,MachineTranslation.com 不会只挑选某一个替代方案,而是让它们并行运行。
我的建议是从语言对和翻译方向入手,然后再看哪个替代方案更合适。
MachineTranslation.com 如何展示 Qwen 与 Gemini 产生分歧的地方?
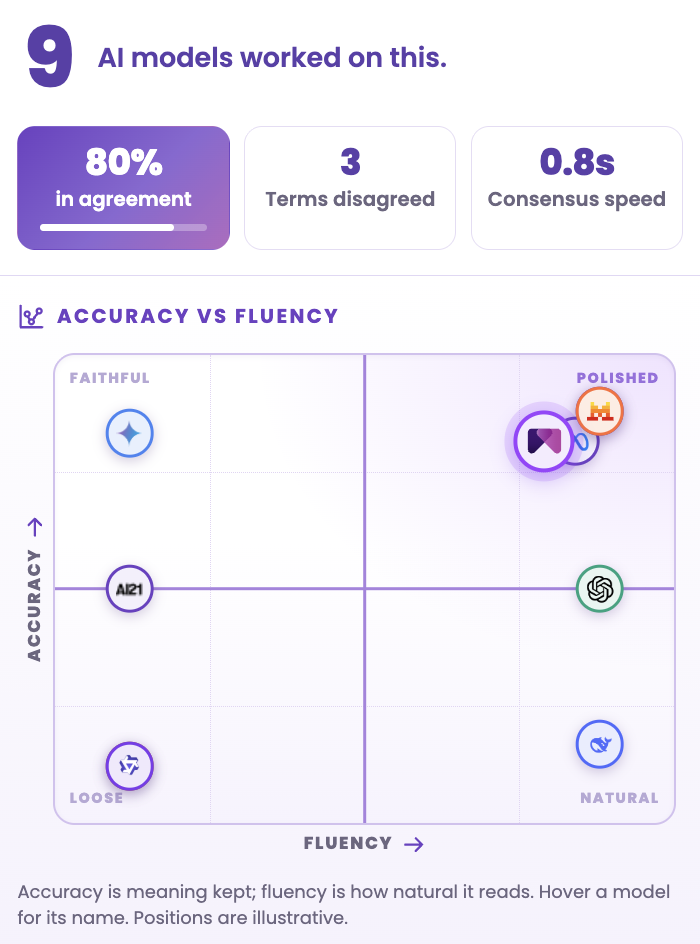
MachineTranslation.com 在每次翻译时都会同时运行这两个模型,并展示各模型在哪些地方达成一致、在哪些地方产生分歧。一致性面板会报告参与文本翻译的 AI 模型数量、达成一致的比例、存在争议的术语数量以及达成共识的速度。
这些结果的时效性如何?
这些结果涵盖 2026 年 7 月 12 日至 8 月 8 日,因此反映的是当时运行的 Gemini 和 Qwen 版本。Google 宣布 Gemini 4 是在 2026 年 10 月。Alibaba 的 Qwen3.8 系列于 2026 年 8 月推出。我的建议是在为一个新项目参考这些数据之前,重新运行该面板。
我预计,在考虑噪声容限的情况下比较相同文本的方法依然成立。我预计差距的幅度会有所变化。对于在新一轮测试中领先地位发生反转的任何语言对,我都会将其视为之前的差距处于噪声范围内的迹象。
如果面对一个项目,我该如何在 Qwen 和 Gemini 之间做出选择?
我的看法是按语言对和翻译方向进行选择,避免为整个项目做一刀切的单一选择。在实践中,这意味着将低于 0.1 分的差距视为平局,并预料领先的模型会在不同语言对之间发生变化。这是我会遵循的顺序。
- 列出项目中的每一个语言对,并标明其翻译方向。
- 查看本文中每个语言对的差距。将低于0.1分的差距视为平局。
- 如果差距较大,请从领先的模型开始,并用您自己的文本样本进行测试。
- 如果您的内容涉及双向翻译,预计领先的模型会在不同语言对之间发生变化。
- 当任一模型发布新版本时,请再次检查。
在MachineTranslation.com的每次翻译中,这两个模型都会与其他20个模型一同运行。系统会返回大多数模型达成共识的版本,因此不必在整个项目中只做出一次选择。完整的模型结果集可在我们的模型对比测试中查看。
常见问题
1. Qwen和Gemini哪个更适合翻译?
这取决于翻译方向,因为在翻译为英文的27个语言对中,Qwen在24个语言对中与Gemini的差距在0.1分以内或处于领先。在MachineTranslation.com的July 12 to August 8, 2026评分中,Gemini在98个语言对中的68个语言对得分依然更高。满分10分中平均差距为0.08分,因此建议按语言对进行选择。
2. 哪个Qwen模型最适合翻译?
根据我们的数据无法给出结论,因为MachineTranslation.com的评分将Qwen视为一个没有版本标签的模型。Alibaba的Qwen3.8系列于August 2026登陆Hugging Face,因此目前存在多个版本。在评分将它们区分开之前,建议在为项目选择模型前,先使用您自己的文本样本对各个版本进行对比。
3. 在翻译方面,Gemini有哪些替代选择?
ChatGPT、Claude、DeepSeek、Qwen、Grok和Mistral AI均在MachineTranslation.com上运行。在我们的July 12 to August 8, 2026评分中,在翻译为英文的27个语言对中,Qwen在24个语言对中与Gemini相差在0.1分以内或处于领先。Mistral AI的法语到英语平均分比Gemini高出0.40分。合适的替代选择取决于语言对。
4. 在翻译方面,Gemini比ChatGPT更好吗?
这取决于语言对,因为没有任何一个AI模型能在所有方面胜出。在我们发布的西班牙语到英语明细中,Gemini赢得了31%的句段,而ChatGPT赢得了21%。在法语上,两个模型都未能在两个方向上同时胜出。在两者之间做出选择之前,建议先确认您需要的语言对和翻译方向。
5. Gemini的翻译准确吗?
是的,因为在 MachineTranslation.com 的 July 12 to August 8, 2026 评分中,Gemini 在 98 个语言对上的平均得分为 9.06(满分 10 分)。准确率仍然因语言对而异。它在从英语译出时的领先优势最大,而在 27 个译入英语的语言对中,Qwen 在 7 个语言对上领先它超过 0.1 分。