September 9, 2026
Qwen vs DeepSeek: Watter AI-model vertaal beter?
Stuur dieselfde 12 000 vertaalsegmente deur Qwen en DeepSeek, en DeepSeek wen die meerderheid van die taalpare. Dit is nie die hele storie nie. Verdeel die resultate volgens rigting, en 'n spesifieke patroon kom na vore: Qwen vernou die grootste deel van die gaping, en neem soms die leiding, spesifiek wanneer die doeltaal Engels is. Wanneer daar uit Engels in enigiets anders vertaal word, wen DeepSeek byna elke keer.
Hierdie verdeling maak meer saak as 'n enkele algehele wenner as jy inhoud oor dosyne tale heen vertaal in plaas van net een taalpaar.
Wat is Qwen en DeepSeek?
Qwen is Alibaba se familie van groot taalmodelle. Die huidige generasie is Qwen3.8, wat in Augustus 2026 vrygestel is: Qwen3.8-Max is die geslote, slegs-API-vlagskip teen 2,4 biljoen parameters, terwyl Qwen3.8-27B 'n kleiner, oopgewig-model is wat 'n paar dae later onder Apache 2.0 vrygestel is, gemik op spanne wat self gasheer wil wees.
DeepSeek is 'n Chinese AI-laboratorium wat bekend is vir mixture-of-experts-modelle wat grensverskuiwende prestasie teen 'n breukdeel van die inferensiekoste ewenaar. Sy huidige generasie, DeepSeek V4, is in April 2026 in twee variante bekendgestel: V4 Pro (1,6 biljoen totale parameters, ongeveer 49 miljard aktief per token) vir gehalte-gefokusde werk, en V4 Flash (284 miljard in totaal, ongeveer 13 miljard aktief) vir latensie-sensitiewe werksladings. Albei word beskikbaar gestel as MIT-gelisensieerde oopgewigte.
Hoe vergelyk Qwen en DeepSeek werklik wat vertaling betref, en nie net op maatstawwe nie?
Die meeste vergelykings tussen Qwen en DeepSeek haal algemene maatstawwe aan: kodering, wiskunde, redenering. Geen van daardie meet vertaalgehalte direk nie, en om elke model op verskillende bronteks te laat loop, maak dit onmoontlik om enige akkuraatheidsgaping te isoleer van wat die teks self vereis het.
MachineTranslation.com se eie vertaalverkeer oor die afgelope 28 dae gee 'n duideliker antwoord, omdat albei modelle die identiese bronteks vertaal het. Oor 98 taalpare en meer as 12,000 ooreenstemmende segmente het DeepSeek hoër behaal in 83 pare; Qwen het hoër behaal in 15. Vernou dit na die 27 pare waar die doeltaal Engels is, en die gaping krimp skerp: DeepSeek wen 63% daarvan (17 van 27), Qwen wen 37% (10 van 27). Oor die oorblywende 71 pare, waar Engels nie die doeltaal is nie, wen DeepSeek 92% (66 van 71).
Wenpersentasie volgens vertaalrigting (98 taalpare, identiese teks)
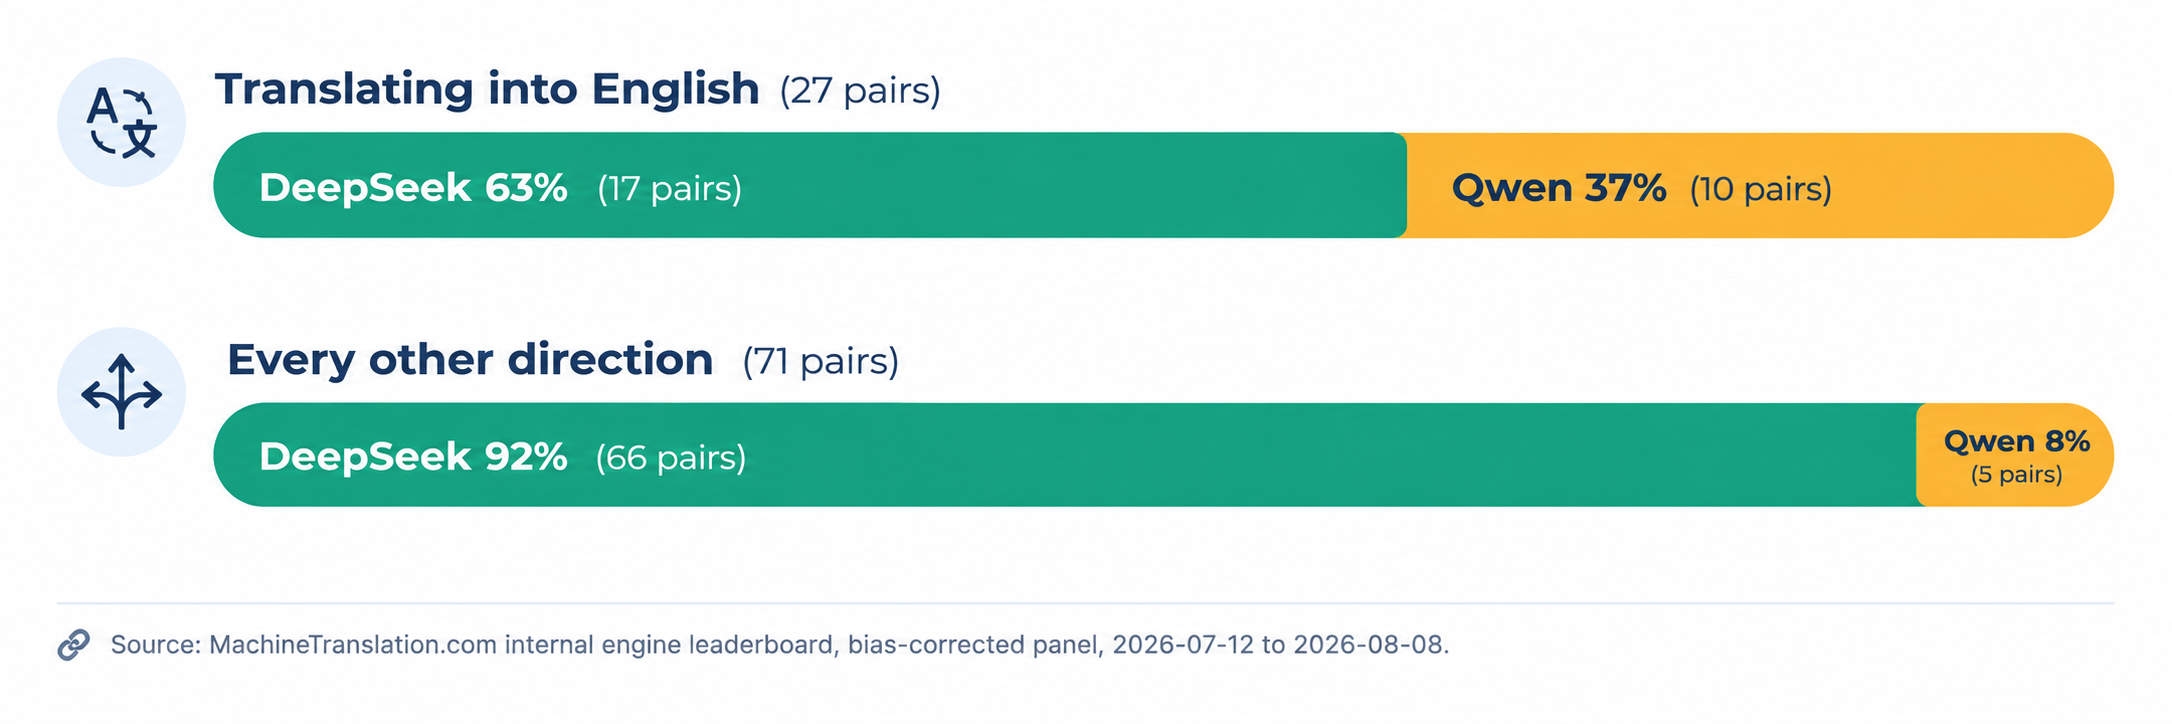
DeepSeek wen oor die algemeen die groot meerderheid van taalpare. Qwen se mededingende venster is nou maar werklik: vertaling in Engels, waar dit meer as 'n derde van die pare wen. Data: MachineTranslation.com se interne enjin-ranglys, sydigheidsgekorrigeerde paneel, 12 Julie tot 8 Augustus 2026.
Die geweegde gemiddelde oor elke ooreenstemmende segment plaas DeepSeek op 9.13 uit 10 en Qwen op 8.98. Dit is 'n werklike gaping, maar dit is nie eweredig versprei nie, wat die nuttiger ding is om te weet as jou inhoud in meer as een rigting beweeg. Dit is dieselfde kop-aan-kop-benadering wat MachineTranslation.com regoor sy volledige modelvergelykingstoetse gebruik, nie net vir hierdie een paar nie.
Die totale getalle hou ook in individuele toetsgevalle stand. Tydens die toetsing van die Franse frase "Elle est directrice adjointe du département commercial," het DeepSeek en Qwen op dieselfde Engelse weergawe gekonvergeer, "deputy director of commercial department". Jy kan daardie regstreekse toetsresultaat direk nagaan. Tydens die toetsing van "as soon as possible" wat in Spaans vertaal is, het DeepSeek van die vier-model-konsensus afgewyk met "esté hecho" in plaas van "se haga", wat 'n werklike afwykingsgeval is wat 'n grammatikale onderskeid tussen proses-teenoor-uitkoms weerspieël, nie 'n fout nie.
Waarom vaar Qwen spesifiek beter wanneer dit in Engels vertaal?
Die data verduidelik nie waarom nie, slegs waar. Sommige van Qwen se sterkste na-Engels-pare is Tamil, Chinees, Pools, Italiaans en Hebreeus, wat brontale is met groot, goed gedokumenteerde Engelstalige opleidingskorpora wat oor die algemeen vir modelbouers beskikbaar is. Buite daardie een rigting geld DeepSeek se voordeel byna oral: sowel uit Engels as tussen nie-Engelse taalpare.
Wat dit uitsluit, is om enigeen van die modelle as 'n universele verstek te behandel. 'n Span wat produklyste uit Spaans in ses tale vertaal en dieselfde prestasierangorde verwag as wat hulle gesien het met die vertaling van 'n Chinese ondersteuningskaartjie in Engels, sou die verkeerde les uit die verkeerde rigting toepas, wat dieselfde asimmetrie is as wat na vore kom in MachineTranslation.com se Spaans-na-Engels-modelontleding, waar die voorste modelle nie dieselfde is as dié wat in die omgekeerde rigting lei nie.
Is Qwen en DeepSeek gratis en oopbron?
Lisensiëring werk verskillend vir elkeen. DeepSeek lisensieer beide V4 Pro en V4 Flash onder MIT, een van die mees permissiewe oopbronvoorwaardes beskikbaar, dus is albei gratis om sonder beperking self te gasheer. Qwen is verdeeld: Qwen3.8-27B word vrygestel onder Apache 2.0 en is gratis om self te huisves, maar die vlagskip Qwen3.8-Max bly gesluit, slegs-API, en onder Alibaba se eie pasgemaakte lisensie.
Prakties beteken dit dat 'n ten volle oop-gewig, MIT-gelisensieerde opsie aan die DeepSeek-kant by albei gehaltevlakke bestaan. Aan die Qwen-kant beteken dit om open-weight te gaan dat die vlagskipmodel prysgegee word.
Wat kos dit om Qwen en DeepSeek op skaal te bedryf?
Na DeepSeek se permanente prysverlaging in Mei 2026 is sy huidige gepubliseerde API-tariewe $0.435 per million input tokens (cache miss) and $0.87 per miljoen output-tokens vir V4 Pro, met V4 Flash wat laer geprys is vir sy latensie-geoptimaliseerde vlak.
Vir spanne wat self-hosting vir enigeen van die modelle doen in plaas daarvan om 'n gehoste API te gebruik, verskuif die kostevergelyking in sy geheel na GPU-infrastruktuur en word dit 'n funksie van parametertelling en aktieweparameter-doeltreffendheid eerder as 'n per-token-tarief.
Is enigeen van die modelle veilig genoeg vir reg-, mediese of gereguleerde inhoud?
Nie een van die modelle publiseer vertalingspesifieke veiligheidsertifiseringe nie, en veiligheidsmaatstawwe vir algemene doeleindes toets nie vir die faalmodusse wat in gereguleerde inhoud saak maak nie: 'n verkeerd vertaalde dosis, 'n verskuifde aanspreeklikheidsklousule, 'n onkonsekwente regsterm. MachineTranslation.com se eie toetsing het presies hierdie soort uiteenlopendheid tussen modelle in regs- en mediese taal gevind, insluitend gevalle waar modelle verskillende regsterme met verskillende omvange gebruik het, ten spyte daarvan dat albei goed gevaar het op algemene gehaltemetrieke.
Vir kontrakte, immigrasiedokumente of kliniese inhoud, is dit 'n rede om die uitset van enige van die modelle te koppel aan 'n menslike verifikasiestap eerder as om 'n enkele KI-uitset op sigwaarde te vertrou, ongeag watter model dit geproduseer het.
Wat beteken dit as jy terselfdertyd na baie tale lokaliseer?
'n Vergelyking wat op een taalpaar gebaseer is, sê vir jou amper niks oor paar nommer veertig nie. Die na-Engels/uit-Engels-splitsing wat hier gedokumenteer is, het oor 'n steekproef van 98 pare standgehou spesifiek omdat dit op daardie skaal getoets is: 'n enkele Engels-na-Spaans-toets, wat is wat die meeste Qwen vs DeepSeek-vergelykings uitvoer, sou getoon het dat DeepSeek gemaklik voor is en niks gesê het oor wat gebeur sodra Tamil, Pools of Hebreeus die pyplyn betree nie.
Dit is die praktiese argument daarvoor om nie by verstek 'n groot lokaliseringsprogram aan een model se uitset te koppel nie. MachineTranslation.com laat loop sowel Qwen as DeepSeek, tesame met meer as 20 ander modelle, op elke vertaling en bring die weergawe vorendag waaroor daardie modelle die meeste saamstem, sodat 'n 68-taal-bekendstelling nie afhang van watter model ook al toevallig die een paar gewen het wat iemand eerste getoets het nie. Jy kan presies sien watter modelle oor enige gegewe vertaling saamgestem of verskil het in die modelontleding per vertaling wat die platform vir elke resultaat wys.
Elke vertaling word nagegaan teen 'n wyer reeks modelle as wat óf Qwen óf DeepSeek alleen kan bied, wat die direkte antwoord is op wat gebeur sodra jou inhoud ophou om in net een rigting te beweeg.
Gereelde vrae
1. Is Qwen of DeepSeek beter vir vertaling?
Regoor 98 taalpare wat op identiese bronteks getoets is, het DeepSeek in 83 daarvan hoër behaal. Qwen se oorwinnings is gekonsentreer in een spesifieke rigting: vertaling na Engels, waar dit ongeveer 'n derde van die tyd wen. In elke ander rigting wen DeepSeek meer as 90% van die tyd.
2. Is Qwen gratis om te gebruik?
Qwen3.8-27B is oop-gewig onder Apache 2.0 en gratis om self te huisves. Die vlagskip Qwen3.8-Max is geslote en slegs beskikbaar deur Alibaba Cloud se betaalde API.
3. Is DeepSeek gratis om te gebruik?
Ja. Albei DeepSeek V4 Pro en V4 Flash word met MIT-gelisensieerde open weights verskeep, so jy kan enigeen van die twee self-host sonder enige lisensiëringskoste. DeepSeek bied ook 'n betaalde API vir spanne wat nie hul eie infrastruktuur wil bestuur nie.
4. Wat is vinniger, Qwen of DeepSeek?
DeepSeek V4 Flash is spesifiek gebou vir lae latensie, met 13 miljard aktiewe parameters per token teenoor V4 Pro se 49 miljard. Qwen se ekwivalente ligter opsie, Qwen3.8-27B, is dense eerder as mixture-of-experts, wat dit oor die algemeen stadiger per token maak teen vergelykbare gehalte.
5. Kan ek Qwen en DeepSeek saam gebruik vir vertaling?
Ja. MachineTranslation.com hardloop albei modelle, plus meer as 20 ander, op elke vertaling en bring die weergawe na vore waaroor hulle die meeste saamstem, so jy is nie vasgevang om een model te kies en te hoop dit is die sterker keuse vir daardie spesifieke taalpaar nie.
6. Wat is die verskil tussen Qwen en DeepSeek se lisensiëring?
DeepSeek lisensieer albei V4-variante onder MIT, een van die mees toelatende oopbronlisensies wat beskikbaar is. Qwen verdeel sy reeks: kleiner modelle soos Qwen3.8-27B word onder Apache 2.0 verskaf, maar die vlagskip Qwen3.8-Max bly gesluit onder 'n pasgemaakte lisensie.