October 2, 2026
Qwen vs Grok: Watter KI-model vertaal beter?
Qwen en Grok is albei algemenedoel AI-modelle, nie vertalingspesifieke hulpmiddels nie, en albei is deel van die poel van modelle wat MachineTranslation.com vir elke vertaling gebruik. Dit is belangrik vir hoe die inligting wat volg, gelees moet word. Hierdie is 'n blik op hoe twee van die platform se eie modelle teen mekaar presteer, met die werklike voorbehoude wat met daardie soort data gepaardgaan, en nie 'n kompetisie tussen twee eksterne uitdagers en die platform self nie.
Wat is Qwen en Grok?
Qwen is Alibaba se familie van groot taalmodelle, tans by sy Qwen3.8-generasie, en is by MachineTranslation.com se modelpoel gevoeg as deel van die platform se deurlopende uitbreiding. Grok is xAI se modelreeks, tans op Grok 4.7 tydens die skryf hiervan, wat deur verskeie vrystellings gevorder het sedert die weergawe wat oorspronklik in hierdie artikel vergelyk is, en het afsonderlik by die platform aangesluit. Geeneen van die modelle is spesifiek vir vertaling gebou nie. Albei is stelsels vir algemene doeleindes wat toevallig baie tale as deel van 'n breër taalvermoë hanteer, wat 'n ander vertrekpunt is as 'n platform wat spesifiek met die oog op vertaalkwaliteit gebou en getoets is.
Hoe vergelyk Qwen en Grok op MachineTranslation.com se eie data?
Oor die afgelope 28 dae van platformverkeer het Grok gemiddeld hoër as Qwen presteer: 9.26 uit 10 teenoor 8.87. Grok se swakste presterende 10% van vertalings het steeds 'n gemiddeld van 9.2 gehandhaaf, terwyl Qwen se swakste presterende 10% tot 7.6 gedaal het, 'n wyer gaping aan die onderkant as wat die gemiddeld alleen suggereer.
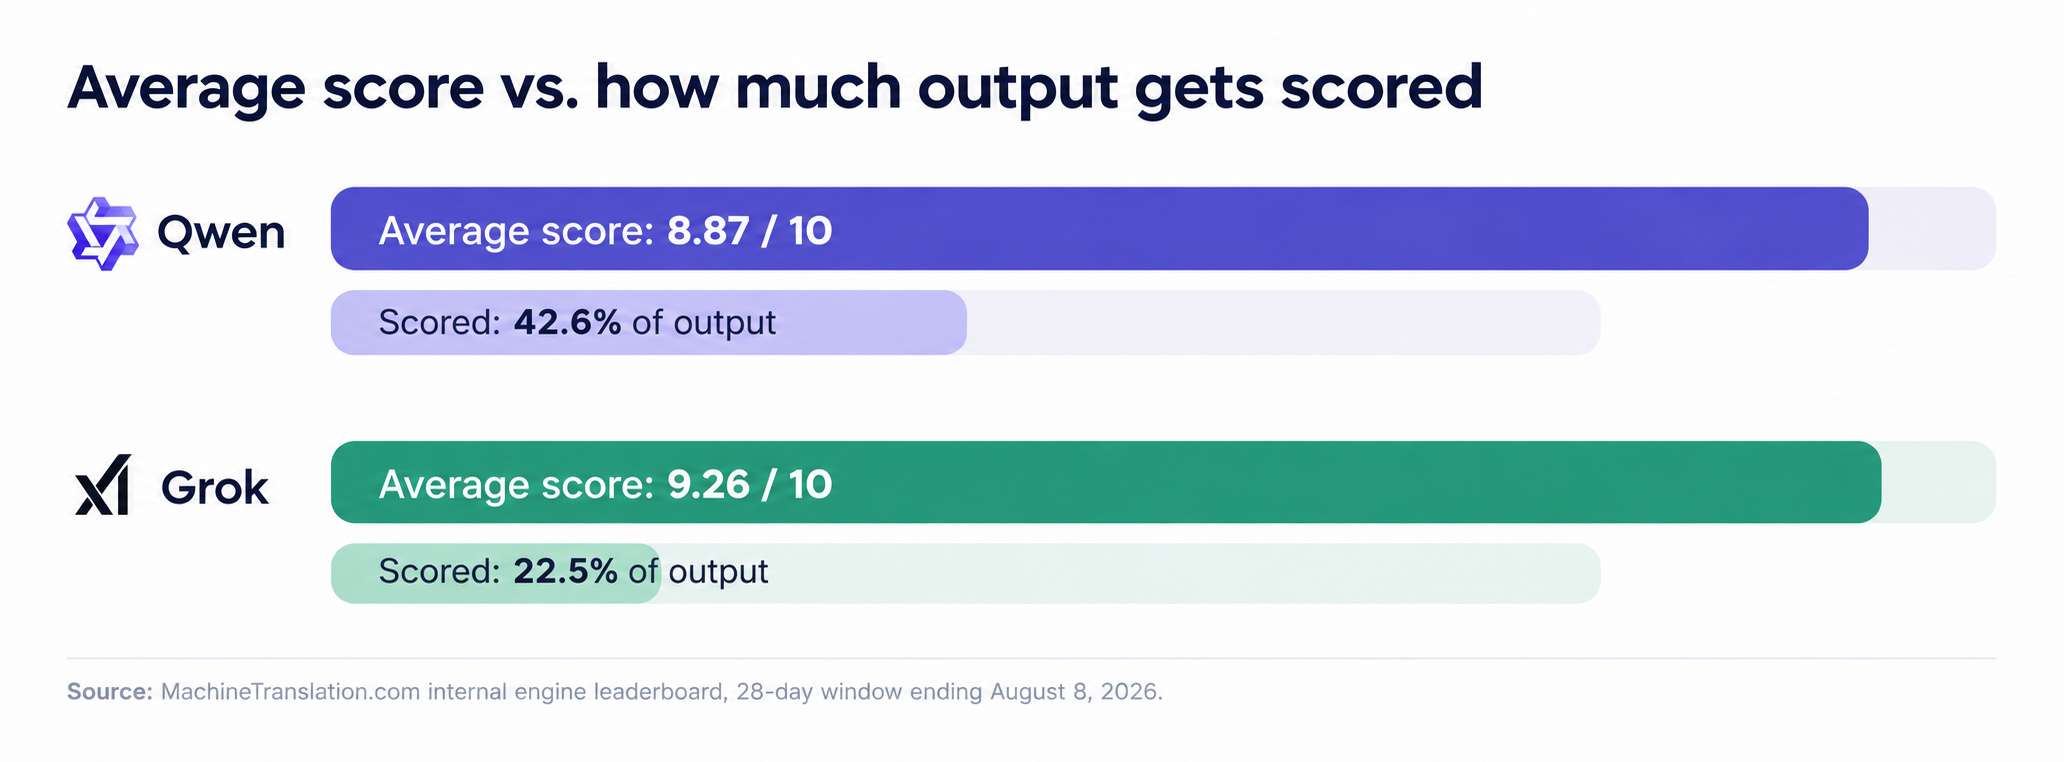
Grok se gemiddelde telling is hoër, maar dit berus daarop dat minder as 'n kwart van sy uitset gegradeer is, teenoor byna die helfte vir Qwen. Die twee stawe vertel verskillende dele van dieselfde storie.
| Qwen | Grok | |
|---|---|---|
| Persentasie van uitset gegradeer | 42.6% | 22.5% |
| Gemiddelde telling | 8.87 / 10 | 9.26 / 10 |
| Onderste 10% van tellings | 7.6 | 9.2 |
Bron: MachineTranslation.com se interne enjin-ranglys, 28-dae-venster wat eindig op August 8, 2026.
Beteken Grok se hoër telling dat dit die beter keuse is?
Nie op sy eie nie. Grok word baie minder op die platform gebruik as Qwen, en minder as 'n kwart van sy vertalings word hoegenaamd beoordeel, teenoor byna die helfte van Qwen s'n. 'n Kleiner, minder verteenwoordigende steekproef kan 'n gemiddelde beter of slegter laat lyk as wat dit sou wees oor dieselfde volume wat Qwen sien. MachineTranslation.com se eie verslaggewing oor hierdie data beskou die dekking van tellings as 'n ware beperking, en nie as 'n voetnoot nie: 'n enjin wat beoordeel word op 'n klein gedeelte van sy verkeer is nie so deeglik getoets soos een wat oor byna die helfte van sy uitset beoordeel is nie.
Die eerlike interpretasie is dat Grok se syfers belowend is, maar yler. Qwen s'n is gemiddeld laer, maar rus op 'n baie groter, meer verteenwoordigende basis. Geen van die twee feite kanselleer die ander een uit nie.
Wat van taaldekking?
Nóg Qwen nóg Grok publiseer 'n geverifieerde lys van taalpare waar werkverrigting afneem, en daar is geen onafhanklike toetse om een te bevestig nie. Wat met sekerheid gesê kan word, is dat geen van die modelle rondom vertaalkwaliteit oor 'n spesifieke stel tale gebou is soos wat 'n toegewyde vertaalplatform is nie. MachineTranslation.com toets en ondersteun meer as 270 tale direk, wat 'n ander tipe aanspraak is as 'n veeldoelige model se breë maar ongetoetste veeltalige vermoë.
Hoe MachineTranslation.com Qwen en Grok werklik gebruik
MachineTranslation.com laat Qwen, Grok, en meer as 20 ander KI-modelle op elke vertaling loop, en bring dan die weergawe waaroor daardie modelle die meeste saamstem na vore. Geen model word uitgesluit omdat dit gemiddeld laer presteer nie. Om baie modelle gelyktydig te laat loop, beteken dat gevalle gevang word waar 'n model met 'n laer gemiddelde telling steeds 'n spesifieke sin regkry wat 'n model met 'n hoër telling misloop. Qwen se werkverrigting word ook verdeel volgens rigting en taalpaar op maniere wat die moeite werd is om te weet voordat 'n enkele model gekies word; dit word meer breedvoerig bespreek in MachineTranslation.com se Qwen vs DeepSeek-vergelyking. Vir 'n nader kyk na hoe modelle direk teen mekaar getoets word, sien MachineTranslation.com se volledige modelvergelykingstoetsing.
Gereelde vrae
1. Is Qwen of Grok beter vir vertaling?
Op MachineTranslation.com se eie 28-dae-enjindata behaal Grok gemiddeld 'n hoër telling as Qwen, 9.26 teenoor 8.87 uit 10. Maar Grok word op 'n baie kleiner, minder verteenwoordigende deel van sy uitset beoordeel, so hierdie is nie 'n suiwer kop-aan-kop-vergelyking soos 'n ooreenstemmende-segment-toets sou wees nie.
2. Hoekom het Grok 'n hoër gemiddelde telling maar minder beoordeelde vertalings?
Grok word minder gereeld op die platform gebruik en slegs ongeveer 22.5% van sy uitset word beoordeel, teenoor 42.6% vir Qwen. 'n Kleiner, minder verteenwoordigende steekproef kan 'n gemiddelde opblaas of onderskat, en daarom moet hierdie vergelyking as rigtinggewend gelees word, nie as definitief nie.
3. Ondersteun Qwen of Grok meer tale?
Beide is algemene-doel KI-modelle sonder 'n gepubliseerde, geverifieerde lys van taalspesifieke beperkings. Nie een is spesifiek vir vertaling gebou nie, wat verskil van 'n platform wat vertaalkwaliteit direk oor 270+ tale heen toets en beoordeel, in plaas daarvan om op breë veeltalige opleiding staat te maak as 'n plaasvervanger vir gemete vertaalprestasie.
4. Kompeteer MachineTranslation.com met Qwen en Grok?
Nee. MachineTranslation.com laat Qwen, Grok, en meer as 20 ander KI-modelle op elke vertaling loop en bring die weergawe waaroor daardie modelle die meeste saamstem na vore. Dit toets en kombineer modelle soos hierdie eerder as om teen hulle te kompeteer as 'n aparte eie model.
5. Watter KI-model beveel MachineTranslation.com aan vir vertaling?
Geen by verstek nie. Verskillende modelle presteer verskillend na gelang van taalpaar en inhoudstipe, en die gaping tussen hulle kan in enige rigting strek afhangende van wat vertaal word. Daardie variasie is presies hoekom die platform veelvuldige modelle op elke vertaling laat loop in plaas daarvan om een as 'n vaste aanbeveling te kies.