May 8, 2026
Grok مقابل Claude في الترجمة: ما تظهره اختبارات الأداء (2026)
يعد كل من Grok (xAI) و Claude (Anthropic) أداتي ترجمة قادرتين بالذكاء الاصطناعي، ولكن لديهما نقاط قوة مختلفة هيكلياً. بالنسبة لمعظم مهام الترجمة العامة، لن تلاحظ فرقاً جوهرياً بينها. بالنسبة لسيناريوهين محددين (ترجمة محتوى حول الأحداث الأخيرة، وترجمة المستندات الرسمية التي تتطلب الدقة)، فإن الاختلاف حقيقي ويكمن في كيفية بناء كل نموذج.
يغطي هذا المقال ما يقدمه كل نموذج بالفعل للترجمة، وأين تضعهما معايير التقييم المستقلة، وما يجب استخدامه عندما لا يكون مخرج أي من النموذجين كافيًا بمفرده.
كيف يقارن Grok و Claude من حيث جودة الترجمة؟
الإجابة المختصرة: يتصدر Claude اختبارات القياس المهنية المستقلة للترجمة. الميزة المحددة لـ Grok هي الوصول إلى المعرفة في الوقت الفعلي، وليست جودة الترجمة الإجمالية.
في اختبارات التقييم الداخلية لـ MachineTranslation.com، يحرز Claude (فئة 3.5 Sonnet) 93.8 من أصل 100 في جودة الترجمة — التي تجمع بين الدقة والمصطلحات والأسلوب. لا يظهر Grok ضمن أفضل 14 حلاً في تقرير Intento بعنوان State of Translation Automation 2025، والذي قيّم 46 محرك MT و LLMs عبر 11 زوجاً لغوياً. يظهر كل من Claude Opus 4 و Claude Sonnet 3.7 ضمن أفضل 14. المصدر: المؤشرات المرجعية الداخلية لـ MachineTranslation.com؛ تقرير Intento State of Translation Automation 2025.
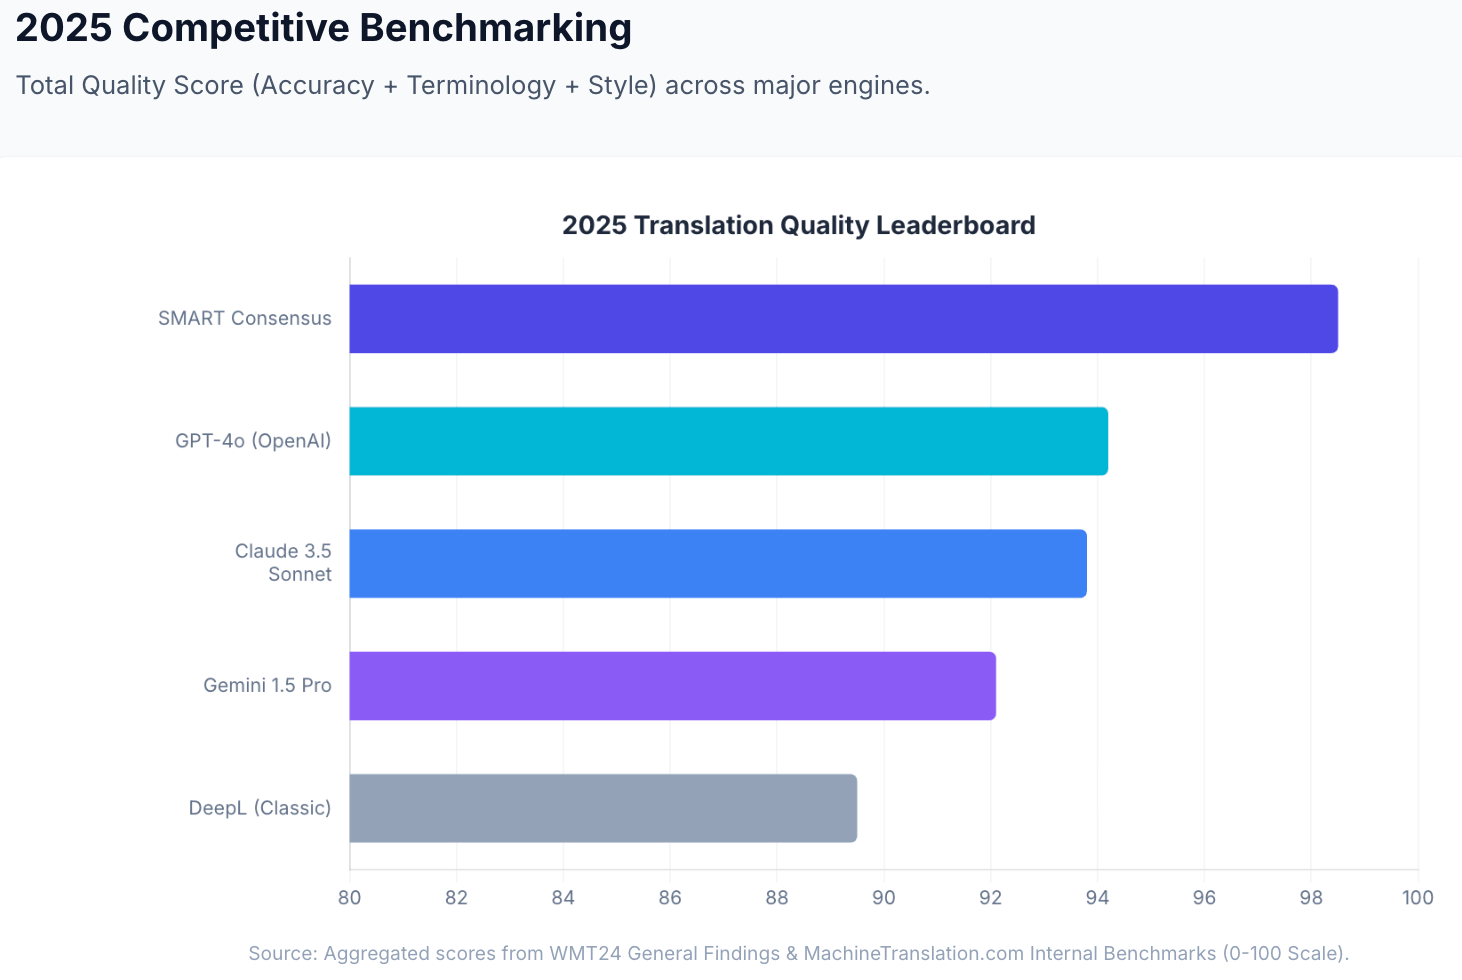
في WMT24 (مسابقة التقييم المرجعي المستقلة الرئيسية في قطاع الترجمة)، احتل Claude 3.5 المرتبة الأولى في 9 من أصل 11 زوجاً لغوياً، متفوقاً على GPT-4 ومحركات neural MT المخصصة. في دراسة Lokalise العمياء لعام 2025 التي أجراها مترجمون محترفون، تم تقييم 78% من ترجمات Claude 3.5 بأنها جيدة — وهي النسبة الأعلى من بين أي LLM تم اختباره.
لم يتم تقييم Grok في WMT24 أو في تقييم LQA المستقل لـ Intento بمستوى مماثل. يدرج Slator Pro Guide (2025) نموذج Grok كأحد نماذج LLMs للأغراض العامة المستخدمة في الترجمة في البيئات المهنية، إلى جانب GPT و Claude، ولكنه لا يصنفه أعلى من أي منهما.
| Benchmark | Grok | Claude |
|---|---|---|
| درجة الجودة الداخلية لـ MachineTranslation.com | لم تُقس على مستوى المقارنة المرجعية | 93.8/100 (فئة 3.5 Sonnet) |
| أفضل 14 حلاً من Intento 2025 | غير مدرج | تم إدراج كل من Claude Opus 4 و Sonnet 3.7 |
| أزواج لغات WMT24 | لم يتم تقييمه | المركز الأول في 9/11 من أزواج اللغات |
| الدراسة العمياء لـ Lokalise 2025 | لم يتم تقييمه | 78% جيد (الأعلى بين أي LLM) |
المصدر: المقارنات المعيارية الداخلية لـ MachineTranslation.com؛ وIntento State of Translation Automation 2025؛ وWMT24 General MT Findings؛ وLokalise 2025.
أين يمتلك Grok ميزة حقيقية؟
الترجمة في الوقت الفعلي وترجمة الأحداث الجارية. السمة المعمارية المحددة لـ Grok هي تكامله مع بيانات منصة X (سابقاً Twitter) والبحث المباشر على الإنترنت. على عكس Claude ومعظم LLMs الأخرى، التي تم تدريبها على مجموعات بيانات ثابتة ذات تاريخ انقطاع معرفي محدد، يدمج Grok معلومات في الوقت الفعلي في مخرجاته. بالنسبة لمهام الترجمة التي تتضمن الأحداث الأخيرة، أو المنتجات الصادرة حديثاً، أو المصطلحات السياسية الناشئة، أو الأخبار الحالية، أو المحتوى الذي يشير إلى أشياء حدثت خلال الأسابيع الماضية، فإن Grok لديه إمكانية الوصول إلى سياق لا يمتلكه Claude.
وهذا الأمر مهم تحديداً لـ: ترجمة المقالات الإخبارية حول الأحداث الأخيرة، وتوطين إعلانات المنتجات للأسواق سريعة الحركة، والتعامل مع المصطلحات المصاغة حديثاً أو العامية التي تأتي لاحقة لبيانات تدريب النماذج الأخرى، وأي محتوى يعتمد معناه على معرفة ما حدث مؤخراً.
المصطلحات الناشئة والمتطورة. تنتج المجالات التقنية والصناعات والسياقات الثقافية مصطلحات جديدة باستمرار. بالنسبة لمهام الترجمة التي تتضمن مصطلحات حديثة الصياغة، أو لغة تنظيمية جديدة، أو تسميات منتجات جديدة، فإن تدريب Grok المحدث وبحثه في الوقت الفعلي يمنحانه إمكانية الوصول إلى أنماط الاستخدام التي لا تلتقطها لقطات بيانات التدريب الأقدم.
نافذة السياق والاستدلال لـ Grok 4.1. Grok 4.1 (اعتباراً من أواخر 2025) يتميز بنافذة سياق بسعة 131K-token وقدرات استدلال محسنة، مما يجعله قادراً على التعامل مع المستندات المعقدة ومتعددة الطبقات حيث تكتسب العلاقات بين البنود والتماسك المنطقي أهمية بالغة.
أين يمتلك Claude ميزة حقيقية؟
جودة الترجمة في اختبارات القياس المستقلة. إن تفوق Claude موثق من خلال تقييم مهني مستقل بدلاً من الادعاءات الذاتية. صنف WMT24 Claude 3.5 في المرتبة الأولى في 9 من أصل 11 زوجاً لغوياً مقابل جميع المنافسين. وجدت دراسة Lokalise العمياء لعام 2025 أن المترجمين المحترفين فضلوا مخرجات Claude 3.5 بمعدل جيد بلغ 78% — وهو أعلى من GPT-4 و DeepL و Google Translate في التقييم نفسه. هذه تقييمات عمياء: قام مترجمون محترفون بتقييم المخرجات دون معرفة النموذج الذي أنتجها.
أزواج لغوية محددة حسب Intento 2025. يظهر Claude Opus 4 و Sonnet 3.7 في فئة الأفضل للترجمة من الإنجليزية إلى الألمانية، ومن الإنجليزية إلى اليابانية، ومن الإنجليزية إلى الإيطالية، ومن الإنجليزية إلى الكورية، ومن الإنجليزية إلى الهولندية، ومن الإنجليزية إلى العربية، ومن الإنجليزية إلى الفرنسية في تقييم LQA البشري لـ Intento. بالنسبة لهذه الأزواج، يُعد Claude الخيار الأقوى الموثق بين الاثنين.
دقة النبرة والمحتوى ذي الفروق الدقيقة. فضل المترجمون المحترفون في دراسة Lokalise مخرجات Claude بأعلى معدل مقارنة بأي LLM — مما يعكس قوة Claude الموثقة في الحفاظ على الأسلوب اللغوي، وصوت الكاتب، والمعنى السياقي. بالنسبة للترجمة الأدبية، والوثائق القانونية، والمراسلات الرسمية، والنصوص التسويقية حيث تهم طريقة التعبير بقدر أهمية ما يقال، يقدم Claude باستمرار أداءً جيداً في التقييمات المستقلة.
اتساق المستندات الطويلة. يدعم Claude 4.6 Sonnet نافذة سياق تبلغ 200K-token، مع دعم Claude Opus 4.6 لـ 1M tokens في beta. بالنسبة للمستندات الرسمية الطويلة (العقود، والأدلة التقنية، وتقارير التجارب السريرية)، يمكن لـ Claude معالجة المستند بأكمله في تمريرة واحدة، مع الحفاظ على اتساق المصطلحات في جميع أنحائه. تظهر المستندات التي تمت معالجتها في أجزاء معدل عدم اتساق في المصطلحات أعلى بنسبة 28% مقارنة بمعالجة المستند بأكمله. المصدر: بيانات MachineTranslation.com الداخلية.
كيف يقارنان من حيث دعم اللغات والأسعار؟
دعم اللغات: يدعم كل من Grok 4.1 و Claude 4.6 الترجمة عبر معظم اللغات العالمية الرئيسية. تم تقييم Claude بشكل مستقل عبر أزواج اللغات الأوروبية وشرق الآسيوية، وحقق نتائج قوية. تحسن دعم Grok متعدد اللغات عبر الإصدارات المتعاقبة. بالنسبة للغات ذات الموارد المحدودة، تتراجع جودة كلا النموذجين — وتكون المراجعة البشرية مناسبة للمحتوى المكتوب بأزواج اللغات ذات الموارد المحدودة بغض النظر عن النموذج المستخدم.
الأسعار:
| الخطة | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| للمستهلكين (شهرياً) | SuperGrok: $30/شهر | Claude Pro: $20/شهر |
| مدخلات API (لكل مليون رمز) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| مخرجات API (لكل مليون رمز) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| الفئة المجانية | نعم (محدودة المعدل عبر X/Grok.com) | نعم (محدودة المعدل عبر claude.ai) |
في فئة المستهلكين، Claude Pro ($20/month) is cheaper than SuperGrok ($30/شهر). على مستوى API، يتمتع Grok 4.1 بميزة تكلفة طفيفة مقارنة بـ Claude Sonnet 4.6 في سير عمل الترجمة كثيف المدخلات.
أيهما أفضل لأنواع محتوى معينة؟
| نوع المحتوى | النموذج الموصى به | السبب |
|---|---|---|
| الأخبار الأخيرة / الأحداث الجارية | Grok | الوصول إلى البيانات في الوقت الفعلي؛ تفتقر النماذج المدربة بشكل ثابت إلى السياق الحالي |
| المصطلحات الناشئة / إطلاق المنتجات الجديدة | Grok | يتيح تكامل البحث المباشر التقاط أنماط الاستخدام الحديثة |
| الوثائق القانونية الرسمية | Claude | التقييم المستقل لـ WMT24 وLokalise 2025؛ دقة النبرة |
| المحتوى الطبي / السريري | Claude | مكانة متميزة في اختبارات القياس المستقلة؛ الحفاظ على الأسلوب اللغوي |
| النصوص التسويقية / المحتوى الإبداعي | Claude | تفضيل دراسة Lokalise 2025 العمياء؛ الفروق الدقيقة في النبرة |
| الوثائق التقنية (الطويلة) | Claude | نافذة سياق تتراوح بين 200K-1M؛ اتساق المصطلحات عبر كامل النص |
| وسائل التواصل الاجتماعي / المحتوى الحواري | أي منهما | يتعامل كلاهما بشكل جيد مع أزواج اللغات الحوارية ذات الموارد العالية |
| المطور / تكامل API | أي منهما | يوفر كلاهما إمكانية الوصول إلى API؛ Grok أرخص قليلاً في رموز المدخلات |
ماذا تستخدم عندما لا يكون نموذج واحد كافياً
إن كلاً من Grok و Claude أداتان بنموذج واحد. ينتج كل نموذج ذكاء اصطناعي فردي (بغض النظر عن مدى قدرته) أخطاءً لا يمكنه اكتشافها في مخرجاته الخاصة. قد تظل الترجمة الطليقة والواثقة من أي من Grok أو Claude خاطئة دلالياً، ودون إجراء تدقيق متقاطع لا توجد طريقة لمعرفة ذلك.
ويُعد كل من Grok و Claude من بين 22 نموذجاً في نظام SMART الخاص بموقع MachineTranslation.com. يشغّل SMART جميع النماذج الـ 22 في آن واحد (بما في ذلك Grok و Claude) ويعيد المخرجات التي تتفق عليها الأغلبية.
ما يعنيه هذا بالنسبة لمسألة Grok مقابل Claude: تساهم كل من قوة Grok في الوقت الفعلي وعمق Claude السياقي في الإجماع نفسه. عندما تتفق، فإن هذا الاتفاق يعد مؤشراً قوياً على الجودة.
في اختبارات التقييم الداخلية لـ MachineTranslation.com، تسجل النماذج الفردية من الفئة الأولى 93-94 من أصل 100 في جودة الترجمة. تصل مخرجات إجماع SMART إلى 98.5/100. المصدر: المقاييس المرجعية الداخلية لـ MachineTranslation.com ونتائج الترجمة الآلية العامة لـ WMT24.
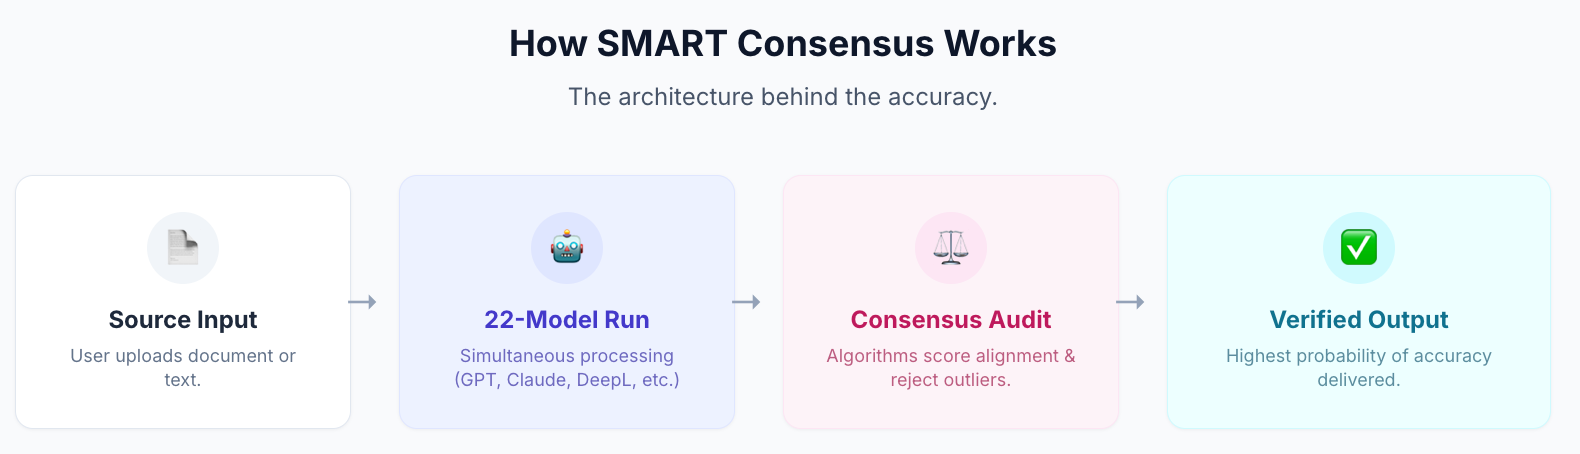
قضى المستخدمون الذين تحولوا من الترجمة أحادية المحرك إلى SMART وقتاً أقل بنسبة 27% في التحقق من المخرجات وتصحيحها. المصدر: البيانات الداخلية لـ MachineTranslation.com.
بالنسبة للمحتوى عالي المخاطر (الوثائق القانونية، والملفات التنظيمية، والإرشادات الطبية)، يصعّد التحقق البشري إجماع SMART إلى مراجع مهني معتمد داخل المنصة نفسها. لا توجد جهة خارجية. دقة مضمونة بنسبة 100%.
ترجم باستخدام Grok و Claude و 20 نموذجًا آخر على MachineTranslation.com — مجانًا، دون الحاجة للتسجيل.
الأسئلة الشائعة
1. هل Grok أفضل من Claude في الترجمة؟
بالنسبة لمعظم مهام الترجمة القياسية، يتصدر Claude في اختبارات القياس المستقلة: الأول في 9 من أصل 11 زوجًا لغويًا في WMT24، وتقييم جيد بنسبة 78% في دراسة Lokalise العمياء لعام 2025، و93.8/100 في اختبارات قياس الجودة الداخلية لـ MachineTranslation.com. تكمن ميزة Grok الخاصة في المحتوى الذي يتطلب معرفة بالأحداث الجارية، إذ يمنحه وصوله إلى البيانات في الوقت الفعلي سياقاً لا تمتلكه النماذج المدربة بشكل ثابت بما في ذلك Claude. للأخبار الحديثة، والمصطلحات الناشئة، والمحتوى الحساس للوقت، فإن Grok هو الخيار الأقوى.
2. ما هي ميزة Grok على Claude في الترجمة؟
يدمج Grok البيانات في الوقت الفعلي من X (Twitter سابقًا) والبحث المباشر على الإنترنت. على عكس Claude ومعظم LLMs الأخرى المدربة على مجموعات بيانات ثابتة، يستطيع Grok الوصول إلى معلومات حول الأحداث الأخيرة، والمصطلحات المصاغة حديثاً، والسياق الحالي عند توليد الترجمات. مما يجعله أقوى تحديداً في ترجمة المحتوى الإخباري، والمنتجات التي تم إصدارها حديثاً، وأي مواد يعتمد معناها على أحداث أو أنماط لغوية من الأسابيع القليلة الماضية.
3. ما هي ميزة Claude على Grok في الترجمة؟
ميزة Claude موثقة من خلال تقييم مهني مستقل. احتل Claude 3.5 المرتبة الأولى في 9 من أصل 11 زوجاً لغوياً في WMT24، وفضل المترجمون المحترفون في دراسة Lokalise العمياء لعام 2025 مخرجاته بمعدل جيد بلغ 78% — وهو الأعلى لأي LLM تم اختباره. يظهر Claude أيضاً ضمن أفضل 14 حلاً لدى Intento عبر أزواج لغوية متعددة في تقييم LQA البشري، بينما لا يظهر Grok. بالنسبة لمهام الترجمة الرسمية والمهنية وعالية المخاطر، فإن مكانة Claude المستقلة في اختبارات القياس المرجعي هي عامل التمييز الموثق.
4. أيهما أفضل للترجمة القانونية، Grok أم Claude؟
يُعد Claude الخيار الأقوى للترجمة القانونية بناءً على تقييم مستقل. احتل Claude 3.5 المرتبة الأولى في معظم أزواج اللغات الأوروبية ذات الموارد العالية في WMT24، وحصل على أعلى تقييمات التفضيل في الدراسات العمياء من المترجمين المحترفين. بالنسبة للمحتوى القانوني الذي يتطلب دقة معتمدة، لا يكفي أي من النموذجين بمفرده — إذ توفر ميزة التحقق البشري من MachineTranslation.com دقة بنسبة 100% من مراجع مهني معتمد داخل المنصة نفسها، دون الحاجة إلى مورد خارجي.
5. هل يتوفر كل من Grok و Claude على MachineTranslation.com؟
نعم. كلاهما من بين الـ 22 نموذجاً في نظام SMART الخاص بـ MachineTranslation.com. تشغّل كل عملية ترجمة SMART كلاً من Grok و Claude و 20 نموذجاً آخر بالتزامن، وتُرجع النتيجة التي تتفق عليها الأغلبية. بدلاً من الاختيار بينها، تتلقى إجماع جميع نماذج AI.
6. كيف يقارن Grok و Claude من حيث الأسعار؟
في فئة المستهلكين، تبلغ تكلفة Claude Pro $20/month versus SuperGrok at $30/شهر. على مستوى API، يُعد Grok 4.1 أرخص قليلاً في رموز الإدخال ($2/M vs. $3/M لـ Claude Sonnet 4.6) والإخراج ($10/M vs. $15/M). تتضمن خطة MachineTranslation.com المجانية كلا النموذجين كجزء من إجماع SMART المكون من 22 نموذجاً، دون الحاجة للتسجيل.
7. أي نموذج ذكاء اصطناعي هو الأفضل لترجمة المقالات الإخبارية؟
لترجمة المقالات الإخبارية، يمتلك Grok ميزة هيكلية: فدمج البيانات في الوقت الفعلي لديه يعني أن لديه سياقاً حالياً للأحداث الموصوفة، وهو ما قد تفتقر إليه النماذج المدربة بشكل ثابت. بالنسبة لترجمة الأخبار العامة حيث لا تكون الحداثة أمرًا بالغ الأهمية، فإن أداء Claude المرجعي يكون أقوى. بالنسبة لترجمة الأخبار بكميات كبيرة حيث تهم الحداثة والدقة معاً، فإن SMART الخاص بـ MachineTranslation.com يقوم بتشغيل كلا النموذجين ويعيد مخرجات التوافق بينهما.