October 9, 2026
Qwen مقابل ChatGPT: أي نموذج ذكاء اصطناعي يترجم بشكل أفضل؟
الجيل الحالي من ChatGPT و Qwen هما جزء من مجموعة النماذج التي يعتمد عليها MachineTranslation.com في كل ترجمة، وليسا منافسَين خارجيَين يتم تقييمهما مقارنة بالمنصة نفسها. وعند تشغيل النص نفسه عبر كليهما على مقاطع متطابقة، يتفوق ChatGPT في الحصة الأكبر من أزواج اللغات بشكل عام. أما عند تقسيم النتائج حسب الاتجاه، يضيق الفارق بشكل حاد في موضع محدد: الترجمة إلى الإنجليزية، حيث يكاد الاثنان يتعادلان.
هل يوجد أي ذكاء اصطناعي أفضل من ChatGPT في الترجمة؟
ازداد الاهتمام العام ببدائل ChatGPT مع تحسن النماذج المنافسة، على الرغم من أن الأسباب تختلف اختلافاً كبيراً باختلاف حالة الاستخدام ولا يوجد تفسير واحد لذلك. وبالنسبة للترجمة على وجه التحديد، فإن السؤال الأكثر فائدة هو أي نموذج يقدم أداءً أفضل فعلياً في زوج لغوي معين، وهو سؤال قابل للاختبار بدلاً من أن يكون مسألة انطباعات شخصية.
على مدار آخر 28 يوماً من حركة البيانات على MachineTranslation.com، قام كلا النموذجين بترجمة نص أصلي متطابق عبر 98 زوجاً لغوياً. وحقق ChatGPT درجات أعلى في 77 زوجاً منها؛ بينما حقق Qwen درجات أعلى في 21 زوجاً. ويضع المتوسط المرجح عبر المخرجات المتطابقة ChatGPT عند 9.10 من 10 وQwen عند 8.98، وهي فجوة حقيقية ولكنها متواضعة في المتوسط، تُخفي تفاوتاً أكثر حدة بمجرد أخذ اتجاه الترجمة في الاعتبار.
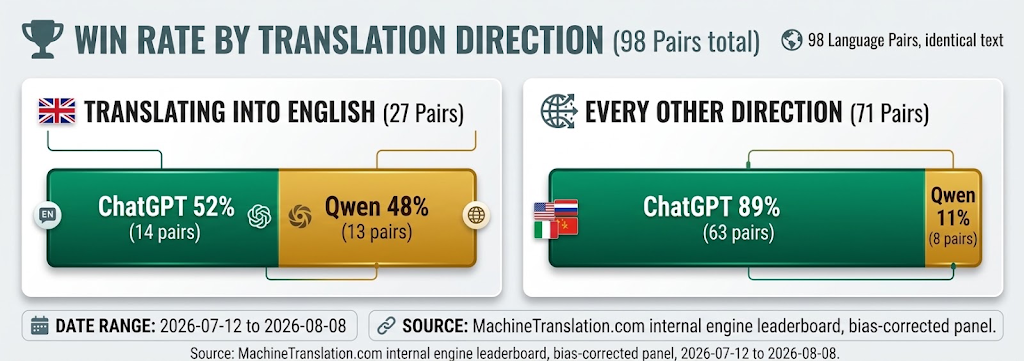
عند الترجمة إلى الإنجليزية، يكاد النموذجان يتعادلان. أما في جميع الاتجاهات الأخرى، يتفوق ChatGPT في الغالبية العظمى من الأزواج المختبرة.
| ChatGPT | Qwen | |
|---|---|---|
| النسبة المئوية للمخرجات التي تم تقييمها | 54.76% | 42.6% |
| متوسط التقييم | 8.89 / 10 | 8.87 / 10 |
| أدنى 10% من الدرجات | 7.8 | 7.6 |
| معدل الفوز، إلى الإنجليزية | 52% | 48% |
| معدل الفوز، في جميع الاتجاهات الأخرى | 89% | 11% |
لماذا تختفي الفجوة تقريباً عند الترجمة إلى الإنجليزية؟
تُظهر البيانات أين يحدث هذا التفاوت، وليس سببه. ما هو واضح أن القدرة التنافسية لـ Qwen ليست موزعة بالتساوي. فمن بين 27 زوجاً لغوياً تكون فيها اللغة الهدف هي الإنجليزية، يتفوق Qwen في 13 زوجاً، وهو ما يشبه رمية عملة تقريباً. ومن بين الأزواج الـ 71 المتبقية، سواء في الترجمة من الإنجليزية أو بين لغتين غير الإنجليزية، يفوز ChatGPT في 63 زوجاً، أي بنسبة 89% منها. وأي فريق يفترض أن أداء Qwen في الترجمة إلى الإنجليزية ينطبق أيضاً على الترجمة من الإنجليزية أو بين أزواج لغوية غير إنجليزية سيكون قد استخلص الدرس الخاطئ من الاتجاه الخاطئ.
هل Qwen شركة صينية، وهل يهم ذلك بالنسبة للترجمة؟
تم تطوير Qwen بواسطة Alibaba Cloud، ومقرها الصين. في حد ذاته، لا يغير هذا من مدى جودة ترجمة النموذج لجملة معينة؛ فالبيانات أعلاه تعكس جودة المخرجات الفعلية بغض النظر عن مكان بناء النموذج. ولكن النقطة التي قد يكون فيها ذلك مهماً هي التعامل مع البيانات: يجب على الشركات التي تترجم محتوى خاضعاً للرقابة أو حساساً (مثل العقود، والسجلات الطبية، والمعلومات الشخصية) أن تتعامل مع مسألة المكان الذي يعالج فيه مزود الذكاء الاصطناعي هذا المحتوى ويخزنه كبند حقيقي من بنود العناية الواجبة، بمعزل عن جودة الترجمة نفسها. ينطبق هذا على أي مزود للذكاء الاصطناعي، وليس على Qwen على وجه التحديد، وهو جزء من سبب قيام MachineTranslation.com بنشر ممارساته الخاصة في التعامل مع البيانات وأمانها بشكل مباشر بدلاً من ترك التساؤل دون إجابة.
هل يُعد أي من النموذجين أكثر موثوقية في الترجمة القانونية والتجارية؟
ليس بشكل متسق، والتباين لا يرتبط دائمًا بالنموذج الذي يحصل على درجات أعلى. كشفت اختبارات MachineTranslation.com لنصوص العقود الحقيقية عن حالتين منفصلتين تجدر معرفتهما قبل الوثوق بأي من النموذجين في النصوص القانونية. وفي بعض الأحيان، تنعكس النتيجة مع التعبيرات الاصطلاحية: إذ أظهر اختبار مقارنة مباشر ومنفصل أن ChatGPT ترجم تعبيرًا اصطلاحيًا ألمانيًا ترجمة حرفية وغير صحيحة، بينما توصل Qwen إلى المعنى الاصطلاحي الصحيح، وهو تذكير بأن التفوق الإجمالي لأي من النموذجين في البيانات المجمعة لا ينطبق بالضرورة على كل جملة على حدة.
| حالة الاختبار | ChatGPT | Qwen |
|---|---|---|
| "At-will employment" إلى الألمانية | صياغة وظيفية قابلة للاستخدام | استعان بمفهوم قانوني لا علاقة له |
| بند تحديد المسؤولية إلى الإسبانية | "que surjan de" | "derivados de" (اختلاف يغير النطاق) |
| "Ich verstehe nur Bahnhof" (تعبير اصطلاحي ألماني) | ترجمة حرفية، غير صحيحة | المعنى الاصطلاحي الصحيح |
لا يتفوق أي من النموذجين بشكل متسق في هذه الحالات الثلاث: فالدرجة الإجمالية لنموذج معين لا تتنبأ بأدائه مع أي مصطلح أو عبارة محددة. وهذا هو السبب أيضًا في أن النصوص القانونية والتعاقدية تستفيد من خطوة التحقق البشري بغض النظر عن النموذج الذي أنشأ المسودة الأولى.
ماذا عن تغطية اللغات؟
لا ينشر أي من ChatGPT أو Qwen قائمة موثقة ومؤكدة بشكل مستقل لأزواج اللغات التي تنخفض فيها جودة الترجمة. كلاهما نموذجان متعددا الأغراض مع تدريب واسع متعدد اللغات، وهو ادعاء يختلف عن قياس أداء الترجمة الفعلي عبر مجموعة محددة من اللغات. يختبر MachineTranslation.com جودة الترجمة ويقيمها عبر أكثر من 330 لغة مباشرةً، بدلاً من الاعتماد على القدرة اللغوية العامة للنموذج كبديل لمدى كفاءة ترجمته الفعلية.
ما الذي لا ينبغي عليك لصقه في ChatGPT أو Qwen لترجمة الأعمال؟
لم يتم بناء أي من ChatGPT أو Qwen كمنصة ترجمة مخصصة، ولصق محتوى الأعمال الحساس مباشرةً في واجهة دردشة عامة الأغراض يثير تساؤلات التعامل مع البيانات نفسها التي يثيرها لصقه في أي أداة ذكاء اصطناعي استهلاكية أخرى: أين تتم معالجة المدخلات، وما إذا كان يتم الاحتفاظ بها، ومن يمكنه الوصول إليها. العقود، والسجلات الطبية، ووثائق الهجرة، والبيانات المالية هي تحديداً نوع المحتوى الذي يستحق الإجابة عن هذا التساؤل بشأنه قبل الترجمة، وليس بعد ذلك. هذا سبب حقيقي يجعل منصة الترجمة المخصصة ذات الممارسات المنشورة والقابلة للتحقق في التعامل مع البيانات خياراً مختلفاً عن واجهة الدردشة عامة الأغراض، بغض النظر عن النموذج الذي يعمل خلف أي منهما.
كيف يستخدم MachineTranslation.com كلا النموذجين فعلياً
يقوم MachineTranslation.com بتشغيل ChatGPT وQwen وأكثر من 20 نموذج ذكاء اصطناعي آخر لكل ترجمة، ثم يعرض النسخة التي تتفق عليها هذه النماذج أكثر من غيرها. وبالنظر إلى مدى التفاوت الحاد في أداء Qwen وChatGPT بناءً على اتجاه الترجمة، فإن اختيار نموذج واحد كخيار افتراضي دائم يعني التخمين الخاطئ لنسبة يمكن التنبؤ بها من أزواج اللغات. ويظهر النمط نفسه المعتمد على الاتجاه في مقارنة MachineTranslation.com بين Qwen وDeepSeek. وللحصول على الصورة الكاملة لكيفية اختبار النماذج الحالية ضد بعضها البعض، راجع اختبارات مقارنة النماذج الكاملة على MachineTranslation.com.
الأسئلة الشائعة
1. هل Qwen أم ChatGPT أفضل في الترجمة؟
عبر 98 زوجاً لغوياً تم اختبارها على نص أصلي متطابق، حقق ChatGPT درجات أعلى في 77 منها. وكان أفضل أداء لـ Qwen في الترجمة إلى الإنجليزية، حيث تعادل النموذجان تقريباً. وفي كل اتجاه آخر، يتفوق ChatGPT في الغالبية العظمى من الأزواج، لذا فإن الإجابة الصادقة تعتمد بشكل كبير على اتجاه ترجمة المحتوى.
2. هل يدعم ChatGPT أم Qwen لغات أكثر؟
كلاهما نموذجا ذكاء اصطناعي متعددا الأغراض بدون قائمة موثقة ومنشورة للقيود الخاصة بكل لغة. ولا ينشر أي منهما بيانات مؤكدة بشكل مستقل حول تغطية أزواج اللغات، وهو ما يختلف عن المنصة التي تختبر وتقيم جودة الترجمة عبر أكثر من 330 لغة مباشرةً، بدلاً من الاعتماد على ادعاءات عامة حول التدريب متعدد اللغات.
3. هل Qwen أم ChatGPT أفضل للترجمة القانونية وترجمة الأعمال؟
ليس أحدهما أفضل بشكل قاطع في المجمل. فعند اختبار مصطلح في قانون العمل الألماني، قدم DeepSeek وChatGPT صياغة عملية قابلة للاستخدام، بينما استند كل من Claude وQwen إلى مفهوم قانوني غير ذي صلة، مما يوضح أن التباين يرتبط بالمصطلح والسياق، وليس بالنموذج الأقوى عموماً.
4. هل ينافس MachineTranslation.com كلاً من ChatGPT وQwen؟
لا. يقوم MachineTranslation.com بتشغيل ChatGPT وQwen وأكثر من 20 نموذج ذكاء اصطناعي آخر لكل ترجمة، ويعرض النسخة التي تتفق عليها هذه النماذج أكثر من غيرها. فهو يختبر ويجمع بين نماذج مثل هذه بدلاً من العمل كنموذج منفصل ومنافس في حد ذاته.
5. أي نموذج يجب أن أختار لمشروع تعريب ضخم؟
لا يُعد أي منهما بمفرده خيارًا افتراضيًا آمنًا بمجرد أن ينتقل المحتوى عبر العديد من اللغات في كلا الاتجاهين. فالتباين المرتبط باتجاه الترجمة والموثق هنا يعني أن النموذج الذي يقدم أداءً جيدًا عند الترجمة إلى الإنجليزية قد يؤدي بشكل مختلف تمامًا عند الترجمة منها، وذلك عبر العشرات من أزواج اللغات في الوقت نفسه.
6. أي نموذج Qwen هو الأفضل للترجمة؟
هذا ليس متاحًا بعد. يسجل نظام التتبع في MachineTranslation.com حاليًا Qwen كمحرك واحد دون علامة تحديد لإصدار النموذج، بخلاف المزودين الآخرين، لذا لا تتوفر بيانات جودة لكل إصدار فرعي لتقديم تقارير عنها. وبمجرد معالجة ذلك، سيكون إجراء مقارنة تفصيلية فعلية بين Qwen3.8-Max وQwen3.8-27B أمرًا ممكنًا؛ أما في الوقت الحالي، فهذه فجوة حقيقية وليست مجرد تفصيل لم يتم قياسه فحسب.