November 13, 2026
Qwen مقابل Gemini في الترجمة ولماذا يُعد اتجاه الترجمة مهمًا
لديك نموذجان وقائمة من الأزواج اللغوية، وعليك أن تقرر أي نموذج تعتمد عليه في المشروع. تجيب معظم المقارنات بين Qwen وGemini بدرجة إجمالية واحدة. أعتقد أن الدرجة الواحدة تخفي ما يحدد النتيجة، وهو اتجاه الترجمة.
أعمل على كيفية اختبار النماذج التي تعمل على MachineTranslation.com، لذا يمكنني مقارنة Qwen وGemini عبر 98 زوجًا لغويًا تم تقييمها بناءً على نص متطابق. حقق Gemini درجات أعلى في 68 من تلك الأزواج وحقق Qwen درجات أعلى في 29، ويبلغ متوسط الفارق 0.08 نقطة من 10. لا تخبرك النتائج الإجمالية وحدها بالنموذج الذي ينبغي اختياره للترجمة من الأردية إلى الإنجليزية أو من الإنجليزية إلى الكريولية الهايتية.
يوضح هذا المقال أين يتقارب النموذجان وأين يتفوق كل منهما. كما يوضح ما لا يمكنني إخبارك به بعد. تنتهي بياناتي في 8 أغسطس 2026، قبل أن تعلن Google عن Gemini 4 في أكتوبر، لذا فهي تصف الإصدارات السابقة لكلا النموذجين.
أبرز النقاط
- عبر 98 زوجًا لغويًا تم تقييمها بناءً على نص متطابق (من 12 يوليو إلى 8 أغسطس 2026)، حقق Gemini درجات أعلى في 68 زوجًا، وQwen في 29، وتعادل النموذجان في زوج واحد.
- متوسط الفارق ضئيل، 9.06 لـ Gemini مقابل 8.98 لـ Qwen، وتقع 60 من أصل 98 زوجًا ضمن نطاق 0.1 نقطة.
- عند الترجمة إلى الإنجليزية، يتفوق Qwen بأكثر من 0.1 نقطة في 7 من أصل 27 زوجًا ويتفوق Gemini في 3؛ وتقع الـ 17 الأخرى ضمن نطاق 0.1 نقطة.
- عند الترجمة من الإنجليزية، يتفوق Gemini بأكثر من 0.1 نقطة في 13 من أصل 29 زوجًا، بينما لم يتفوق Qwen في أي منها.
- تنتهي البيانات قبل إعلان Google عن Gemini 4 في أكتوبر 2026، لذا فهي تصف إصدارات Gemini السابقة وتتطلب إجراء اختبارات جديدة قبل اعتمادها كبيانات حالية.
هل Qwen أم Gemini أفضل للترجمة؟
يعتمد ذلك على الاتجاه، لأن النموذجين متقاربان عندما تكون الإنجليزية هي اللغة الهدف، بينما يحقق Gemini درجات أعلى في معظم الأزواج الأخرى. عبر جميع الأزواج الـ 98، حقق Gemini درجات أعلى في 68. وفي تقييمات MachineTranslation.com في الفترة من 12 يوليو إلى 8 أغسطس 2026، بلغ متوسط Gemini نحو 9.06 من 10 ومتوسط Qwen نحو 8.98، بمتوسط فارق قدره 0.08 نقطة.
تحتسب لوحة التقييم المقاطع التي حصلت فيها كل من ChatGPT وClaude وDeepSeek وGemini وQwen على درجة فعلية فقط، بحيث يُحكم على كل نموذج بناءً على نص مصدري متطابق. يحتوي كل زوج لغوي على 30 مقطعًا على الأقل. وأنا أستخدم هذه اللوحة لأنها تزيل خطأً شائعًا، وهو مقارنة النماذج على نصوص مختلفة.
من حيث العدد، يتقدم Gemini في 68 زوجًا (69%)، وQwen في 29 (30%)، وهناك تعادل في زوج واحد. إن العدد وحده يضخم الفارق، لأن 60 من أصل 98 زوجًا تقع ضمن نطاق 0.1 نقطة. وتقسم الأقسام التالية النتائج حسب الاتجاه وحسب الهامش.
أي اتجاهات الترجمة تصب في مصلحة كل نموذج؟
يتصدر Gemini عندما تكون الإنجليزية هي لغة المصدر أو عندما لا تكون أي من اللغتين هي الإنجليزية، ويتعادل معه Qwen أو يتقدم عليه عندما تكون الإنجليزية هي اللغة الهدف. عند الترجمة من الإنجليزية، يتقدم Gemini بأكثر من 0.1 نقطة في 13 من أصل 29 زوجًا ولا يتقدم Qwen في أي منها. وعند الترجمة إلى الإنجليزية، يتقدم Qwen بهذا الهامش في 7 من أصل 27 زوجًا بينما يتقدم Gemini في 3.
| الاتجاه | الأزواج | تقدم Gemini بأكثر من 0.1 | في حدود 0.1 نقطة | تقدم Qwen بأكثر من 0.1 | متوسط الفارق |
|---|---|---|---|---|---|
| إلى الإنجليزية | 27 | 3 | 17 | 7 | Qwen +0.04 |
| من الإنجليزية | 29 | 13 | 16 | 0 | Gemini +0.16 |
| كلا الطرفين غير الإنجليزية | 42 | 14 | 27 | 1 | Gemini +0.13 |
في الترجمة إلى الإنجليزية، يقع 17 من أصل 27 زوجاً ضمن نطاق 0.1 نقطة، ويتصدر Qwen في 7، بينما يتصدر Gemini في 3. وفي الترجمة من الإنجليزية، يقع 16 من أصل 29 زوجاً ضمن نطاق 0.1 نقطة، ويتصدر Gemini في 13، في حين لا يتصدر Qwen في أي منها. وعندما لا تكون أي من اللغتين هي الإنجليزية، يقع 27 من أصل 42 ضمن نطاق 0.1 نقطة، ويتصدر Gemini في 14، ويتصدر Qwen في 1.
يقترب Qwen من Gemini بفارق لا يتجاوز 0.1 نقطة أو يتفوق عليه في 24 من أصل 27 زوجاً عند الترجمة إلى الإنجليزية. وبحساب المتوسط حسب الاتجاه، يتقدم Qwen بنحو 0.04 نقطة في الترجمة إلى الإنجليزية، بينما يتقدم Gemini بنحو 0.16 نقطة في الترجمة من الإنجليزية و0.13 نقطة بين لغتين غير إنجليزيتين.
لا أعلم سبب هذا التباين، ولا يمكن لهذه البيانات أن توضح لي ذلك. والتفسير الأول الذي قد أختبره هو مزيج نصوص التدريب المستخدمة في كل نموذج، لكنني لم أجرِ هذا الاختبار بعد. ويُظهر Qwen نمطاً مماثلاً في مواجهة ChatGPT. وفي مجموعة الاختبار نفسها، خلصت مقارنتنا بين Qwen وChatGPT إلى أن النموذجين متقاربان إلى حد التعادل تقريباً في الترجمة إلى الإنجليزية، مع تقدم ChatGPT في 89% من الأزواج اللغوية الأخرى.
ما هي الأزواج اللغوية التي تُظهر أكبر الفوارق؟
تصب أكبر الفوارق في مصلحة Gemini، حيث يتصدر بفارق يتراوح بين 0.51 و0.95 نقطة في الترجمة من الروسية إلى الكازاخية، ومن الإنجليزية إلى الكريولية الهايتية، ومن الإنجليزية إلى التاغالوغية، ومن الإسبانية إلى اليونانية، ومن العربية إلى الفارسية. أما أكبر الفوارق التي يتصدر فيها Qwen فهي أصغر، إذ تتراوح بين 0.15 و0.26 نقطة، وتعتبر أربعة من أفضل خمسة أزواج لديه هي أزواج مترجمة إلى الإنجليزية.
| الزوج اللغوي | درجة Gemini | درجة Qwen | الفارق |
|---|---|---|---|
| من الروسية إلى الكازاخية | 9.27 | 8.32 | Gemini +0.95 |
| من الإنجليزية إلى الكريولية الهايتية | 9.19 | 8.27 | Gemini +0.92 |
| من الإنجليزية إلى التاغالوغية | 9.14 | 8.43 | Gemini +0.70 |
| الإسبانية إلى اليونانية | 8.90 | 8.33 | Gemini +0.57 |
| العربية إلى الفارسية | 8.84 | 8.34 | Gemini +0.51 |
| الأوردية إلى الإنجليزية | 8.56 | 8.81 | Qwen +0.26 |
| الصينية إلى الإنجليزية | 9.00 | 9.19 | Qwen +0.19 |
| من السويدية إلى الإنجليزية | 8.29 | 8.46 | Qwen +0.16 |
| من الصينية إلى الإندونيسية | 9.03 | 9.19 | Qwen +0.16 |
| من البورمية إلى الإنجليزية | 8.94 | 9.09 | Qwen +0.15 |
لن أتعامل مع هذه النتائج كتصنيفات نهائية. فأكبر فجوتين، من الروسية إلى الكازاخية ومن الإنجليزية إلى الكريولية الهايتية، تستندان إلى عينات أصغر من الزوج الوسيط. بينما تستند أزواج الإنجليزية إلى التاغالوغية، والإسبانية إلى اليونانية، والعربية إلى الفارسية إلى عينات أكبر، لذا سأثق في هذه الأزواج الثلاثة بدرجة أكبر. كما أنني سأعيد اختبار الفجوتين ذواتي العينات المحدودة قبل الاعتماد عليهما.
ماذا تعني فجوة قدرها 0.1 نقطة؟
من وجهة نظري، فإن وجود فارق يقل عن 0.1 نقطة يعد ضئيلًا للغاية لتحديد فائز. فمن بين 98 زوجًا، يقع 60 زوجًا ضمن هذا الهامش، ويتم تقييم كل زوج بناءً على عدد محدود من المقاطع. يُعد حد 0.1 هذا عتبة العمل الخاصة بي، ولم أُجرِ اختبار دلالة إحصائية على هذه الأزواج.
كما أن النتيجة الإجمالية تغفل بعض الفروق. ففي اختباراتنا للعبارات الشائعة، قمنا بتمرير كلمة "sorry" إلى العربية عبر 22 نموذج ذكاء اصطناعي. اختار كل من Gemini وQwen كلمة "آسف" غير الرسمية. بينما اختار ChatGPT والنتيجة المجمعة كلمة "عذرًا" الرسمية. حصل كل نموذج على 9.5، لذا تختلف الكلمتان في مستوى الخطاب دون أن تتأثر النتيجة.
ولهذا السبب أقرأ الهامش وأمثلة مستوى الخطاب معًا. فوجود فارق صغير مع اختلاف واضح في مستوى الخطاب يتطلب قرارًا بشريًا. أما الفارق الكبير في عينة محدودة فيتطلب إعادة اختبار.
هل يرتكب Qwen وGemini أنواعًا مختلفة من الأخطاء؟
نعم، ففي اختبار اقتباسات كأس العالم 2026 الذي أجريناه، اتخذ كلا النموذجين خيارًا واحدًا على الأقل لم تتخذه النماذج الأخرى، وبالكاد تغيرت الدرجات. ترجم Gemini عبارة لـ Mbappé إلى "with each game" وترجم اقتباسًا لـ Wirtz حرفيًا، بينما قدم Qwen قراءة مختلفة لاقتباس Scaloni. وتراوحت الدرجات في هذه الحالات بين 9.2 و9.5.
تأتي التفاصيل من اختبار اقتباسات كأس العالم لدينا. ففي اقتباس Mbappé حول التطلع إلى الأمام، احتفظت النماذج الأخرى بكلمة "match" بينما كتب Gemini عبارة "with each game"، وهو هفوة طفيفة في مستوى الخطاب نالت 9.4. وفي اقتباس Wirtz، ترجم Gemini عبارة ترجمة حرفية مما غيّر المعنى، ونال أيضًا 9.4. وفي اقتباس Scaloni، اتفقت معظم النماذج على قراءة واحدة بينما كتب Qwen عبارة "that is what matters" وسجل 9.4. وفي اقتباس Mbappé التكتيكي، اختار Claude وDeepSeek الإنجليزية البريطانية لكرة القدم بينما اختار Gemini وQwen والنماذج الأخرى الإنجليزية الأمريكية، وسجل Qwen درجة 9.2، وهي أقل من البقية.
أرى في هذه الحالات مجرد عادات صغيرة. تتعلق أمثلة Gemini بمستوى الخطاب والصياغة الحرفية. بينما تتعلق أمثلة Qwen باختيار قراءة معينة للنص. إن أربعة أمثلة أقل من أن تشكل نمطًا عامًا، لكنها توضح نوع الفروق التي تخفيها الدرجة الواحدة.
أي نموذج Qwen هو الأفضل للترجمة؟
لا أستطيع تحديد ذلك من واقع بياناتنا، لأن تقييمات MachineTranslation.com تتعامل مع Qwen كنموذج واحد دون وسم للإصدار. فقد وصلت نماذج Alibaba من عائلة Qwen3.8 إلى Hugging Face في أغسطس 2026، لذا توجد الآن عدة إصدارات، والتقييمات في هذا المقال لا تفصل بينها.
أود تقسيم ذلك بحسب الإصدار، لكنني لا أستطيع ذلك بعد. فقد يمثل الرقم على مستوى المنصة متوسطًا لأكثر من إصدار من Qwen تم تشغيله خلال تلك الفترة. وإذا كنت تختار بين إصدارات Qwen من أجل مشروع ما، فإنني أوصي بالمقارنة بينها على عينة من نصوصك الخاصة.
ما هي بعض بدائل Gemini للترجمة؟
تعمل جميع النماذج ChatGPT وClaude وDeepSeek وQwen وGrok وMistral AI على MachineTranslation.com، ويعتمد البديل المناسب على زوج اللغات. ففي تقييماتنا للفترة من 12 يوليو إلى 8 أغسطس 2026، جاء Qwen ضمن نطاق 0.1 نقطة من Gemini أو متقدمًا عليه في 24 من أصل 27 زوجًا إلى الإنجليزية. وتُظهر نتائج Mistral AI بالفرنسية أن متوسطه من الفرنسية إلى الإنجليزية يتفوق بمقدار 0.40 نقطة على Gemini.
إذا كان بديلك هو ChatGPT، فإن الإجابة تنقسم أيضًا بحسب زوج اللغات. ففي تحليلنا المنشور للترجمة من الإسبانية إلى الإنجليزية، فاز Gemini بنسبة 31% من المقاطع وفاز ChatGPT بنسبة 21%. أما في الفرنسية، فلم يفز أي من النموذجين في كلا الاتجاهين. ولأن الاختيار يتغير باختلاف زوج اللغات، فإن MachineTranslation.com لا يختار بديلًا واحدًا، بل يقوم بتشغيلها معًا.
اقتراحي هو البدء بالزوج اللغوي والاتجاه، ثم النظر في البديل المناسب.
كيف يوضح MachineTranslation.com مواضع الاختلاف بين Qwen وGemini؟
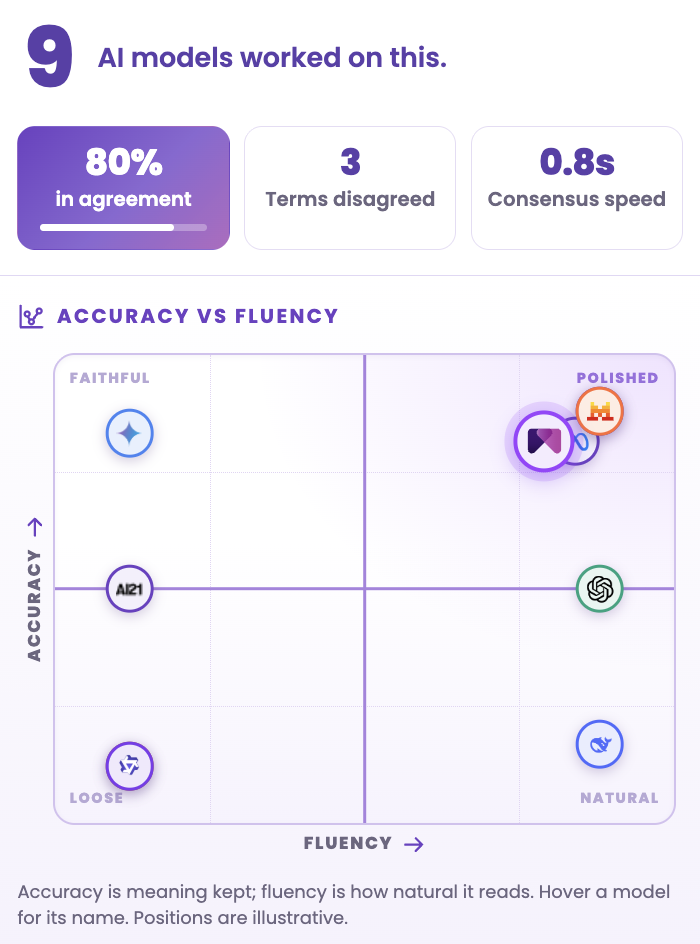
يقوم MachineTranslation.com بتشغيل كلا النموذجين في كل ترجمة ويوضح أين يتفق النموذجان وأين يختلفان. وتُظهر لوحة التوافق عدد نماذج الذكاء الاصطناعي التي عملت على النص، ونسبة التوافق، وعدد المصطلحات المتنازع عليها، ومدى سرعة التوصل إلى إجماع.
ما مدى حداثة هذه النتائج؟
تغطي هذه النتائج الفترة من July 12 to August 8, 2026، لذا فهي تصف إصدارات Gemini وQwen التي كانت تعمل في ذلك الوقت. أعلنت Google عن Gemini 4 في October 2026. ووصلت عائلة Qwen3.8 من Alibaba في August 2026. وتوصيتي هي إعادة تشغيل اللوحة قبل الاعتماد على هذه الأرقام في مشروع جديد.
أتوقع أن تظل طريقة مقارنة النصوص المتطابقة مع وجود هامش للتشويش صالحة. وأتوقع أن يتغير حجم الفجوات. وسأعتبر أي زوج يتغير فيه النموذج المتصدر في اختبار جديد علامة على أن الفجوة السابقة كانت ضمن نطاق التشويش.
كيف أختار بين Qwen وGemini لمشروع ما؟
رأيي هو الاختيار بحسب الزوج والاتجاه وتجنب الاختيار لمرة واحدة للمشروع بأكمله. عمليًا، يعني ذلك اعتبار الفجوة التي تقل عن 0.1 نقطة بمثابة تعادل وتوقع تغير النموذج المتصدر بين الأزواج اللغوية. وهذا هو الترتيب الذي سأتبعه.
- ضع قائمة بكل زوج لغوي في المشروع وحدد اتجاهه.
- تحقق من الفارق لكل زوج لغوي في هذه المقالة. اعتبر أي فارق يقل عن 0.1 نقطة بمثابة تعادل.
- عندما يكون الفارق أكبر، ابدأ بالنموذج المتصدر واختبر عينة من نصوصك الخاصة.
- إذا كان المحتوى الخاص بك يسير في كلا الاتجاهين، فتوقع أن يتغير النموذج المتصدر بين الأزواج اللغوية.
- تحقق مرة أخرى عندما يُصدر أي من النموذجين إصدارًا جديدًا.
يعمل كلا النموذجين إلى جانب 20 نموذجًا آخر في كل عملية ترجمة على MachineTranslation.com. وتُعرض النتيجة التي يتفق عليها معظمها، لذا لا يلزم اتخاذ القرار مرة واحدة لكامل المشروع. تتوفر المجموعة الكاملة لنتائج النماذج في اختبار مقارنة النماذج لدينا.
الأسئلة الشائعة
1. هل Qwen أم Gemini أفضل في الترجمة؟
يعتمد ذلك على الاتجاه، لأن Qwen يقع ضمن فارق لا يتعدى 0.1 نقطة عن Gemini أو يتفوق عليه في 24 من أصل 27 زوجًا لغويًا إلى الإنجليزية. ومع ذلك، حقق Gemini نتائج أعلى في 68 من أصل 98 زوجًا لغويًا في نتائج MachineTranslation.com للفترة من 12 يوليو إلى 8 أغسطس 2026. ويبلغ متوسط الفارق 0.08 نقطة من أصل 10، لذا أنصح بالاختيار حسب كل زوج لغوي.
2. ما هو أفضل نموذج Qwen للترجمة؟
لا يمكنني الجزم من واقع بياناتنا، لأن نتائج MachineTranslation.com تتعامل مع Qwen كنموذج واحد دون تحديد وسم الإصدار. وصلت عائلة Qwen3.8 من Alibaba إلى Hugging Face في أغسطس 2026، لذا توجد إصدارات متعددة الآن. وإلى أن تفصل النتائج بينها، أنصح بمقارنة الإصدارات على عينة من نصوصك الخاصة قبل اختيار أحدها للمشروع.
3. ما هي بعض البدائل لـ Gemini في الترجمة؟
تعمل كل من ChatGPT وClaude وDeepSeek وQwen وGrok وMistral AI على MachineTranslation.com. وفي نتائجنا للفترة من 12 يوليو إلى 8 أغسطس 2026، جاء Qwen ضمن فارق لا يتعدى 0.1 نقطة عن Gemini أو تفوق عليه في 24 من أصل 27 زوجًا لغويًا إلى الإنجليزية. كما تقدم متوسط Mistral AI في الترجمة من الفرنسية إلى الإنجليزية بمقدار 0.40 نقطة عن Gemini. ويعتمد البديل المناسب على الزوج اللغوي.
4. هل Gemini أفضل من ChatGPT في الترجمة؟
يعتمد ذلك على الزوج اللغوي، حيث لا يتفوق نموذج ذكاء اصطناعي واحد في جميع الحالات. وفي تحليلنا المنشور للترجمة من الإسبانية إلى الإنجليزية، فاز Gemini في 31% من الأجزاء بينما فاز ChatGPT في 21%. أما في اللغة الفرنسية، فلا يتفوق أي من النموذجين في كلا الاتجاهين. أنصح بالتحقق من الزوج والاتجاه المطلوبين قبل الاختيار بينهما.
5. هل Gemini دقيق في الترجمة؟
نعم، لأن Gemini حقق متوسط 9.06 من 10 عبر 98 زوجًا لغويًا في نتائج MachineTranslation.com للفترة من 12 يوليو إلى 8 أغسطس 2026. ومع ذلك، لا تزال الدقة تختلف باختلاف الزوج اللغوي. ويكون تفوقه هو الأكبر عند الترجمة من الإنجليزية، في حين يتقدم عليه Qwen بأكثر من 0.1 نقطة في 7 من 27 زوجًا إلى الإنجليزية.