October 2, 2026
Qwen مقابل Grok: أي نموذج ذكاء اصطناعي يترجم بشكل أفضل؟
يُعد كل من Qwen و Grok نموذجي ذكاء اصطناعي للأغراض العامة، وليسا أداتين مخصصتين للترجمة، وكلاهما جزء من مجموعة النماذج التي يعتمد عليها موقع MachineTranslation.com في كل عملية ترجمة. وهذا الأمر مهم لكيفية قراءة ما سيأتي. فهذه نظرة على أداء اثنين من نماذج المنصة في مواجهة بعضهما البعض، مع مراعاة التحفظات الحقيقية التي تصاحب هذا النوع من البيانات، وليس منافسة بين متحديين خارجيين والمنصة ذاتها.
ما هما Qwen و Grok؟
Qwen هي عائلة النماذج اللغوية الكبيرة التابعة لشركة Alibaba، وتعمل حالياً بإصدار الجيل Qwen3.8، وقد أُضيفت إلى مجموعة نماذج MachineTranslation.com كجزء من التوسع المستمر للمنصة. Grok هي سلسلة نماذج شركة xAI، والتي وصلت حالياً إلى إصدار Grok 4.7 وقت كتابة هذا التقرير، بعد أن مرت بعدة إصدارات منذ النسخة التي قارنها هذا المقال في الأصل، وانضمت إلى المنصة بشكل منفصل. لم يُصمم أي من النموذجين خصيصاً للترجمة؛ فكلاهما أنظمة للأغراض العامة تصادف أنها تتعامل مع العديد من اللغات كجزء من قدرات لغوية أوسع، وهو ما يمثل نقطة انطلاق مختلفة عن منصة بُنيت واختُبرت خصيصاً لضمان جودة الترجمة.
كيف يُقارن أداء Qwen و Grok استناداً إلى بيانات منصة MachineTranslation.com الخاصة؟
خلال الأيام الـ 28 الماضية من حركة المرور على المنصة، سجل نموذج Grok متوسط درجات أعلى من Qwen: 9.26 من 10 مقابل 8.87. وحافظت أسوأ 10% من ترجمات Grok على متوسط درجات بلغ 9.2، بينما انخفضت أسوأ 10% من ترجمات Qwen إلى 7.6، مما يمثل فجوة أوسع في الحد الأدنى مقارنة بما يشير إليه المتوسط وحده.
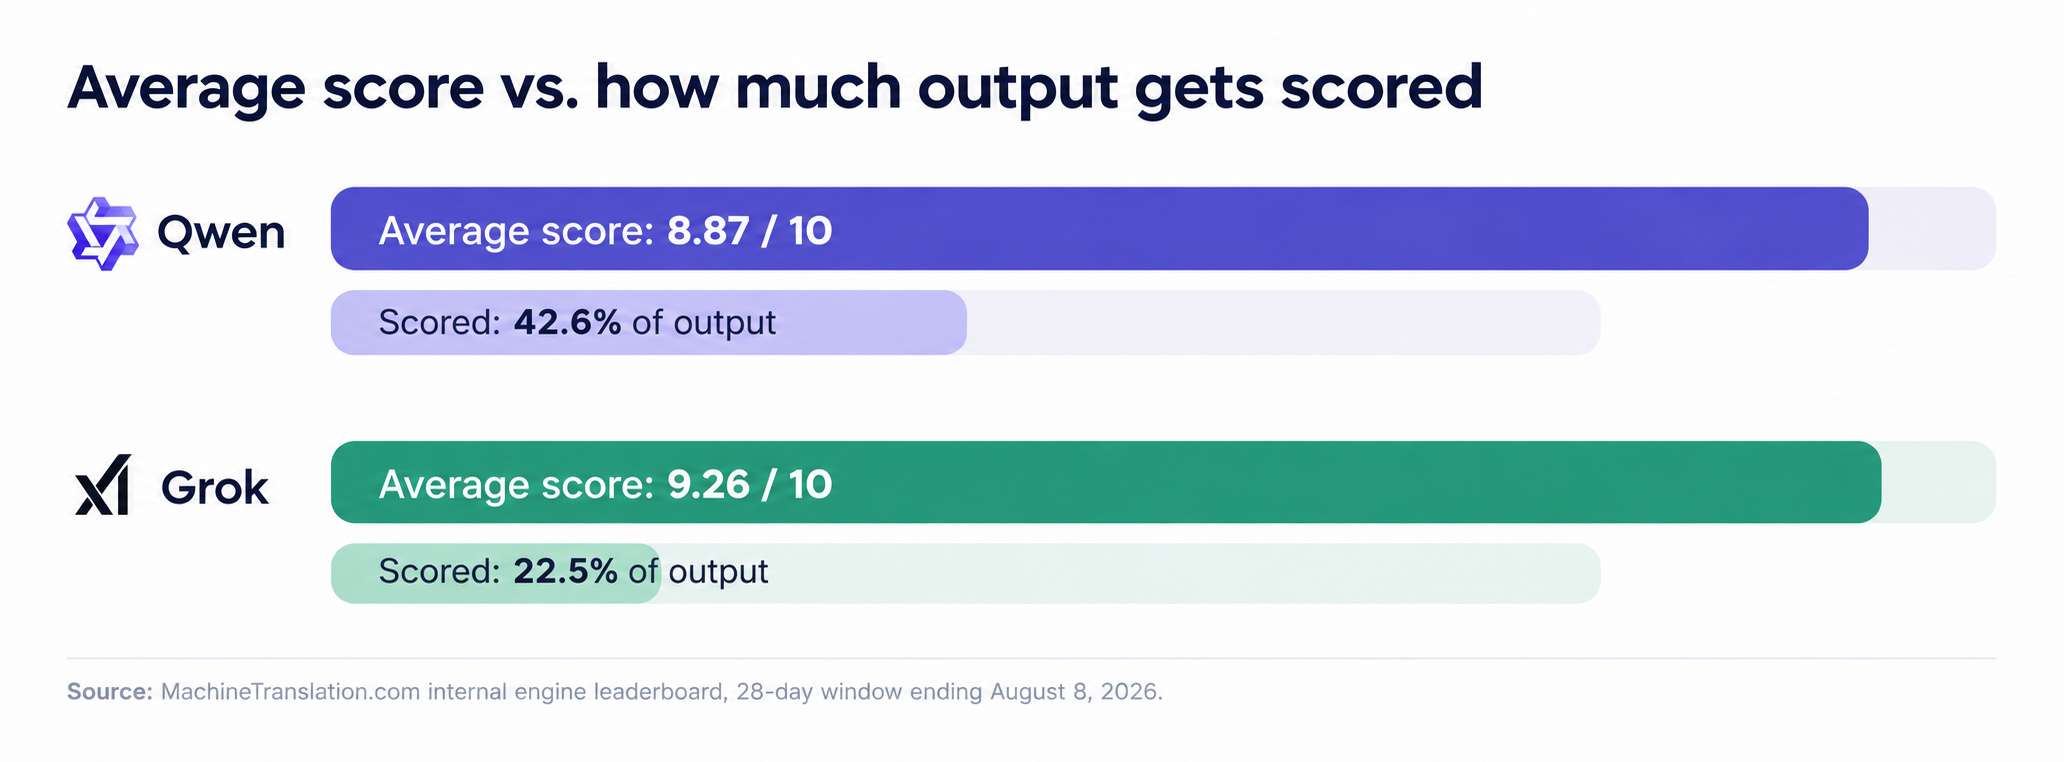
متوسط درجات Grok أعلى، لكنه يستند إلى تقييم أقل من ربع مخرجاته، مقابل ما يقرب من النصف لنموذج Qwen. لذا، يروي العمودان البيانيان أجزاءً مختلفة من نفس القصة.
| Qwen | Grok | |
|---|---|---|
| النسبة المئوية للمخرجات التي تم تقييمها | 42.6% | 22.5% |
| متوسط الدرجات | 8.87 / 10 | 9.26 / 10 |
| أدنى 10% من التقييمات | 7.6 | 9.2 |
المصدر: لوحة الصدارة الداخلية للمحركات الخاصة بـ MachineTranslation.com، فترة 28 يوماً تنتهي في 8 أغسطس 2026.
هل يعني حصول Grok على درجة أعلى أنه الخيار الأفضل؟
ليس بحد ذاته. يُستخدم Grok على المنصة بمعدل أقل بكثير من Qwen، وتحصل أقل من ربع ترجماته على درجات تقييم، مقابل ما يقرب من النصف لـ Qwen. يمكن لعينة أصغر وأقل تمثيلاً أن تجعل المتوسط يبدو أفضل أو أسوأ مما سيكون عليه عبر نفس الحجم الذي يشهده Qwen. تتعامل تقارير MachineTranslation.com الخاصة بهذه البيانات مع تغطية التقييم كقيد حقيقي، وليس كمجرد ملاحظة هامشية: المحرك الذي يتم تقييمه على شريحة ضيقة من حركة المرور الخاصة به لم يتم اختباره بدقة مثل المحرك الذي يتم تقييمه عبر ما يقرب من نصف مخرجاته.
القراءة الصادقة هي أن أرقام Grok واعدة ولكنها تستند إلى بيانات أقل. أرقام Qwen أقل في المتوسط ولكنها تستند إلى قاعدة أكبر بكثير وأكثر تمثيلاً. ولا تلغي أي من الحقيقتين الأخرى.
ماذا عن تغطية اللغات؟
لا ينشر Qwen ولا Grok قائمة معتمدة بأزواج اللغات التي ينخفض فيها الأداء، ولا يوجد اختبار مستقل لتأكيد ذلك. ما يمكن قوله بثقة هو أنه لم يتم بناء أي من النموذجين حول جودة الترجمة عبر مجموعة لغات محددة بالطريقة التي صُممت بها منصة الترجمة المخصصة. تختبر وتدعم MachineTranslation.com أكثر من 270 لغة بشكل مباشر، وهو ادعاء من نوع مختلف عن القدرة اللغوية المتعددة الواسعة ولكن غير المختبرة لنموذج الأغراض العامة.
كيف تستخدم MachineTranslation.com فعلياً Qwen و Grok
تُشغّل MachineTranslation.com نماذج Qwen و Grok وأكثر من 20 نموذج ذكاء اصطناعي آخر على كل ترجمة، ثم تُظهر النسخة التي تتفق عليها هذه النماذج بشكل أكبر. لا يتم استبعاد أي نموذج بسبب حصوله على درجات تقييم أقل في المتوسط. إن تشغيل العديد من النماذج في وقت واحد يعني التقاط الحالات التي ينجح فيها نموذج ذو تقييم أقل في المتوسط في ترجمة جملة معينة بشكل صحيح في حين يخطئ فيها نموذج ذو تقييم أعلى. ينقسم أداء Qwen أيضاً حسب الاتجاه وزوج اللغات بطرق تستحق المعرفة قبل اختيار نموذج واحد، وهو ما تمت تغطيته بعمق أكبر في مقارنة Qwen ضد DeepSeek الخاصة بـ MachineTranslation.com. للحصول على نظرة أقرب على كيفية اختبار النماذج مقابل بعضها البعض بشكل مباشر، راجع اختبار مقارنة النماذج الكامل لـ MachineTranslation.com.
الأسئلة الشائعة
1. هل Qwen أم Grok أفضل للترجمة؟
بناءً على بيانات محرك MachineTranslation.com الخاصة لفترة 28 يومًا، يسجل Grok في المتوسط نقاطًا أعلى من Qwen، بواقع 9.26 مقابل 8.87 من 10. ولكن تم تقييم Grok على شريحة أصغر بكثير وأقل تمثيلاً من مخرجاته، لذا لا تعد هذه مقارنة مباشرة دقيقة بالطريقة التي يكون عليها اختبار الأجزاء المتطابقة.
2. لماذا يمتلك Grok متوسط درجات أعلى ولكن عددًا أقل من الترجمات المقيّمة؟
يُستخدم Grok بشكل أقل على المنصة ويتم تقييم حوالي 22.5% فقط من مخرجاته، مقابل 42.6% لنموذج Qwen. يمكن لعينة أصغر وأقل تمثيلاً أن تضخم أو تقلل من المتوسط، ولهذا السبب يجب قراءة هذه المقارنة على أنها توجيهية وليست قاطعة.
3. هل يدعم Qwen أو Grok لغات أكثر؟
كلاهما من نماذج AI متعددة الأغراض ولا يمتلكان قائمة منشورة وموثقة للقيود الخاصة باللغات. لم يُبنَ أي منهما خصيصًا للترجمة، وهو ما يختلف عن منصة تختبر وتقيم جودة الترجمة عبر أكثر من 270 لغة بشكل مباشر، بدلاً من الاعتماد على تدريب واسع متعدد اللغات كبديل للأداء المُقاس في الترجمة.
4. هل تتنافس MachineTranslation.com مع Qwen و Grok؟
لا. تقوم MachineTranslation.com بتشغيل Qwen و Grok وأكثر من 20 نموذج AI آخر على كل ترجمة وتُبرز النسخة التي تتفق عليها هذه النماذج بشكل أكبر. فهي تختبر وتدمج مثل هذه النماذج بدلاً من التنافس معها كنموذج مستقل خاص بها.
5. ما هو نموذج AI الذي توصي به MachineTranslation.com للترجمة؟
لا يوجد نموذج محدد بشكل افتراضي. يختلف أداء النماذج المختلفة باختلاف زوج اللغات ونوع المحتوى، ويمكن أن تميل الفجوة بينها في أي من الاتجاهين بناءً على ما تتم ترجمته. هذا التباين هو بالضبط السبب الذي يجعل المنصة تُشغّل نماذج متعددة على كل ترجمة بدلاً من اختيار نموذج واحد كتوصية ثابتة.