April 16, 2026
Grok супраць ChatGPT для перакладу: які з іх варта выкарыстоўваць у 2026 годзе?
У вас, напэўна, ужо адкрыта ўкладка з адным з іх. Пытанне ў тым, ці дастаткова дакладны атрыманы вынік для выкарыстання (для дакумента кліента, старонкі прадукту, пункта дагавора) без таго, каб марнаваць наступныя 20 хвілін на сумневы наконт кожнага сказа.
У гэтым артыкуле параўноўваюцца Grok 4.1 і ChatGPT (GPT-5.4) менавіта для выкарыстання ў перакладзе: што кожны з іх робіць добра, у чым кожны церпіць няўдачу і што вам спатрэбіцца, калі ніводнага з іх недастаткова.
Што такое Grok і як ён развіваўся?
Grok — гэта вялікая моўная мадэль, распрацаваная xAI, кампаніяй у галіне штучнага інтэлекту, заснаванай Іланам Маскам у 2023 годзе (цяпер яна з'яўляецца часткай SpaceX пасля набыцця ў лютым 2026 года). З моманту свайго запуску Grok прайшоў праз чатыры асноўныя пакаленні: Grok 1 (2023), Grok 2 (2024), Grok 3 (люты 2025) і Grok 4 (ліпень 2025), прычым Grok 4.1 будзе даступны з канца 2025 года.
Вызначальнай архітэктурнай асаблівасцю Grok з'яўляецца доступ да даных у рэальным часе. У адрозненне ад большасці вялікіх моўных мадэлей, навучаных на статычных наборах даных, Grok інтэгруе пошук у інтэрнэце ў рэальным часе і даныя платформы X (раней Twitter) у свае вынікі. Гэта робіць яго асабліва эфектыўным для працы з кантэнтам, які тычыцца бягучых падзей, новай тэрміналогіі, нядаўна створанай галіновай лексікі або адчувальных да часу зыходных матэрыялаў — катэгорый, дзе мадэлі, навучаныя на больш старых здымках даных, могуць выкарыстоўваць састарэлыя фармулёўкі або выпускаць з-пад увагі сучасны кантэкст.
Што тычыцца менавіта перакладу, доступ Grok у рэальным часе з'яўляецца рэальнай перавагай у вузкім, але важным спектры сцэнарыяў выкарыстання: пры перакладзе навінавага кантэнту, прэс-рэлізаў, абнаўленняў нарматыўных актаў і матэрыялаў, якія спасылаюцца на бягучыя падзеі або новыя тэрміны. Яго шматмоўная падтрымка паляпшалася з кожным наступным пакаленнем мадэлі. Grok 4.1 мае кантэкстнае акно памерам 131K токенаў, палепшаны шматмоўны вывад і натыўнае выкарыстанне інструментаў з інтэграцыяй пошуку ў рэальным часе.
У чым Grok усё яшчэ саступае спецыялізаванай інфраструктуры перакладу: гэта мадэль агульнага прызначэння, а не спецыялізаваная для перакладу. Яно выдае адзіны вынік без унутранага механізму праверкі. Якасць выніку вар'іруецца ў залежнасці ад моўнай пары і тыпу кантэнту, і няма міжмадэльнай праверкі, каб выявіць няправільны вынік.
Што такое ChatGPT і што змяняе GPT-5.4?
ChatGPT — гэта размоўны штучны інтэлект, распрацаваны OpenAI, пабудаваны на яго архітэктуры GPT (Generative Pre-trained Transformer). Ён быў запушчаны ў лістападзе 2022 года і стаў самым хуткарослым спажывецкім дадаткам у гісторыі. Бягучая мадэль па стане на красавік 2026 года — гэта GPT-5.4, выпушчаная 5 сакавіка 2026 года.
Для задач перакладу ChatGPT уваходзіць у лік наймацнейшых даступных LLM агульнага прызначэння. Ва ўнутраным бэнчмарку MachineTranslation.com, які ахопліваў 5000 слоў змешанага тэхнічнага і маркетынгавага кантэнту, ChatGPT паказаў дакладнасць 89,8% — прадэманстраваўшы добрую якасць на павярхоўным узроўні, але згенераваўшы галюцынацыйны кантэнт у двух ключавых сказах падчас гэтага тэсту. Паводле незалежных навуковых тэстаў, GPT-5.4 набірае 92,0% у тэсце GPQA Diamond (навуковае мысленне на ўзроўні PhD), што сведчыць пра высокую эфектыўнасць працы са складаным, заснаваным на фактах кантэнтам, дзе дакладнасць мае вырашальнае значэнне.
ChatGPT падтрымлівае шырокі спектр моў і добра спраўляецца са складанымі структурамі сказаў, ідыяматычнымі выразамі і прафесійным стылем у еўрапейскіх і асноўных азіяцкіх моўных парах. Яго слабыя бакі ў перакладзе маюць хутчэй структурны характар, чым звязаны з якасцю: як і любая аднамадэльная сістэма штучнага інтэлекту, яна не можа праверыць уласны вынік. Калі яно галюцынуе (ствараючы пераклад, які гучыць плаўна, але з'яўляецца фактычна або семантычна памылковым), няма сігналу, каб папярэдзіць карыстальніка.
Як Grok і ChatGPT суадносяцца па дакладнасці перакладу?
Абодва інструменты ствараюць высакаякасныя пераклады для агульнага кантэнту. Істотныя адрозненні выяўляюцца на межах — калі кантэнт з'яўляецца спецыялізаваным, тэхнічным, адчувальным да часу або звязаным з высокімі стаўкамі.
Дзе Grok мае перавагу: Кантэнт, звязаны з бягучымі падзеямі, тэрміналогія, якая фарміруецца, і матэрыялы, якія патрабуюць актуальнага кантэксту. Інтэграцыя пошуку ў рэальным часе Grok азначае, што ён можа абапірацца на актуальныя шаблоны выкарыстання пры перакладзе навінавых артыкулаў, запускаў прадуктаў або рэгулятарных абнаўленняў — кантэнту, у якім мадэль, навучаная на даных шасцімесячнай даўніны, можа выдаваць састарэлыя фармулёўкі.
У чым ChatGPT мае перавагу: Структураваны, насычаны фактамі кантэнт — навуковы, юрыдычны і тэхнічны тэкст, дзе дакладнасць усталяванай тэрміналогіі мае большае значэнне, чым актуальнасць. Паказчык бенчмарку GPQA GPT-5.4 у 92,0% і на 33% ніжэйшая частата ілжывых сцвярджэнняў у параўнанні з папярэднімі мадэлямі робяць яго больш удалым выбарам для высокадакладнага прафесійнага перакладу складанага зыходнага матэрыялу.
Чаго не можа зрабіць ніводзін з інструментаў: Праверыць уласны вывад. Асобныя вядучыя ВММ (уключаючы як Grok, так і ChatGPT) галюцынуюць або выдумляюць кантэнт ад 10% да 18% часу пры выкананні перакладчыцкіх задач, паводле даных, сінтэзаваных на аснове справаздач Intento «State of Translation Automation 2025» і «WMT24 General Machine Translation Findings». Для прафесійнага, арыентаванага на кліентаў або рэгуляванага кантэнту гэты дыяпазон не з'яўляецца дапушчальнай хібнасцю.
| Grok 4.1 | ChatGPT (GPT-5.4) | |
|---|---|---|
| Найлепш для | адчувальнага да часу кантэнту і кантэнту пра бягучыя падзеі | структураванага, тэхнічнага і насычанага фактамі кантэнту |
| Доступ да даных у рэальным часе | Так — інтэграцыя з X у рэальным часе і вэбам | Не — статычныя навучальныя даныя |
| Бенчмарк дакладнасці | AIME 2025: 91.7% (матэматычныя развагі) | GPQA Diamond: 92.0% (навуковыя развагі) |
| Бенчмарк перакладу | ---- | 89.8% на 5 000 словах змешанага кантэнту (з 2 галюцынаванымі сказамі) |
| Верыфікацыя вываду | Адзіная мадэль, без сігналу верыфікацыі | Адзіная мадэль, без сігналу верыфікацыі |
| Узровень галюцынацый (адзіная мадэль) | 10–18% (Intento/WMT24) | 10–18% (Intento/WMT24) |
Як адрозніваецца падтрымка моў у Grok і ChatGPT?
ChatGPT падтрымлівае шырокі набор моў з усіх асноўных моўных сямействаў. Яна паказвае найлепшыя вынікі на парах еўрапейскіх моў і асноўных азіяцкіх мовах (кітайскай, японскай, карэйскай), з некалькі менш стабільнай якасцю на маларэсурсных мовах.
Grok паступова пашыраў сваю шматмоўную падтрымку ў розных пакаленнях мадэлей. Grok 4.1 істотна паляпшае вынікі для неанглійскага вываду ў параўнанні з папярэднімі версіямі, хоць ён і застаецца арыентаваным на высокарэсурсныя моўныя пары, дзе навучальных даных дастаткова.
MachineTranslation.com падтрымлівае больш за 330 моў, адначасова аб'ядноўваючы 22 мадэлі ШІ (уключаючы як Grok, так і ChatGPT) і выбіраючы той варыянт, з якім згодна большасць. Для каманд, якія працуюць на некалькіх рынках або з менш распаўсюджанымі моўнымі парамі, гэты падыход пазбаўляе ад неабходнасці ацэньваць кожны інструмент для кожнай мовы незалежна.
Для атрымання рэкамендацый па канкрэтных моўных парах: З англійскай на іспанскую, з англійскай на французскую, з англійскай на нямецкую.
Як супастаўляюцца цэны паміж Grok і ChatGPT?
Grok (xAI):
- Бясплатны тарыф: Даступна праз X з абмежаваным доступам да Grok
- X Premium+: $22/месяц — уключае доступ да чат-бота Grok
- SuperGrok: $30/месяц — пашыраныя магчымасці
- API (Grok 4.1): $0.20 per 1 million input tokens / $0,50 за 1 мільён выходных токенаў — адны з самых нізкіх тарыфаў API на рынку LLM
ChatGPT (OpenAI):
- Бясплатны тарыф: Даступна з абмежаванымі магчымасцямі
- ChatGPT Plus: $20/месяц
- ChatGPT Pro: $200/месяц
- API (GPT-5.4): $1.75 per 1 million input tokens / $14.00 за 1 мільён выходных токенаў
MachineTranslation.com:
- Бясплатна: Штодзённы ліміт без неабходнасці рэгістрацыі; пераклады скідаюцца кожныя 24 гадзіны
- План Pro: $39/месяц — неабмежаваныя пераклады, апрацоўка дакументаў, захаванне арыгінальнага макета
- Поўны доступ на 24 гадзіны: $9.50 (аднаразова, без аўтападаўжэння)
Цэны на API Grok прыкметна ніжэйшыя, чым у ChatGPT, што робіць яго эканамічна прывабным для выкарыстання API ў вялікіх аб'ёмах. Аднак, менавіта для перакладу, кошт за токен — гэта толькі адно вымярэнне — якасць выніку, праверка і выдаткі на выпраўленне памылак маюць аднолькавае значэнне ў прафесійным кантэксце.
У каго лепшы API для працоўных працэсаў перакладу?
API Grok стаў цалкам даступным з пераходам xAI на тарыфікацыю на аснове выкарыстання ў кастрычніку 2025 года. Цэны — адны з самых нізкіх на рынку і складаюць 0,20 $ за 1 млн уваходных токенаў (Grok 4.1). Дакументацыя значна пашырылася з часоў бэта-версіі Grok 3. Для распрацоўшчыкаў, якія ствараюць канвееры, што патрабуюць інтэграцыі даных у рэальным часе, API Grok — гэта моцны варыянт.
API ChatGPT (OpenAI) — гэта найбольш сталае і шырока задакументаванае API LLM сярод даступных. Яно падтрымлівае выклік функцый, структураваны вывад, карыстальніцкія GPT і шырокую экасістэму інтэграцыі. Пры кошце $1,75 за 1 млн уваходных токенаў для GPT-5.4, гэта значна даражэй, чым Grok, але яна мае больш глыбокую наладу і рэпутацыю стабільнасці, якія звычайна патрабуюцца для карпаратыўных працоўных працэсаў.
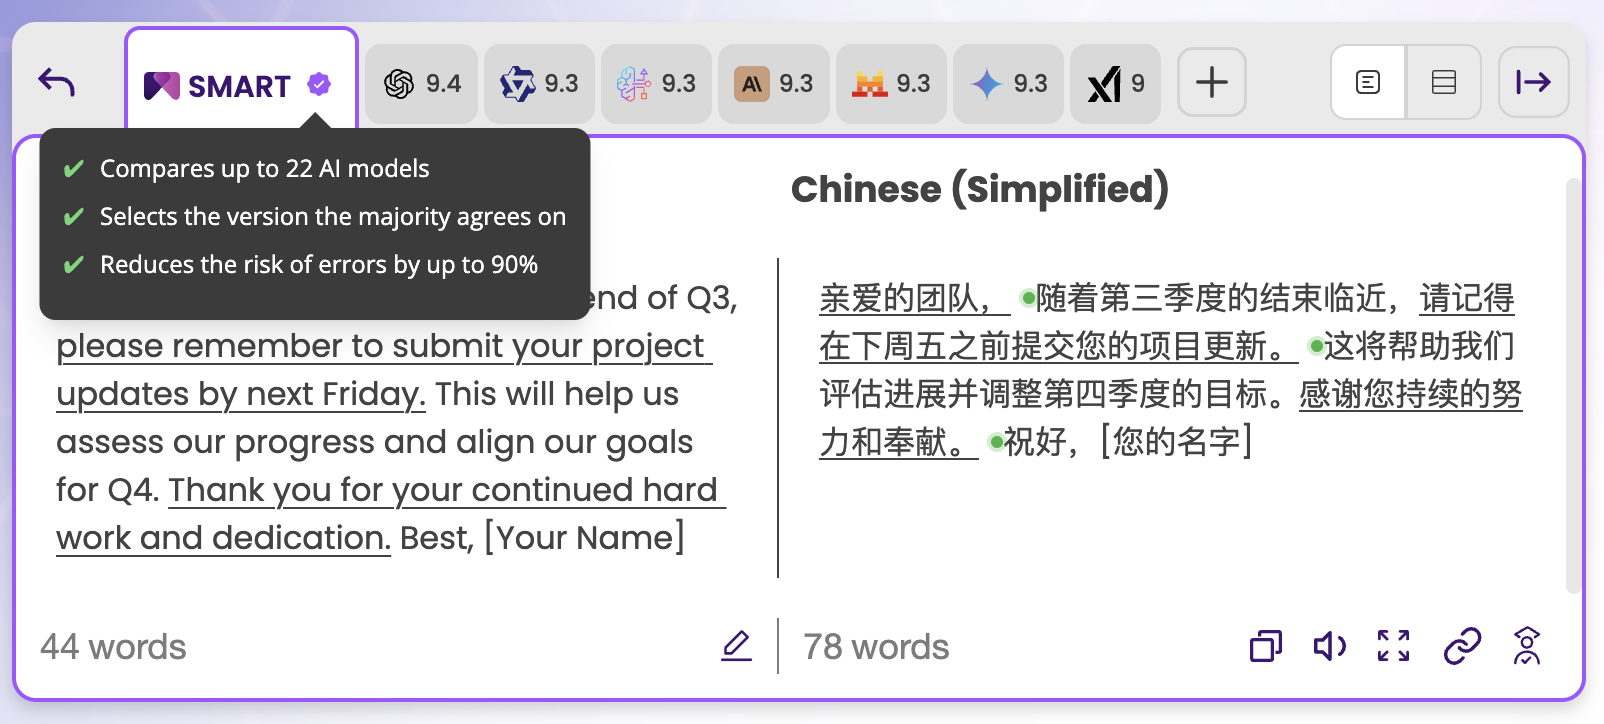
API MachineTranslation.com накіроўвае запыты праз усе 22 мадэлі адначасова (уключаючы як Grok, так і ChatGPT) і вяртае кансенсусны вынік SMART. Для распрацоўшчыкаў, якім патрабуецца правераная якасць перакладу ў вялікіх маштабах, адзін выклік API пазбаўляе ад неабходнасці самастойна кіраваць, ацэньваць і параўноўваць інтэграцыі некалькіх рухавікоў.
Для агляду варыянтаў і тарыфаў на API перакладу: Параўнанне API для перакладу.
Які інструмент лепш падыходзіць для якога тыпу перакладу?
Выкарыстоўвайце Grok 4.1 для:
- Кантэнту пра бягучыя падзеі, навінавых артыкулаў і прэс-рэлізаў, дзе важны актуальны кантэкст
- Перакладу матэрыялаў з новай тэрміналогіяй або нядаўна ўзніклай галіновай лексікай
- Вялікіх аб'ёмаў менш адказных перакладаў, дзе кошт за токен з'яўляецца галоўным прыярытэтам
- Кантэнту са спасылкамі на нядаўнія культурныя падзеі або моўныя мадэлі сацыяльных сетак
Выкарыстоўвайце ChatGPT (GPT-5.4) для:
- Тэхнічнага, навуковага і прафесійнага кантэнту, дзе важная структураваная дакладнасць
- Юрыдычных, фінансавых або медыцынскіх тэкстаў з усталяванай тэрміналогіяй
- Доўгіх дакументаў, дзе важная лагічная паслядоўнасць ва ўсім тэксце
- Любога кантэксту, дзе ўжо выкарыстоўваюцца шырокія інтэграцыі экасістэмы GPT (Word, Notion, Zapier і г. д.)
У абодвух выпадках: Ніводзін з інструментаў не правярае ўласныя вынікі, і ніводзін не дае сігналу ўпэўненасці перад тым, як вы адправіце пераклад.
Што вы робіце, калі дакладнасць павінна быць гарантаванай?
І Grok, і ChatGPT ствараюць карысныя пераклады. Яны церпяць няўдачу такім жа структурным чынам: адна мадэль не можа выявіць памылкі, якія яна стварае. Калі Grok няправільна перадае юрыдычны тэрмін або ChatGPT згалюцынаваў два сказы пасярод тэхнічнага дакумента (як гэта адбылося ва ўнутраным бенчмарку MachineTranslation.com на 5000 слоў), у атрыманым выніку няма нічога, што магло б падказаць вам, дзе гэта адбылося.
Менавіта гэтую праблему па сваёй канструкцыі вырашае механізм SMART ад MachineTranslation.com. SMART прапускае кожны пераклад адначасова праз 22 мадэлі штучнага інтэлекту (уключаючы Grok і ChatGPT сярод іх), а затым прымяняе кансэнсусны аўдыт: выбіраецца пераклад, з якім згаджаецца большасць мадэлей. Паколькі галюцынацыі перакладу ўласцівыя канкрэтным мадэлям, міжмадэльнае ўзгадненне структурна адфільтроўвае іх.
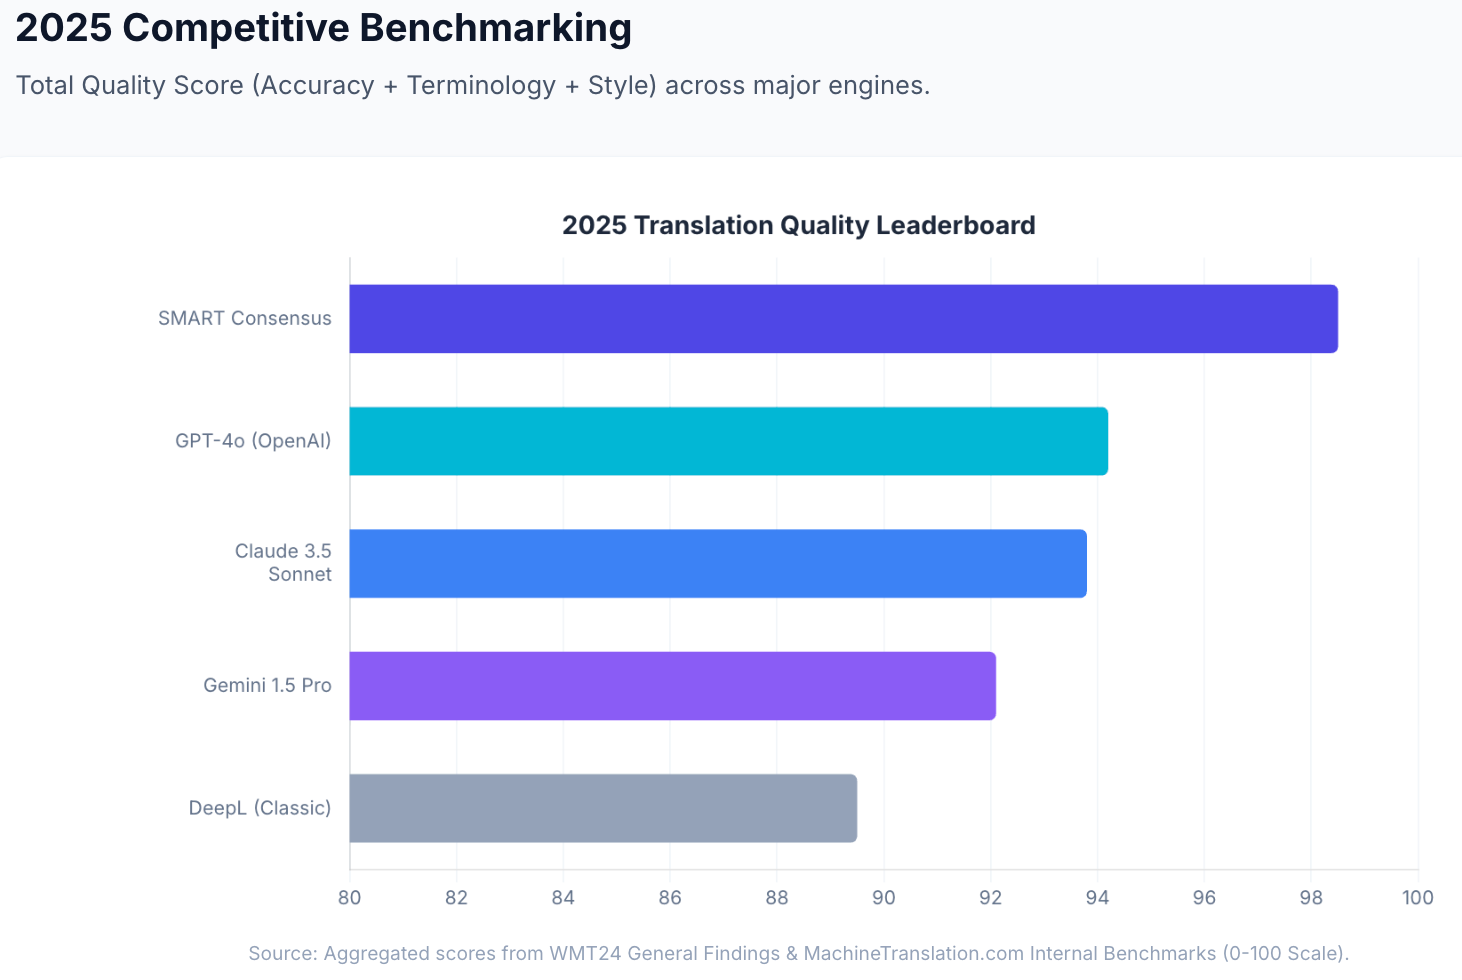
Унутраныя тэсты паказваюць, што кансэнсусны падыход SMART дасягае сукупнай ацэнкі якасці 98,5 са 100 (у параўнанні з 94,2 у GPT-4o у тым жа наборы тэстаў) і зніжае рызыку крытычных памылак перакладу на 90%. Пераклады, апрацаваныя праз SMART, зніжаюць колькасць крытычных памылак да менш чым 2% у параўнанні з 10–18% узроўнем галюцынацый у аднамадэльных LLM, уключаючы Grok і ChatGPT. (Крыніца: Унутраныя справаздачы MachineTranslation.com; Справаздача Intento «Стан аўтаматызацыі перакладу 2025»; Высновы WMT24 па агульным машынным перакладзе.)
Для перакладаў, якія патрабуюць абсалютнай упэўненасці (юрыдычныя дакументы, клінічная дакументацыя, рэгулятарныя дакументы), на той жа платформе даступная праверка чалавекам. Няма знешняга агенцтва. 100% дакладнасць гарантавана.
Пачніце перакладаць на MachineTranslation.com — бясплатна, рэгістрацыя не патрабуецца. Запусціце Grok, ChatGPT і 20 іншых мадэляў штучнага інтэлекту адначасова і атрымайце пераклад, з якім яны згодныя.
Частыя пытанні
1. Ці Grok лепшы за ChatGPT для перакладу?
Ніводзін з іх не з'яўляецца адназначна лепшым для ўсіх задач перакладу. Grok 4.1 мае асаблівую перавагу пры перакладзе кантэнту пра бягучыя падзеі і матэрыялаў з новай тэрміналогіяй дзякуючы сваёй інтэграцыі з вэб-данымі і данымі X у рэальным часе. ChatGPT (GPT-5.4) лідзіруе ў бенчмарках структураванай дакладнасці і з'яўляецца больш эфектыўным для тэхнічных, навуковых і юрыдычных тэкстаў. Абедзве маюць адно і тое ж асноўнае абмежаванне: як аднамадэльныя сістэмы, ніводная з іх не можа праверыць уласныя вынікі.
2. Ці можа Grok перакладаць дакументы?
Grok можа перакладаць устаўлены тэкст і, у залежнасці ад тарыфнага плана, загружаныя дакументы. Аднак гэта не спецыялізаваны інструмент для перакладу і не прапануе такіх функцый, як захаванне арыгінальнага макета, ацэнка якасці перакладу або крос-мадэльная праверка. Для перакладу дакументаў з захаваннем макета MachineTranslation.com падтрымлівае файлы памерам да 30 МБ у фарматах PDF, DOCX, TXT, CSV, XLSX і фарматах выяў.
3. Наколькі дакладны ChatGPT для перакладу ў 2026 годзе?
Ва ўнутраным бенчмарку MachineTranslation.com на 5000 слоў змешанага тэхнічнага і маркетынгавага кантэнту ChatGPT паказаў дакладнасць 89,8% — гэта высокі вынік, але падчас таго ж тэсту ён дапусціў галюцынацыі ў кантэнце ў двух сказах. На бенчмарках навуковага мыслення (GPQA Diamond) GPT-5.4 набірае 92,0%. Як і ва ўсіх аднамадэльных LLM, узровень галюцынацый ChatGPT у задачах перакладу складае 10–18% згодна з высновамі Intento State of Translation Automation 2025 і WMT24.
4. Які кошт Grok у 2026 годзе?
Grok даступны праз X Premium+ ($22/month) or SuperGrok ($30/месяц) для спажывецкага выкарыстання. API xAI (Grok 4.1) каштуе $0.20 per 1 million input tokens and $0,50 за 1 мільён выходных токенаў, што з'яўляецца адным з самых нізкіх тарыфаў на API сярод асноўных LLM.
5. Ці выкарыстоўвае MachineTranslation.com Grok і ChatGPT?
Так. Як Grok, так і ChatGPT уваходзяць у лік 22 мадэлей штучнага інтэлекту, якія MachineTranslation.com адначасова запускае праз сваю сістэму SMART. Замест таго, каб спадзявацца на які-небудзь адзін інструмент, SMART выбірае пераклад, з якім згаджаецца большасць з 22 мадэлей, — захоўваючы моцныя бакі кожнай і адначасова адфільтроўваючы памылкі, уласцівыя асобным мадэлям. Поўны спіс мадэляў уключае ChatGPT, Claude, Gemini, DeepL, Google, Grok і 16 іншых.
6. Які інструмент штучнага інтэлекту лепшы для юрыдычнага ці медыцынскага перакладу?
Для рэгуляванага кантэнту ні Grok, ні ChatGPT самі па сабе недастатковыя — абодва дапускаюць галюцынацыі на ўзроўні 10–18% у задачах перакладу, што стварае прамую адказнасць для юрыдычных і медыцынскіх дакументаў. SMART-кансэнсус MachineTranslation.com зніжае гэты ўзровень памылак да менш чым 2%, а праверка чалавекам даступная на той самай платформе са 100%-й гарантыяй дакладнасці для кантэнту, які гэтага патрабуе.
Перакладайце з дапамогай Grok, ChatGPT і яшчэ 20 іншых мадэлей штучнага інтэлекту адначасова на MachineTranslation.com — бясплатна, без рэгістрацыі.