October 2, 2026
Qwen супраць Grok: Якая мадэль штучнага інтэлекту перакладае лепш?
Qwen і Grok з'яўляюцца мадэлямі штучнага інтэлекту агульнага прызначэння, а не спецыялізаванымі інструментамі для перакладу, і абедзве ўваходзяць у пул мадэляў, якія MachineTranslation.com выкарыстоўвае пры кожным перакладзе. Гэта важна для разумення таго, пра што пойдзе гаворка ніжэй. Гэта аналіз таго, як дзве ўласныя мадэлі платформы працуюць у параўнанні адна з адной, з рэальнымі агаворкамі, якія суправаджаюць такія дадзеныя, а не спаборніцтва паміж двума знешнімі канкурэнтамі і самой платформай.
Што такое Qwen і Grok?
Qwen гэта сямейства вялікіх моўных мадэляў ад Alibaba, якое ў цяперашні час прадстаўлена пакаленнем Qwen3.8 і было дададзена ў пул мадэляў MachineTranslation.com у рамках пастаяннага пашырэння платформы. Grok гэта лінейка мадэляў ад xAI, якая на момант напісання гэтага тэксту прадстаўлена версіяй Grok 4.7, прайшоўшы праз некалькі рэлізаў з версіі, якая першапачаткова параўноўвалася ў гэтым артыкуле, і была дададзена на платформу асобна. Ніводная з мадэляў не стваралася спецыяльна для перакладу. Абедзве яны з'яўляюцца сістэмамі агульнага прызначэння, якія працуюць са шматлікімі мовамі ў рамках сваіх больш шырокіх магчымасцяў, што з'яўляецца зусім іншым зыходным пунктам у параўнанні з платформай, распрацаванай і пратэставанай спецыяльна дзеля якасці перакладу.
Як выглядае параўнанне Qwen і Grok на ўласных дадзеных MachineTranslation.com?
За апошнія 28 дзён трафіку платформы Grok у сярэднім атрымліваў больш высокія адзнакі, чым Qwen: 9.26 з 10 супраць 8.87. Найгоршыя 10% перакладаў Grok па-ранейшаму ў сярэднім мелі бал 9.2, у той час як найгоршыя 10% перакладаў Qwen знізіліся да 7.6, што паказвае на больш значны разрыў на ніжнім узроўні, чым можна меркаваць толькі па сярэднім паказчыку.
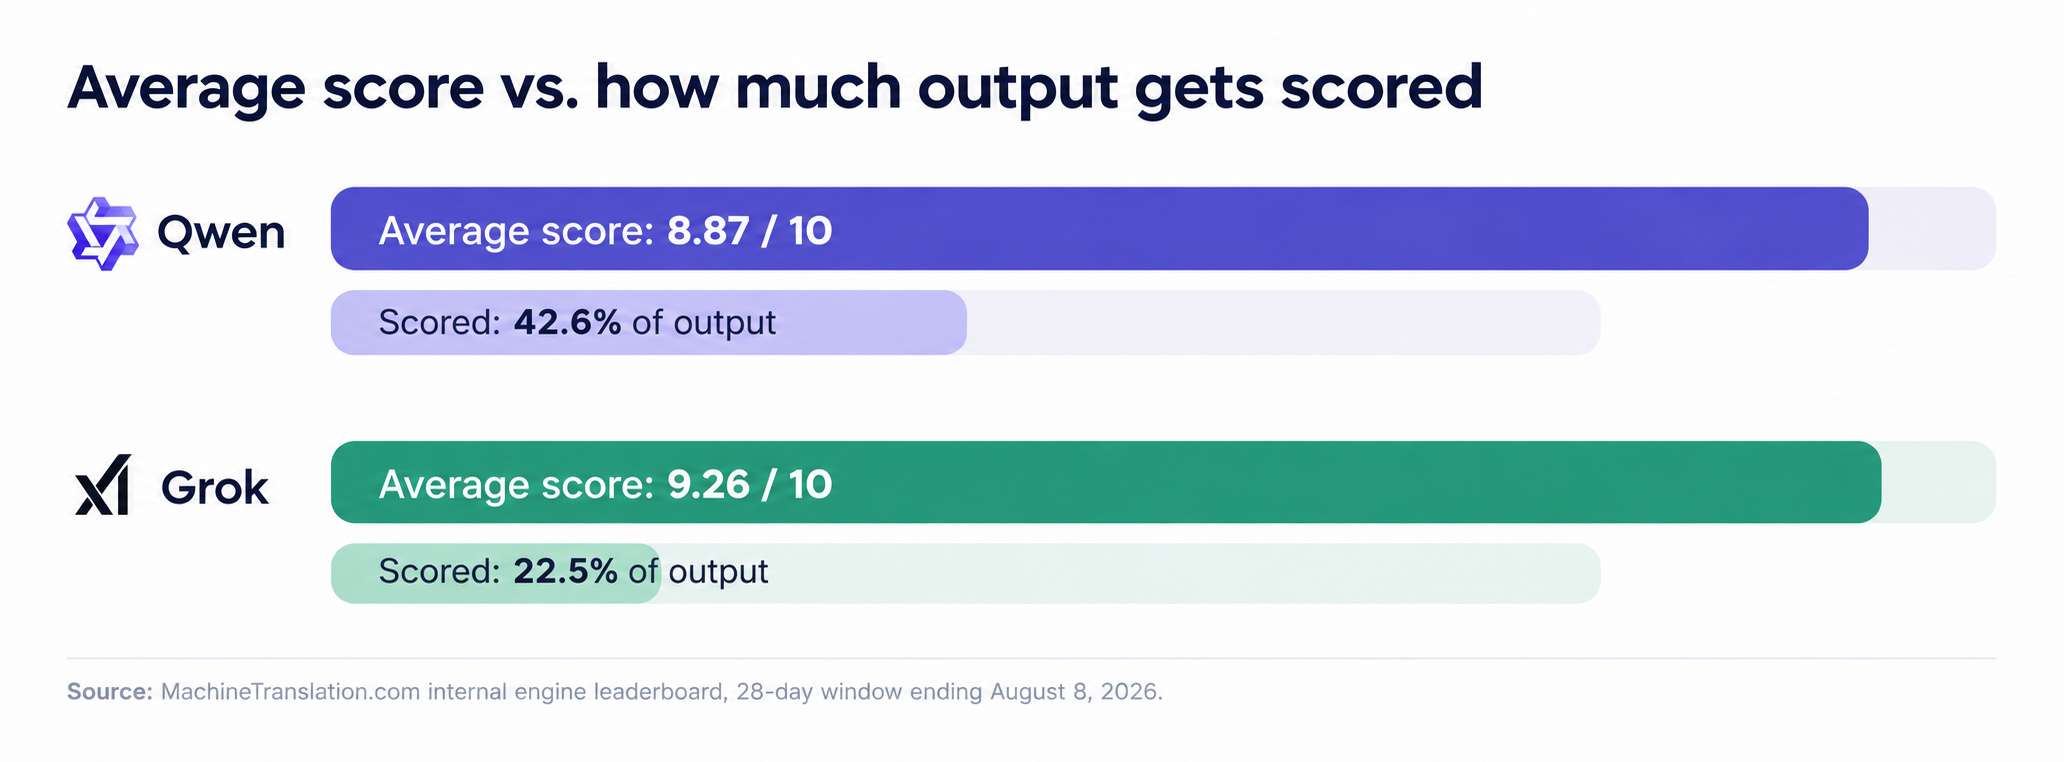
Сярэдні бал Grok вышэйшы, але ён грунтуецца на ацэнцы менш чым чвэрці яго вынікаў, у параўнанні з амаль паловай для Qwen. Гэтыя два слупкі расказваюць розныя часткі адной і той жа гісторыі.
| Qwen | Grok | |
|---|---|---|
| Адсотак ацэненых вынікаў | 42.6% | 22.5% |
| Сярэдні бал | 8.87 / 10 | 9.26 / 10 |
| Ніжнія 10% ацэнак | 7.6 | 9.2 |
Крыніца: унутраная табліца лідараў рухавікоў MachineTranslation.com, 28-дзённы перыяд, які завяршаецца 8 жніўня 2026 года.
Ці азначае больш высокая ацэнка Grok, што гэта лепшы выбар?
Сама па сабе не. Grok выкарыстоўваецца на платформе значна радзей, чым Qwen, і менш за чвэрць яго перакладаў наогул атрымліваюць ацэнку, у параўнанні з амаль паловай у Qwen. Меншая, менш рэпрэзентатыўная выбарка можа зрабіць сярэдні паказчык лепшым або горшым, чым ён быў бы пры тым жа аб'ёме, які апрацоўвае Qwen. Уласная справаздачнасць MachineTranslation.com па гэтых дадзеных разглядае ахоп ацэньвання як рэальнае абмежаванне, а не як зноску: рухавік, ацэнены на вузкім зрэзе яго трафіку, не быў пратэставаны так грунтоўна, як той, што быў ацэнены амаль на палове ўсіх сваіх вынікаў.
Справядліва сказаць, што паказчыкі Grok шматспадзеўныя, але абапіраюцца на меншы аб'ём дадзеных. Паказчыкі Qwen у сярэднім ніжэйшыя, але абапіраюцца на значна большую, больш рэпрэзентатыўную базу. Гэтыя факты не выключаюць адзін аднаго.
Як наконт моўнага ахопу?
Ні Qwen, ні Grok не публікуюць правераны спіс моўных пар, дзе прадукцыйнасць зніжаецца, і не існуе незалежнага тэсціравання, якое б гэта пацвердзіла. З упэўненасцю можна сказаць, што ні адна з мадэляў не стваралася з акцэнтам на якасць перакладу ў пэўным наборы моў, як гэта робіцца на спецыялізаваных платформах для перакладу. MachineTranslation.com непасрэдна тэсціруе і падтрымлівае больш за 270 моў, што адрозніваецца ад заяў мадэляў агульнага прызначэння аб шырокіх, але неправераных шматмоўных магчымасцях.
Як MachineTranslation.com на самай справе выкарыстоўвае Qwen і Grok
MachineTranslation.com запускае Qwen, Grok і больш за 20 іншых мадэляў штучнага інтэлекту для кожнага перакладу, а затым прапануе версію, з якой гэтыя мадэлі больш за ўсё згодныя. Ні адна з мадэляў не выключаецца з-за больш нізкага сярэдняга бала. Адначасовы запуск многіх мадэляў дазваляе выявіць выпадкі, калі мадэль з меншай у сярэднім ацэнкай усё ж такі правільна перакладае канкрэтны сказ, з якім не спраўляецца мадэль з вышэйшай ацэнкай. Прадукцыйнасць Qwen таксама адрозніваецца ў залежнасці ад напрамку і моўнай пары, што варта ведаць перад выбарам адной мадэлі, і гэта больш падрабязна разглядаецца ў параўнанні Qwen і DeepSeek ад MachineTranslation.com. Для больш дэталёвага азнаямлення з тым, як мадэлі наўпрост тэсціруюцца адна супраць адной, глядзіце поўнае параўнальнае тэсціраванне мадэляў ад MachineTranslation.com.
Часта задаваныя пытанні
1. Што лепш для перакладу: Qwen ці Grok?
Паводле ўласных даных рухавікоў MachineTranslation.com за 28 дзён, Grok у сярэднім атрымлівае вышэйшы бал, чым Qwen: 9.26 супраць 8.87 з 10. Але балы Grok выстаўляюцца на значна меншай, менш рэпрэзентатыўнай частцы яго вынікаў, таму гэта не чыстае прамое параўнанне, якім быў бы тэст з супастаўленнем сегментаў.
2. Чаму Grok мае вышэйшы сярэдні бал, але менш ацэненых перакладаў?
Grok выкарыстоўваецца на платформе радзей, і толькі каля 22.5% яго вынікаў атрымліваюць ацэнку, у параўнанні з 42.6% у Qwen. Меншая, менш рэпрэзентатыўная выбарка можа завысіць або занізіць сярэдні паказчык, таму гэта параўнанне варта разглядаць як арыенціровачнае, а не канчатковае.
3. Qwen ці Grok падтрымлівае больш моў?
Абедзве з'яўляюцца ШІ-мадэлямі агульнага прызначэння без апублікаванага, праверанага спісу абмежаванняў для канкрэтных моў. Ніводная з іх не створана спецыяльна для перакладу, што адрознівае іх ад платформы, якая непасрэдна тэсціруе і ацэньвае якасць перакладу для больш чым 270 моў, а не спадзяецца на шырокае шматмоўнае навучанне як на замену вымеранай якасці перакладу.
4. Ці канкурыруе MachineTranslation.com з Qwen і Grok?
Не. MachineTranslation.com запускае Qwen, Grok і больш за 20 іншых ШІ-мадэлей для кожнага перакладу і прапануе версію, з якой гэтыя мадэлі згодныя больш за ўсё. Яна тэсціруе і аб'ядноўвае падобныя мадэлі, а не канкурыруе з імі ў якасці асобнай уласнай мадэлі.
5. Якую ШІ-мадэль MachineTranslation.com рэкамендуе для перакладу?
Па змаўчанні — ніводную. Розныя мадэлі працуюць па-рознаму ў залежнасці ад моўнай пары і тыпу кантэнту, і разрыў паміж імі можа змяняцца ў любы бок у залежнасці ад таго, што перакладаецца. Менавіта з-за гэтай варыятыўнасці платформа запускае некалькі мадэлей для кожнага перакладу, а не выбірае адну ў якасці пастаяннай рэкамендацыі.