May 8, 2026
Grok срещу Claude за превод: какво показват бенчмарковете (2026)
Grok (xAI) и Claude (Anthropic) са способни AI инструменти за превод, но имат структурно различни силни страни. За повечето общи задачи за превод няма да забележите съществена разлика между тях. За два конкретни сценария (превод на съдържание за скорошни събития и превод на официални документи, изискващи прецизност), разликата е реална и се основава на начина, по който е създаден всеки модел.
Тази статия разглежда какво всъщност предлага всеки модел за превод, къде ги позиционират независимите бенчмаркове и какво да използвате, когато резултатът от нито един от двата модела сам по себе си не е достатъчен.
Как се сравняват Grok и Claude по отношение на качеството на превода?
Краткият отговор: Claude води в независимите бенчмаркове за професионален превод. Специфичното предимство на Grok е достъпът до знания в реално време, а не цялостното качество на превода.
Във вътрешните бенчмаркове на MachineTranslation.com, Claude (ниво 3.5 Sonnet) получава 93.8 от 100 за качество на превода — комбинация от точност, терминология и стил. Grok не фигурира сред първите 14 решения в State of Translation Automation 2025 на Intento, който оценява 46 MT системи и LLMs в 11 езикови двойки. И Claude Opus 4, и Claude Sonnet 3.7 присъстват в топ 14. Източник: Вътрешни бенчмаркове на MachineTranslation.com; Intento State of Translation Automation 2025.
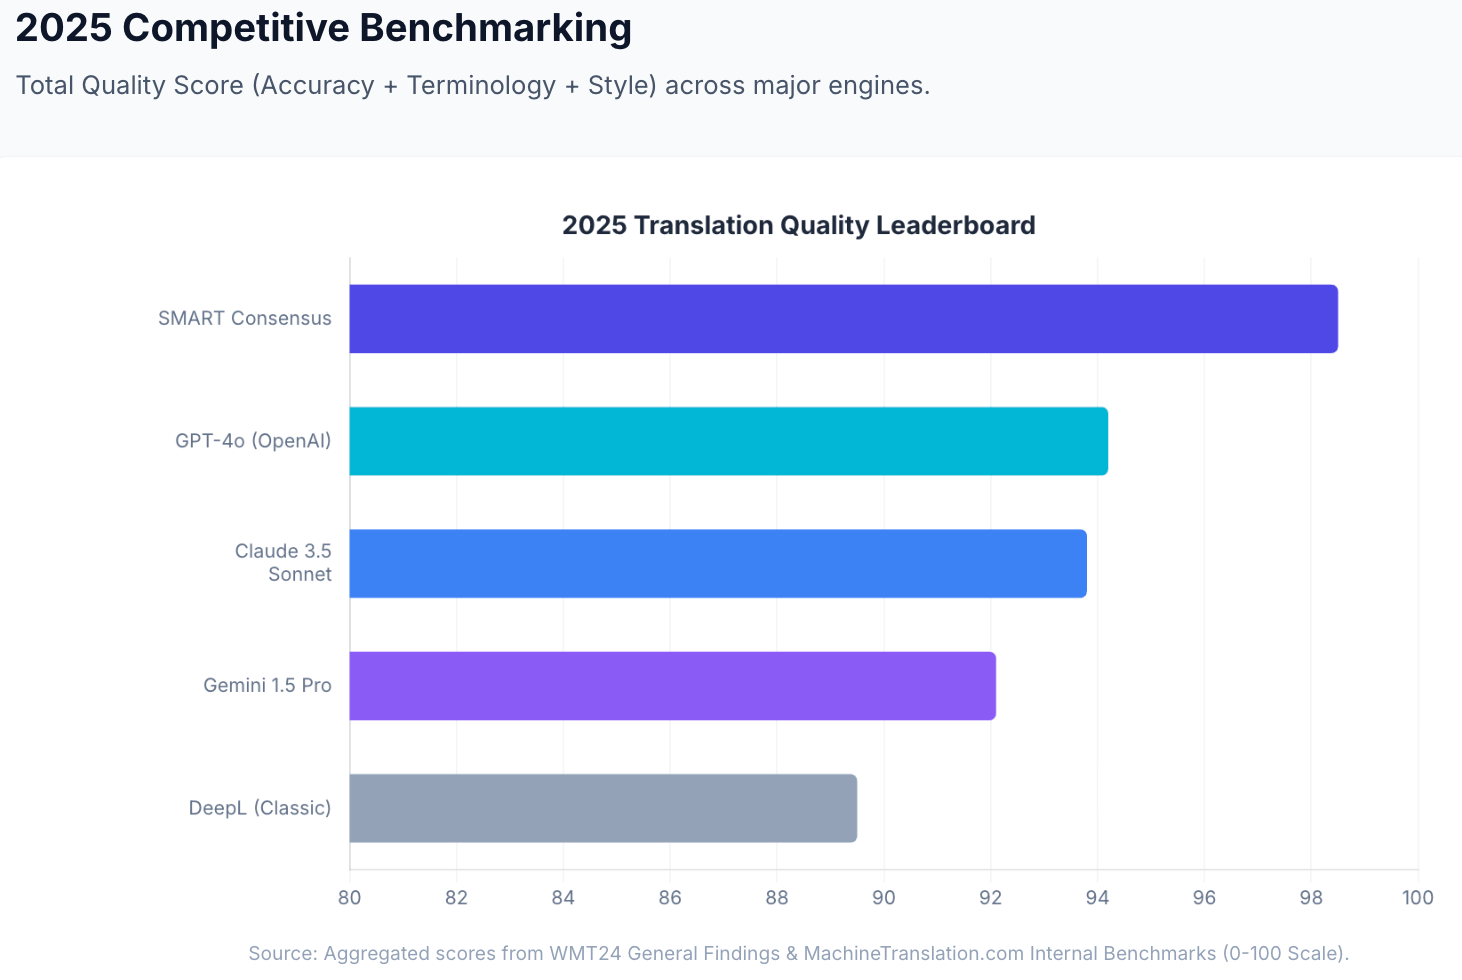
На WMT24 (основното независимо състезание за бенчмаркове в преводаческата индустрия), Claude 3.5 се класира на първо място в 9 от 11 езикови двойки, изпреварвайки GPT-4 и специализираните невронни системи за машинен превод. В сляпото проучване на Lokalise от 2025 г., проведено от професионални преводачи, 78% от преводите на Claude 3.5 бяха оценени като „добри“ — най-високият резултат от всеки тестван LLM.
Grok не е оценяван в WMT24 или в независимата LQA оценка на Intento на съпоставимо ниво. Slator Pro Guide (2025) посочва Grok като един от LLMs с общо предназначение, използвани за превод в професионална среда, наред с GPT и Claude, но не го класира по-високо от нито един от тях.
| Бенчмарк | Grok | Claude |
|---|---|---|
| Вътрешна оценка за качество на MachineTranslation.com | Не е измервано на ниво бенчмарк | 93.8/100 (ниво 3.5 Sonnet) |
| Топ 14 решения на Intento за 2025 г. | Не е в списъка | Claude Opus 4 и Sonnet 3.7 са в списъка |
| Езикови двойки на WMT24 | Не е оценявано | 1-во място в 9/11 езикови двойки |
| Сляпо проучване на Lokalise за 2025 г. | Не е оценявано | 78% „добро“ (най-високото от всички LLM) |
Източник: Вътрешни бенчмаркове на MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Къде Grok има истинско предимство?
Превод в реално време и на актуални събития. Определящата архитектурна характеристика на Grok е неговата интеграция с данните от платформата X (преди Twitter) и търсенето в интернет в реално време. За разлика от Claude и повечето други LLMs, които са обучени върху статични набори от данни с фиксирани времеви граници на знанието, Grok включва информация в реално време в своите резултати. За задачи за превод, свързани със скорошни събития, наскоро пуснати продукти, нововъзникваща политическа терминология, текущи новини или съдържание, отнасящо се до случилото се през последните седмици, Grok има достъп до контекст, до който Claude няма.
Това е от значение по-конкретно за: превод на новинарски статии за скорошни събития, локализиране на продуктови анонси за динамични пазари, справяне с новосъздадена терминология или жаргон, които датират след данните за обучение на другите модели, и всякакво съдържание, при което значението зависи от това да се знае какво се е случило наскоро.
Нововъзникваща и развиваща се терминология. Техническите области, индустриите и културните контексти непрекъснато създават нова терминология. За задачи за превод, включващи наскоро създадени термини, нов регулаторен език или нова продуктова номенклатура, актуализираното обучение на Grok и търсенето в реално време му осигуряват достъп до модели на употреба, които по-старите моментни снимки на данни за обучение не улавят.
Контекстен прозорец и разсъждение на Grok 4.1. Grok 4.1 (към края на 2025 г.) разполага с контекстен прозорец от 131K токена и подобрени способности за разсъждение, което го прави способен да се справя със сложни, многопластови документи, където връзките между клаузите и логическата съгласуваност са от значение.
Къде Claude има истинско предимство?
Качеството на превода при независими бенчмаркове. Предимството на Claude е документирано от независима професионална оценка, а не от самостоятелно декларирани твърдения. WMT24 класира Claude 3.5 на първо място в 9 от 11 езикови двойки срещу цялата конкуренция. Сляпото проучване на Lokalise от 2025 г. установи, че професионалните преводачи предпочитат резултатите на Claude 3.5 с 78% оценка „добро“ — по-висока от тази на GPT-4, DeepL и Google Translate в същото оценяване. Това са слепи оценявания: професионални преводачи оцениха резултатите, без да знаят кой модел ги е генерирал.
Конкретни езикови двойки според Intento 2025. Claude Opus 4 и Sonnet 3.7 попадат в категорията „най-добри“ за английски на немски, английски на японски, английски на италиански, английски на корейски, английски на нидерландски, английски на арабски и английски на френски в човешката LQA оценка на Intento. За тези двойки Claude е по-силният документиран избор между двете.
Прецизност на тона и нюансирано съдържание. Професионалните преводачи в проучването на Lokalise предпочетоха резултатите на Claude в най-висока степен спрямо всеки друг LLM — което отразява документираната сила на Claude в запазването на регистъра, авторския глас и контекстуалното значение. За художествен превод, правни документи, официална комуникация и маркетингови текстове, където начинът, по който се казва нещо, е толкова важен, колкото и какво се казва, Claude последователно се представя добре в независими оценки.
Кохерентност при дълги документи. Claude 4.6 Sonnet поддържа контекстен прозорец от 200K токена, като Claude Opus 4.6 поддържа 1M токена в бета. За дълги официални документи (договори, технически ръководства, доклади от клинични изпитвания), Claude може да обработи целия документ с едно преминаване, запазвайки последователността на терминологията в целия текст. Документите, обработени на фрагменти, показват с 28% по-висок процент на терминологична непоследователност в сравнение с обработката на цели документи. Източник: Вътрешни данни на MachineTranslation.com.
Как се сравняват по отношение на езиковата поддръжка и ценообразуването?
Езикова поддръжка: И Grok 4.1, и Claude 4.6 поддържат превод на повечето основни световни езици. Claude е оценен независимо в европейски и източноазиатски езикови двойки със силни резултати. Мултиезичната поддръжка на Grok се подобри с всяка следваща версия. За езици с ограничени ресурси качеството и на двата модела се влошава — прегледът от човек е подходящ за съдържание на езикови двойки с ограничени ресурси, независимо кой модел се използва.
Ценообразуване:
| План | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Потребителски (месечно) | SuperGrok: $30/месец | Claude Pro: $20/месец |
| API вход (на M токена) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API изход (на M токена) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Безплатно ниво | Да (с ограничение на заявките през X/Grok.com) | Да (с ограничение на заявките през claude.ai) |
При потребителското ниво, Claude Pro ($20/month) is cheaper than SuperGrok ($30/месец). На ниво API, Grok 4.1 има леко ценово предимство пред Claude Sonnet 4.6 за работни процеси по превод с голям обем на входящи данни.
Кой е по-добър за конкретни типове съдържание?
| Тип съдържание | Препоръчителен модел | Причина |
|---|---|---|
| Последни новини / текущи събития | Grok | Достъп до данни в реално време; статично обучените модели нямат актуален контекст |
| Нововъзникваща терминология / пускане на нови продукти | Grok | Интеграцията на търсене в реално време улавя скорошните модели на употреба |
| Официални правни документи | Claude | Независима оценка на WMT24 и Lokalise 2025; прецизност на тона |
| Медицинско / клинично съдържание | Claude | Позиция в независими бенчмаркове; запазване на регистъра |
| Маркетингови текстове / творческо съдържание | Claude | Предпочитание при сляпо проучване на Lokalise 2025; тонални нюанси |
| Техническа документация (дълга) | Claude | Контекстен прозорец от 200K-1M; съгласуваност на терминологията по цялата дължина |
| Социални медии / разговорно съдържание | И двата | И двата се справят добре с разговорни двойки с голям обем ресурси |
| Интеграция за разработчици / API | И двата | И двата предлагат достъп до API; Grok е малко по-евтин за входящи токени |
Какво да използвате, когато един модел не е достатъчен
И Grok, и Claude са инструменти с един модел. Всеки отделен AI модел (независимо колко е способен) допуска грешки, които не може да открие в собствения си изход. Гладкият, уверен превод от Grok или Claude все още може да бъде семантично погрешен и без кръстосана проверка няма как да се разбере.
И Grok, и Claude са сред 22-та модела в SMART системата на MachineTranslation.com. SMART изпълнява всички 22 модела едновременно (включително Grok и Claude) и връща резултата, за който мнозинството е постигнало съгласие.
Какво означава това за въпроса Grok срещу Claude: Силата на Grok в реално време и контекстуалната дълбочина на Claude допринасят за един и същ консенсус. Когато са на едно мнение, това съгласие е силен сигнал за качество.
Във вътрешните бенчмаркове на MachineTranslation.com индивидуалните модели от най-висок клас постигат резултат от 93-94 от 100 за качество на превода. Консенсусният резултат на SMART достига 98.5/100. Източник: Вътрешните бенчмаркове на MachineTranslation.com и констатациите на WMT24 за общ машинен превод.
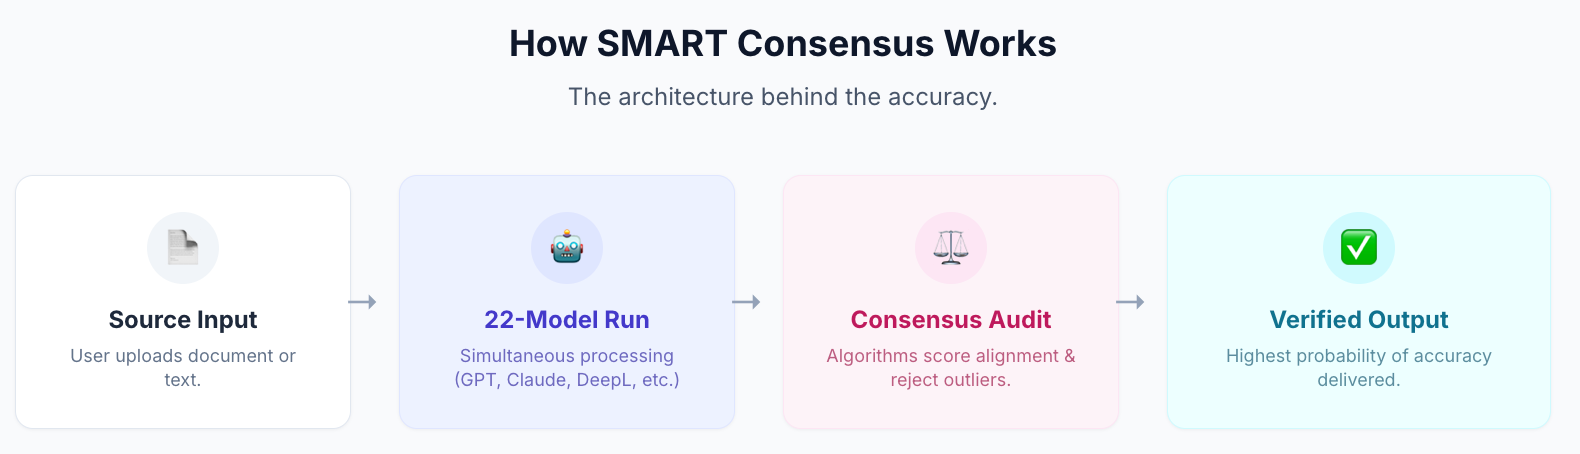
Потребителите, които са преминали от превод с един двигател към SMART, са отделили 27% по-малко време за проверка и коригиране на резултатите. Източник: Вътрешни данни на MachineTranslation.com.
За съдържание с висок риск (правни документи, регулаторни документи, медицински инструкции), Human Verification ескалира SMART консенсуса до сертифициран професионален рецензент в рамките на същата платформа. Без външна агенция. 100% гарантирана точност.
Превеждайте с Grok, Claude и 20 други модела на MachineTranslation.com — безплатно, без нужда от регистрация.
Често задавани въпроси
1. По-добър ли е Grok от Claude за превод?
За повечето стандартни задачи за превод Claude води в независимите бенчмаркове: първи в 9 от 11 езикови двойки на WMT24, 78% оценка добър в сляпото проучване на Lokalise за 2025 г. и 93.8/100 във вътрешните бенчмаркове за качество на MachineTranslation.com. Специфичното предимство на Grok е при съдържание, изискващо познания за текущи събития, като неговият достъп до данни в реално време му дава контекст, който статично обучените модели, включително Claude, нямат. За актуални новини, нововъзникваща терминология и чувствително към времето съдържание Grok е по-добрият избор.
2. Какво е предимството на Grok пред Claude за превод?
Grok интегрира данни в реално време от X (преди Twitter) и търсене в интернет на живо. За разлика от Claude и повечето други LLMs, обучени върху статични набори от данни, Grok има достъп до информация за скорошни събития, новосъздадена терминология и текущия контекст при генериране на преводи. Това го прави специално по-силно при превода на новинарско съдържание, наскоро пуснати продукти и всякакви материали, при които смисълът зависи от събития или езикови модели от последните няколко седмици.
3. Какво е предимството на Claude пред Grok при превод?
Предимството на Claude е документирано чрез независима професионална оценка. Claude 3.5 се класира на първо място в 9 от 11 езикови двойки на WMT24, а професионалните преводачи в сляпото проучване на Lokalise от 2025 г. предпочетоха неговия резултат с 78% степен „добър“ — най-високата сред всички тествани LLM. Claude също присъства в топ 14 решенията на Intento в множество езикови двойки при човешка LQA оценка, докато Grok не. За официални, професионални и преводачески задачи с висок залог, позицията на Claude в независимите бенчмаркове е документираният диференциатор.
4. Кой е по-добър за правен превод, Grok или Claude?
Claude е по-добрият избор за правен превод въз основа на независима оценка. Claude 3.5 зае първо място в повечето високоресурсни европейски езикови двойки на WMT24 и получи най-високите оценки за предпочитание в сляпо проучване от професионални преводачи. За правно съдържание, изискващо сертифицирана точност, нито един от двата модела самостоятелно не е достатъчен — Human Verification на MachineTranslation.com осигурява 100% точност от сертифициран професионален рецензент в рамките на същата платформа, без да е необходим външен доставчик.
5. Налични ли са и Grok, и Claude в MachineTranslation.com?
Да. И двата са сред 22-та модела в системата SMART на MachineTranslation.com. Всеки SMART превод стартира Grok, Claude и 20 други модела едновременно, като връща резултата, за който мнозинството е съгласно. Вместо да избирате между тях, получавате консенсуса на всички AI модели.
6. Как се сравняват Grok и Claude по отношение на цените?
На потребителското ниво Claude Pro струва $20/month versus SuperGrok at $30/месец. На ниво API, Grok 4.1 е малко по-евтин за входящи токени ($2/M vs. $3/M за Claude Sonnet 4.6) и изходящи ($10/M vs. $15/M). Безплатният план на MachineTranslation.com включва и двата модела като част от консенсуса от 22 модела на SMART, без да се изисква регистрация.
7. Кой AI модел е най-добър за превод на новинарски статии?
За превод на новинарски статии Grok има структурно предимство: неговата интеграция на данни в реално време означава, че той разполага с актуален контекст за описваните събития, какъвто статично обучените модели може да нямат. За превод на общи новини, където актуалността не е от критично значение, бенчмарк представянето на Claude е по-силно. За превод на новини в големи обеми, при който както актуалността, така и точността са от значение, SMART на MachineTranslation.com изпълнява и двата модела и връща техния консенсусен резултат.